

Кейсы внедрения DevOps для Data Platform: отраслевые примеры
В современных организациях данные становятся стратегическим активом. Для Data Platform требуется не только мощная архитектура и инструменты для обработки больших объемов данных, но и управляемый жизненный цикл: от кода трансформаций до развёртывания инфраструктуры и автоматизации изменений в продуктивной среде. В этом разделе представлены отраслевые кейсы внедрения практик DevOps в Data Platform: как в разных секторах формируются требования к архитектуре, как выстраиваются CI/CD, инфраструктура как код и подход GitOps, какие риски и организационные изменения сопровождают переход, и какие дорожные карты предлагаются для масштабирования на уровне всей компании.
Введение фокусируется на основных паттернах и уроках, которые применимы к различным отраслям: финансовым сервисам, телекоммуникациям, электронной коммерции и индустриальному сектору. Особое внимание уделено тому, как сочетать контроль качества данных, управляемость изменений и регуляторные требования с ускорением поставки данных и моделей в продакшн.
Краткое содержание главы
- Архитектурные паттерны Data Platform в условиях DevOps: универсальные принципы, роль lakehouse, дата-архитектуры и управление данными как кодом.
- Практические кейсы внедрения в банковском секторе, телекоммуникациях и ритейле: что можно повторить, какие инструменты выбрать, как выстроить процессы.
- Управление качеством данных и регуляторикой: данные как продукт, трассируемость изменений, аудит и соответствие требованиям.
- Масштабирование DevOps для Data Platform: организационные изменения, роли, процессы и критичные метрики.
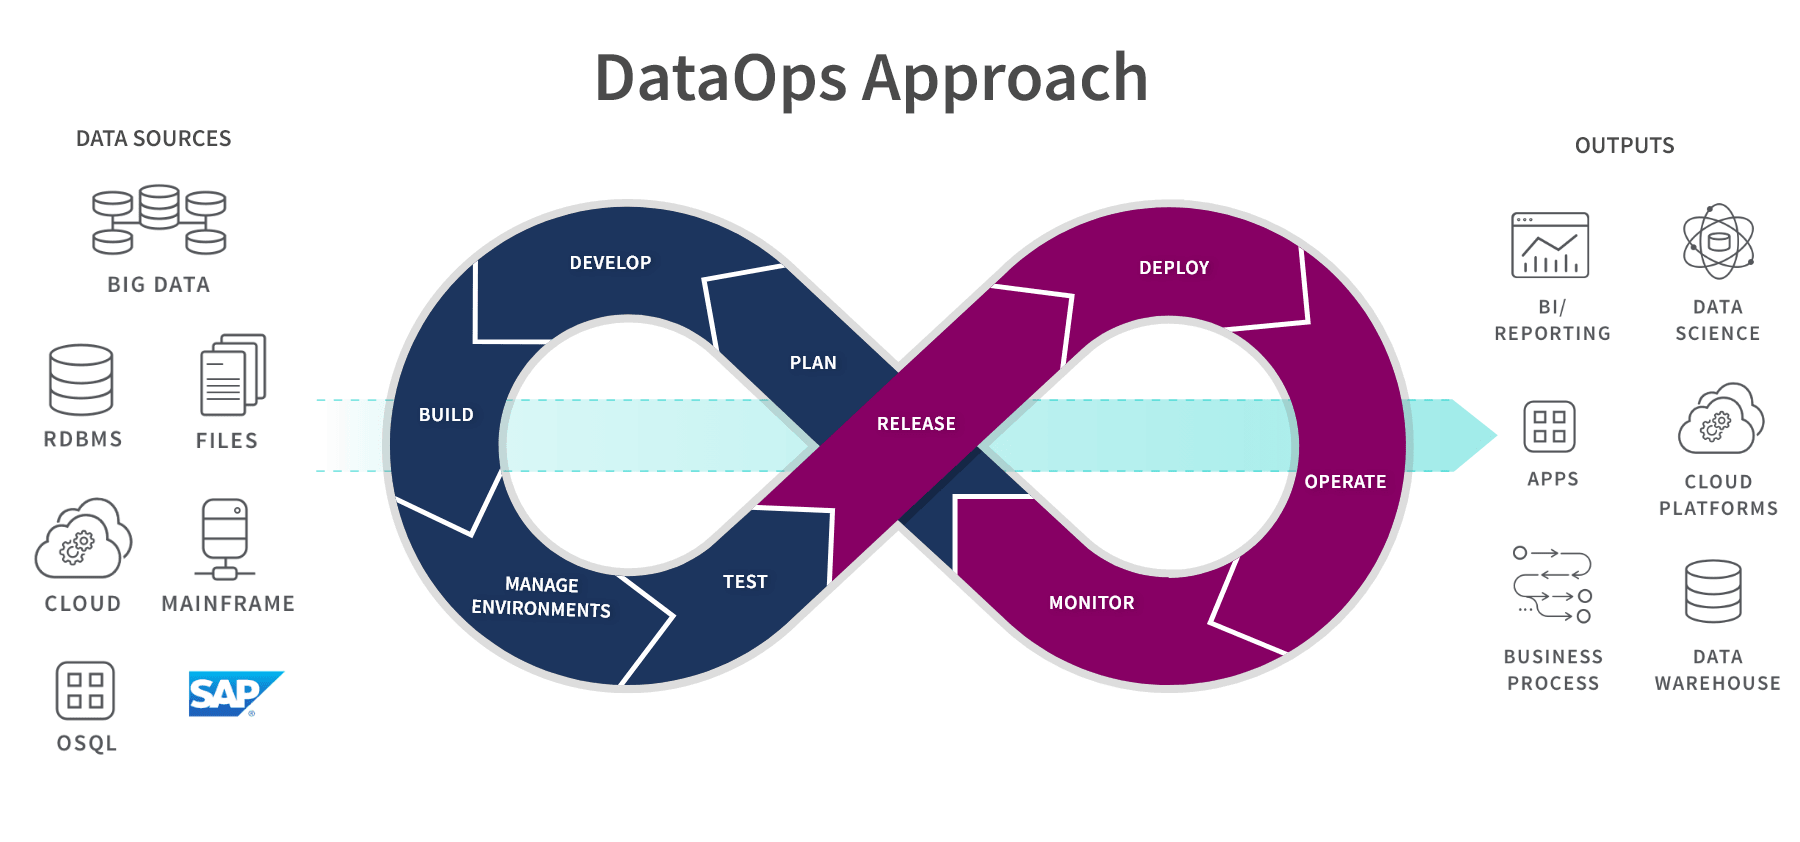
Кейс 1: Финансовый сектор — обеспечение регуляторной готовности через DataOps
Финансовые сервисы предъявляют строгие требования к регуляторике, аудиту и защите данных. Кейсы в банковском секторе демонстрируют, как DevOps-подходы применяются к трансформациям данных, нормативам и управлению циклами поставки данных в продуктивную среду.
Архитектурные принципы
Здесь доминируют сочетания Data Lakehouse и Data Warehouse. Данные проходят через слои: инпута (sourcing), интеграции (ETL/ELT), обработки (партии и стримы) и публикации в слой аналитики. Ключевые принципы include:
- отделение кода бизнес-логики от инфраструктуры и данных, с явной версионизацией контрактов данных;
- обеспечение дубликируемости и многопоточности обработки, поддержка аудита и lineage;
- применение «data contracts» между источниками, обработчиками трансформаций и потребителями данных;
- применение конфигураций инфраструктуры как кода (Terraform, Helm) и декларативного управления ресурсами в Kubernetes;
- реализация мер защиты: маскирование чувствительных данных, политик доступа на уровне строк/колонок, управление секретами и журналирование.
CI/CD, IaC и GitOps для банковских пайплайнов
В банковских пайплайнах трансформации данных часто являются первым классом кода: dbt-проекты, DAG-логика Airflow/Ddagster и конфигурации инфраструктуры. Практика включает:
- монорепозитории с разделением по доменам данных и по окружениям (dev/stage/prod) и overlays для параметров окружения;
- автоматическую валидацию изменений: тесты данных (data quality checks), unit-тесты трансформаций, контрольные сценарии регуляторных ограничений;
- внедрение параллельного развёртывания: сначала инфраструктура, затем платформенный слой, затем данные и приложения;
- отслеживание изменений и аудита через хранилища длинной линии и журналов изменений.
Пример архитектурной схемы и интеграций
- источник данных → инжест в Data Lake (object storage) → слой обработки (ETL/ELT) → дата-слой аналитики (DW) и/или lakehouse → доступ к данным через BI/ML.
- инструменты: Terraform для инфраструктуры, Kubernetes для исполнения тяжелых рабочих процессов, dbt для трансформаций, Apache Airflow или Dagster для оркестрации, Great Expectations для data quality, Delta Lake или Iceberg для управляемых таблиц, Snowflake/BigQuery как хранилище аналитики.
- GitOps-управление: Argo CD или Flux управляет конфигурациями и манифестами Kubernetes и сопутствующими артефактами; секреты защищены через Sealed Secrets или Vault.
name: Data Platform CI
on:
  pull_request:
    branches: [ main ]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Set up Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'
      - name: Install dbt
        run: pip install dbt-core dbt-snowflake
      - name: Run dbt tests
        run: dbt test --profiles-dir=profiles
Реализация на примере
- задача: гарантировать, что любая модификация трансформаций данных не ломает существующие бизнес-процессы.
- шаги внедрения: создание единого репо трансформаций и конфигураций окружающей среды, тестирование данных до продвижения в PROD, внедрение альтернативного канала развертывания для регуляторных изменений.
- управление секретами: хранение политик доступа к данным в виде декларативных конфигураций и применение секретов через Kubernetes Secrets либо Vault.
- аудит и соответствие: хранение неизменяемых журналов изменений, автоматическое сохранение снимков данных и метаданных для регуляторных проверок.
Важные уроки и риски
- риски несоответствия: изменения в ETL-логике могут повлечь падение качества данных и регуляторные тревоги; требуется строгий регламент тестирования и утверждений;
- уроки: настройка систем уведомлений и SLA по качеству данных, автоматизированные отчеты по соответствию по каждому развороту;
- роль команды: тесное сотрудничество между data engineering, SRE и compliance-отрядом.
Кейс 2: Телекоммуникации — управление стримингом и данными в реальном времени
Телеком-компании работают с потоками данных в реальном времени: клики, события связи, телеметрия устройств. В таких условиях DevOps-практики становятся критически важными для поддержания SLA по задержкам, полноте и точности данных.
Архитектурные принципы
- единый поток данных от источников к хранилищам: ingress через Kafka/Confluent, обработка через Spark Structured Streaming или Flink, результат в озеро данных и/или оперативное хранилище;
- поддержка репликации и устойчивости к сбоям, срезка версии схем и эволюция схем;
- концепции data contracts и контрактов сервисов, масштабирование на уровне потоковых потребителей.
CI/CD, IaC и GitOps
- CI/CD для потоковых задач: тестирование конвейеров данных, проверка совместимости между версиями обработчиков и данным форматом;
- инфраструктура как код: создание кластеров, потоков и подписок в Terraform и Helm-чартами;
- GitOps: развертывание потоковых DAG через Argo CD; параметризация окружений через overlays с безопасностью секретов.
Реализация на примере
- стриминговые пайплайны получают обновления через Git, изменения распространяются через Prod-окружение после прохождения ряда валидирующих тестов;
- мониторинг задержек и ошибок в потоках: Prometheus + Grafana, а также OpenTelemetry для трассировки.
Пример кода
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: streaming-data-prod
spec:
  project: default
  source:
    repoURL: 'https://github.com/org/streaming-pipelines.git'
    path: 'prod'
    targetRevision: main
  destination:
    server: 'https://kubernetes.default.svc'
    namespace: streaming-prod
  syncPolicy:
    automated:
      prune: true
      selfHeal: true
Важные уроки и риски
- закономерности задержек и сбоев: потребность в строгой фильтрации ранних ошибок, устойчивому мониторингу и автоматическому масштабированию;
- ключевые практики: эволюция схем, версионирование DAG’ов, тестирование моделей потока, эксплуатация функциональных тестов для стриминга.
Кейс 3: Электронная коммерция — одновременная поддержка аналитики и ML
В e-commerce платформах критически важны как адаптивная аналитика, так и модели рекомендаций и ценообразования. DevOps-практики здесь помогают ускорить доставку данных и обновление моделей, сохраняя при этом качество данных и управляемость изменений.
Архитектурные принципы
- lakehouse-архитектура с параллельной обработкой batch и streaming;
- управление данными как продукт: каталоги данных, спецификации полей, контрактные тесты и slope-метрики;
- единый репозиторий трансформаций и конфигураций услуг, поддержка версионирования контрактов и данных.
CI/CD, IaC и GitOps
- CI для трансформаций: тестирование SQL-трансформаций, проверка совместимости с модельными пайплайнами; тестирование качества персистентности данных и корректности агрегаций;
- IaC для инфраструктуры аналитических сервисов и ML-окружений (контейнеры, кластеры, сервисы K8s);
- GitOps для развёртывания изменений в моделях, данных и контейнеризованных сервисах через Argo CD.
Практический пример
- pipeline включает: сбор данных, подготовку трансформаций, обновление моделей, A/B тестирование, миграцию схем, публикацию обновленных моделей и дашбордов;
- активная работа по управлению экспериментальными данными, безопасному контролю версий и отслеживанию влияния изменений на бизнес-метрики.
Важные уроки и риски
- риск «разной скорости» между данными и моделями; необходима координация релизов между командами данных и продуктовой командой;
- достижение: явно определённые контракты данных, версионирование признаков, использование feature store для воспроизводимости моделей.
Кейс 4: Производственный сектор — обмен данными между полями и данным центром
Для производственных компаний характерны данные из локальных сенсоров, MES-систем, ERP и облачных сервисов. В этом контексте DevOps-практики помогают создать устойчивую экосистему Data Platform, охватывающую edge-данные и централизованный анализ.
Архитектурные принципы
- интеграция edge и облачных источников через безопасные конвейеры данных, поддержка локальных бэкапов и устойчивость к сбоям;
-湖-архитектура с поддержкой транзакционных операций и единым каталогом данных; - политика управления изменениями и данными в режиме реального времени с возможностью отката.
CI/CD, IaC и GitOps
- CI для трансформаций и экспорта данных из MES/ERP: проверка форматов, консистентности и согласования с бизнес-правилами;
- IaC для инфраструктурной части: создание кластеров, сетей, политик безопасности и мониторинга;
- GitOps: контроль конфигураций облачных и локальных окружений, развёртывание обновлений через Argo CD, поддержка секретов через Vault или аналогичные решения.
Реализация на примере
- решение включает сценарии онлайн-аналитики для планирования и предиктивного обслуживания, а также офлайн-аналитику для консолидированной картины производства;
- ориентир на управление доступом к данным по ролям, журналирование действий, и обеспечение соответствия нормативам.
Важные уроки и риски
- сложности с интеграцией устаревших систем и современных пайплайнов; необходима плавная эволюция архитектуры и совместная работа между командами промышленной эксплуатации и ИТ;
- ключевые практики: безопасная миграция данных, контроль версий схем и данных, мониторинг критичных процессов.
Key takeaways
- DevOps для Data Platform требует сочетания архитектурной дисциплины и операционных процессов: CI/CD, IaC и GitOps совместно с управлением качеством данных и регуляторной готовностью.
- В отраслевых кейсах важна адаптация паттернов под специфические требования сектора: регуляторика в банковском секторе, стриминг и SLA в телекоммуникациях, баланс между аналитикой и ML в ритейле, интеграция edge-данных в производстве.
- Архитектурные решения должны обеспечивать lineage, контроль версий и контрактов данных, чтобы изменения в коде трансформаций не повлекли неожиданные изменения в данных.
- Инструментарий должен быть сбалансирован: выбор подходящих инструментов для CI/CD, оркестрации и управления инфраструктурой, при этом не перегружать команду излишним арсеналом.
- Масштабирование DevOps в Data Platform требует организационной экспертизы: роли SRE, Data Engineer, Platform Engineer, Data Steward, и бизнес-аналитика, а также общих регламентов по изменению, тестированию и аудиту.
- Data quality и governance должны быть встроены в конвейеры как нормальная часть выпуска, а не как поздний этап проверки.
- Обеспечение безопасности и соответствия требует единых контрактов данных, политики доступа и надлежащего журналирования изменений на всех слоях платформы.
FAQ
Что такое DataOps и зачем он нужен в рамках DevOps для Data Platform?
DataOps — это совокупность практик и культурных изменений, ориентированных на повышение скорости, качества и управляемости процессов работы с данными. В контексте DevOps для Data Platform DataOps дополняет традиционные подходы к CI/CD и IaC за счет внедрения контрактов данных, автоматических тестов качества данных, трассируемости изменений, аудита и гибкого управления данными на уровне всей платформы. Это позволяет ускорить доставку аналитических продуктов и моделей, но без потери контроля над качеством и соответствием регуляторным требованиям.
Какие архитектурные паттерны чаще всего применяются в кейсах банковского сектора?
Чаще всего используются lakehouse- или гибридные архитектуры: слой инпута через коннекторы к данным, единый слой трансформаций (dbt/ETL), управляемый слой хранения (Delta Lake или Iceberg) и аналитический слой (DW/BI). Особое внимание уделяется контрактам данных, миграциям схем, управлению доступом и аудиту, а также множественной изоляции окружений и строгой версии трансформаций.
Как организовать CI/CD для трансформаций данных и моделей?
Через монорепозиторий, где хранится код трансформаций, тесты качества данных, конфигурации инфраструктуры и параметры окружения. Тестирование включает unit-тесты трансформаций, интеграционные тесты данных и проверки соответствия контрактам данных. Развертывание идёт через GitOps-подход: изменения проходят через стадии тестирования и утверждения, затем автоматически разворачиваются в PROD после прохождения всех квитов.
Какие инструменты подходят для GitOps в Data Platform?
Подходящими являются Argo CD или Flux для управления манифестами в Kubernetes, совместно с инструментами для управления конфигурациями и секретами (например, Vault или Sealed Secrets). В контексте данных это означает управление правами доступов, конфигурациями DAG’ов и инфраструктурой как код в единых пайплайнах.
Какие меры повышения качества данных следует автоматизировать?
Включить data contracts, валидаторы данных (например, Great Expectations), тесты трансформаций, мониторинг качества данных и уведомления о падающих тестах. Важно обеспечить репродуктивность тестовых данных, версионирование схем и прозрачные отчёты по качеству на каждом развороте.
Как обеспечить соответствие регуляторным требованиям при быстром выпуске изменений?
Необходимо разделение ролей, аудит изменений, хранение неизменяемых логов и снапшотов данных, строгие политики доступа и секретности, а также автоматизированные проверки на соответствие требованиям в каждом конвейере. Внедрение контрактов данных позволяет заранее проверять совместимость изменений.
Какие организационные изменения необходимы для перехода к DevOps в Data Platform?
Необходимо сформировать межфункциональные команды (Data Engineering, Data Science, SRE, Compliance, Biz-аналитика), внедрить общие практики управления изменениями, архитектурные ревью и единые регламенты выпуска. Важна культура совместной ответственности за качество данных и скорость поставки.
Какие метрики полезны для оценки эффективности DevOps в Data Platform?
Частота выпусков (deployment frequency), среднее время восстановления после инцидента (MTTR), скорость доставки изменений в бизнес-показатели, доля автоматизированных тестов качества данных, процент успешно пройденных контрактов данных, время цикла от кода до данных в PROD, показатели latency и throughput для стриминга.
Как балансировать требования к безопасности и скорость изменений?
Это достигается за счёт предопределённых политик доступа, автоматизации аудита и проверок на уровне конвейера, а также поэтапного управления изменениями: сначала в DEV/STAGE, затем в PROD через согласование и тестирование на регуляторных ограничениях. GitOps обеспечивает прозрачность и контроль над каждым шагом.
Какие примеры ошибок стоит заранее предусмотреть и как их избежать?
Ошибки могут включать несогласованность версий схем, скрытые зависимости между трансформациями, неполную обработку ошибок в стриминге и недостаточное тестирование качества данных. Предотвращение достигается через строгую версионизацию контрактов, повторяемое тестирование, симуляционные окружения, а также внедрение регламентов ревью и утверждений.
Если требуется углубление в конкретный кейс или добавление дополнительного сектора — можно адаптировать фокус под отрасль, организационные особенности и зрелость DevOps в вашей команде.


