

Архитектура распределённых вычислений: coordinator и workers
Распределённая архитектура Trino строится на разделении функций между координационным узлом (координатор) и нодами-исполнителями (воркеры). Координатор отвечает за анализ запроса, оптимизацию плана, распределение задач и агрегацию результатов, тогда как воркеры выполняют сами вычисления на данных, распараллеливая работу по источникам и участкам данных. Такой подход обеспечивает масштабируемость, гибкую настройку ресурсов и устойчивость к отказам, поскольку выполнение фрагментов запроса разбито на независимые задачи, которые могут работать параллельно и восстанавливаться при сбоях.
Глобальная схема работы основана на следующих принципах. Запрос попадает на координатор, где выполняется синтаксический разбор, семантический анализ, проверка прав доступа и сбор статистики. Затем формируется распределённый физический план, состоящий из последовательности задач (tasks) и обменов (exchanges) между воркерами. Воркеры получают соответствующие фрагменты плана и данныеSplit’ы, исполняют их локально, передавая промежуточные результаты другим воркерам или координируя сводные операции. В результате собирается итоговый набор данных, который возвращается клиенту. Важной особенностью является поддержка разных стратегий обмена данными между этапами: partitioned shuffle, broadcast и gather, что позволяет минимизировать сетевой трафик и ускорить операции соединения и агрегации.
Ключевой прогал в архитектурном контексте состоит в том, что эффективная координация вычислений достигается за счёт чёткой дисциплины обменов между узлами, продуманной памяти и механикой spill, а также грамотной настройки соотношения запросов к ресурсам. В рамках методического курса мы подробно рассмотрим роли координатора и воркеров, принципы планирования запросов, механизмы связи и взаимодействия, а также практические сценарии масштабирования и интеграции с внешними источниками данных.
- Ключевые концепции распределённых вычислений в Trino: разделение задач, планирование на уровне фрагментов, обмен данными между узлами.
- Роли координатора и воркеров и их взаимодействие на протяжении жизненного цикла запроса.
- Механизмы масштабирования, устойчивости к сбоям и интеграции с каталогами и источниками данных.
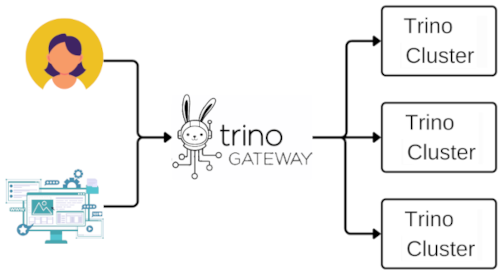
Архитектура распределённых вычислений в Trino: базовые принципы
Решение о выполнении запроса в Trino строится на распределённой вычислительной модели, где каждый элемент плана может быть параллельно обработан на отдельных узлах. При этом единственный координатор выступает в роли «мозга» запроса: он анализирует, оптимизирует план, распределяет задачи по воркерам и собирает результаты. Воркеры, в свою очередь, несут ответственность за конкретные вычисления: чтение данных, выполнение скалярных и агрегационных операций, ранжирование, соединения иshuffle-операции.
Распределение начинается с разбивки входного объёма данных на логические единицы — splits. Splits соответствуют фрагментам данных, которые могут быть считаны и обработаны независимо друг от друга. Такую разбивку выполняют источники данных (Connectors) через их адаптеры. Примеры источников: файловые системы (HDFS, локальные файловые системы), объектные хранилища и базы метаданных (например, Hive Metastore в качестве каталога). Воркеры получают конкретные splits и выполняют вычисления над ними, формируя промежуточные результаты, которые затем собираются на другие воркеры или на координаторе в зависимости от типа операции.
Важной архитектурной конструкцией является модель обменов между воркерами. Exchange отделяет этапы обработки и позволяет переносить промежуточные данные между узлами локально или через сеть. В зависимости от характера операции используются разные стратегии обмена:
- Partitioned Exchange: данные разделяются по ключу и рассылка выполняется по соответствующим разделам; это минимизирует пролитие лишних данных и поддерживает эффективные операции объединения и сортировки.
- Broadcast Exchange: небольшие таблицы или результаты одной стороны передаются на все воркеры, что ускоряет операции типа join, если одна сторона существенно меньше другой.
- Gather/Merge: на завершающих стадиях промежуточные данные собираются наCoordinator или на выделённых воркерах для формирования итогового результата.
С точки зрения алгоритма, процесс выполнения запроса в Trino состоит из последовательности стадий: анализ, верификация, оптимизация (переписывание логического плана в физический), затем планирование распределения задач и, наконец, исполнение. Планирование учитывает доступные ресурсы (память, CPU), локальность данных и возможности операторов (join, aggregation, window functions). Баланс между параллелизмом и управлением памятью критически важен: слишком высокий уровень параллелизма может привести к перегрузке сети и задержкам, тогда как недостаточный параллелизм ограничит пропускную способность и увеличит время выполнения.
Из практических аспектов отметим: координационная часть остается относительно легковесной по вычислительной нагрузке по сравнению с воркерами, что позволяет обходиться меньшим количеством CPU на координаторе за счёт быстрой маршрутизации запросов и агрегации результатов. Однако координатор должен обладать достаточной вычислительной мощностью и оперативно реагировать на изменяющуюся нагрузку, чтобы не стать узким местом в сценариях пиковых нагрузок.
- Разделение данных на splits и их распределение по воркерам.
- Модель обменов между этапами выполнения (Partitioned, Broadcast, Gather).
- Роль планирования и оптимизации в распределённом исполнении.
# Пример минимальной конфигурации кластера Trino (упрощено) # Файл config.properties на coordinator coordinator=true node-scheduler.include-coordinator=true http-server.http.port=8080 query.max-memory=60GB query.max-memory-per-node=12GB discovery-server.enabled=true discovery.uri=http://localhost:8080Файл config.properties на воркеры
coordinator=false http-server.http.port=8080 query.max-memory=60GB query.max-memory-per-node=12GB discovery.uri=http://localhost:8080
Стратегии выполнения в кластере зависят от характеристик данных и запросов. Например, для больших присоединений (joins) целесообразна гибридная стратегия: часть данных может обрабатываться локально на воркерах, другие части — через broadcast-join для маленьких таблиц, чтобы сократить сетевой трафик. Эффективность достигается через грамотное размещение данных (data locality), выбор стратегии обмена и ленивую загрузку метаданных. В контексте архитектуры важны механизмы мониторинга и контроля ресурсов: лимиты памяти на узел, квоты на скорость выполнения, механизмы spill и хранение временных результатов на диске, что предотвращает переполнение RAM и снижает риск сбоев из-за нехватки памяти.
- Воркеры выполняют вычисления и управляют локальными состояниями.
- Координатор отвечает за планирование, безопасность и агрегацию.
- Обмен данными между узлами реализуется через Exchange с поддержкой нескольких режимов.
Роли coordinator и workers: ответственность, взаимодействие
Координатор выполняет роль «оркестратора» выполнения запроса. Он осуществляет поступающую на вход запрос, проводит синтаксический разбор, валидирует доступы и собирает статистику. Затем он строит физический план, распределяет фрагменты плана по воркерам и обеспечивает координацию их выполнения. В ходе исполнения координатор обменивается результатами между воркерами, принимает промежуточные данные, выполняет операции агрегации и фильтрации на завершающих этапах, и в конце выдает клиенту итоговый результат. В некоторых конфигурациях, если возможно, координатор также может выполнять локальные операции, но основная функция — управление потоком выполнения.
Воркеры — исполнительные единицы кластера. Они загружают данные из источников, применяют вычисления над своими splits, создают промежуточные результаты и передают их другим узлам по мере надобности. Воркеры должны обладать достаточной памятью и вычислительной мощностью, чтобы справляться с локальными операциями, такими как фильтрации, агрегации и сортировки, а также с обменами между этапами. Их задача — обеспечить устойчивость к задержкам сетевых коммуникаций и минимизировать временные затраты на ожидание данных. Воркеры поддерживают изоляцию состояний по фрагментам плана и, при необходимости, используют spill на диске для обработки больших наборов данных, чтобы не переполнить RAM.
Механика диалога между координатором и воркерами строится вокруг передачи план-фрагментов, описания границ и параметров вычислений, а также обмена промежуточными результатами. Взаимодействие происходит через сетевые каналы, которые управляются внутренними сервисами и мониторами. Воркеры могут быть назначены различными способами: статически, когда конкретный воркер закреплён за фрагментом, или динамически, когда план распределяется в зависимости от текущего состояния кластера и доступности ресурсов. В результате достигается баланс между локальностью данных, эффективностью выполнения и устойчивостью к сбоям.
- Координатор несёт ответственность за планирование и агрегацию.
- Воркеры реализуют вычисления и обмен данными.
- Эффективное выполнение достигается через грамотное распределение задач и управление ресурсами.
Протоколы взаимодействия и планирования запросов
Внутренний протокол взаимодействия между координатором и воркерами описывает последовательность шагов, необходимых для преобразования запроса в исполняемый набор задач и их последующего выполнения. На входе запроса координатор анализирует и валидирует его, после чего формируется физический план, состоящий из операторов и точек обмена. Затем план разбивается на фрагменты, которые назначаются соответствующим воркерам. Каждый воркер получает набор задач, которые он выполняет локально над своими splits, и передаёт промежуточные результаты по мере необходимости. Итоговый результат собирается и возвращается клиенту.
Ключевые элементы протокола:
- Планирование фрагментов: координатор выбирает оптимальные стратегии выполнения (например, выбор между partitioned и broadcast joins), основываясь на статистике данных и текущей загрузке.
- Распределение и исполнение: воркеры получают фрагменты, выполняют их, формируют промежуточные результаты и отправляют их к другим воркерам или обратно координатору.
- Обмен данными: Exchange-операторы управляют перемещением данных между воркерами. Выбор стратегии обмена зависит от размера данных и типа операций (соединение, агрегация, сортировка).
- Акт распознавания ошибок: в случае сетевых задержек или ошибок воркеры могут повторно отправлять задачи или переназначать их другим узлам. Координатор следит за временем ожидания и открывает механизм повторного выполнения.
Практически для инженеров важно понимать, как параметры конфигурации влияют на поведение протокола. Например, размер памяти на воркерах и лимит по памяти на этапе выполнения могут определять, когда начинается spill на диск, что, в свою очередь, влияет на стоимость сетевых операций и задержки ответа. В контексте оптимизаций следует учитывать статическую статистику, обновляемую каталогами (метаданные о таблицах и разделах) и динамическую статистику во время выполнения.
- Распределение задач по плану и фрагменты плана.
- Типы обмена между воркерами и их влияние на производительность.
- Обработка ошибок и повторное выполнение.
Масштабирование, отказоустойчивость и интеграции
Масштабирование кластера Trino может осуществляться горизонтально: добавлением воркеров по мере роста объёма данных и числа запросов. При этом координатор остаётся точкой планирования и координации, а воркеры — источниками параллелизма. В идеальном случае добавление узлов приводит к снижению времени выполнения за счёт увеличения количества исполняемых задач и улучшения локальности чтения данных. При этом важно обеспечить баланс ресурсов: слишком большое число воркеров без достаточной памяти и пропускной способности сети может привести к перегрузке и ухудшению латентности.
Отказоустойчивость достигается за счёт нескольких механизмов:
- Спилл на диск. Когда объём данных для обработки превышает доступную RAM, временные результаты записываются на диск, чтобы избежать переполнения памяти и сбоев.
- Репликация плана и метаданных. Координатор хранит информацию о текущем исполнении и может повторно запустить задачу на другом узле в случае сбоя.
- Мониторинг и алерты. Встроенные инструменты наблюдения позволяют оперативно выявлять узкие места, такие как задержки на конкретных воркерах или проблемы с подключением к источникам данных.
- Каталоги и интеграции. Взаимодействие с каталогами, такими как Hive Metastore, обеспечивает консистентность схем и статистик, которые необходимы для корректного планирования. Интеграции с внешними источниками данных требуют соответствующего драйвера и коннекторов, которые могут поддерживать ленивую загрузку схем, а также адаптеры для чтения параллельными потоками.
Ключевые интеграционные сценарии включают:
- Hive Metastore в качестве каталога метаданных: обеспечивает единый источник истины о схемах, таблицах и разделах и поддерживает параллельное выполнение запросов через коннекторы к данным.
- Облачные хранилища и локальные файловые системы: выбор стратегии чтения и извлечения данных зависят от конкретного источника, но общая концепция разделения данных и параллельного чтения остаётся неизменной.
- Коннекторы к разнообразным СУБД и хранилищам: они позволяют Trino вести запросы к данным, размещённым в разных системах, и объединять результаты в единой аналитической плоскости.
Практические рекомендации по архитектуре и эксплуатации:
-
Выбирайте подходящий баланс между координатором и воркерами в зависимости от нагрузки и объема данных. При высокой конкуренции запросов балансировать следует в сторону большего количества воркеров и оптимизированного плана.
-
Настраивайте memory budgets и spill-пути, чтобы предотвратить переполнение памяти и обеспечить устойчивость к пиковым нагрузкам.
-
Обеспечьте надёжную связь с каталогами и источник данных, минимизируя задержки на чтение схем и разделов, а также поддерживая актуальные статистики.
-
Реализуйте мониторинг на уровне узлов, потоков и Exchange-операций, чтобы выявлять узкие места и оперативно масштабировать кластер.
-
Масштабирование и отказоустойчивость.
-
Интеграции с каталогами и источниками данных.
-
Практические рекомендации по конфигурации.
Примеры реализации и практические соображения
Для иллюстрации реальных сценариев рассмотрим два типовых паттерна развёртывания:
- Локальный кластер на Kubernetes. В этом случае координационный узел и воркеры разворачиваются как поды, управляемые оркестратором. Преимущества — гибкость развертывания, простая эластичность и быстрый отклик на изменения нагрузки. Важные аспекты: настройка discovery-сервиса, ограничение ресурсов под каждую ноду, горизонтальное масштабирование воркеров и мониторинг через стандартные инструменты Kubernetes.
- Облачная инфраструктура с выделенными узлами. Часто применяется сочетание облачных вычислительных ресурсов и внешних хранилищ. Здесь существенную роль играют стратегии кэширования, совместное использование схем и централизация метаданных через Hive Metastore или аналогичные каталоги. Основной вызов — поддержание согласованности между источниками и эффективное использование пропускной способности сети.
Практические шаги к развёртыванию:
-
Определение роли узлов: один или несколько координаторов, остальные — воркеры.
-
Настройка Discovery-сервиса и каталогов: указать URI-адреса, обеспечить доступ к Hive Metastore или другому каталогу.
-
Конфигурация ресурсной политики: memory budgets на узел, лимиты на параллелизм, настройки spill.
-
Тестирование на тестовом наборе данных: проверить параллелизм, производительность и кожухи отказоустойчивости.
-
Мониторинг и алёрты: настройка метрик по задержкам, загрузке CPU, задержкам на обменах и прочим критическим путям.
-
Развёртывание координационных узлов и воркеров.
-
Настройка каталогов и коннекторов.
-
Практические советы по мониторингу и управлению ресурсами.
Key takeaways
- В Trino архитектура строится вокруг централизованного координатора и распределённой группы воркеров, что обеспечивает эффективное разделение ролей между планированием и исполнением.
- Разделение данных на splits и использование Exchange-операций позволяют добиваться высокой параллелизации и управляемого обмена промежуточными результатами между узлами.
- Эффективное выполнение запросов достигается за счёт грамотной настройки планирования, выбора стратегий обмена и баланса ресурсов в кластере.
- Масштабирование кластера достигается горизонтальным добавлением воркеров и адаптацией памяти, spill и сетевых факторов под нагрузку.
- Интеграции с каталогами (например, Hive Metastore) и коннекторами обеспечивают единый слой доступа к данным и корректную статистику для планирования.
- Физическая архитектура кластера требует внимания к мониторингу и устойчивости к сбоям: spill, повторное выполнение задач и распределение нагрузки помогают сохранить производительность и доступность.
- Практические сценарии развёртывания (локально в Kubernetes и в облаке) требуют чёткой стратегии управления ресурсами, безопасности и согласованности данных.
FAQ
Какова основная роль координатора в Trino?
- Координатор выполняет роль центрального планировщика и агрегатора. Он принимает входящий запрос, выполняет его синтаксический разбор, валидирует безопасность, формирует физический план, распределяет задачи по воркерам и, в ходе выполнения, собирает промежуточные и итоговые результаты. Кроме того, координатор отвечает за статистики, мониторинг и координацию обменов между узлами. Важно, что координатор не участвует в обработке всех данных напрямую, а управляет распределённой операцией и обеспечивает целостность вычислений.
Какие задачи выполняют воркеры и чем они отличаются от координатора?
- Воркеры непосредственно исполняют вычисления над данными: чтение из источников, применение операторов фильтрации, агрегации, соединения и сортировки. Они обрабатывают конкретные splits и обмениваются промежуточными результатами через Exchange-операторы. Воркеры работают параллельно, под управлением плана, который разработал координатор. В отличие от координатора, воркеры ориентированы на вычислительную работу и сетевую коммуникацию, а не на планирование.
Какие типы обмена данных используются между воркерами?
- В Trino применяются несколько стратегий обмена: Partitioned Exchange (распределение данных по ключу и параллельная обработка разделов), Broadcast Exchange (транслирование небольших наборов данных на все воркеры), и Gather/Merge (сбор промежуточных результатов в одном узле для финального агрегационного шага). Выбор стратегии зависит от размера данных, типа операции и локализации данных. Эффективность достигается за счёт минимизации сетевого трафика и оптимального распределения вычислительной нагрузки.
Как осуществляется масштабирование кластера?
- Масштабирование осуществляется горизонтально: добавляются новые воркеры, при необходимости — дополнительные координаторы. Важно учесть ресурсы каждого узла: память, CPU и сеть. Добавление воркеров должно сопровождаться корректной настройкой памяти и spill-пути, чтобы ответственность за обработку данных не приводила к перегрузке узлов. Поддержка каталога и коннекторов должна сохраняться в работоспособном состоянии при изменении размера кластера.
Какие практические требования к конфигурации для устойчивости?
- Необходимо задать разумные лимиты памяти на узел и per-node budgets, включить spill на диск для больших запросов, обеспечить надёжные сетевые каналы и устойчивость к сбоям через повторное выполнение задач. Также важна корректная настройка discovery-сервиса и каталогов, чтобы координатор мог эффективно планировать и заражать данные. Мониторинг и алерты должны быть встроены для своевременного реагирования на пиковые нагрузки и потенциальные узкие места.
Каковы лучшие практики для интеграции с каталогами и источниками данных?
- Использование Hive Metastore как каталога метаданных обеспечивает единый источник схем и статистик, что улучшает точность планирования. Коннекторы к внешним источникам должны поддерживать параллельное чтение и эффективную обработку метаданных. Регулярное обновление статистик и кэширование часто используемых схем снижает задержки планирования и повышает общую производительность.
Какие типичные проблемы возникают при работе с архитектурой coordinator и workers?
- Узкие места на координаторе при пиковых нагрузках и сложных планах, перегрузка памяти на воркерах, высокая задержка обмена между узлами, а также несогласованность статистик метаданных. Решение предполагает балансировку нагрузки, увеличение числа воркеров, настройку spill и улучшение конфигурации каталогов. Важно также обеспечить устойчивость к сбоям и корректное поведение планирования в условиях ограниченных ресурсов.
Какую роль играют инструменты мониторинга в архитектуре?
- Мониторинг позволяет отслеживать загрузку процессоров, использование памяти, задержки на обменах, количество активных задач и состояние узлов. Он помогает выявлять узкие места, планировать масштабирование и предупреждать проблемы до того, как они повлияют на выполнение запросов. Мониторинг обычно интегрируется с внешними системами наблюдения и алертами, обеспечивая оперативную реакцию.
Какие сценарии можно рассмотреть для обучения и внедрения?
- Практическое внедрение в рамках локального кластера на Kubernetes для разработки и тестирования, переход на облачную инфраструктуру для масштабируемых рабочих нагрузок, а также постепенное внедрение с учётом отраслевых требований к данным и безопасности. В каждом сценарии следует уделить внимание настройке памяти, обменов и конфигурации каталогов.
Какова роль безопасности в архитектуре распределённых вычислений?
- Безопасность должна быть встроена на всех уровнях: управление доступом к данным, разграничение прав выполнения, шифрование при передаче данных между узлами и аудит операций. В контексте архитектуры координатора и воркеров важно обеспечить проверку аутентификации и авторизации на этапе планирования и выполнения, а также защиту конфигурационных файлов и секретов.


