

StarRocks в Kubernetes: развертывание, масштабирование и автоматизация эксплуатации
Современные аналитические системы требуют инфраструктуры, способной обрабатывать большие объёмы данных с минимальными задержками и при этом масштабироваться вместе с ростом нагрузки. В этой роли всё чаще используются аналитические базы данных нового поколения, оптимизированные для OLAP-запросов и потоковой загрузки данных. StarRocks относится к таким системам: он сочетает высокопроизводительный движок аналитических запросов, колоночное хранение данных и архитектуру, рассчитанную на горизонтальное масштабирование.
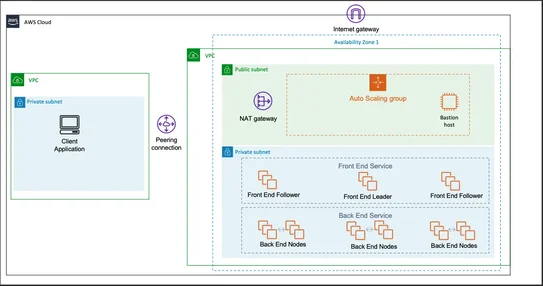
В корпоративных средах такие системы всё чаще разворачиваются в Kubernetes, который обеспечивает стандартизированное управление инфраструктурой, автоматизацию эксплуатации и гибкое масштабирование кластеров. В этом разделе рассматриваются архитектура StarRocks и особенности её работы в Kubernetes: компоненты FE и BE, модели развёртывания через Helm и Operators, управление хранением и сетью, а также практические аспекты эксплуатации — безопасность, мониторинг, производительность и стратегии масштабирования аналитической платформы.
- Введение: StarRocks в Kubernetes, цели и аудитория
- Терминология и базовые концепции StarRocks: FE, BE, индексы, репликация
- Архитектура StarRocks: принципы обработки запросов, хранение данных
- Архитектура StarRocks в Kubernetes: поды, контейнеры, StatefulSet, CRD
- Контекст применения в корпоративной аналитике: сценарии, требования SLA/OLAP
- Инфраструктурные требования под StarRocks в Kubernetes: сеть, хранилище, вычисления
- Модели развёртывания в Kubernetes: Helm, Operator, CustomResource
- Выбор подхода к развёртыванию: плюсы и минусы чарта vs оператора
- Управление данными и хранением: CSI, классы хранения, блочное vs объектное
- Сетевые аспекты: сервис-дискавери, балансировка, политики сетей
- Безопасность и управление доступом: RBAC, Secrets, шифрование, аутентификация
- Управление конфигурациями: ConfigMaps, Helm values, CRD-списки
- Интеграции с источниками данных: конвейеры, источники входных данных, коннекторы
- Интеграция с инструментами загрузки данных: ETL/ELT паттерны, Stream ingestion
- Управление схемами и моделями данных: таблицы, партиционирование, типы данных
- Репликация, шардинг и консистентность: режимы, политики репликации
- Масштабирование и баланс нагрузки: горизонтальное масштабирование, кластерная архитектура
- Автоматизация эксплуатации: GitOps, CI/CD, IaC, инструменты
- Мониторинг и observability: метрики, логи, трассировка, алерты
- Производительность и конфигурации: тюнинг StarRocks и Kubernetes
- Управление ресурсами и стоимостью: лимиты, квоты, профили узлов, оптимизация затрат
- Резервное копирование, восстановление и DR: стратегии, тестирование восстановления
- Обновления и миграции: стратегии без простоя, тестирование апгрейдов
- Тестирование и валидация: бенчмарки, нагрузочное тестирование, регрессионные тесты
- Кейсы внедрения: практические примеры в разных отраслях
- Архитектурные паттерны развёртывания: единый кластер, мультиарендность, мультикластерность
- Управление рисками: безопасность, комплаенс, аудит, план по инцидентам
- Руководство по операционной практике: runbooks, чек-листы, процессы инцидентов
- План развития компетенций команды и дорожная карта проекта
- Временные горизонты внедрения и обзор будущих возможностей StarRocks в Kubernetes


