

Архитектура данных для MLOps: сбор, качество, lineage, доступ и управление метаданными
Краткое введение
Эта глава систематизирует принципы архитектуры данных в контексте MLOps, охватывая сбор данных, обеспечение качества, отслеживание lineage, управление доступом и метаданными. В условиях гибридной инфраструктуры (облако и on-premise) правильная архитектура становится критической основой для воспроизводимости моделей, соблюдения регулятивных требований и управляемых затрат. Мы рассмотрим архитектурные шаблоны, соответствующие инструментальные стеки, а также конкретные примеры реализации на открытом стеке и отечественных решениях.
Введение
В современном МLOps-пейзаже данные - не просто входной ресурс, а актив проекта. Их качество, ясная связь с моделями (lineage), доступность для команд и управляемость метаданными определяют скорость вывода моделей в продакшн, безопасность данных и возможность аудита. Архитектура данных для MLOps должна обеспечивать:
- сбор данных из разнообразных источников в единый поток данных;
- контроль качества данных на всех этапах жизненного цикла;
- полноту и прозрачность lineage от источников до обученных моделей и предсказаний;
- управляемый доступ к данным с учетом регуляторных требований и политик;
- единое управление метаданными, включая каталог, контрактность данных и связь между датасетами, признаками и моделями.
Эта глава посвящена тому, как спроектировать такую архитектуру, какие архитектурные решения подходят для облака, on-premise или их гибридной смеси, и какие практики позволяют снизить риски и повысить отдачу от инвестиций в инфраструктуру и процессы MLOps.
Теоретические основы и терминология
- Архитектура данных для MLOps - совокупность паттернов, стандартов и инструментов, которые обеспечивают сбор, хранение, обработку, качество, lineage, доступ и управление метаданными в контексте ML-цикла от идеи до продакшна.
- Сбор данных (data ingestion) - процесс объединения данных из множества источников**: лог-файлы, базы данных, потоковые источники, API, файлы и т. п.
- Качество данных (data quality) - совокупность метрик и правил, которые оценивают пригодность данных для конкретных сценариев: корректность значений, полнота, консистентность, своевременность.
- Lineage (линейность данных) - трассировка происхождения данных**: от источника до конечного использования в моделях и предсказаниях, включая версии данных и трансформации.
- Доступ и безопасность - механизмы контроля доступа, сегментации, шифрования и аудита, обеспечивающие защиту данных и соответствие политик.
- Управление метаданными (metadata management) - централизованное хранение и управляемые процессы над информацией о данных: источники, форматы, версии, владельцы, контракты качества, зависимые артефакты (датасеты, признаки, эксперименты, модели).
Ключевые понятия в рамках данной темы:
- Data catalog (каталог данных) - упорядоченная инвентаризация датасетов и артефактов, с описаниями, метаданными и связями между ними.
- Feature store (хранилище признаков) - специализированное хранилище для повторного использования признаков в обучении и в онлайн-подсчетах.
- Data governance (управление данными) - политики, роли, процессы и процедуры, обеспечивающие надлежащее использование данных.
- Data contracts (контракты данных) - явное соглашение о качестве и формате данных между поставщиком и потребителем.
- Open standards и OpenLineage - открытые форматы и интероперабельные протоколы для сбора и передачи информации о lineage.
Методологии и подходы
- Data Mesh vs Data Lakehouse vs Data Fabric
- Data Mesh предлагает децентрализованный подход к владению данными: доменные продуктовые команды несут ответственность за наборы данных и их качество в рамках своих контекстов.
- Data Lakehouse объединяет хранение больших объемов неструктурированных и структурированных данных с возможностью их эффективной обработки и аналитики.
- Data Fabric обеспечивает унифицированную среду доступа к данным независимо от их размещения.
- Контракты данных и контрактно-ориентированное управление качеством
- Формализуйте ожидания по данным: формат, диапазоны значений, частота обновления, задержки потока.
- Инструменты: Great Expectations, Deequ, Great Expectations на этапе конвейера, интеграция с каталогом.
- Метаданными к экосистемам ML
- Использование ML Metadata (MLMD) для отслеживания: датасетов, признаков, экспериментов, моделей и связанных артефактов.
- Встраивание lineage как обязательной части процесса обучения и развёртывания моделей.
- Архитектурные паттерны
- Event-driven ingestion: событийная архитектура с использованием потоков (Kafka/Flink) для своевременного попадания данных в хранилища.
- Lambda vs Kappa
- Kappa-архитектура для упрощения обработки потоков и единообразия данных.
- Multi-layer storage: "мир данных" может включать Data Lake, Data Warehouse и Feature Store, соединенных через управляемые каталоги и линейку.
- Безопасность и соответствие
- RBAC/ABAC + политики на уровне данных, шифрование в покое и в транзите, аудит доступа.
- Регулируемые данные: маскирование, минимальный доступ, принцип наименьших привилегий.
Архитектура и технологическая реализация
- Общий стек компонентов
- Источники данных: БД, файлохранилища, потоковые источники (Kafka, Kinesis).
- Инфраструктура обработки: Spark, Flink, Beam, Kubernetes.
- Хранилища: Data Lake (S3/HDFS/облачное object storage), Data Warehouse (Snowflake, BigQuery, ClickHouse), или гибридные варианты.
- Метаданные и каталог: Amundsen, DataHub, Apache Atlas, Yaндекс DataSphere (для российских реалий).
- Lineage и контрактность: OpenLineage, MLMD, интеграция через коннекторы в оркестраторе.
- Хранилище признаков: Feast (или альтернативы в рамках open-source/локального стека).
- Инструменты качества данных: Great Expectations, Deequ, партии тестов в CI/CD.
- Оркестрация и контроль версий: Airflow, Dagster, Kubeflow Pipelines, Argo Workflows.
- Безопасность и управление доступом: Apache Ranger, OPA (Open Policy Agent), IAM, шифрование и хранилища секретов.
- Архитектурная схема в виде текстовой диаграммы
- Источники данных -> Инфраструктура ingestion -> Data Lake/Data Warehouse -> Хранилище признаков (Feature Store) -> Модели и предсказания
- Каталог данных и метаданные связывают датасеты, признаки, эксперименты и модели
- OpenLineage/MLMD собирают lineage и затягивают в каталог и трекер экспериментов
- Контракты качества и проверки данных выполняются на разных стадиях (ETL/ELT)
- Управление доступом и аудит осуществляются через политический слой поверх всех компонентов
Пример псевдореализации в архитектуре (уровень абстракции):
- Ingestion Service (Kafka) -> Raw Layer (HDFS/S3) -> Processing Layer (Spark/Beam) -> Clean/Curated Layer -> Data Warehouse
- Data Catalog Service (Amundsen/DataHub) индексирует коллекции датасетов и их признаки
- Feature Store ( Feast) обращается к Clean Layer для обучения и онлайн-подсчета
- Model Registry и Experiment Tracking (MLflow/Kubeflow) связывают модели с датасетами и признаками, которые они используют
- Lineage Service (OpenLineage) собирает трассировку всех трансформаций и связывает с артефактами
- Data Quality Service (Great Expectations/Deequ) валидирует данные по контрактам и публикует метрики в каталог
- Access Control Layer (OPA/Ranger) обеспечивает политическую защиту на уровне данных и API
Ключевые современные реализации и инструменты
- Open-source стеки
- Amundsen или DataHub в качестве каталога данных
- OpenLineage для lineage
- Great Expectations и Deequ для качества данных
- Feast для управления признаками
- MLflow и Kubeflow для экспериментального учёта и конвейеров
- Apache Atlas как часть управляемой инфраструктуры на базе Hadoop-окружения
- Airflow/Dagster/Kubeflow Pipelines для оркестрации и интеграции
- Российские/отечественные решения
- Яндекс DataSphere как российская платформа для совместной работы над данными и ML-проектами, поддерживающая каталоги, пайплайны и управление метаданными в рамках отечественной инфраструктуры и регулятивных требований.
- В рамках локальных проектов применяются открытые конвейеры и каталоги в сочетании с локальными системами хранения и сетевой безопасностью, адаптированными к требованиям госучреждений и крупных корпораций. Применение отечественного стека обычно связано с применением сертифицированных решений по данным, интеграцией с внутренним удостоверением и аудитом доступа.
- В кейсах крупных банков и телеком-компаний часто сочетают открытые инструменты с локальными модулями мониторинга и управления безопасностью, адаптированными под регуляторные требования и данные по хранению в локальном дата-центре.
- Примеры паттернов реализации
- Гибридная архитектура: данные из облака и локальных источников объединяются через единый каталог и governance-шлюз, обеспечивая единый интерфейс доступа.
- Контракты качества задаются на уровне датасетов и признаков, валидируются на этапе ELT-процессов, и результаты фиксируются в каталоге.
- Линейность и васаби-трассировка: lineage собирается через OpenLineage и ML Metadata, обеспечивая взаимосвязь источников, трансформаций, датасетов, признаков, экспериментов и моделей.
Организационные и процессные аспекты
- Роли и ответственности
- Data Owner - владелец набора данных, отвечает за корректность содержания и согласование политики использования.
- Data Steward - ответственный за качество, описание и поддержку данных, мониторинг контрактов.
- ML Engineer/Data Scientist - пользователи данных, которые создают признаки, обучают модели и применяют результаты.
- Platform Team - команда, которая обеспечивает инфраструктуру, интеграции, безопасность и мониторинг.
- Процессы управления метаданными
- Регистрация датасетов и признаков в каталоге; привязка к источникам и версиям.
- Определение контрактов данных и автоматическая проверка на каждом этапе CI/CD.
- Регистрация экспериментов и артефактов: данные, признаки, модель, метрики.
- Постоянный мониторинг качества данных и lineage; автоматическая алертинг в случае отклонений.
- Процедуры доступа и безопасности
- Многоуровневая аутентификация и авторизация, RBAC/ABAC, политики на уровне сервисов.
- Шифрование данных в покое и в транзите, аудит доступа.
- Политики минимального доступа (least privilege) для исследовательских и продовых окружений.
- Управление затратами
- Контейнеризация и оркестрация: эффективное использование кластеров, автоматическое отключение неиспользуемых ресурсов.
- Хранение: выбор между hot/creeze-стратегиями хранения, lifecycle rules для архивирования.
- Мониторинг затрат на конвейеры ML, учёт использования признаков и экспериментов.
Практические примеры и кейсы (open-source и российские решения)
- Кейсы open-source
- Пример 1: Внедрение lineage через OpenLineage + Airflow, с интеграцией с Amundsen как каталогом и Great Expectations как инструментом качества. Этот набор обеспечивает прозрачность происхождения данных и качества на каждом шаге конвейера.
- Пример 2: Использование Feast как хранилища признаков в связке с Kubeflow Pipelines и MLflow для управления экспериментами; совместная работа над признаками и повторное использование в обучении.
- Пример 3: Архитектура на основе Data Lakehouse: Spark + Delta Lake + DataHub/Amundsen, плюс Apache Atlas в части предприятий, для обеспечения совместимости с существующими данными и регулятивными требованиями.
- Пример 4: Great Expectations в пайплайне ELT: контракты качества, автоматические проверки и визуализация результатов. По мере роста данных эти проверки помогают поддерживать согласованность и контрактность.
- Российские решения и кейсы
- Пример российского решения: использование Яндекс DataSphere в рамках отечественного ML-проекта для централизованного управления данными и экспериментами, с адаптацией под требования регуляторов и локальные политики доступа. Примером может служить интеграция каталога, пайплайнов и мониторинга в рамках единой инфраструктуры.
- Практические кейсы в крупных российских организациях: внедрение гибридной архитектуры, где данные и вычисления проходят через локальные дата-центры и интегрированы с облачными компонентами, что позволяет соблюсти регуляторные требования и контроль затрат.
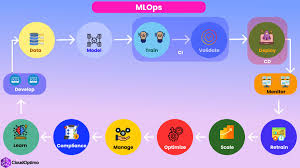
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Архитектурная схема взаимодействия компонентов
- Источники данных -> Ingestion Layer (Kafka, Flink) -> Data Lakes/Curated Layer (S3/HDFS) -> Data Warehouse (Snowflake, ClickHouse, BigQuery) -> Feature Store (Feast) -> Модели и предсказания
- Каталог данных (Amundsen/DataHub) индексирует датасеты, признаки; Lineage (OpenLineage) собирает трассировку трансформаций; Контракты качества (Great Expectations) валидируют данные; ML Metadata (MLMD) связывает датасеты, признаки и эксперименты.
- Политики доступа через OPA/Ranger применяются на уровне API и сервисов.
- Протоколы и интеграции
- OpenLineage как стандартный протокол передачи метаданных линейности между оркестратором (Airflow/Kubeflow) и каталогом.
- MLMD как база для метаданных экспериментов и моделей, связанная с датасетами и признаками.
- REST/GraphQL API для каталогов данных и управления доступом, поддержка webhooks для уведомлений об изменениях.
- Пример реализации: сборка пайплайна
- Ingest data from source systems (Kafka/DB) into Raw zone.
- Transform, validate, and load into Curated zone with quality checks (Great Expectations).
- Catalog datasets and features in Amundsen/DataHub; record lineage via OpenLineage.
- Train model using curated features; log artifacts in MLflow; register model in Model Registry.
- Deploy and monitor; lineage continues to track data-to-model relationships.
- Алгоритмы контроля качества
- Контракты данных: schema validation, value ranges, nullability, referential integrity.
- Проверки регрессионного качества: drift detection для распределений признаков, мониторинг пропусков и аномалий.
- Регулярные повторные валидации после обновления данных или моделей.
- Архитектурные паттерны реализации
- Контейнеризация сервисов и использование Kubernetes для масштабирования.
- Инструменты мониторинга: Prometheus/Grafana, OpenTelemetry для трассировки.
- Безопасность: секреты через Vault/ Kubernetes Secrets, RBAC для сервисов и пользователей.
Риски, ограничения и типовые ошибки
- Риски
- Потеря lineage из-за изменений в пайплайнах или несовместимых версий инструментов.
- Несогласованность между каталогом данных и фактическими источниками, что приводит к неверной интерпретации.
- Сложность синхронизации данных между облаком и on-premise, что может приводить к задержкам и конфликтам версий.
- Проблемы безопасности и соответствия: утечки, утраты аудита, слабая сегментация.
- Ограничения
- Вендорная зависимость и сложности миграции между инструментами.
- Ограничения пропускной способности в гибридных сетях и регулятивные требования к локализации данных.
- Стоимость хранения и обработки, особенно в случае больших датасетов и сложных конвейеров.
- Типовые ошибки
- Игнорирование контрактов и несогласованность между данными и их потребителями.
- Непрактическая детализация lineage, которая не покрывает критически важные этапы ETL/ELT.
- Отсутствие единого едва ли полного каталога; фрагментарные подходы, ведущие к распылению информации.
- Недостаточная автоматизация тестирования качества данных и несвоевременная реакция на отклонения.
Перспективы развития направления
- Общее направление: усиление контрактности данных и автоматизация качества в рамках ML-пайплайнов, расширение связей между датасетами, признаками и моделями.
- Технологические тренды
- Развитие OpenLineage и стандартизация линейности в облачных и локальных средах.
- Расширение возможностей Data Mesh: автономные домены, ответственность за данные внутри команд и более быстрая адаптация к изменениям.
- Увеличение роли автоматической настройки политик доступа и аудита через Policy-as-Code (OPA).
- Интеграция governance-процессов с управлением ответственностями и прозрачностью для регуляторных требований.
- Эволюция инфраструктуры
- Продвижение hybrid-first архитектур, где доступ и безопасность становятся единым сервисом across clouds и локальных систем.
- Более тесная связка между датасетами, признаками и моделями через расширенные метаданные и более детализированные lineage.
- Внедрение автоматизированного мониторинга качества, предиктивной алертинг и автоматического реагирования на признаки дрейфа.
- Образовательные и методические выводы
- Непрерывное обучение команд в области эксплуатации MLOps-инфраструктуры и управления данными.
- Внедрение повторяемых и документированных паттернов, которые можно адаптировать под отраслевые требования и регулятивные рамки.
Заключение
Архитектура данных для MLOps - это не просто набор инструментов. Это управляемая экосистема, которая обеспечивает воспроизводимость, безопасность и эффективность ML-цикла. В условиях гибридной инфраструктуры важна единая стратегия сбора, качества, lineage, доступ и управления метаданными: она позволяет командам быстро адаптироваться к изменениям требований, снижает риск регуляторных нарушений и обеспечивает прозрачность для стейкхолдеров. Реализация требует синергии между архитектурой, технологиями и организационными процессами: только так можно достичь устойчивой ценности от ML-проектов и развивать направление MLOps в долгосрочной перспективе.
FAQ (7-10 вопросов с развернутыми ответами)
Какую роль играет архитектура данных в общем цикле MLOps?
Она задаёт базовую основу для воспроизводимости и управляемости: от сбора данных до обучения, развёртывания и мониторинга моделей. Без прозрачной lineage и контроля качества данных добиться повторяемости сложно, особенно в гибридной среде. Архитектура данных обеспечивает связность между датасетами, признаками, экспериментами и моделями, что критично для аудита и регуляторных требований.
Какие компоненты являются критическими для сборки MLOps-архитектуры?
Источники данных, ingestion-layer, Data Lake/Data Warehouse, каталог данных, lineage, качество данных, хранилище признаков (Feature Store), оркестрацию пайплайнов, управление метаданными (MLMD), политики доступа и аудит. Все эти элементы работают в связке для обеспечения воспроизводимости и управляемости.
Какие открытые инструменты наиболее часто применяются для этих задач?
Каталоги данных: Amundsen, DataHub.
Линейность и метаданные: OpenLineage, ML Metadata (MLMD).
Качество данных: Great Expectations, Deequ.
Хранилище признаков: Feast.
Оркестрация: Airflow, Dagster, Kubeflow Pipelines.
Эксперименты и модели: MLflow, Kubeflow.
Безопасность: OPA, Apache Ranger.
Как реализовать lineage в гибридной среде облако-on-premise?
Использовать OpenLineage как прозрачный протокол обмена метаданными между оркестратором и каталогом данных, дополнительно внедрить MLMD для экспериментов и зависимостей между датасетами и моделями. Обеспечить защиту и аудит через единую политику доступа (OPA/Ranger) и хранение версии данных и трансформаций в каталоге.
Какие методы обеспечивают качество данных в MLOps?
Контракты данных и валидаторы на этапах ELT/ETL, автоматические проверки в пайплайнах, drift-detection, мониторинг пропусков и аномалий, версионирование датасетов и признаков. Важно не только тестировать данные, но и документировать контракт в каталоге.
Как организовать доступ к данным и безопасность в архитектуре MLOps?
Внедрить RBAC/ABAC, разделение зон доступа, политики на уровне сервисов и данных, шифрование в покое и в транзите, аудит и журналирование. Использовать OPA для политики, интегрировать с Kubernetes и сервисами API. Регулярно пересматривать политики и проводить аудит.
Какие риски наиболее характерны для архитектуры данных в MLOps, и как их минимизировать?
Риск потери lineage, несоответствие данным контрактам, регуляторные нарушения и угроза безопасности. Минимизировать можно через автоматическое тестирование качества, поддержку единого каталога, стандарты версионирования и документирования, а также мониторинг изменений в пайплайнах и данных.
Какие перспективы следует учитывать при планировании развития архитектуры?
Расширение контрактности и автоматизации, внедрение data mesh-ориентированных паттернов, усиление governance-процессов через policy-as-code, углубление интеграции между данными и моделями через расширенные метаданные и более детальную lineage, адаптация к регулятивным требованиям отрасли.
Какие примеры российских решений можно привести помимо открытого стека?
Российские решения обычно интегрируют открытые инструменты с локальными модулями управления безопасностью и аудита, адаптированными к регуляторным требованиям. Примером может служить Яндекс DataSphere - российская платформа, предоставляющая функционал для совместной работы над данными, пайплайнами и управлением метаданными в рамках отечественной инфраструктуры. Это демонстрирует возможность реализации эффективной архитектуры в рамках локальной инфраструктуры и регулятивной среды.
Как начать внедрение архитектуры данных для MLOps в вашей организации?
Определите стратегию и принципы управления данными: цели, требования к регулятивности, роли и ответственности. Разработайте единый каталог датасетов и признаков, контрактность данных, и интегрируйте линейность в существующие пайплайны. Постройте минимально жизнеспособную архитектуру с OpenLineage+каталог+Quality, затем постепенно добавляйте Feast, MLMD и orchestration, учитывая требования по безопасности и затратам. Продолжайте развивать governance-процессы и обучайте команды новым паттернам и инструментам.
Эта глава дает целостное понимание того, как проектировать архитектуру данных для MLOps в условиях облака и on-premise, как выбирать инструменты, какие паттерны и практики применять, и какие риски учитывать на каждом этапе жизненного цикла моделей.
Если ваша компания планирует внедрение машинного обучения или масштабирование AI-решений, ключевым фактором успеха становится правильная архитектура платформы данных и MLOps-инфраструктуры.
Узнайте, как реализовать искусственный интеллект для бизнеса от стратегии до внедрения: от оценки готовности компании и выбора архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы.


