

Будущее направление MLOps: новые технологии, автоматизация и этика
Краткое введение
Современная практика MLOps выходит за рамки автоматизации конвейеров обучения моделей. В контексте курса «MLOps в облаке и on-premise выбор инфраструктуры, масштабирование и управление затратами» этот раздел посвящён тем, как развиваются направления в области автоматизации, инженерии данных и этики. Мы рассмотрим, какие новые технологии формируют будущее MLOps, как строятся автоматизированные конвейеры в гибридных облаках и на локальных инфраструктурах, и какие этические принципы должны быть встроены в процессы жизненного цикла моделей. В условиях ускоренного внедрения основанных на больших языковых моделях систем (foundation models) роль надёжной инфраструктуры, контроля затрат и соблюдения регуляторики становится критической как для коммерческих, так и для государственных проектов.
Введение
MLOps как дисциплина синтезирует DevOps-практики с требованиями к качеству данных, воспроизводимости моделей и надёжности эксплуатации. Будущее направление MLOps: новые технологии, автоматизация и этика ориентировано на расширение возможностей автономизации процессов, повышения прозрачности и снижения рисков. В этом разделе мы объединяем теоретические основы с практическими паттернами внедрения в облаке и on-premise: от автоматического приготовления инфраструктуры и данными до интеграции этических рамок и регуляторных требований в конвейеры поставки моделей. В рамках курса рассматриваются как архитектурные решения, так и организационные аспекты, чтобы сформировать целостное представление о том, как проектировать устойчивые МЛ-операции.
Теоретические основы и терминология
- МЛ lifecycle и MLOps: различия и сходство с DevOps. В MLOps добавляются этапы подготовки данных, валидации признаков, мониторинга данных и моделей на протяжении всего жизненного цикла.
- Репродуктивность и детерминированность: от версионирования данных до управления зависимостями кода и окружения.
- Управление данными и этика: контроль доступа, приватность, защита персональных данных, справедливость моделей, прозрачность принятия решений и аудит.
- Архитектурные паттерны: data lakehouse, feature store, model registry, пайплайны и оркестрация, наблюдаемость (observability) и управление затратами.
- Терминология: data lineage, data drift, concept drift, feature store, model registry, continuous training, canary deployment, A/B тестирование моделей, рефакторинг признаков, governance.
Методологии и подходы
- Эволюционные модели зрелости MLOps: от локальных пайплайнов к масштабируемым платформам с автоматическим масштабированием и управлением затратами.
- Feature store как единый источник истины для признаков, с поддержкой версии и ретроспективного анализа.
- Наблюдаемость и качество данных: мониторинг качества входящих данных, обнаружение сбоев данных, валидность признаков, обнаружение data drift.
- Безопасность и соответствие требованиям: аутентификация, авторизация, шифрование данных в покое и в передаче, журналирование аудита.
- Управление затратами: оценка TCO, выбор между облачными и on-premise решениями, бюджеты на хранение, вычисления и лицензии.
Архитектура и технологическая реализация
Контекст: архитектура будущего MLOps опирается на гибридность инфраструктуры, управление жизненным циклом моделей и автоматизацию процессов. Рассмотрим типовую целевую архитектуру, примерную схему данных и технологические компоненты.
- Архитектурная карта
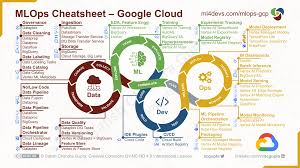
- Data ingestion и обработка: ingestion layer → pre-processing → feature engineering → data validation.
- Feature store: единый слой признаков с версионированием и lineage.
- Model training и evaluation: репозитории кода и зависимостей, конфигурации обучения, регистры версий моделей.
- Model serving и inference: инфраструктура развертывания, canary/rolling updates, наблюдаемость и алерты.
- Observability и governance: метрики, логи, OpenTelemetry, OpenLineage, доступ к журналам аудитов.
- Cost management: бюджеты, аллокации, оптимизация использования вычислительных ресурсов.
- Технологическая реализация: выбор стеков в облаке и on-premise
- Оркестрация и конвейеры: Kubeflow Pipelines, Apache Airflow, Dagster, MLRun.
- Хранение признаков: Feast, alternatives with integration into Kubernetes.
- Registry и контроль версий моделей: MLflow, Kubeflow Pipelines, DVC как часть Git-цепочки версий.
- Мониторинг и прогнозирование качества: Prometheus, OpenTelemetry, SRE-подходы к ML.
- Безопасность и соответствие: OIDC/SAML, mTLS, secrets management (HashiCorp Vault, Kubernetes Secrets), доступ по ролям (RBAC).
- Облачная и локальная инфраструктура: кросс-облачные пайплайны, гибко масштабируемые кластеры Kubernetes, автономия edge-узлов там, где требуется.
- Пример конфигурации конвейера (yaml-уровень)
version: '1.0' pipeline: name: training-and-deploy stages: - fetch-data: source: "s3://data-bucket/raw" format: "parquet"
- validate: checks:
- schema
- data_quality
- feature-engineering: script: "features.py"
- train: framework: "scikit-learn" algorithm: "RandomForest" hyperparameters: n_estimators: 200
- evaluate: metrics:
- accuracy
- F1
- register-model: registry: "MLflow" versioning: true
- deploy: strategy: "canary" endpoint: "production"
- Интеграции и протоколы
- REST и gRPC - интеграционные точки между компонентами пайплайна.
- OpenLineage и Data Catalog - для трассализации происхождения данных и признаков.
- Механизмы тестирования: unit-тесты для компонентов data и feature-трасс, тесты на регрессию производительности.
- Безопасность: mTLS между сервисами, RBAC на уровне Kubernetes, контроль доступа к артефактам через политики.
- Архитектура в облаке vs on-premise
- Облако: гибкость, масштабируемость, глобальные регионы, сервисы управления данными и безопасностью на уровне провайдера.
- On-premise: локализация данных, соответствие требования ФЗ о защите данных и регуляторные ограничения, контроль сети и отказоустойчивость внутри организации.
- Гибрид: пространственный подход с синхронной и асинхронной передачей данных, федеративные схемы и локальные кэш-линии признаков.
Организационные и процессные аспекты
- Роли и компетенции
- ML Platform Engineer - инженер платформы MLOps, интеграция пайплайнов, обеспечение воспроизводимости.
- Data Engineer - подготовка и качество данных, обеспечение совместимости между источниками и хранилищами.
- ML Engineer/Scientist - разработка моделей, экспериментирование, участие в валидации и переносе в продакшн.
- ML Ops Lead - координация процессов, безопасность, соответствие требованиям регуляторов, бюджетирование.
- Compliance и Risk - контроль соответствия, этический надзор, аудит, управление ограничениями доступа.
- Процессы и методологии
- Модели управления: жизненный цикл проектов, планирование бюджета и сроков, регламент версионирования.
- Верификация и тестирование: тестирование данных и признаков, проверка на смещение и bias, тесты на производительность сервиса.
- Этические принципы и регуляторика: построение этических чек-листов, защитa приватности, прозрачность принятия решений.
- Управление затратами и бюджетирование: планирование ресурсов, контроль за расходами на хранение и вычисления, оптимизация за счёт автоматического масштабирования и прерывистого потребления.
Практические примеры и кейсы (open-source и российские решения)
Open-source решения
- Kubeflow Pipelines: платформа для оркестрации сложных ML-пайплайнов в Kubernetes, поддерживает версионирование артефактов, мониторинг и повторяемость.
- MLflow: управление жизненным циклом моделей (эксперименты, повторное использование артефактов, регистрация моделей), легко интегрируется с различными фреймворками.
- Feast: feature store, обеспечивает единый источник признаков, поддерживает версионирование и lineage данных.
- Dagster: оркестрация данных и ML-пайплайнов с понятной модульностью и тестируемостью.
- Metaflow и MLRun: упрощение разработки и эксплуатации ML-конвейеров, включая экспериментирование и деплой.
- OpenTelemetry/OpenLineage: наблюдаемость и трассировка данных и моделей; интеграция с существующими системами мониторинга.
Российские решения и кейсы
- Локализация инфраструктуры: адаптация открытых инструментов под требования российского законодательства, включая хранение данных внутри страны и соответствующие политики доступа.
- Пилоты в банковском и телеком-сегментах: внедрение гибридных конвейеров с локальными узлами обработки и регламентами аудита.
- Практики аудита и регуляторики: использование отечественных решений по управлению безопасностью и соответствию ФЗ, внедрение политик контроля доступа и шифрования.
- Образовательные и исследовательские проекты: интеграционные решения, объединяющие отечественные научно-образовательные инициативы и промышленную эксплуатацию.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Алгоритмы и методики
- Мониторинг данных: проверка синтаксической валидности, гистограммы распределения, тесты на drift, проверка целевых метрик.
- Мониторинг моделей: деградация точности, задержка отклика, устойчивость к изменению входных данных.
- Этическая валидация: анализ bias и fairness, оценка влияния на пользователей, аудит решений.
- Схемы интеграции
- Архитектура данных: источник данных → обработка → признаки → обучение → валидация → доставка в продакшн.
- Архитектура безопасности: все сервисы взаимодействуют через безопасные каналы, интеграция с системами идентификации и доступа.
- Протоколы и стандарты
- OpenLineage для трассировки и lineage.
- Открытые протоколы обмена данными: gRPC, REST, OpenAPI.
- Протоколы безопасности: OAuth2.0, OIDC, mTLS, секреты через Vault.
- Интеграции
- Базы данных и хранилища: S3-compatible object storage, HDFS/ину другие платформи хранения.
- Системы CI/CD: GitHub Actions, GitLab CI, Jenkins и интеграции с пайплайнами для обучения.
- Контроль версий кода и данных: Git, DVC, MLflow, ML Registry.
Риски, ограничения и типовые ошибки
- Риски
- Данные и концептуальный дрейф: изменение распределения данных, деградация качества признаков.
- Этические и регуляторные риски: дискриминация, прозрачность моделей, нарушения приватности.
- Экономическая устойчивость: перерасход бюджета на вычисления и хранение, неожиданные пиковые нагрузки.
- Безопасность и соответствие: уязвимости в конфигурациях, несанкционированный доступ, безопасность данных.
- Ограничения
- Совмещение требований к latency и точности; на продакшн-компонентах иногда приходится идти на компромиссы.
- Влияние зависимости от внешних сервисов и облачных провайдеров.
- Скорость внедрения этических и регуляторных процессов.
- Типовые ошибки
- Недостаточная документация и отсутствие репродуктивности пайплайнов.
- Игнорирование качества данных на входе в пайплайн.
- Неполное тестирование на смену данных/моделей.
- Неправильная настройка мониторинга и оповещений.
Перспективы развития направления
- Foundation Models Ops (FMOps): управление жизненным циклом больших языковых моделей и мультимодальных систем, включая обучение и продакшн-эксплуатацию.
- Автоматизация и AutoML: автоматическая настройка гиперпараметров, автоматическое извлечение признаков и автоматический выбор архитектур, с учётом регуляторики и этики.
- Этические рамки как встроенная часть pipelines: прозрачность, объяснимость, аудит и ответственность за решения.
- Edge и локальные вычисления: деплой моделей на периферийные устройства и в локальные дата-центры с ограниченной пропускной способностью.
- Гибридные облака и управление затратами: координация ресурсов между облачными и локальными инфраструктурами; оптимизация затрат и качество сервиса.
Заключение
Будущее направление MLOps требует совместимости технологических инноваций и этических норм. Архитекторы и руководители data-направлений должны подходить к внедрению с учётом сочетания облачных и on-premise возможностей, подстраивая инфраструктуру под требования регуляторов, бюджета и целевых бизнес-результатов. Важнейший вывод: автоматизация жизненного цикла моделей должна идти рука об руку с прозрачностью, ответственности и устойчивыми механизмами контроля риска. Именно на стыке технологий, процессов и этики рождается надёжная и масштабируемая MLOps-экосистема.
Вопрос-Ответ (FAQ)
- Чем отличается будущее направление MLOps от текущих практик?
- Ответ: В будущее направление включены усиление автоматизации на уровне архитектуры, более глубокая интеграция этики и регуляторики в конвейеры, расширение поддержки FMOps и гибридных инфраструктур, а также более строгие требования к воспроизводимости и управлению данными. Это означает не только быстрый выпуск моделей, но и полноценную контрольную среду, которая учитывает приватность, безопасность и устойчивость затрат.
- Какие новые технологии будут критическими для MLOps в ближайшие годы?
- Ответ: Технологии для управления признаками (feature store), регистры моделей, ориентированные на регуляторные требования режимы аудита, расширенная наблюдаемость и мониторинг моделей, федеративное обучение, а также инструменты для работы с foundation models и их эксплуатацией в продакшене. Важны также процессы управления данными и этические рамки.
- Как интегрировать этические принципы в MLOps?
- Ответ: Нужно внедрять этические чек-листы на этапах дизайн-обоснования, валидирования признаков и оценки моделей; строить мониторинг bias и fairness, обеспечивать прослеживаемость решений (когда, как и почему модель приняла решение), реализовать прозрачность и аудируемость процессов, соблюдать приватность данных и регуляторные требования.
- Какие типовые архитектурные паттерны применяются в гибридных облаках?
- Ответ: Часто встречаются архитектуры с централизованной регистрацией моделей, feature store, локальной обработкой чувствительных данных в on-premise сегменте и синхронной/асинхронной передачей данных в облако. Гибридность достигается через кросс-сервисные API, федеративную обработку данных и общие политики безопасности.
- Какие открытые инструменты рекомендуется использовать в Open-Source стратегии MLOps?
- Ответ: Kubeflow Pipelines, MLflow, Feast, Dagster, Metaflow, MLRun, OpenTelemetry и OpenLineage. Они обеспечивают оркестрацию, хранение признаков, регистры моделей, мониторинг и трассировку жизненного цикла моделей, что важно для воспроизводимости и аудита.
- Какие риски чаще всего возникают при переходе к MLOps в гибридной инфраструктуре?
- Ответ: Риски включают сложности синхронизации данных между облаком и on-premise, сложности обеспечения единообразного мониторинга, увеличение затрат на хранение и вычисления, а также регуляторные риски и требования к приватности. Важна правильная архитектура контроля доступа и тщательное тестирование на каждом этапе.
- Как учитывать регуляторику и требования к защите данных в проектах MLOps?
- Ответ: Необходимо заранее определить требования к хранению данных, шифрованию, аудитам и доступу. Включайте процессы соответствия и аудита на уровне архитектуры, внедряйте политики RBAC, mTLS, настройку секретов и интеграцию с системами управления доступом, а также поддерживайте локализацию данных там, где это необходимо.
- Какие есть практические примеры внедрения в России?
- Ответ: В рамках российского рынка часто применяются локальные адаптации открытых инструментов под требования ФЗ и регуляторику, внедрение гибридных пайплайнов в банковском и телеком-сегментах, а также пилоты по сохранению данных внутри страны и аудируемой эксплуатации. Это сочетает в себе использование открытых технологий с локализацией и контролем доступа.
- Что такое FMOps и почему это важно?
- Ответ: FMOps** - это Operational Management для foundation models (больших языковых моделей и мультимодальных систем). Это включает управление обучением, копированием, развертыванием и мониторингом таких моделей в продакшене, обеспечение безопасности их использования и этических норм, а также эффективное управление затратами.
- Какие шаги стоит предпринять сначала, если начать внедрение в рамках курса?
- Ответ: Определите целевые бизнес-метрики и регуляторные требования, сформируйте команду с четкими ролями (ML Platform Engineer, Data Engineer, ML Engineer, Compliance), выберите ориентир на гибридную архитектуру, настройте базовый пайплайн с инструментариями для оркестрации, хранения признаков и регистрации моделей, затем постепенно внедряйте мониторинг, аудит и этические проверки.
Если ваша компания планирует внедрение машинного обучения или масштабирование AI-решений, ключевым фактором успеха становится правильная архитектура платформы данных и MLOps-инфраструктуры.
Узнайте, как реализовать искусственный интеллект для бизнеса от стратегии до внедрения: от оценки готовности компании и выбора архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы.


