

Эволюция: традиционные подходы к признакам и преимущества Feature Store
Краткое введение
В рамках курса по Feature Store и повторному использованию признаков мы переходим от понятия «признак» как некоего артефакта данных к системной концепции хранения, управления и повторного использования признаков на протяжении всего жизненного цикла ML-проектов. Эта глава раскрывает историю эволюции признаков: от ручной инженерии и фрагментарного хранения до централизованных feature store, которые обеспечивают версионирование, управление доступами, совместное использование, качество данных и интеграцию с пайплайнами обучения. Понимание традиционных подходов помогает не только выбрать правильную архитектуру, но и выстроить требования к современным решениям, которые позволят масштабировать аналитику и ускорить цикл обучения моделей.
Введение
Формирование признаков - фундаментальная часть любого ML-проекта. Исторически инженеры данных создавали все новые признаки «на месте» в рамках конкретного пайплайна: скрипты трансформаций, SQL-запросы, функции, которые запускались разово перед обучением. Такой подход был эффективен на начальных стадиях, когда проекты охватывали узкий домен и ограниченное количество признаков. Но с ростом сложности моделей, зависимостей между признаками, необходимостью повторного использования признаков между командами и регуляторными требованиями к качеству данных стало очевидно, что самостоятельные скрипты теряют управляемость, воспроизводимость и контроль версий.
Зачем нужна эволюция и что дает переход к Feature Store:
- Повторное использование признаков: одни и те же вычисления и наборы признаков используются в нескольких моделях и проектах, что экономит время и снижает риск рассинхронизации.
- Управление версиями признаков и их метаданными: история изменений, откат к предыдущим версиям, прозрачность происхождения признаков.
- Единый каталог определения признаков: единый словарь терминов, стандарт именования и описание контекста.
- Интеграция с пайплайнами обучения и инференса: единый API для получения признаков в процессе обучения и онлайн-введении в прод.
- Контроль качества и соответствие требованиям: валидация данных, тесты на регрессию признаков и защита от утечек в условиях обучения и сервиса.
- Архитектурная устойчивость и масштабируемость: offline и online хранилища, поддержка батчевых и стриминговых источников, кэширование и задержки при доступах.
Теоретические основы и терминология
Основные понятия и термины, которые будут использоваться в этой и последующих главах:
- Признак (feature): измеримый атрибут объекта, который может использоваться как входной сигнал модели. Признаки могут быть результатами трансформаций, агрегаций или комбинаций исходных данных.
- Фича-генерация (feature engineering): процесс создания и обработки признаков из сырых данных для улучшения качества модели.
- Feature Store (хранилище признаков): централизованная система для хранения, версиификации и совместного использования признаков между командами и пайплайнами обучения и инференса.
- Offline store: долговременное хранилище признаков в формате, удобном для обучения (обычно колонно-ориентированные файловые форматы, Parquet/ORC, S3/HDFS, дата-озера).
- Online store: быстрое хранилище признаков для инференса в реальном времени (Redis, RedisAI, Cassandra, Cassandra-backed stores, RocksDB и т. п.).
- Feature registry/catalog: репозиторий метаданных о признаках, включая их имя, тип, источник данных, формулу вычисления, версии и требования к обновлениям.
- Feature group: контейнер признаков, который объединяет признаки одной тематики или набора источников для удобной версионизации и доступа.
- Versioning: управление версиями признаков и их вычислений, позволяющее откатывать изменения и отслеживать влияние изменений на производительность моделей.
- Lineage: трассировка происхождения признаков, включая источники данных и последовательности трaнформаций, что критично для аудита и воспроизводимости.
- Data drift и избыточная утечка (leakage): риски связанные с несоответствием распределений признаков между обучением и продом и возможным использованием будущей информации в обучении.
Методологии и подходы
Традиционные подходы к признакам опирались на эволюцию процессов в рамках нескольких этапов:
- Инженеринг признаков в рамках конкретного пайплайна.
- Фиксация «среза» признаков в виде ETL-скриптов, которые затем запускались при обучении.
- Ручное документирование набора признаков в носителях вроде spreadsheets или документированных SQL-скриптов.
- Фрагментация версий и ограниченная прозрачность источников и изменений.
Преимущества централизованных решений по сравнению с традиционными подходами:
- Повышение повторяемости и воспроизводимости; один и тот же признак не пересоздаётся раз за разом.
- Улучшение контроля качества и мониторинга данных.
- Быстрое масштабирование за счет разделения вычислительной логики на сервисы и кэширования.
- Соблюдение принципов управляемого доступа: разграничение ролей, аудит и соответствие требованиям регуляторов.
- Взаимная совместимость между командами: централизованный каталог упрощает поиск признаков и их применение в новых проектах.
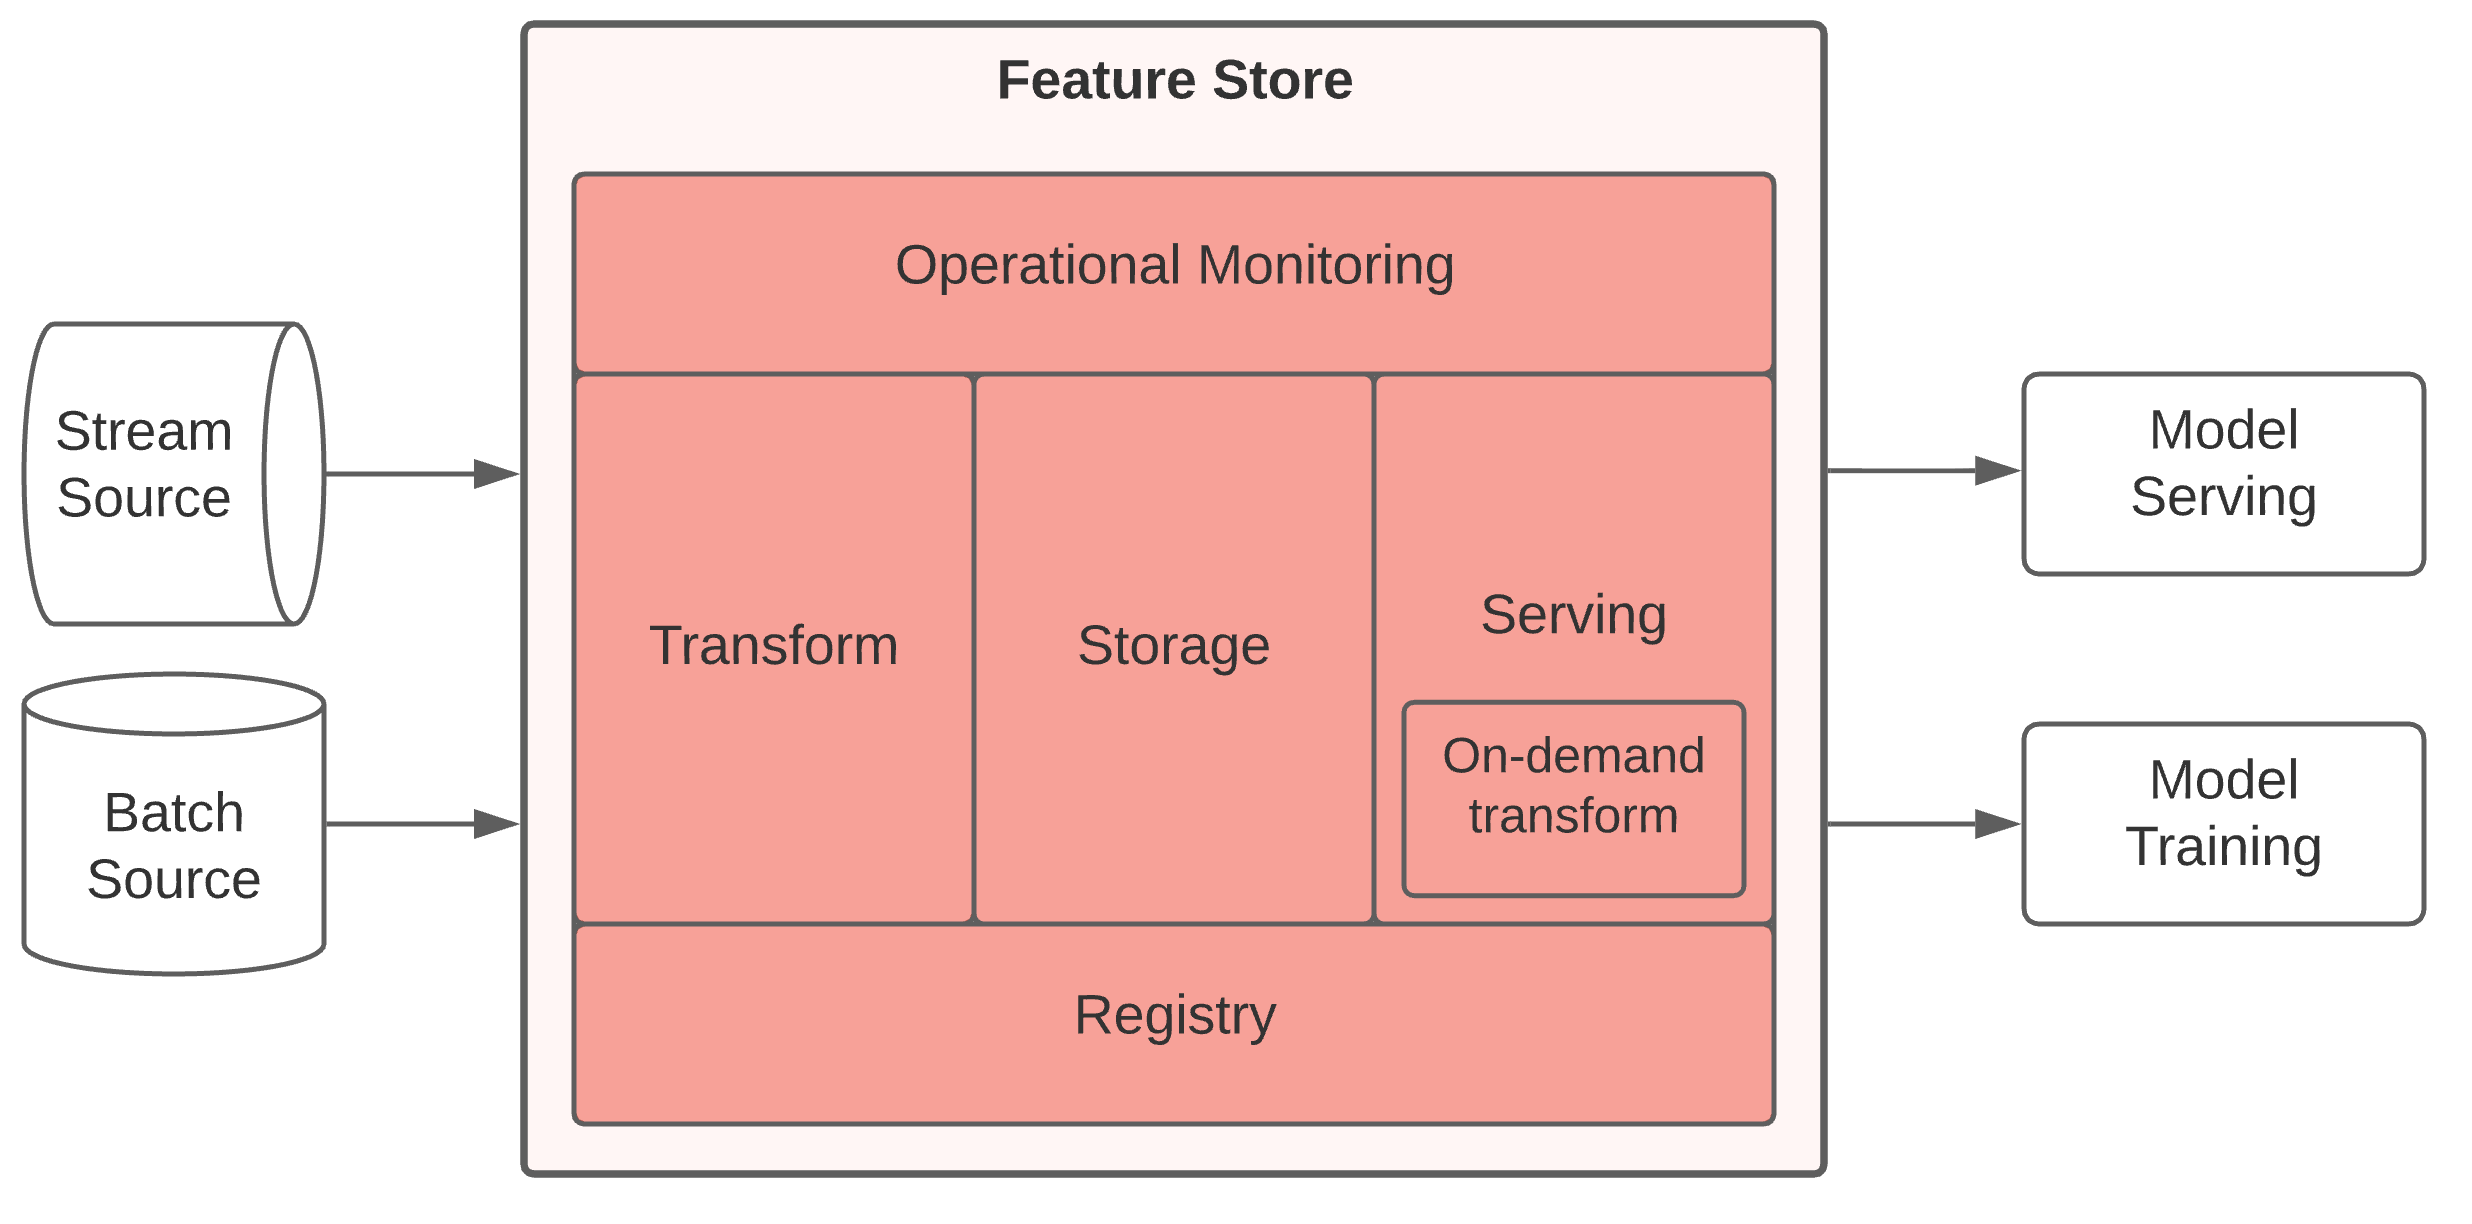
Архитектура и технологическая реализация
Общая архитектура modern feature store обычно состоит из нескольких слоев:
- Источники данных (data sources): базы данных, логи, хранилища файлов, стриминговые потоки.
- Offline store (хранилище признаков для обучения): parquet/ORC-файлы, облачные Data Lake, каталоги с временными метками.
- Online store (быстрый доступ к признакам): in-memory/ключ-значение хранилища для сервиса онлайн-Inference.
- Feature computation layer: трансформация и агрегации признак-генераторы, которые могут быть реализованы как SQL-проекты, Spark/Databricks, Python-пайплайны.
- Feature registry/catalog: хранение метаданных и описаний признаков.
- API и сервисы: интерфейсы для запроса признаков в обучении и онлайн-инференсе, поддержка REST/gRPC, встраиваемых функций и кэширования.
- Управление качеством и контролем доступа: политики безопасности, валидация данных и механизмы мониторинга.
Типовая схема:
- Batch/Offline процесс: источники данных -> трансформации -> offline store (центральный репозиторий признаков) -> обучение.
- Online процесс: запрос признаков через feature service -> online store (быстрый доступ) -> инференс.
Пример архитектурной раскладки на практике:
- Источник: база заказов, логины пользователя, данные о транзакциях.
- Признаки: суммарные метрики, вероятности поведения, статусы, временные окна (rolling features), категории.
- Вычисление: Spark-проекты, Python-функции, SQL-скрипты.
- Хранение: Offline store в S3/ADLS с Parquet, Online store в Redis/Cassandra.
- Доступ: REST/gRPC API для обучающих пайплайнов и онлайн-сервиса прогнозирования.
- Метаданные: каталог признаков с версиями, источниками и описаниями.
Немного технических деталей реализации:
- Верификация признаков: валидация форматов, типов, отсутствующих значений, сценариев отсутствующих данных.
- Мониторинг качества: проверки на распределение данных, Drift检测, контроль задержек и статистики использования признаков.
- Безопасность и доступ: ACL/role-based access control (RBAC), аудит доступа к признакам, маскировка чувствительных данных.
- Интеграции: интеграция с CI/CD для обновления вычислений признаков, тестовые окружения, откат.
Ключевые технологии и решения на рынке
Open-source решения:
- Feast: один из наиболее известных open-source проектов для хранения, версии и доступа к признакам. Поддерживает offline и online stores, feature registry, простые API и интеграцию со многими облачными платформами.
- Hopsworks Feature Store: облачный и on-prem выпуск, поддерживает продвинутые сценарии управления признаками, комплексный набор инструментов для трансформаций и мониторинга.
- Apache Spark-based approaches: сборка фреймворков для вычислений признаков на базе Spark, совместно с хранением в Parquet/Delta и внешних онлайн-слоях.
Российские решения и кейсы:
- Яндекс DataSphere: платформа для машинного обучения в экосистеме Яндекс, в составе которой присутствуют инструменты для управления признаками, их версии и использования в обучении и инференсе. Акцент на интеграцию с экосистемой Яндекса, безопасностью и масштабируемостью.
- Сбер Технологии/Сбер Cloud ML: решения для корпоративной ML-платформы, включая управление признаками, каталог признаков и доступ к ним из разных команд. Фокус на соответствие регулятивным требованиям, контроль версий и надёжность.
- Кейс крупной телеком-компании/финтеха: применение внутренних feature store для повторного использования признаков в нескольких моделях. Подчёркнуто важны аспекты миграции в централизованный регистр и возможность отката изменений.
Эти примеры помогают увидеть различие между открытыми подходами и решениями, разработанными внутри крупных организаций, где требования к безопасности, соответствию и интеграции с внутренними сервисами особенно высоки.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Определение и описание признаков
- Определение признака включает имя, тип, источник, формулу вычисления, параметры окна (если применимо) и версию.
- Формат хранения метаданных - стандартный JSON/YAML-описание, которое используется в registry.
- Пример описания признака:
- name: user_total_spent_last_30d
- type: float
- source: transactions_db
- transformation: sum(amount) over last 30 days, filtered by user_id
- version: v1
- timeframe: last_30_days
- description: суммарные траты пользователя за последние 30 дней
- Пример конфигурации Feast (упрощённо)
- Определение фича-группы (feature view) в Feast:
- features:
- user_id: int64
- total_spent_30d: float
- online_store: Redis
- offline_store: Parquet on S3
- ttl: 30 days
- batch_source: spark_job.py
- Пример кода для получения признаков в обучении:
- from feast import FeatureStore, RepoConfig
- fs = FeatureStore(repo_path="path/to/registry")
- feature_refs = ["ecommerce: user_total_spent_last_30d: float"]
- training_df = fs.get_historical_features(
entity_df=entity_df, features=feature_refs).to_df()
- Архитектура взаимодействия
- Обеспечение согласованности между offline и online store через согласованную схему обновления признаков.
- Внедрение кэширования на уровне сервиса: горячие признаки кэшируются в онлайн-хранилище для снижения задержек.
- Управление версиями: каждый раз при изменении вычисления признаков создаётся новая версия. Клиенты могут запросить конкретную версию или использовать последнюю стабильную.
- Протоколы и интеграции
- Протоколы: REST/gRPC для сервисного доступа к признакам; событийный протокол для уведомления об обновлениях.
- Развертывание и CI/CD: автоматическое тестирование новых версий признаков на тестовых пайплайнах; автоматическое откатывание при обнаружении деградации валидации.
- Инструменты мониторинга: Prometheus/Grafana для слежения за временем получения признаков, латентностью, успешностью обновлений.
Риски, ограничения и типовые ошибки
- Утечка признаков: использование будущих значений или целевых переменных в признаках приведёт к завышенным метрикам и деградации в проде. Требуется строгий контроль времени обновления и валидация.
- Data drift и изменение распределений: признаки, которые раньше работали хорошо, могут устареть; необходимы регулярые проверки и переобучение.
- Несоответствие версий между обучением и инференсом: несогласованные версии признаков приводят к несовпадению данных и падению производительности.
- Проблемы с латентностью онлайн-store: слишком медленный доступ к признакам может стать узким местом в инференсе.
- Сложности миграций: переход с фрагментированных подходов на централизованный store требует координации между командами, процедур миграции и тестирования.
- Ограничения доступа и безопасность: нужно балансировать между доступностью признаков и защитой чувствительных данных, особенно в проде.
Перспективы развития направления
- Стандартизация форматов и контрактов признаков: единые спецификации, которые позволят легко обмениваться признаками между организациями и платформами.
- Расширение функциональности: автоматическое тестирование признаков, мониторинг изменений и автоматический откат.
- Расширение онлайн-архитектур: поддержка различных онлайн-хранилищ (включая SSD/DRAM, флеш-решения и распределённые KV-хранилища).
- Применение privacy-by-design: анонимизация, дифференцируемая приватность и ограничение утечки в условиях обучения и продовой инференсы.
- Интеграция с регулятивными требованиями: аудит, прозрачность версий и lineage-просмотр для регуляторов.
Заключение
История признаков идёт от фрагментарной инженерии к централизованной архитектуре, где признаки становятся управляемым и переиспользуемым активом. Feature Store обеспечивает воспроизводимость, контроль качества и масштабируемость, позволяя организациям ускорять обучение и улучшать качество инференса. В ходе курса мы увидим, как проектах реальный мир внедряются архитектуры online/offline store, регистры признаков, управление доступами и интеграции с пайплайнами обучения. Освоив эти принципы, вы сможете не только выбрать подходящую технологическую платформу, но и построить устойчивую организационную модель управления признаками в рамках вашей data-стратегии.
FAQ (Q&A)
Что такое Feature Store и зачем он нужен?
Feature Store - централизованное хранилище и управляющая система для признаков, которая обеспечивает стандартизацию их определения, версии, доступности и совместного использования между командами обучения и инференса. Он снижает дублирование вычислений, ускоряет повторное использование признаков и улучшает воспроизводимость моделей.
Какие основные типы хранилищ в Feature Store?
Offline store: долговременное хранилище признаков для обучения (Parquet/ORC в Data Lake, S3/ADLS).
Online store: быстрый доступ к признакам для инференса (Redis, Cassandra, RocksDB и т. п.).
Feature registry/catalog: хранение метаданных-описаний признаков, версий, источников и зависимостей.
Какие преимущества дает версионирование признаков?
Позволяет откатывать изменения, тестировать влияние новых формул вычисления и грамотно управлять зависимостями между признаками и моделями.
Как избежать утечки данных при создании признаков?
Внедрять строгие временные границы, тестировать на задержки между источниками и тестировать признаки отдельно от целевых переменных.
Разделять метаданные и данные, использовать временные метки и контроль доступа.
Какие риски стоит учитывать при внедрении Feature Store в организацию?
Сложности миграции и внедрения, требования к инфраструктуре, необходимость в качественных данных и контроле версий, а также риск перегрузки онлайн-store при резком росте спроса.
Как современные решения поддерживают интеграцию с пайплайнами обучения?
Через API (REST/gRPC), поддержку Spark/Python/SQL, возможность запроса признаков прямо в обучающих пайплайнах, поддержка CI/CD и мониторинга.
Какие примеры open-source решений можно использовать на практике?
Feast: централизованный registry и хранение признаков, поддержка offline/online сценариев, интеграции с облаками.
Hopsworks Feature Store: продвинутый набор инструментов для управления признаками, мониторингом и безопасностью.
Дополнительно: архитектуры на базе Spark и Parquet/Delta с онлайн-хранилищами.
Какие российские примеры можно упомянуть для контекста?
Яндекс DataSphere: платформа ML, включающая управление признаками и интеграцию в экосистему Яндекса.
Сбер Cloud ML/платформа внутри компаний: управление признаками, версиями и доступами с учетом регулятивных требований.
Как проектировать переход к Feature Store без сбоев в бизнес-процессах?
Постепенная миграция: начать с отдельных моделей и набора признаков, внедрить регистр признаков, параллельно сохранять старые скрипты, проводить тестирование и мониторинг, а затем полноценно переходить на централизованный store.
Какие направления в развитии стоит ожидать в ближайшем будущем?
Стандартизация контрактов признаков, расширение возможностей безопасного доступа и мониторинга, усиление поддержки прозрачности и аудитирования, глубокая интеграция с CI/CD и правовыми требованиями, а также новые архитектурные паттерны для унифицированного доступа к признакам в разных контекстах.
Дополнительные примеры и примечания
- Пример кода для расчета признаков и их регистрации может быть полезен: открытые реализации Feast показывают, как определить признаки, зарегистрировать их и запросить в обучении. Разбор таких примеров поможет закрепить концепцию.
- В контексте российских задач стоит обратить внимание на адаптацию зарубежных практик под локальные требования к безопасности, хранению данных и регулятивные ограничения; практические кейсы показывают, как крупные организации в России внедряют feature store внутри своей ML-экосистемы.
В этой главе мы заложили фундаментальные концепции эволюции признаков и принципов работы с Feature Store. В следующих главах мы перейдём к проектированию повторного использования признаков, версионированию, разграничению доступов и интеграции с пайплайнами обучения и инференса - от концепций к практическим реализациям, включая примеры архитектур, шаблоны конфигураций и реальные кейсы внедрения как в открытых платформах, так и внутри российских организаций.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


