

Архитектурные паттерны: feature groups, feature views, feature vectors
Краткое введение
Эта глава посвящена ключевым архитектурным паттернам работы с признаками в рамках концепции Feature Store: как организовать признаки в группы, как структурировать их представление для моделей и как формировать вектор признаков. Правильное проектирование этих паттернов напрямую влияет на скорость разработки моделей, повторяемость экспериментов, качество обучения и устойчивость к изменениям данных. Мы рассмотрим концепции, практические подходы к реализации, вариации под разные технологические стеки и реальные примеры внедрений, включая open-source решения и российские практики.
Введение
Feature Store призван устранить разрыв между данными и моделями: от источников признаков до оперативной выдачи признаков во время обучения и в проде. В этом контексте три паттерна являются основой эффективной архитектуры:
- feature groups - логическая группировка признаков, связанных источником, ответственностью за качество и временем жизни;
- feature views - виртуальные или физические представления признаков, отражающие необходимость моделирования зависимости признаков друг от друга и удобство потребления;
- feature vectors - агрегированные наборы признаков, готовые к подаче в конкретную модель или пайплайн обучения.
Понимание различий и взаимосвязей между этими уровнями позволяет строить масштабируемые, управляемые и повторяемые инфраструктуры признаков. В реальных проектах эти паттерны применяются как в чисто open-source стеке (Feast, Hopsworks Feature Store и др.), так и внутри крупных российских MLOps 플랫폼 (через адаптацию открытых решений под внутренние требования, контроль доступа, аудит и локальные хранилища). Далее мы раскроем теоретические основы, методики применения и примеры реализации.
Теоретические основы и терминология
- Feature (признак) - именованная характеристика объекта обучения. Признаки имеют тип данных, источник, временную привязку и срок годности.
- Feature group (группа признаков) - логическая коллекция признаков, объединённых общим источником данных, ответственностью за качество и политикой обновления. Группы позволяют локализовать владение и версионирование признаков.
- Feature view (представление признаков) - контракт на набор признаков, который будет доступен потребителю (модели, пайплайны). Часто включает указание источника, временной контекст (event_time), TTL, метаданные обновления и зависимость от Entity.
- Feature vector (вектор признаков) - конкретный набор признаков, передаваемый в модель или на вход пайплайна. Вектор может представлять одну запись или батч признаков, имеющий согласованные ключи и временные метки.
- Feature store - централизованное хранилище, которое обеспечивает хранение, версионирование, онлайн/оффлайн доступы и согласование между обучением и продом.
Ключевые принципы проектирования:
- единообразие идентификаторов и ключей: поддержка единого идентификатора (entity) для всех признаков в группе;
- временная валидность: хранение времени обновления и событийной временной метки для корректного сшивания признаков;
- версия признаков: возможность одновременного существования нескольких версий признаков и откаты;
- разделение онлайн и оффлайн хранилищ: быстрый доступ к признакам во время сервиса и устойчивые аналитические запросы для обучения;
- управление доступами и аудит: блоки ACL на уровне групп, представлений и отдельных признаков.
Методологии и подходы
- Стратегия группировки: разделение признаков по источнику данных (например, пользовательские события, транзакционные логи, технические метрики) или по доменному контексту (пользователь, сеанс, устройство).
- Нормализация имен и версионирование: четкие схемы именования групп и представлений, внутренние механизмы версионирования, чтобы избежать конфликтов при обновлениях.
- Контракты представлений: определение точного набора признаков в каждом feature view с документацией, зависимостями и контрактами по времени.
- Инкрементальная сборка в пайплайнах: возможность частичного обновления признаков без переработки всей базы признаков.
- Обеспечение согласованности offline-online: синхронизация версий и ключей между оффлайн-архивами и онлайн-слоем, чтобы результаты обучения совпадали с сервисом онлайн-инференции.
- Тестирование признаков: модульное тестирование контрактов признаков, тесты на регрессии времени и на drift, эмуляции задержек данных.
Комментарий к паттернам:
- Feature groups позволяют управлять качеством данных и правами доступа на уровне группы, уменьшая риск непреднамеренного использования некорректных признаков.
- Feature views служат абстракцией над реальными источниками и облегчают повторное использование признаков между моделями.
- Feature vectors обеспечивают конкретную форму передачи признаков в модель, упрощая совместное использование между различными пайплайнами.
Архитектура и технологическая реализация
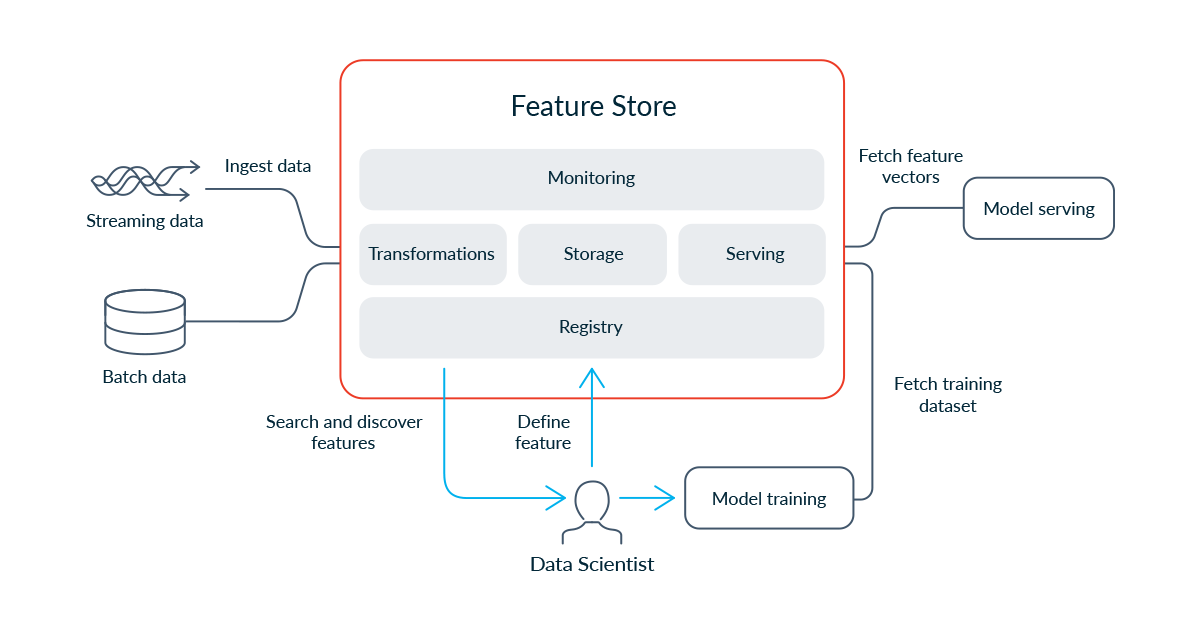
Рассмотрим общую архитектуру, где присоединение к источникам данных, хранение, подготовка и потребление признаков разделены по слоям:
- Источник данных (data sources)
- Логи событий, транзакции, метрики.
- Разделение между "источниками изменений" и "источниками прочих признаков".
- Слой обработки и конвейеры загрузки
- ETL/ELT задачи, преобразование признаков, вычисления, агрегации.
- Упаковка признаков в группы и представления.
- Feature store
- Оффлайн-слой: хранилище параллельно обучающих наборов, версия признаков, кэширование для быстрых запросов.
- Онлайн-слой: быстрый доступ к признакам с минимальной задержкой, поддержка транзакций.
- Сервис потребления признаков
- Интеграция с пайплайнами обучения (train pipelines) и инференсом (serving).
- Контракты и валидация признаков на этапе внедрения.
- Инфраструктурный слой
- Контейнеризация, оркестрация (Kubernetes), очереди и потоки данных (Kafka, Pulsar), мониторинг.
Ниже приведена упрощенная диаграмма слоёв в текстовом виде:
- Источник данных -> Feature Group (производство признаков) -> Feature View (контракт) -> Feature Vector (потребление) -> Модель/Пайплайн
- Offline store (Parquet/ORC, Hive, BigQuery, Snowflake) <-> Online store (Redis, Redis Enterprise, Cassandra, DynamoDB)
- Инструменты тестирования и мониторинга -> Метрики, логирование, аудит
Пример кода (упрощенная иллюстрация паттернов):
- Feast (open-source)
# Определение сущности
from feast import Entity, FeatureView, Feature, ValueType
user = Entity(name="user_id", value_type=ValueType.INT64, description="Идентификатор пользователя")
источник оффлайн (путь к Parquet/Cloud Storage)
from feast import FileSource user_events_source = FileSource( path="s3://bucket/features/user_events.parquet", event_timestamp_column="event_time", created_timestamp_column="created_at", )
определяем представление признаков
driver_hourly_stats_view = FeatureView( name="user_hourly_stats", entities=["user_id"], ttl=None, online=False, source=user_events_source, schema=[
Feature(name="sessions_count", dtype=ValueType.INT64),
Feature(name="click_rate", dtype=ValueType.FLOAT),
    Feature(name="transactions_amount", dtype=ValueType.FLOAT),
],
)
сервис признаков и флоу версий
...
- Hopsworks Feature Store (open-source)
# Пример на базе Hopsworks: создание Feature Group и Feature View
from hops import featurestore
fs = featurestore.FeatureStore(database="featurestore")
создание группы признаков
fg = fs.get_feature_group(name="user_hourly_features", version=1) fg.create_schema(columns=[("user_id", "BIGINT"), ("hour", "INT"), ("clicks", "INT"), ("revenue", "DOUBLE")])
записываем данные в группу
records = [ {"user_id": 123, "hour": 10, "clicks": 5, "revenue": 0.0}, {"user_id": 124, "hour": 10, "clicks": 2, "revenue": 1.5}, ] fs.insert_feature_group("user_hourly_features", records, mode="append")
- Пример интеграции в пайплайны (общий подход)
- Обучение: загрузка признаков оффлайн-слоя, сборка в Feature Vector, запуск обучения.
- Инференс: запрос онлайн-признаков по ключу (entity) и времени, формирование вектора признаков для сервиса.
Важно помнить: конкретные реализации зависят от стека и требований к latency, лицензированию и политике доступов. В некоторых случаях можно комбинировать open-source паттерны с корпоративной инфраструктурой.
Организационные и процессные аспекты
- Владение признаками: назначьте ответственных за каждую feature group и за соответствующие feature views. Это упрощает аудит и ответственность за качество признаков.
- Управление версиями: определите политики версий (например, major/minor для признаков, TTL, политику откатов). Важна возможность возвращения к предыдущей версии без потери воспроизводимости.
- Контракты и согласование: формализуйте контракты между командой данных, командами аналитики и командами ML. Каждый изменения в представлениях потребует согласования с потребителями признаков.
- Доступы и безопасность: реализуйте RBAC на уровне групп и представлений, аудит изменений и логов доступа. Учитывайте требования к приватности и регуляторные ограничения.
- Тестирование и качество: регулярно тестируйте признаки на drift, валидацию типов, корректности источников и согласованности временных меток. Учитывайте влияние задержек на онлайн-слой.
- Мониторинг и observability: мониторинг задержек, пропускной способности, ошибок конвейеров и соответствие SLA. Храните метрики по времени жизни признаков и версиям.
Практические примеры и кейсы (open-source и российские решения)
- Open-source: Feast + BigQuery/Redshift/Snowflake (оффлайн) и Redis (онлайн)
- Пример кейса: организация центра признаков для интернет-магазина, где признаками являются поведенческие метрики, транзакции и технические параметры устройств. Группа признаков обновляется каждую ночь, онлайн-слой обслуживает ML-моделью в реальном времени.
- Вывод: такая архитектура облегчает повторное использование признаков между моделями (рекомендательная система, антифрод, ценовая оптимизация).
- Open-source: Hopsworks Feature Store
- Пример кейса: крупная телеком-компания реализовала централизованный store признаков на базе Hopsworks, используемый для моделей churn prediction и сетевых оптимизаций.
- Вывод: возможность управлять версиями признаков и иметь единый контракт на признаки между моделями.
- Российские решения (практика внедрения)
- Пример 1: крупная финансовая организация реализовала внутреннюю ML-платформу с собственным feature store, построенным на базе открытых технологий и адаптированном под требования локальных регуляций, доступов, локальных хранилищ (on-prem и частные облака). Архитектура поддерживает онлайн и оффлайн слои, контроль версий и аудит.
- Пример 2: интеграторы и банки используют гибридные подходы: Feast/Hopsworks как базовые паттерны, дополненные корпоративной политикой безопасности, интеграцией с внутренними каталогами данных и локальными хранилищами. Важно, что такие реализации позволяют соответствовать локальным требованиям по защите данных и доступности.
- Вывод: российские реализации чаще всего основаны на открытых паттернах с адаптацией под требования регуляторов, локальные хранилища и инфраструктуру, а также усиленным контролем доступа и аудита.
Пора к деталям реализации и техническим деталям интеграции, чтобы переходы между паттернами были понятны и практически применимы.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Схема идентификаторов и временных меток
- У каждого признака должна быть уникальная идентификация и явная временная привязка (event_time, ingestion_time).
- В трансформациях признаков учитывайте временную корректность: задержки, watermarking и обработку событий-опозданий.
- Типизация и сериализация
- Константная типизация признаков (INT64, FLOAT, STRING, BOOLEAN и т.д.).
- Сериализация в Parquet/Arrow для оффлайн-хранилищ; оптимизация онлайн-слоя (Redis, Cassandra) для низкой задержки.
- Версионирование и миграции
- Глобальная политика версий: versioning на уровне feature groups и views.
- Учет миграций: backward/forward совместимость, тестирование в песочнице.
- Интеграция с пайплайнами
- Обучение: пайплайн получает признаковый вектор через API feature store; результаты обучения сохраняются вместе с метаданными и версиями признаков.
- Инференс: онлайн-признаки запрашиваются в момент инференса, обеспечивая согласование версий с теми, что были использованы на этапе обучения.
- Протоколы и API
- REST/GRPC интерфейсы для запросов онлайн признаков.
- Запросы к оффлайн-хранилищам через стандартные аналитические движки (Spark, Dask, Presto/Trino).
- Безопасность и доступ
- RBAC на уровне объектов: группы, представления, признаки.
- Логи и аудит: хранение журналов доступа, изменений и ошибок на длительный срок.
- Примеры архитектурных решений
- Архитектура на Feast: оффлайн-хранилище (PostgreSQL/BigQuery/Snowflake) + онлайн-слой ( Redis) + механизм онлайн-запросов для инференса.
- Архитектура на Hopsworks: единый Feature Store с GUI, версиями, группами, API для потребителей и интеграция с Jupyter/Notebook-окружениями.
Риски, ограничения и типовые ошибки
- Несоответствие между онлайн и оффлайн версиями признаков
- Решение: синхронизация версий, явная привязка online_store_version и offline_store_version, мониторинг рассинхронов.
- Drift признаков и концептуальное расхождение между моделями
- Решение: встроенные тесты на drift, уведомления об изменениях источников данных.
- Перенасыщение признаков и дублирование
- Решение: управляемое удаление устаревших признаков, регламентирование TTL и политики удаления.
- Безопасность и соблюдение регуляторов
- Решение: аудит доступа, анонимизация данных, контроль над темами доступа к личным данным.
- Сложности изменения архитектуры
- Решение: поэтапные миграции, постепенное введение версий и контрактов.
- Масштабирование и затраты
- Решение: архитектура гибкость-эффективность: выбор онлайн-слоя под latency requirements, оптимизация кэширования.
Перспективы развития направления
- Усиление интеграции с управляемыми данными и метаданными (ML metadata) для improved reproducibility.
- Расширение функциональности feature vectors: поддержка динамических признаков, потоковых признаков в near-real-time режимах.
- Улучшение совместимости между различными фреймворками и пайплайнами: унифицированные трансформеры, контрактные тесты.
- Повышение уровня автоматизации: автоматическое определение зависимостей признаков, управление жизненным циклом признаков, автоматическое тестирование на drift и регрессии.
- Социально-правовые и инфраструктурные тренды: усиление локализации данных, соответствие регуляциям и безопасные многооблачные решения.
Заключение
Архитектурные паттерны feature groups, feature views и feature vectors образуют фундамент для устойчивого, масштабируемого и воспроизводимого управления признаками в рамках Feature Store. Правильная организация групп признаков, контрактов представлений и готовых векторов признаков позволяет не только ускорить разработку моделей, но и обеспечить повторяемость экспериментов, прозрачность в работе команд и соблюдение требований к качеству данных и безопасности. Интеграция этих паттернов с современными пайплайнами обучения, онлайн-сервисами и локальными инфраструктурами обеспечивает гибкость и долговременную ценность для организации.
Вопрос-Ответ (FAQ)
Что такое feature group и зачем она нужна?
Feature group - это логическая коллекция признаков, которая объединяет признаки одного источника данных или доменного контекста. Она нужна для управления качеством данных, упрощения доступов и версионирования. Группа позволяет централизовать владение признакми и их обновлениями, а также упрощает повторное использование признаков между моделями и проектами.
В чем разница между feature view и feature group?
Feature group - это физическая или логическая единица хранения признаков, ориентированная на источник данных. Feature view - контракт на набор признаков, который доступен потребителю. View может агрегировать признаки из одной или нескольких групп и задавать конкретный набор признаков, которые будут использованы моделью или пайплайном.
Что такое feature vector и как он связан с моделью?
Feature vector - готовый набор признаков, упакованный для подачи в модель. Вектор может быть представлен как единичная запись или батч признаков. Вектор обеспечивает единообразие входа в модель и позволяет повторно использовать признаки в разных моделях и задачах.
Какие типичные паттерны версионирования признаков и как их внедрить?
Типичный подход: версия на уровне feature group и на уровне feature view, с TTL и правилом откатов. Внедряется через политики версионирования, контрактов и тестов; важно поддерживать явное соответствие обучающих наборов и версий признаков, используемых в проде.
Как обеспечить согласование онлайн и оффлайн признаков?
Ключевые механизмы: единая система версий, синхронизация ключей (entity), контроль временных меток, тестирование на соответствие между offline записями и online-запросами. Мониторинг задержек и дрейфа помогает поддерживать согласованность.
Какие риски связаны с использованием feature store и как их минимизировать?
Риски: дрейф признаков, несовпадение версий между обучением и инференсом, задержки доступа к онлайн-признакам, сложности доступа и аудит. Минимум снижения рисков достигается через тестирование, аудит, документирование контрактов, версионирование и четкую ответственнось.
Какие open-source решения наиболее популярны и какие их сильные стороны?
Feast: хорошо подходит как основной паттерн для оффлайн- и онлайн-признаков, поддерживает интеграцию с разными хранилищами и пайплайнами обучения. Hopsworks Feature Store: предоставляет GUI, контроль версий и развертывание в рамках единого сервиса. MLRun (Iguazio) тоже реализует концепцию feature store и может быть полезен в стеке MLOps.
Какие российские практики можно привести в качестве ориентиров?
В крупных российских организациях часто реализуют внутренние ML-платформы на базе открытых паттернов: Feast/Hopsworks как ядро работы с признаками, дополненные локальными хранилищами, регуляторной политикой и контролем доступа. Эти решения позволяют удовлетворить требования к локализации данных, аудиту и совместной работе команд.
Как начать внедрение паттернов в существующую инфраструктуру?
Шаги: определить владельцев признаков и группы, выбрать целевые объемы признаков и источников, определить контракт и версию признаков, внедрить оффлайн-слой и онлайн-слой, организовать CI/CD для признаков и тестов, запустить пилот на одной задаче и далее масштабировать.
Какие будущие направления стоит учитывать при проектировании?
Расширение функционала векторной обработки признаков, более тесная integration с метаданными (ML metadata), автоматизация тестирования на drift, улучшение кросс-платформенной совместимости, поддержка streaming признаков и сокращение latency для прод-пайплайнов.
Дополнительные комментарии к реализации и практикам
При разработке паттернов следует начинать с малого: выберите одну feature group и одну feature view для пилота и затем постепенно расширяйте. Это позволит быстрее получить обратную связь, устранить узкие места и договориться об общем контракте.
Важно помнить: паттерны не являются «волшебной таблеткой» - они требуют дисциплины в управлении версиями, документацией и мониторингом. Успех достигается через чёткие политики, тестирование и участие бизнес-пользователей в определении признаков и контрактов.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


