

Версионирование данных и моделей: DVC, MLflow, Model Registry и артефакты
Эта глава фокусируется на том, как управлять версиями данных, моделей и связанных артефактов на протяжении всего жизненного цикла разработки ML-систем. В контексте курса «CI/CD для ML и MLOps автоматизация тестирования данных, моделей и инфраструктуры» версионирование становится фундаментом воспроизводимости, трассируемости и управления рисками. Мы разберём теоретические основы, архитектурные решения, практические подходы и примеры реальных реализаций: от открытых инструментов DVC и MLflow до российских платформ и практик, применимых в крупных организациях.
Введение
Версионирование - это не merely витрина изменений. Это механизм управления состоянием данных и моделей, который обеспечивает воспроизводимость экспериментов, контроль качества данных и управление артефактами на каждом этапе развёртывания. В MLOps практики версии данных позволяют избежать “feature leakage” и несоответствий между обучением и инференсом; версии моделей и артефактов позволяют повторно воспроизводить выводы и регистрировать переходы между стадиями внедрения (разработка, тестирование, продакшн).
В этой главе мы сосредоточимся на трех столпах:
- версионирование данных и данных-поисков (data lineage) и артефактов;
- управление моделями через реестры моделей (Model Registry) и жизненные циклы версий;
- архитектура CI/CD для ML, где данные и модели проходят через контролируемые конвейеры с проверками качества, тестами и метриками.
Теоретические основы и терминология
- Данные и артефакты в ML: данные обучающие, валидационные, тестовые наборы; признаки (features); результаты экспериментов; артефакты модели (weights, граф вычислений, сериализованные форматы).
- Версионирование данных: практика сохранения не только файлов, но и метаданных об их происхождении, состава и состояния, чтобы можно было восстановить конкретное состояние набора данных в конкретный момент времени.
- DVC (Data Version Control): инструмент для версионирования данных и пайплайнов, реализующий pointers к большим файлам в Git-репозитории. Обеспечивает совместное использование артефактов и повторяемость экспериментов через хранение данных в удалённых хранилищах.
- MLflow: платформа для экспериментирования и отслеживания экспериментов, логирования параметров, метрик, артефактов и моделей; включает компонент Model Registry для управления версиями и публикации моделей.
- Model Registry: реестр моделей с жизненным циклом версий и переходами статусов (например, Staging → Production). Поддерживает управление версиями, аннотирование и контроль доступа, а также эксперименты по откатам и отклонениям.
- Артефакты: любые выходы ML-цикла** - датасеты, признаки, пайплайны, отчёты об валидации, веса модели, конфигурации и прочие ресурсы, необходимые для воспроизведения и развёртывания.
Методологии и подходы
- Data-first версия: данные версионируются независимо от кода, чтобы исследователь мог вернуться к конкретной иллюстративной конфигурации и воспроизвести обучение.
- Immutable артефакты: каждое изменение данных или модели приводит к созданию новой версии артефактa, что снижает риск несоответствий и ошибок.
- Линейная и ветвящая история: поддержка параллельных веток данных и моделей, соответствующая разным экспериментам, фичингам и продержке в продакшне.
- Контроль качества на каждом шаге: в пайплайнах важны проверки целостности данных, валидации признаков, автоматические тесты пайплайна и регрессионный тестинг моделей.
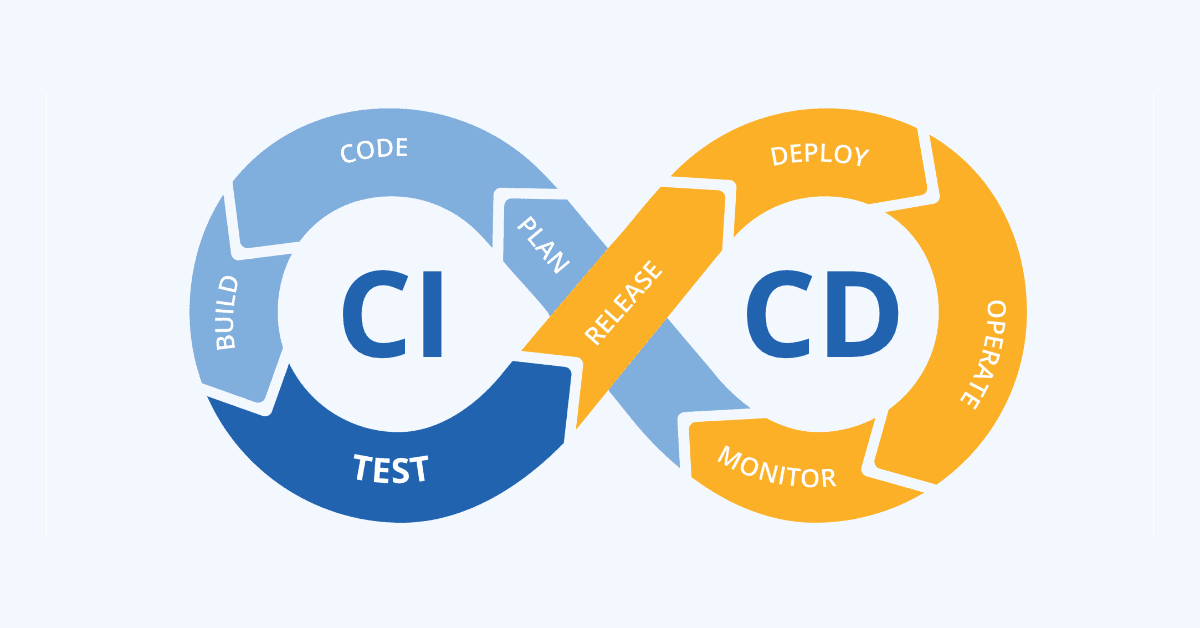
- Интеграция в CI/CD: конвейеры должны автоматически версионировать данные и модели, запускать тесты, регистрировать артефакты в Model Registry и обеспечивать безопасное развёртывание.
Архитектура и технологическая реализация
Архитектурная карта
- Источник кода и конфигураций: Git репозитории (конфигурации пайплайнов, скрипты подготовки данных, модели).
- Хранение данных: удалённое хранилище (S3, GCS, Azure Blob), локальные файлы или сетевые файловые системы; DVC хранит ссылки на файлы в репозитории, а сами файлы - в удалённом хранилище.
- Движок версионирования данных: DVC, который синхронно обновляет ссылки на данные и метаданные, отслеживает зависимости между данными и пайплайнами.
- Пайплайны и orchestration: Kubeflow Pipelines, Apache Airflow, или собственные конвейеры; выполняют этапы подготовки данных, обучения и тестирования.
- Модель и реестр артефактов: MLflow Tracking для экспериментов, MLflow Model Registry для версий и переходов стадий.
- Исполнение и развёртывание: сервера для MLflow, сервисы инференса, CI/CD runners, мониторинг и observability.
- Безопасность и соответствие: контроль доступа к артефактам, аудит действий, шифрование и хранение секретов.
Пример последовательности действий
- Инициализация проекта и конфигураций пайплайна в Git.
- Версионирование данных через DVC: dvc init, dvc add data/train.csv, dvc push.
- Обучение модели в изолированном окружении; логирование параметров и метрик в MLflow.
- Сохранение версии модели в Model Registry: регистрация новой версии, переход по стадиям.
- Включение в CI/CD: автоматические проверки качества данных, тесты на регрессию, регистрирование артефактов, развёртывание на тестовом окружении.
- Воспроизведение: использование точной версии данных и модели для воспроизведения эксперимента.
Пример кода и команд
-
DVC: создание и управление данными
dvc init
Добавление файла данных под контроль DVC
dvc add data/train.csv
Пуш артефактов в удалённое хранилище
dvc remote add -d origin s3://ml-artifacts-bucket dvc push
-
MLflow: отслеживание экспериментов и логирование артефактов
import mlflow
import mlflow.sklearn
from sklearn.ensemble import RandomForestClassifier
mlflow.set_experiment("credit-risk-experiment")
with mlflow.start_run(): model = RandomForestClassifier(n_estimators=200, random_state=42) model.fit(X_train, y_train) acc = model.score(X_valid, y_valid) mlflow.log_param("n_estimators", 200) mlflow.log_metric("accuracy", acc) mlflow.sklearn.log_model(model, "credit_model")
-
MLflow Model Registry: базовая операция с моделью
# Создать новую версию и поместить в Production mlflow models serve -m "runs://credit_model" -p 5000 # В REST API можно перелагать версию между стадиями: # POST /api/2.0/mlflow-model-registry/registry-models/{name}/versions # PATCH /api/2.0/mlflow-model-registry/versions/{version_id} -
Пример конвейера в GitHub Actions (упрощённо)
name: ML CI/CD
on: push: branches: [ main ]
jobs: build-and-test: runs-on: ubuntu-latest steps:
-
uses: actions/checkout@v3 -
name: Set up Python uses: actions/setup-python@v4 with: python-version: '3.9' -
name: Install dependencies run: | python -m pip install -r requirements.txt pip install dvc[all] mlflow -
name: Prepare data and run tests run: | dvc pull pytest tests/ -
name: Train and log run: | python train.py mlflow run . -
name: Push artifacts run: | dvc push
Архитектурные паттерны интеграции
- Непрерывное обучение через Model Registry: каждая версия обученной модели регистрируется, тестируется в staging и затем продвигается в production.
- Data lineage и воспроизводимость: DVC хранит цепочку зависимостей между данными и пайплайнами, позволяя повторно построить модель на той же версии данных.
- Разграничение окружений: хранение артефактов и конфигураций отдельно от кода; среда выполнения строго контролируется и повторима.
- Безопасность и доступ: роли и политики доступа к артефактам, журналирование действий, аудит изменений.
Организационные и процессные аспекты
- Роли и ответственности: Data Engineer отвечает за пайплайны и хранение данных; ML Engineer - за модели и экспериментирование; Platform/Infra - за инфраструктуру реестров и CI/CD.
- Процессы выпуска (release) моделей: планирование версий, review-коды изменений, тестирование на ограниченной выборке, постепенное продвинение в production с canary-слоями.
- Управление данными в корпоративной среде: соответствие требованиям по защите данных, политике хранения, срокам архивирования и удалению артефактов.
- Документация и прозрачность: ведение реестра изменений, карточек версий, описаний стадий, этикетки метрик и зависимостей.
Практические примеры и кейсы (open-source и российские решения)
- Open-source кейсы:
- DVC + MLflow в сочетании с Kubeflow Pipelines для полного цикла: версионирование данных, пайплайны обучения, регистр моделей и развёртывание.
- Kubeflow Pipelines как оркестратор и средство интеграции пайплайнов с Model Registry и артефактами.
- Российские решения и практики:
- Яндекс DataSphere как платформа для совместной разработки и MLOps, поддерживающая хранение наборов данных и управление версиями артефактов.
- СберКлауд в контексте корпоративных MLOps-практик: локальные развёртывания реестров моделей и пайплайнов с учетом требований к защите информации, ответственность за данные и аудит.
- Локальные реестры артефактов в крупных организациях: сочетание DVC/MLflow с собственными сервисами управления доступом и безопасностью; примеры использования в банковском секторе и телекомах для контроля версий и воспроизводимости.
- Обзорecкие уроки:
- Внесение данных в CI/CD: чем больше артефактов - тем выше риск утечек и сложнее контроль версий; решение - строгие политики хранения и удаления, ограничение по размеру артефактов в Git.
- Верификация данных и моделей: тесты на совместимость версий данных и предсказательной силы моделей; автоматический ревью и откаты.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
Алгоритмы и принципы версионирования
- Хеширование и контроль целостности: каждый артефакт сопровождается checksum (SHA-256), что позволяет отслеживать неизменность.
- Content-addressable storage: хранение артефактов по их содержимому, независимом от имени файла; обеспечивает уникальные версии и детерминированность.
- Дифференциация и патчи: хранение изменений между версиями там, где возможно, чтобы экономить место и ускорять восстановление.
Механизмы отслеживания и формат артефактов
- Данные: файлы набора, метаданные об источнике, параметры подготовки, признаки и целевые переменные; хранение в DVC-папке .dvc и удалённом хранилище.
- Модели: веса, граф вычислений, окружение (конфигурации зависимостей), документация по версии.
- Пайплайны: конфигурации YAML или Python-скрипты, которые описывают зависимости между шагами, параметры обучения и варианты валидации.
Протоколы и интеграции
- Протокол взаимодействия между Git и DVC: Git хранит конфигурации и метаинформацию; DVC хранит большие файлы в отдельном хранилище, синхронизируемом через команды dvc pull/push.
- Интеграция MLflow Registry с CI/CD: автоматическое регистрация моделей после успешных тестов; переходы стадий через API или UI.
- Интеграция с инфраструктурой мониторинга: сбор метрик с инференса, отслеживание дрейфа данных, алерты по вероятным сбоям.
Примеры инфраструктурных сценариев
- Локальный дата-центр: DVC + MLflow с локальным S3-совместимым хранилищем, соблюдение полисов безопасности.
- Облачное развёртывание: использованием S3/GCS-Blob как артефакт-репозитория и облачных реестров моделей, интеграция с CI-платформами (GitHub Actions, GitLab CI).
- Гибридная архитектура: данные остаются в внутреннем HDFS/NAS, артефакты - в облачном хранилище; меры к снижению латентности и сохранению конфиденциальности.
Риски, ограничения и типовые ошибки
- Утечки данных и leakage: риск передачи данных в тестовые окружения через артефакты; решение - строгие политики фильтрации, анонимизация и контроль доступа.
- Размер артефактов: большие датасеты и модели могут разрастаться в репозитории; решение - хранение в внешнем хранилище и использование дублирования только по необходимости.
- Неполная воспроизводимость: без точной версии зависимостей и окружения повторить обучение может быть невозможно; решение - фиксация окружения (conda/venv, контейнеры) и конфигураций пайплайнов.
- Несогласованность между версиями: различия между версиями данных, признаков и моделей; решение - строгое тестирование совместимости и регрессионные тесты.
- Откаты и деградации: риск ошибок при переходе между стадиями; решение - внедрение canary-release, rollback-процедуры и мониторинг.
Перспективы развития направления
- Расширение поддержки data lineage в промышленных платформах: автоматическое извлечение зависимостей между данными и пайплайнами, улучшение отслеживания происхождения признаков.
- Усовершенствование Model Registry: управление версиями в мультиобластной инфраструктуре, поддержка multiple-registries, ускорение развёртывания через патчи и delta-обновления.
- Интеграция с генеративными моделями: версия и контроль за большими моделями и их семантикой, особенно в контекстах приватности и ответственности.
- Расширение российских решений: внедрение локальных реестров артефактов, соответствие требованиям регуляторов, интеграция с внутренними корпоративными платформами и системами аудита.
Заключение
Версионирование данных и моделей - краеугольный камень надёжного MLOps. Оно обеспечивает воспроизводимость, прозрачность и управляемость в условиях возрастающих объёмов данных и усложнения моделей. Правильная архитектура версионирования, детальное хранение артефактов, грамотная настройка Model Registry и продуманная интеграция в CI/CD позволяют быстро тестировать гипотезы, безопасно переходить в продакшн и эффективно управлять рисками. Реальные кейсы, включая open-source решения (DVC, MLflow) и российские платформы, демонстрируют, что путь к масштабируемым и надёжным ML-системам лежит через дисциплину версионирования и четкие процессы управления артефактами.
FAQ
Что такое артефакт в контексте MLOps и зачем он нужен?
Артефакт - это конечный продукт этапа ML-цикла**: набор данных, признаковая матрица, обученная модель, конфигурации пайплайна, отчёты об валидации и метрики. Артефакты нужны для воспроизведения экспериментов, аудита, регрессионного тестирования и безопасного развёртывания.
В чём разница между версионированием данных и версионированием моделей?
Версионирование данных фиксирует состояние набора данных и признаков на момент эксперимента, поддерживая lineage между данными и пайплайнами. Версионирование моделей фиксирует конкретное состояние обученной модели и связанных конфигураций, включая окружение, параметры и метрики, что позволяет откатываться к конкретной версии и повторно использовать её в продакшене.
Как DVC помогает управлять данными без перегрузки Git?
DVC хранит большие файлы в удалённом хранилище и сохраняет в Git лишь ссылки и метаданные на данные, тем самым снижая размер репозитория и сохраняя воспроизводимость через привязку к конкретной версии данных.
Что даёт Model Registry и зачем он нужен в CI/CD?
Model Registry обеспечивает централизованный реестр версий моделей с жизненным циклом (Development, Staging, Production). Он упрощает управление правами доступа, тестирование, переходы между стадиями и аудит изменений, что критично при безопасном развёртывании.
Какие риски связаны с версионированием и как их минимизировать?
Риски: leakage, несогласованность версий, увеличение объёма артефактов. Меры: фильтрация данных, анонимизация, политики доступа, тестирование совместимостей, хранение артефактов вне кода и наличие регламентов по архивированию.
Как строится CI/CD для версионирования артефактов и моделей?
CI/CD для ML включает: DVC pull/push и проверку целостности данных; автоматическую тренировку и логирование в MLflow; автоматическое размещение версий в Model Registry; контрольные тесты и деплой в тестовую среду; мониторинг и возможность отката.
Какие open-source и российские решения можно использовать вместе?
Open-source: DVC, MLflow, Kubeflow Pipelines; их можно сочетать для полного цикла: версионирование данных, эксперименты, реестр моделей. Российские примеры: Яндекс DataSphere, СберКлауд MLOps и локальные архитектуры внутри крупных организаций, реализующие схожие принципы через интеграцию с собственными реестрами и политиками безопасности.
Какие типовые ошибки встречаются при внедрении версионирования?
Частые ошибки: хранение больших файлов непосредственно в Git, неполная фиксация окружения, отсутствие прозрачной политики доступа к артефактам, отсутствие версионирования данных, недостаточное тестирование на регрессию при изменениях данных.
Как оценивать эффективность версионирования в рамках проекта?
Метрики: доля воспроизводимых экспериментов, время от изменения данных до выпуска новой версии модели, точность и качество на продакшене по сравнению с тестовыми версиями, частота откатов и времени восстановления.
Что ждать в будущем в контексте версионирования данных и моделей?
Расширение возможностей lineage и метаданных, усиление интеграции с генеративными моделями, улучшенная поддержка локального и гибридного развёртывания, более тесная связь между реестрами и мониторингом, рост требования к аудиту и соответствию нормам.
Если ваша компания планирует масштабировать проекты машинного обучения, ключевым фактором становится создание устойчивой ML-платформы с практиками MLOps и автоматизированными CI/CD-процессами.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки готовности компании и архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые бизнес-процессы.


