

Архитектура данных для продвинутой аналитики: модели данных, хранилища и потоки
Процесс цифровой трансформации начинается с грамотной архитектуры данных. В условиях, когда пилотные проекты переходят в индустриальные применения, требования к архитектуре становятся жесткими: необходимо обеспечить единое понимание данных, предсказуемость качества, управляемость и защиту информации на масштабах всей организации. Эта глава рассматривает архитектурные концепции продвинутой аналитики, конкретизирует модели данных, критерии выбора хранилищ и принципы организации потоков данных от источников до потребителей аналитики и ML-моделей.
Краткое введение
Современная архитектура данных - это не просто совокупность компонентов. Это набор абстракций, которые позволяют строить устойчивые решения: от интеграции разнообразных источников до обеспечения единых семантик, управления версиями схем и поддержки строгих политик доступа. В переходном периоде от пилотной реализации к промышленному масштабированию важны принципы модульности, контрактной совместимости и управляемости. В данной главе акцент сделан на технических аспектах: схемах данных, хранилищах, потоках и механизмов контроля качества и безопасности.
- Краткое содержание главы
- Архитектурная концепция данных: слои, контракты, управление метаданными и lineage
- Модели данных, структуры и эволюция схем
- Хранилища данных: выбор, проектирование и современные паттерны
- Потоки данных: интеграция, обработка и обеспечение устойчивости
- Управление качеством данных, безопасность и соблюдение регуляторных требований
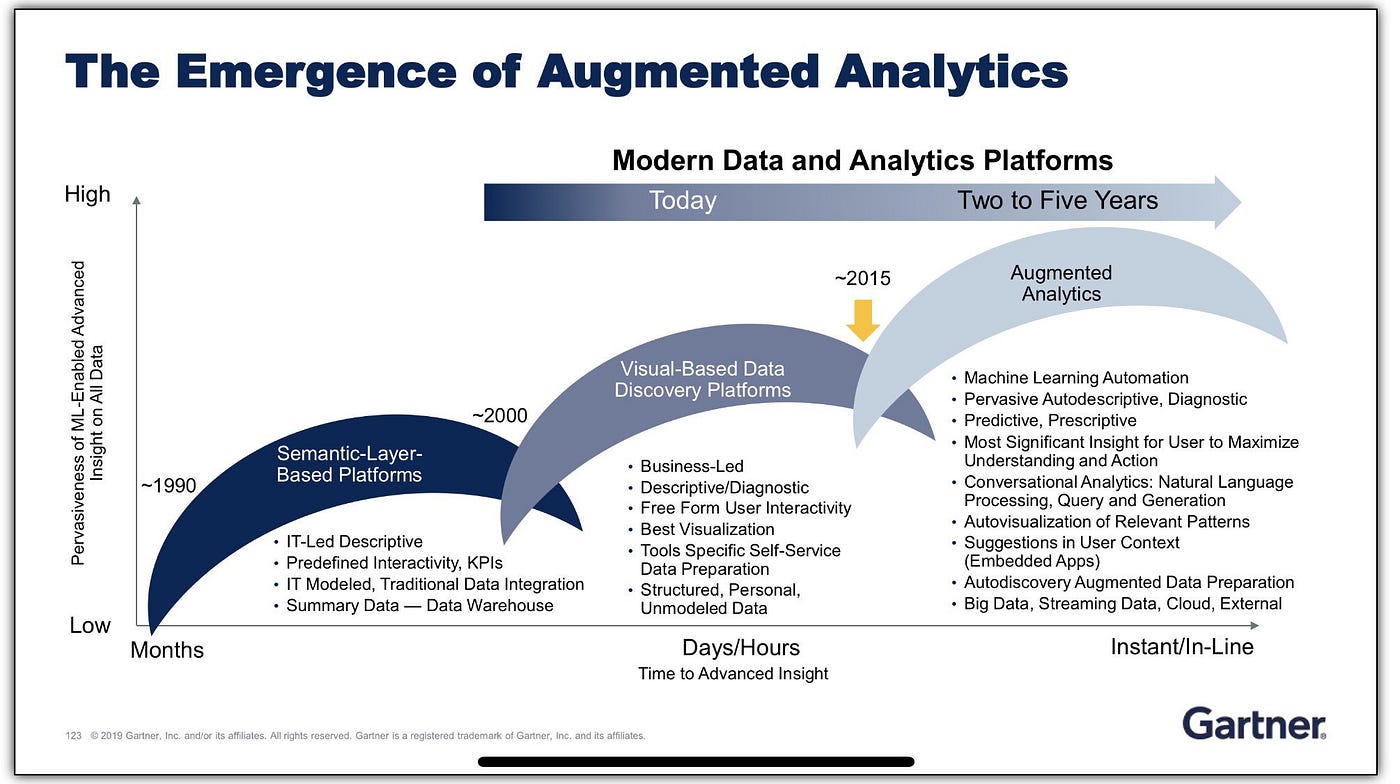
Архитектурная концепция данных
Архитектура данных в продвинутой аналитике строится вокруг четко delineated слоев, которые разделяют источники, хранение и вычисления. Это обеспечивает независимость между изменениями в источниках и потребителем аналитики, упрощает управление качеством и ускоряет внедрение новых форматов данных.
Основные принципы:
- Разделение по слоям: инжестия и оригинальные данные (raw), промежуточный слой (cleared/curated) и слой семантики (semantic/knowledge) - позволяют реализовать контроль целостности и версионирование.
- Контракты данных: явные соглашения о формате, семантике и правилах обработки между поставщиками данных и потребителями. Это снижает риск несовместимости при добавлении новых источников.
- Метаданные и lineage: прозрачная прослеживаемость происхождения данных, трансформаций и времени обновления. Это критично для аудита, воспроизводимости экспериментов и устранения ошибок.
- Безопасность и доступ к данным: политика доступа по ролям, шифрование в покое и в передаче, маскирование персональных данных, аудит доступа.
- Эволюционная архитектура: поддержка схемной эволюции, версионирования таблиц и адаптивного выбора хранилищ под разные режимы работы (батч vs поток).
Включение принципов архитектуры
Где возможно, архитектурные решения должны опираться на паттерны микроархитектуры и событийную интеграцию. В реальном мире часто встречаются три слоя взаимодействий: источники - брокеры сообщений - процессоры обработки. В качестве примера можно рассмотреть инфраструктуру, где источники передают данные в очередь событий (Kafka), далее данные обрабатываются бессерверными или кластерными вычислительными слоями (Spark/Flink), а результаты попадают в ленту изменений в хранилище. Такой подход обеспечивает асинхронность, масштабируемость и устойчивость к пиковым нагрузкам.
{
  "contractVersion": "1.0",
  "entities": {
    "customer": {
      "fields": [
        {"name": "customer_id", "type": "string", "nullable": false},
        {"name": "email", "type": "string", "nullable": true},
        {"name": "signup_date", "type": "date", "nullable": true}
      ],
      "primaryKey": ["customer_id"]
    }
  },
  "dataPolicies": {
    "retentionDays": 3650,
    "privacy": "PII-protected"
  }
}
Контракты данных позволяют ускорить внедрение новых источников и минимизировать риск несовместимости между компонентами архитектуры. Важной практикой является поддержка версий контрактов и автоматизированная проверка соответствий при изменениях в источниках и моделях.
Модели данных и структуры
Модели данных представляют собой конструкт данных, семантику и правила их обработки в аналитическом конвейере. На уровне концепций ориентиром служит разделение между концептуальной, логической и физической моделями, что позволяет системно подходить к структурированию информации и ее интерпретации аналитическими инструментами и ML-моделями.
Ключевые концепты:
- Canonical data model: унифицированная семантика, которая служит “языком” между различными источниками и целями анализа. Это снижает фрагментацию и облегчает агрегацию.
- Модели данных: концептуальная (что описывается), логическая (как описывается) и физическая (как реализуется). Разделение обеспечивает гибкость при изменении технологий хранения и обработки.
- Стратегии нормализации и денормализации: баланс между консистентностью и производительностью аналитических запросов. В продвинутой аналитике часто применяется денормализация для ускорения интерактивной аналитики и агрегатов.
- Архитектура схем и эволюция: версии схем, совместимость backward/forward и поддержка schema registry. В реальных условиях важно иметь механизм автоматической проверки совместимости схем при выпуске новых версий.
- Холодная и горячая семантика: различение volatile и persistent данных, чего требует управление временем жизни объектов, репликацией и кэшированием.
Эволюция структуры данных
Эволюция схем - частая реальность, особенно при интеграции новых источников и изменении требований бизнеса. Следующие принципы помогают поддерживать устойчивость:
- Версионирование схем: каждая версия фиксируется и поддерживается долгое время, перевод между версиями автоматизирован.
- Канонизация полей: ключевые идентификаторы и поля остаются неизменными или получают устойчивые алиасы, чтобы избежать поломки зависимостей.
- Совместимость по контрактам: при несовместимости инициируются миграционные пути, не прерывая доступ к текущим данным.
- Метаданныe и тестирование: автоматическое тестирование миграций схем и регрессионные проверки на совместимость.
Форматы и структуры хранения
Современная аналитика объединяет подходы реляционной и колоночной обработки, унифицированные через форматы колоночного хранения (Parquet, ORC) и современные табличные паттерны. В реальном проекте выбор зависит от профиля запросов: интерактивная аналитика, ML-образование или пакетная обработка больших массивов данных. В качестве примера можно встретить каноническую модель, где ключевые сущности (клиенты, заказы, продукты) описаны через объединенный набор атрибутов и связанных зависимостей. Вопрос о нормализации и денормализации решается на уровне целевых сцен: BI-дашборды чаще выигрывают от денормализации ради скорости, аналитические конвейеры - от нормализации ради консистентности.
Хранилища данных: выбор и проектирование
Хранилища данных являются сердцем аналитической инфраструктуры. Они должны сочетать масштабируемость, производительность, управляемость и стоимость. В современных архитектурах ключевыми являются концепции data lakehouse, а также специализированные OLAP-решения. Важно выбрать подходящие хранилища под режимы обработки, корпоративные требования к безопасности и регуляторные ограничения.
Основные направления:
- Data lakehouse как единое хранилище для Raw, Curated и Semantics слоев; обеспечивает единый обмен данными и упрощает управление данными в масштабе. При этом нужно учитывать требования к управляемости и трансформациям. Популярные паттерны включают управление временем жизни данных, хранение на облачных платформах и использование каталогов метаданных.
- Форматы и каталоги: Parquet/ORC как эффективные колоночные форматы, поддержка компрессии и схемной эволюции. Использование каталога данных (метаданных) для управления схемами, правами доступа и версионированием.
- Табличные паттерны и таблицы: широкие таблицы из денормализованных данных против нормализованных моделей; разделение на фактные и размерные таблицы. В некоторых случаях применяется модель Data Vault для историчности и гибкости интеграции.
- Архитектурные решения: выбор между data lake, data warehouse и hybrid решения зависит от требования к скорости, объему и стоимости, а также от наличия эксплуатационных процессов и компетенций в организации.
- Географическая и организационная локализация данных: необходимость соответствия политикам локализации, управлению доступом и скорости доступа к данным в разных бизнес-единицах.
Современные архитектуры хранения
Data lakehouse - это повторяемый шаблон для объединения преимуществ ленивого хранения и высокопроизводительного вычисления. В таких системах часто применяют таблицы, поддерживаемые на уровнях файловой системы (например, Parquet) и управляющие слои, такие как Iceberg или Delta Lake, которые обеспечивают транзакционность и схему эволюцию на уровне данных. В рамках данного подхода важно обеспечить:
- Транзакционность и версионирование данных, чтобы операции чтения всегда видели консистентное состояние набора данных.
- Поддержку множественных схем и миграций, чтобы бизнес-пользователи могли безопасно внедрять изменения.
- Эффективную себестоимость хранения и обработки, включая компрессию и оптимизацию форматов.
Примеры технологий:
- ClickHouse как высокопроизводительный OLAP-движок, хорошо подходящий для интерактивной аналитики и агрегаций в реальном времени.
- Apache Iceberg как табличный формат и управляющий слой, обеспечивающий транзакции, schema evolution и partitioning на больших объёмах данных.
Форматы и каталоги
Эффективная организация каталога данных и форматов - фундамент для управляемости и повторяемости аналитики. Parquet и ORC позволяют экономить место и ускоряют сканирование столбцов. Каталоги метаданных (data catalogs) служат «навигатором» по данным: они описывают источники, схемы, политики доступа, версии и линейку времени данных. В реальных проектах каталоги помогают автоматизировать соответствие требованиям регуляторов, а также упрощают доступ к данным для BI и ML команд.
Управление схемой и эволюцией
Эволюция схем требует поддержки версий, обратной совместимости и планирования миграций. Регистрация схем и автоматизированная валидация изменений позволяют снизить риск возникновения несогласованности между источниками и потребителями данных. В этом контексте роль data contracts усиливается: изменение схем должно сопровождаться обновлением контракта, тестами совместимости и уведомлением потребителей.
Потоки данных: интеграция и обработка
Потоки данных описывают как данные перемещаются и обрабатываются в режиме реального времени или батческой загрузки. Эффективная архитектура потоков обеспечивает своевременную доставку данных, корректность обработки и возможность повторного воспроизведения в случае сбоев.
Основные концепции:
- Батч vs поток: выбор режима зависит от частоты обновления источников, требуемой задержки и бизнес-логики. Часто применяется гибридная архитектура, где критически важные события обрабатываются в потоковом режиме, остальное - батчами.
- Обработчики потоков: Kafka как брокер событий, Spark и Flink как движки обработки; Kafka Streams обеспечивает внутри-процессорную обработку, световую интеграцию с внешними системами.
- Idempotence и exactly-once semantics: обработка повторных сообщений не должна искажать данные. В особо чувствительных контурах необходимо проектировать idempotent операции и детерминированные ключи.
- Времена и окна: управление event time и processing time, оконные стратегии для агрегаций, периодические задачи и задержки в обработке должны быть тщательно продуманы для корректной аналитики.
- Мониторинг и устойчивость: отслеживание задержек, ошибок, пропусков и загрузки конвейеров, автоматическое повторное воспроизведение и ретрансляции.
Интеграционные протоколы и прототипы
Эффективная интеграция требует сочетания протоколов и стандартов: Kafka для стриминга, REST/gRPC для синхронного доступа, CDC-инструменты для синхронной инкрементной загрузки. В рамках продвинутой аналитики целесообразно применить CDC-решения для минимизации задержек и поддержания консистентности между системами.
Управление качеством и обработкой ошибок
Ключевые практики включают:
- Проверку форматов данных на входе и в конвейере;
- Установку порогов качества и автоматические предупреждения;
- Механизмы повторной обработки и дедупликации;
- Логирование и трассировку для аудита и воспроизводимости.
Реализация и интеграции: подход к внедрению
При переходе от пилота к промышленному масштабу требуется системный подход к миграциям. Рекомендованы эволюционные шаги: начать с наиболее критичных сценариев аналитики, затем расширять покрытие источников, применяя принцип минимальной достаточности и повторяемости. Важно обеспечить совместимость между существующими коннекторами и новыми источниками, а также планирование роллов-ап для ML-платформ.
Управление данными, качество и безопасность
Глобальная архитектура данных обеспечивает не только функциональность, но и соответствие нормам конфиденциальности, законодательства и корпоративной политике. Эффективные практики сочетания качества данных, управления данными и обеспечения безопасности позволяют снизить риски и ускорить внедрение решений.
- Управление данными и эстетика контроля: наличие политики управления данными, распределение ролей, процесс approvals и регламентированные процессы изменения данных.
- Качество данных: определение KPI качества, создание визуализаций качества, автоматическое проставление правил контроля на этапах конвейера, регламентные проверки и исправления ошибок.
- Метаданные и линейность: линейность происхождения данных, прослеживаемость трансформаций и ответственности за данные.
- Безопасность и доступ: RBAC, политики шифрования, маскирование данных, аудит доступа и соответствие требованиям регуляторов (например, GDPR/локализация данных).
- Этические и правовые аспекты: управление персональными данными, согласование использования данных для исследований и продуктовых решений.
В этом контексте архитектура должна быть поддержана инструментарием по каталогам и автоматическими тестами соответствия. Одним из примеров инструментария для каталогов является Amundsen, который обеспечивает видимость датасетов, их семантику и связи между источниками. В контексте российских проектов для хранилищ и аналитики можно упомянуть использование ClickHouse как OLAP-движка, который хорошо подходит для анализа больших массивов данных в реальном времени, в сочетании с Iceberg как формата таблиц для управления схемами и версиями данных.
Key takeaways
- Архитектура данных должна быть слоистой и контрактной, чтобы ускорять внедрение и снижать риск несогласованности между источниками и потребителями.
- Модели данных требуют четкой эволюции схем и управления версиями; canonical data model упрощает интеграцию.
- Выбор хранилища зависит от требований к скорости, масштабу и затрат; lakehouse-подходы объединили хранение и вычисления на едином уровне, но требуют жестких политик управления схемами и безопасностью.
- Потоки данных должны сочетать батчевые и стримовые режимы, обеспечивая idempotentность и exactly-once там, где это критично; временные окна требуют четкой настройки.
- Управление качеством данных, каталогами и безопасностью - ключ к устойчивости и соответствию регуляторным требованиям.
- Реализация перехода от пилота к промышленному применению требует поэтапной миграции, устойчивого управления изменениями и наличия планов отката.
FAQ
1) Что такое lakehouse и зачем он нужен в продвинутой аналитике?
Lakehouse - это паттерн хранения данных, объединяющий преимущества data lake и data warehouse: масштабируемость и гибкость ленивого хранения с функциональностью транзакций, схемной эволюции и ускоренной аналитикой. В промышленной среде lakehouse упрощает интеграцию разнообразных источников, ускоряет развёртывание новых аналитических сценариев и снижает суммарную стоимость владения за счёт единых хранилищ и механизмов контроля качества.
2) Как выбрать между слоем raw, curated и semantic?
Raw содержит прямые копии источников; curated - очищенные и структурированные данные; semantic - бизнес-ориентированные семантики и готовые к потреблению наборы. Выбор зависит от потребителей и сценариев: для инженерной аналитики и ML полезно наличие чистых, хорошо документированных наборов, в то же время BI может требовать более денормализованных, семантически понятных материалов. В идеале архитектура поддерживает все три слоя с четкими контрактами между ними.
3) Какие типичные паттерны схемной эволюции применяют на практике?
Чаще всего применяют версионирование схем и совместимость backward/forward. Используется schema registry для фиксации версий и автоматических проверок на изменение схем при загрузке данных. Эволюционные миграции обычно реализуются через шаговые переходы: новая версия таблицы создаётся параллельно со старой, данные мигрируют, потребители переключаются на новую схему, затем устаревшая версия удаляется.
4) Какие технологии стоит упомянуть как базовые примеры для потоков данных?
Для потоков данных часто применяются Kafka в качестве брокера событий, вместе с инструментами обработки (Flink, Spark Streaming) и движками для репликации изменений (CDC). В рамках хранилищ для интервальных и реальных запросов разумно рассмотреть ClickHouse для OLAP-аналитики и Iceberg как управляемый слой таблиц, поддерживающий транзакции и эволюцию схем.
5) Как обеспечить idempotentность и exactly-once semantics в обработке потоков?
Это достигается посредством идентификаторов транзакций и детерминированных ключей, использования системных механик повторной обработки и дедупликации, а также контроля непрерывной консистентности на уровне конвейера. Архитектура должна поддерживать повторное воспроизведение потоков без дублирования данных.
6) Какие аспекты безопасности критичны для архитектуры данных в цифровой трансформации?
Необходимо управление доступом по ролям (RBAC), шифрование данных в покое и в передаче, маскирование чувствительных данных, аудит доступа, мониторинг подозрительных действий и соответствие регуляторным требованиям. Встроенная политика управления данными должна быть частью архитектуры, а не вспомогательным компонентом.
7) Что считать критерием успешной миграции пилота в промышленное внедрение?
Необходимо наличие повторяемых конвейеров, устойчивых метрик качества и задержек, ясных контрактов и версий схем, управляемых каталогов и линий происхождения данных, а также готовности команд к эксплуатации и сопровождению в условиях растущего объема и сложности данных.
8) Какую роль играет метаданные и lineage в продвинутой аналитике?
Метаданные и lineage позволяют видеть источник данных, трансформации, версии и частоту обновления. Это критично для воспроизводимости экспериментов, аудита, устранения причин проблем и обеспечения доверия бизнес-пользователей к результатам аналитики.
9) Какие практики полезны для интеграции новых источников данных?
Используйте контрактные соглашения, автоматические проверки совместимости схем, пилотные запуски на ограниченном наборе данных и поэтапный переход потребителей на новые источники. Важно обеспечить прозрачность изменений и минимизировать риск простоев потребителей.
10) Какие сигналы показывают, что архитектура готова к промышленному масштабу?
Стабильная работа конвейера, предсказуемые задержки и-throughput, эффективная автоматизация управления версиями схем и контрактами, четко работающие политики безопасности и доступа, а также наличие инструментов мониторинга и оповещений по всем слоям архитектуры. Важным признаком является способность быстро масштабировать горизонтально, не ухудшая качество данных и научной точности выводов.
Конечная мысль: архитектура данных в рамках продвинутой аналитики - это не набор технологий, а управляемый, эволюционный конструктор, который обеспечивает единое понимание данных, безопасность и гибкость для масштабирования аналитики и ML-инициатив в рамках цифровой трансформации.
Чтобы искусственный интеллект приносил реальную бизнес-ценность, необходимо выстроить не только модели, но и архитектуру данных, процессы управления и платформу для масштабирования AI-инициатив.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки потенциала AI и подготовки данных до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые процессы компании.


