

ETL: что такое, зачем и для кого
В статье рассмотрено одно из ключевых BI-понятий (Business Intelligence) – ETL-технологии: определение, история возникновения, основные принципы работы, примеры реализации и типовые варианты использования (use cases). Также отмечены некоторые проблемы применения ETL и способы их решения с помощью программных инструментов обработки больших данных (Big Data).
ЧТО ТАКОЕ ETL И ЗАЧЕМ ЭТО НУЖНО
Начнем с определения: ETL (Extract, Transform, Load) – это совокупность процессов управления хранилищами данных, включая :
- извлечение данных из внешних источников (таблицы баз данных, файлы);
- преобразование и очистка данных согласно бизнес-потребностям;
- загрузка обработанной информации в корпоративное хранилище данных (КХД).
Понятие ETL возникло в результате появления множества корпоративных информационных систем, которые необходимо интегрировать друг с другом с целью унификации и анализа хранимых в них данных. Реляционная модель представления данных, подходящая для потребностей транзакционных систем, оказалась неэффективной для комплексной обработки и анализа информации. Поиск унифицированного решения привел к развитию хранилищ и витрин данных – самостоятельных систем хранения консолидированной информации в виде измерений и показателей, что считается оптимальным для формирования аналитических запросов .
Прикладное назначение ETL состоит в том, чтобы организовать такую структуру данных с помощью интеграции различных информационных систем. Учитывая, что BI-технологии позиционируются как «концепции и методы для улучшения принятия бизнес-решений с использованием систем на основе бизнес-данных» , можно сделать вывод о прямой принадлежность ETL к этому технологическому стеку.
КАК УСТРОЕНА ETL-СИСТЕМА: АРХИТЕКТУРА И ПРИНЦИП РАБОТЫ
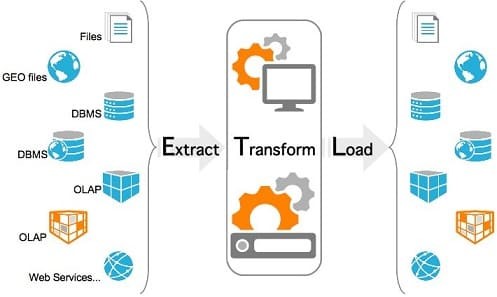
Независимо от особенностей построения и функционирования ETL-система должна обеспечивать выполнение трех основных этапов процесса ETL-процесса (рис.1) :
- извлечение данных из одного или нескольких источников и подготовка их к преобразованию (загрузка в промежуточную область, проверка данных на соответствие спецификациям и возможность последующей загрузки в ХД);
- трансформация данных – преобразование форматов и кодировки, агрегация и очистка;
- загрузка данных — запись преобразованных данных, включая информацию о структуре их представления (метаданные) в необходимую систему хранения (КХД) или витрину данных.

Рис. 1. Обобщенная структура процесса ETL
Таким образом, ETL-процесс представляет собой перемещение информации (потока данных) от источника к получателю через промежуточную область, содержащую вспомогательные таблицы, которые создаются временно и исключительно для организации процесса выгрузки (рис. 2) . Требования к организации потока данных описывает аналитик. Поэтому ETL – это не только процесс переноса данных из одного приложения в другое, но и инструмент подготовки данных к анализу.

Рис. 2. Потоки данных между компонентами ETL
На практике ETL выступает в качестве промежуточного слоя между OLTP - и OLAP -системами. OLTP (Online Transaction Processing) – это транзакционные системы для обработки непрерывного потока небольших по размеру транзакций в режиме реального времени: ERP-, MES-, банковские и биржевые приложения. Они автоматизируют структурированные, повторяющиеся задачи обработки данных, например, ввод заказов и банковские транзакции, в большом количестве за короткие промежутки времени. Однако сложные аналитические запросы, например, сколько товаров категории «предметы народного промысла» было куплено молодыми людьми 18-30 лет в городах-миллионниках за последние 3 года, в таких системах выполняются очень долго .
Для подобных запросов предназначены OLAP-системы. OLAP (Online Analytical Processing) – это интерактивная аналитическая обработка, подготовка суммарной (агрегированной) информации на основе больших массивов данных, структурированных по многомерному принципу. При этом строится сложная структура данных – OLAP-куб, включающий таблицу фактов, по которым делаются ключевые запросы и таблицы агрегатов (измерений), показывающие, как могут анализироваться агрегированные данные. Например, группировка продуктов по городам, производителям, потребителям и другие сложные запросы, которые могут понадобиться аналитику. Куб потенциально содержит всю информацию, нужную для ответов на любые количественные и пространственно-временные вопросы. При огромном количестве агрегатов зачастую полный расчёт происходит только для некоторых измерений, для остальных же производится «по требованию» .
Таким образом, основные функции ETL-системы можно представить в виде последовательности операций по передаче данных из OLTP в OLAP (рис. 3) :
- загрузка в ETL «сырых» данных (Raw Data) произвольного качества для дальнейшей обработки. При этом выполняется сверка суммы пришедших строк: если в системе-источнике больше строк, чем в Raw Data, то загрузка прошла с ошибкой.
- валидация данных, когда данные последовательно проверяются на корректность и полноту, составляется отчет об ошибках для исправления;
- настройка соответствия (мэппинг) данных с целевой моделью, когда к валидированной таблице пристраиваются столбцы по количеству справочников целевой модели, а потом в каждой пристроенной ячейке каждой строки проставляются соответствие значений целевых справочников (1:1, *:1, 1:* или *:*);
- агрегация данных, необходимая из-за разности детализации данных в OLTP и OLAP-системах. OLAP представляет собой полностью денормализованную таблицу фактов и окружающие ее таблицы справочников по схеме звездочка или снежинка. При этом максимальная детализация сумм OLAP равна количеству перестановок (агрегаций) всех элементов всех справочников. OLTP-система может содержать несколько сумм для одного и того же набора элементов справочников. Чтобы проследить, из каких строк OLTP сформировалась сумма в ячейке OLAP-системы, необходим мэппинг OLTP-детализации, а потом «склейка» данных в отдельной таблице для загрузки в OLAP.
- выгрузка в целевую систему с использованием коннектора и интерфейсных инструментов.

Рис. 3. ETL-процесс по передаче данных от OLTP в OLAP
НЕМНОГО ПРО ХРАНИЛИЩА И ВИТРИНЫ ДАННЫХ
ETL часто рассматривают как средство переноса данных из различных источников в централизованное КХД. Однако КХД не связано с решением какой-то конкретной аналитической задачи, его цель — обеспечивать надежный и быстрый доступ к данным, поддерживая их хронологию, целостность и непротиворечивость. Чтобы понять, каким образом КХД связаны с аналитическими задачами и ETL, для начала обратимся к определению.
Корпоративное хранилище данных (КХД, DWH – Data Warehouse) – это предметно-ориентированная информационная база данных, специально разработанная и предназначенная для подготовки отчётов и бизнес-анализа с целью поддержки принятия решений в организации. Информация в КХД, как правило, доступна только для чтения. Данные из OLTP-системы копируются в КХД таким образом, чтобы при построении отчётов и OLAP-анализе не использовались ресурсы транзакционной системы и не нарушалась её стабильность. Есть два варианта обновления данных в хранилище :
- полное обновление данных в хранилище, когда старые данные удаляются, потом происходит загрузка новых данных. Процесс происходит с определённой периодичностью, при этом актуальность данных может несколько отставать от OLTP-системы;
- инкрементальное обновление, когда обновляются только те данные, которые изменились в OLTP-системе.
ETL-процесс позволяет реализовать оба этих способа. Отметим основные принципы организации КХД :
- проблемно-предметная ориентация, когда данные объединяются в категории и хранятся в соответствии с областями, которые они описывают, а не с приложениями, которые они используют;
- интегрированность – данные объединены так, чтобы они удовлетворяли всем требованиям предприятия в целом, а не конкретной бизнес-функции;
- некорректируемость – данные в КХД не создаются, а поступают из внешних источников, не корректируются и не удаляются;
- зависимость от времени – данные в хранилище точны и корректны только в том случае, когда они привязаны к некоторому промежутку или моменту времени.
Витрина данных (Data Mart) представляет собой срез КХД (как на срезах в Fine BI) в виде массива тематической, узконаправленной информации, ориентированного, например, на пользователей одной рабочей группы или департамента. Витрина данных, аналогично дэшборд-панели, позволяет аналитику увидеть агрегированную информацию в определенном временном или тематическом разрезе, а также сформировать и распечатать отчетные данные в виде шаблонизированного документа .
При проектировании хранилищ и витрин данных аналитику следует ориентироваться на возможности их прикладного использования и с учетом этого разрабатывать ETL-процессы. Например, если известно, что информация, поступающая из определенных подразделений, является самой важной и полезной, а также наиболее часто анализируется, то в регламент переноса данных в хранилище стоит внести соответствующие приоритеты. Это позволит ускорить работу с информацией, что особенно важно для data-driven организаций со сложной многоуровневой филиальной структурой и большим количеством подразделений .
ПРИКЛАДНЫЕ КЕЙСЫ ИСПОЛЬЗОВАНИЯ ETL-ТЕХНОЛОГИЙ
Рассмотрим пару типовых примеров использования ETL-систем .
Кейс 1. Прием нового сотрудника на работу, когда требуется завести учетную карточку во множестве корпоративных систем. В реальности в средних и крупных организациях этим занимаются специалисты разных подразделений, не скоординировав задачу между собой. Поэтому на практике часто возникают ситуации, когда принятый на работу сотрудник подолгу не может получить банковскую карту, потому что его учетная запись не была вовремя заведёна в бухгалтерии, а уже уволенные сотрудники имеют доступ к корпоративной почте и приложениям, т.к. их аккаунты не заблокированы в домене. ETL поможет быстро наладить взаимодействие между всеми корпоративными информационными системами.
Аналогичным образом ETL-технологии помогут автоматизировать удаление аккаунтов сотрудника из всех корпоративных систем в случае увольнения. В частности, как только в HR-систему попадут данные о дате окончания карьеры сотрудника на этом месте работы, информация о необходимости блокировки его записи поступит контроллеру домена, его корпоративная почта автоматически архивируется, а почтовый ящик блокируется. Также возможен полуавтоматический режим с созданием заявки на блокировку в службу технической поддержки, например, Help Desk.
Кейс 2. Разноска платежей, когда при взаимодействии со множеством контрагентов необходимо сопоставить информацию в виде платёжных документов, с деньгами, поступившими на расчетный счёт. В реальности это два независимых потока данных, которые сотрудники бухгалтерии или операционисты связывают вручную. Далеко не все корпоративные финансовые системы имеют функцию автоматической привязки платежей.
Итак, информация о платежах поступает от платежной сети в зашифрованном виде, т.к. содержит персональные данные. Вторым потоком данных являются файлы в формате DBF, содержащие информацию о банках-контрагентах, которая требуется для геолокации платежа. Наконец, с минимальной задержкой в три банковских дня, приходят деньги и выписка с платежами, проведёнными через банк-партнёр. Отметим, что в реальности прямой связи между всеми этими данными нет: номера документов, указанные в реестрах от платёжной системы и банка, не совпадают, а из-за особенностей работы банка дата платежа, которая значится в выписке, может не соответствовать дате реальной оплаты, которая содержится в зашифрованном файле реестра.
Расшифровку данных можно включить в ETL-процесс, в результате чего получится текстовый файл сложной структуры, содержащий ФИО, телефон, паспортные данные плательщика, сумму и дату платежа, а также дополнительные технические данных, идентифицирующие транзакцию. Это как раз позволит связать платёж с данными из банковской выписки. Данные из реестра обогащаются информацией о банках-контрагентах (филиалах, подразделениях, городах и адресах отделений), после этого осуществляются их соответствие (мэппинг) к конкретным полям таблиц корпоративных информационных систем и загрузка в КХД. Обогащение уже очищенных данных происходит в рамках реляционной модели с использованием внешних ключей.
После прихода банковской выписки запускается ещё один ETL-процесс, задача которого состоит в сопоставлении ранее полученной информации о платежах с реально пришедшими деньгами. Поскольку выписки приходят из банка в текстовом формате, первым шагом трансформации является разбор файла, затем идет процесс автоматической привязки платежей с использованием информации, ранее загруженной в корпоративную систему из реестров платежей и банков. В процессе привязки происходит сравнение не только ключей, идентифицирующих транзакцию, но и суммы и ФИО плательщика, а также отделения банка. Также решается задача исправления неверной даты платежа, указанной в банковской выписке, на реальную дату его совершения.
В результате нескольких ETL-процессов получилась система автоматической привязки платежей, при этом основные затраты были связаны с не с разработкой программного обеспечения, а с проектированием и изучением форматов файлов. В редких случаях ручной привязки обогащение данных с помощью ETL-технологии существенно облегчает эту процедуру. В частности, наличие телефонного номера плательщика позволяет уточнить данные о платеже лично у него, а геолокация платежа даёт информацию для аналитических отчётов и позволяет более эффективно отслеживать переводы от партнёров-брокеров (рис. 4).

Рис. 4. Организация разноски платежей с помощью ETL


СОВРЕМЕННЫЙ РЫНОК ETL-СИСТЕМ И ОСОБЕННОСТИ ВЫБОРА
Существует множество готовых ETL-систем, реализующих функции загрузки данных в КХД. Среди коммерческих решений наиболее популярными считаются следующие :
- IBM WebSphere DataStage;
- Informatica PowerCenter;
- Oracle Data Integrator;
- SAP Data Services;
- SAS Data Integration Server;
К категории условно бесплатных можно отнести :
- Oracle Warehouse Builder;
- Talend Open Studio;
- Scriptella;
- Pentaho.
При выборе готовой ETL-системы необходимо, в первую очередь, руководствоваться не бюджетом ее покупки или стоимостью использования, а следующими функциональными критериями:
- совместимость с источниками данных – современные КХД могут строиться на основе различных моделей данных (многомерных, реляционных, гибридных), поэтому ETL-систем должна быть универсальной, чтобы извлекать и переносить данные как можно большего числа типов и форматов ;
- наличие инструментов разработки (API, коннекторов и т.д.) для масштабирования и интеграции со сторонними системами (источниками и потребителями данных), а также для создания оригинальных алгоритмов операций с данными;
- «зрелость» системы, включающая завершенность ее функциональных возможностей, простоту эксплуатации и уровень технической поддержки.
Многие из современных промышленных решений представляют собой технологические платформы, позволяющие масштабировать ETL-процессы с поддержкой параллелизма выполнения операций, перераспределением нагрузки по обработке информации между источниками и самой системой, а также другими функциями в области интеграции данных. Поэтому выбор ETL-средства – это своего рода компромисс между конкретным проектным решением, текущими и будущими перспективами использования ETL-инструментария, а также стоимостью разработки и поддержания в актуальном состоянии всех используемых функций ETL-процесса .
НЕКОТОРЫЕ ПРОБЛЕМЫ ETL-ТЕХНОЛОГИЙ И СПОСОБЫ ИХ РЕШЕНИЯ
Как правило, ETL-системы самостоятельно справляются с проблемами подготовки данных к агрегированию и анализу, выполняя операции очистки данных. При этом устраняются проблемы качества данных: проверка на корректность форматов и типов, приведение значений к нужному диапазону, заполнение пропусков, удаление дубликатов, противоречий и нарушений структуры. Однако, кроме очистки данных, можно выделить еще пару трудоемких задач, которые не решаются автоматически:
- выбор источников данных – перед запуском процесса извлечения данных следует определить, где и в каком виде хранится информация, которая должна попасть в КХД. При этом аналитик данных должен учесть следующие факторы:
значимость данных с точки зрения анализа; сложность получения данных из источников; возможное нарушение целостности и достоверности данных; объем данных в источнике.
На практике часто приходится искать компромисс между этими факторами. Например, данные могут представлять несомненную ценность для анализа, но сложность их извлечения или очистки может свести на нет все преимущества от использования .
- разрозненность конечных данных – после того, как Data Analyst определил, какая информация и из каких источников должна попадать в КХД, эти источники становятся основными репозиториями. Содержимое витрин данных становится доступным для пользователей, однако исходные данные не хранятся и не могут быть извлечены. Но на практике различным категориям пользователей нужно больше информации, чем предоставляют ETL-системы. В этом случае пользователи создают свои собственные, локальные хранилища и витрины данных, которые не интегрированы с общим КХД. В результате при использовании одной и тоже же по смыслу информации у разных бизнес-подразделений возникают разночтения, что приводит к несогласованности в работе .
- появление новых источников и форматов представления данных – традиционные ETL-инструментов хорошо подходят для обработки структурированных данных, однако в реальности часто возникает необходимость работы с полуструктурированной или неструктурированной информаций. В этом случае следует подключать технологии больших данных (Big Data), например, Apache Hive и Pig для загрузки и преобразования информации, хранящейся в распределенной файловой системе Hadoop Distributed File System (HDFS). Hive реализует принципы традиционных баз и хранилищ данных на основе SQL-запросов и схем, а Pig похож на стандартный язык ETL-сценариев. Оба инструмента используют функции MapReduce в пакетной обработке данных .
Таким образом, Big Data инструменты пакетной и потоковой обработки позволяют дополнить типовые ETL-системы, предоставляя бизнес-пользователям более широкие возможности по работе с корпоративной информацией. Однако, в этом случае временные, трудовые и финансовые затраты на аналитику данных существенно возрастут, т.к. понадобятся дорогие специалисты: Data Engineer, который выстроит конвейер данных (pipeline), а также Data Scientist (Data Fine BI), который разработает программное приложение для онлайн-аналитики, включая оригинальные ML-алгоритмы. Впрочем, такие инвестиции будут оправданы, если предприятие достигло хотя бы 3-го уровня управленческой зрелости по модели CMMI, обладает большим количеством разных данных с высоким потенциалом для аналитики и стремится стать настоящей data-driven компанией. Однако, чтобы эти вложения принесли выгоду, а не превратились в пустые траты, стоит адекватно оценить свои потребности и возможности, возможно, с привлечением внешнего консультанта по аналитике данных.
Стоит отметить, что разработчики многих ETL-систем учитывают потребность аналитики больших данных с помощью своих продуктов и потому включают в их возможности работы с Apache Hadoop и Spark, как, например, Pentaho Business Analytics Platform .