

Создание сложных формул с вложенными условиями и математическими операциями в вычисляемых полях
Современные дашборды требуют не только агрегаций, но и гибких вычисляемых показателей, адаптирующихся под контекст пользователя, временной факт и сегменты аудитории. В рамках продвинутого курса по Yandex DataLens рассмотрим подходы к построению сложных формул с вложенными условиями и математическими операциями в вычисляемых полях, сфокусировав внимание на балансе между читаемостью, повторным использованием выражений и производительностью. Рассмотрим архитектурные принципы, паттерны проектирования формул, способы тестирования и внедрения в продуктивные дашборды с учётом ограничений платформы и инфраструктуры. Глава сочетает в себе product-подход к компонентам DataLens и методологические практики проектирования формул для команд аналитики и BI.
- Какие формы выражений поддерживает DataLens и как их структура влияет на поведение дашборда
- Вложенные условия, их читаемость и способы избежания ошибок
- Математические операции и функции: обработка нулевых значений, типизация и производительность
- Шаблоны сложных вычисляемых полей и практические сценарии внедрения
- Тестирование, верификация и интеграция вычисляемых полей в рабочие процессы
Краткое содержание главы
- Архитектура и проектирование вычисляемых полей в Yandex DataLens
- Вложенные условия: синтаксис, предпочтительные практики и читаемость
- Математические операции, функции и обработка нулевых значений
- Шаблоны сложных вычисляемых полей и референсные кейсы
- Интеграция, тестирование и управление качеством вычисляемых полей
- Производительность, мониторинг и устойчивость формул к изменениям данных
Архитектура и проектирование вычисляемых полей в Yandex DataLens
Вычисляемые поля в DataLens представляют собой единицы вычислений, которые могут ссылаться на исходные поля данных, а также на другие вычисляемые поля. Эффективная архитектура предполагает модульность, повторное использование выражений и минимальные зависимости, чтобы изменения в одном месте не приводили к каскадным перерасчётам в большом количестве дашбордов. В рамках гибкой архитектуры полезно разделять логику на несколько уровней: базовые арифметические вычисления, условная логика и бизнес-правила сегментации. Такой подход облегчает сопровождение и тестирование, а также упрощает перенос вычислений между дашбордами и проектами.
- Модульность: каждое вычисляемое поле следует рассматривать как самостоятельный модуль, который можно переиспользовать в разных местах. Это позволяет снизить дублирование логики и упростить обновления.
- Управление зависимостями: явное документирование зависимостей между полями улучшает понимание порядка вычислений и устраняет неопределённости при изменении исходных данных.
- Нейминг и стиль: единый стиль наименований (например, revenue_after_discount, customer_lre_score) облегчает поиск и повторное использование формул. Включение контекста в имя поля помогает понять роль выражения без просмотра кода.
- Разграничение вычислений между источником и DataLens: тяжёлые вычисления, зависящие от больших наборов данных, целесообразно выносить в базу данных или в представления SQL (views), чтобы использовать возможности оптимизации источника и снизить нагрузку на движок DataLens.
- Версионирование и тестирование: хранение описания формул в репозитории и поддержка версий позволяют отслеживать изменения, восстанавливать предшествующие состояния и проводить регрессионное тестирование.
Рассматривая архитектуру, важно помнить, что DataLens выполняет вычисления на этапе формирования визуализации. Это означает, что выражения должны быть не только корректными по синтаксису, но и достаточными по производительности для реалистичных наборов данных. В частности, сложные вложенные выражения и частые обращения к большим таблицам следует распознавать на стадии проектирования и по возможности опускать в базовый слой данных.
-- пример ориентировочного подхода к архитектуре:
1) **Вычисляемые поля уровня источника**: чистые поля и простые преобразования
2) **Вычисляемые поля уровня DataLens**: условная логика и сложные выражения
3) **Шаблоны и общие функции**: CASE WHEN, IF, COALESCE, арифметика
4) **Тестирование и документирование**: набор тестовых строк и комментарии
Подход к архитектуре требует баланса между читаемостью выражений и их мощностью. В продуктивной среде часто применяют два паттерна: отложенная агрегация (в базах данных) и динамическая логика на уровне DataLens. Первый паттерн позволяет вынести вычисления в слой, оптимизированный под SQL-подзаготовки и индексированные поля; второй - обеспечить гибкость в дашбордах, когда необходимо адаптировать логику под конкретные визуализации без переработки источника.
Вложенные условия: синтаксис, предпочтительные практики и читаемость
Вложенные условия - один из наиболее частых способов реализовать бизнес-правила в вычисляемых полях DataLens. В практической работе следует стремиться к балансу между компактностью выражения и его понятностью. При проектировании сложной ветвистой логики предпочтение обычно отдают формированию единых блоков условий с использованием CASE WHEN, а не глубокой цепочке вложенных IF. Это не только улучшает читабельность, но и упрощает отладку и тестирование.
- CASE WHEN против вложенных IF: CASE WHEN обеспечивает более явную структуру ветвления, лучшую читаемость и упрощает добавление новых условий без нарушения текущей логики.
- Порядок условий: следуйте принципу «самые строгие условия в начале» там, где это разумно применимо. Это минимизирует количество вычислений для большинства случаев.
- Обочинные ветви: используйте ELSE для обработки «переданного» значения или значения по умолчанию, чтобы не оставлять неопределённости в итогах.
- Типизация и приведение значений: чтобы избежать ошибок преобразования типов, приводите типы в явной форме, особенно в выражениях, где результат должен быть числом, датой или строкой.
- Обработка NULL: в реальных данных нередко встречаются пропуски. Используйте COALESCE или аналогичный механизм замены NULL на безопасное значение до применения математических операций.
Примеры формул:
- Вложенные IF (наглядный вариант):
IF(is_premium AND total_spent > 1000, 1,
   IF(total_spent > 500, 0.75, 0))
- CASE WHEN (рекомендованный для читаемости подход):
CASE
  WHEN is_premium AND total_spent > 1000 THEN 1
  WHEN total_spent > 500 THEN 0.75
  ELSE 0
END
- Пример с обработкой NULL и приведением типов:
IF(COALESCE(is_premium, false) AND COALESCE(total_spent, 0) > 1000, 1, 0)
Замечание: для сложных сценариев полезно переносить часть логики в отдельные вычисляемые поля, а итоговую комбинацию - в итоговом выражении. Так достигается ясность и повторное использование логики в нескольких дашбордах.
Математические операции, функции и обработка нулевых значений
Сложные вычисления в DataLens опираются на базовый набор арифметических операций и функций, который позволяет строить как простые, так и многоступенчатые формулы. Основные принципы:
- Базовая арифметика: сложение, вычитание, умножение и деление служат фундаментом для любых вычисляемых полей, на которых строятся более сложные метрики.
- Обработка нулевых значений: в реальных данных нулевые и пропущенные значения часто приводят к ошибкам вычисления. Рекомендовано использовать COALESCE (или эквивалент) для замены пропусков на безопасные значения.
- Округление и точность: для финансовых метрик применяется округление до нужной точности; это важно для стабильности графиков и отчетов.
- Функции для чисел и математики: ABS, MAX, MIN, SQRT, POW, LOG, EXP позволяют реализовать широкий спектр бизнес-правил и корректировок.
- Функции времени и даты: датовые функции позволяют строить периоды, скользящие окна и диапазоны, что особенно важно при сегментации по времени и динамическим порогам.
Примеры формул:
- Базовая маржа:
revenue = quantity * unit_price
margin = (revenue - cost) / NULLIF(revenue, 0)
- Распределение скидок с учётом дефолтного значения:
final_price = price * (1 - COALESCE(discount, 0))
- Категоризация по значение в диапазоне с CASE:
grade =
CASE
  WHEN score >= 90 THEN 'A'
  WHEN score >= 75 THEN 'B'
  WHEN score >= 60 THEN 'C'
  ELSE 'D'
END
- Работа с датами: динамическая агрегация по месяцам:
order_month = DATE_TRUNC('month', order_date)Важно помнить, что поддержка конкретных функций зависит от источника данных и версии движка DataLens. В практике целесообразно начать с набора функций, общих для большинства сценариев, и расширять его при необходимости на основе производительности и ограничений источника данных.
Шаблоны сложных вычисляемых полей и референсные кейсы
Ниже представлены типовые шаблоны, применимые к широкому спектру задач бизнес-аналитики. Они помогают ускорить внедрение, повысить читаемость и обеспечить повторное использование.
- Диапазоны и сегментация клиентов:
CASE
  WHEN engagement_score >= 90 THEN 'Top'
  WHEN engagement_score >= 70 THEN 'Mid'
  ELSE 'Low'
END
- Динамическая цена с учётом статуса клиента и промо:
final_price = price * (1 - COALESCE(discount, 0)) * CASE WHEN is_premium THEN 0.95 ELSE 1 END
- Расчёт валовой прибыли и маржи за период:
gross_profit = revenue - cost
profit_margin = gross_profit / NULLIF(revenue, 0)
- Кластеризация по времени и поведению:
cluster =
CASE
  WHEN last_purchase_date >= DATEADD('day', -7, CURRENT_DATE()) THEN 'Recent'
  WHEN last_purchase_date >= DATEADD('day', -30, CURRENT_DATE()) THEN 'Medium'
  ELSE 'Old'
END
- Комбинация нескольких полей для сегментации:
segment =
CASE
  WHEN (paid_orders > 5) AND (avg_order_value > 100) THEN 'High-potential'
  WHEN (paid_orders > 0) THEN 'Active'
  ELSE 'New'
END
Важно помнить, что сложные выражения лучше хранить в виде набора небольших, повторно используемых вычисляемых полей и затем сочетать их в более крупные конструкции. Это снижает риск ошибок и упрощает сопровождение.
Интеграции, тестирование и управление качеством вычисляемых полей
Переход формул в продуктивную среду требует системного подхода к тестированию и внедрению. Ключевые практики:
- Поэтапная проверка: сначала проверить корректность выражения на тестовом наборе данных, затем на дорожном наборе, и только после этого - в реальном дашборде.
- Наборы тестовых данных: создавать минимальные, но характерные случаи, включая крайние значения и пропуски, чтобы убедиться в устойчивости формул.
- Верификация производительности: анализ времени выполнения вычислений, особенно для полей, участвующих в крупных фильтрах или полноценных вычислениях. При необходимости перенос части логики в базовый слой данных.
- Документация и повторное использование: документировать назначение вычисляемого поля, источники входных данных и зависимости. Это облегчает поддержку и совместную работу.
- Контроль качества данных: вычисляемые поля должны корректно реагировать на изменения схемы данных, обновления источников и миграции. Регулярно выполняйте регрессионные тесты после изменений.
- Внедрение и ревью: включайте вычисляемые поля в ревью бизнес-логики, следуйте единой схеме именования и версионированию, чтобы управлять изменениями и откатами.
Инструменты тестирования в DataLens часто позволяют просматривать превью результатов по нескольким строкам, что ускоряет отладку. Кроме того, полезно поддерживать небольшие наборы тестовых кейсов, которые можно повторно запускать при каждом изменении выражения.
Производительность, мониторинг и устойчивость формул к изменениям данных
Производительность вычисляемых полей зависит от нескольких факторов:
- Уровень вычисления: вычисления, выполняемые на уровне источника данных, обычно быстрее и эффективнее по памяти, чем вычисления в движке DataLens. Стремитесь переносить тяжелые арифметические и логические операции в SQL-в views и материализовать данные, если это возможно.
- Размер набора данных: если формула применяется к огромным таблицам без предварительных фильтров, разумно снизить вычислительную нагрузку через предфильтрацию источника, использование денормализации или агрегаций.
- Читаемость и поддерживаемость: читаемость формул напрямую влияет на скорость внедрения и исправления ошибок. Разложение сложных выражений на несколько вычисляемых полей упрощает оптимизацию и тестирование.
- Кэширование и повторное использование: использование кэша результатов промежуточных вычислений, повторное использование общих полей, а также избежание дублирующих вычислений с экономит ресурсы.
- Мониторинг: ведение журнала изменений формул, а также аудит использования вычисляемых полей в дашбордах помогает выявлять узкие места и оптимизировать выражения.
Практические рекомендации по повышению производительности:
- Перенос тяжёлых вычислений в датасорс: при возможности используйте SQL-вью или материализованные представления на уровне источника.
- Сведение к минимальному числу операций: избегайте повторных вызовов одинаковых функций в нескольких местах; вынесите повторяющуюся логику в отдельное вычисляемое поле.
- Валидируйте типы и NULL заранее: приводите значения к устойчивым типам до выполнения вычислений, чтобы предотвратить исключения и неопределённости.
- Применяйте индексы и фильтры на входе: минимизируйте объём обрабатываемых данных за счёт раннего применения фильтров и агрегаций.
Key takeaways
- Эффективная архитектура вычисляемых полей строится на модульности, повторном использовании и грамотном управлении зависимостями.
- Для вложенных условий CASE WHEN предпочтительнее по читабельности и поддержке; избегайте чрезмерной глубины вложенности без необходимости.
- Почти всегда полезно обрабатывать NULL-значения с помощью COALESCE и явного приведения типов в выражениях.
- Шаблоны вычисляемых полей ускоряют внедрение и обеспечивают единообразие бизнес-логики: сегментация, динамические цены, маржа и т.д.
- Тестирование, документация и контроль версий формул необходимы для устойчивой эксплуатации в продуктивной среде.
- Производительность вычисляемых полей критически зависит от того, где реализованы вычисления: в источнике или в DataLens; оптимально выносить тяжёлые операции на уровень источника там, где это возможно.
- Внедрять вычисляемые поля следует в рамках процессов управления изменениями: предварительные тесты, оценка влияния на дашборды, ревью коллег и мониторинг.
FAQ
1) Какие рекомендации по выбору между CASE WHEN и вложенными IF?
- CASE WHEN обеспечивает более явную структуру ветвления и читаемость, особенно при большом числе условий. Вложенные IF могут быть уместны для краткой логики, но становятся сложными для поддержки по мере роста условий. В продвинутых сценариях предпочтительнее начать с CASE WHEN и переходить к вложенным IF только если синтаксис DataLens и требования к читаемости диктуют иначе.
2) Как правильно обрабатывать пропуски в формулах?
- Используйте COALESCE для замены NULL значений на безопасные альтернативы до выполнения арифметических операций. Это снижает риск ошибок преобразования типов и делает поведение формул предсказуемым.
3) Какие функции полезны для работы с числами и временем?
- Для чисел: ABS, MAX, MIN, SQRT, POW, LOG, EXP, ROUND. Для времени: DATE_TRUNC, YEAR/ MONTH/ DAY и аналогичные функции источника данных. В зависимости от источника данные функции могут отличаться, поэтому держите набор стандартных функций, совместимых с вашей средой.
4) Как повысить читаемость сложных выражений?
- Разделяйте логику на несколько вычисляемых полей, используйте CASE WHEN вместо глубокой вложенности, документируйте каждое поле и придерживайтесь стандартов именования. Такую логику легче тестировать и переиспользовать.
5) Как оптимизировать вычисляемые поля для больших наборов данных?
- По возможности переносите тяжёлые вычисления в источник (SQL-вью). Сведите к минимуму количество вычисляемых полей, избегайте повторяющихся выражений и минимизируйте обращения к данным без фильтров. Применяйте раннюю фильтрацию и агрегацию на уровне источника.
6) Какие практики рекомендуются для тестирования формул?
- Создайте набор тестовых данных, включающих крайние значения и пропуски. Прогоните выражение через тестовую выборку и сравните результаты с ожидаемыми. Верифицируйте поведение формулы на разных дашбордах, где она используется, чтобы обнаружить регрессии после изменений.
7) Как обеспечить повторное использование вычисляемых полей?
- Создавайте общие вычисляемые поля с конкретной бизнес-логикой (например, "base_revenue" и "discount_factor"), используйте их в более сложных формулах. Это упрощает поддержку и позволяет быстро адаптировать дашборды к новым требованиям.
8) Что делать, если формула сильно зависит от контекста?
- В таких случаях рекомендуется вынести контекст в отдельные вычисляемые поля (например, флаги сегментации, статусы клиентов) и затем сочетать их в основном выражении. Это уменьшает связанность формулы и упрощает изменение бизнес-правил.
9) Как учитывать изменения схемы данных в формулах?
- Поддерживайте документацию по зависимостям между полями и используйте версионирование формул. Регулярно проводите ревизии формул после изменений в источнике и в процессе интеграции с данными.
10) Какие практики помогут в командной работе над вычисляемыми полями?
- Создавайте единый стиль именования, стандартные шаблоны и наборы тестов. Устраивайте совместные ревью формул, документируйте логику и зависимости, используйте систему контроля версий для формул и связанных материалов. Это повышает доверие к данным и ускоряет внедрение новых метрик.
Глава охватывает конкурентный баланс между технологическими возможностями Yandex DataLens, практическими шаблонами и методологией внедрения вычисляемых полей. В процессе работы над дашбордами следует помнить, что вычисляемые поля - это мост между достоверностью данных и полезностью бизнес-решений. Правильная организация выражений, их тестирование и грамотное внедрение позволяют создавать динамические и устойчивые к изменениям метрики, которые действительно поддерживают принятие решений на основе данных.
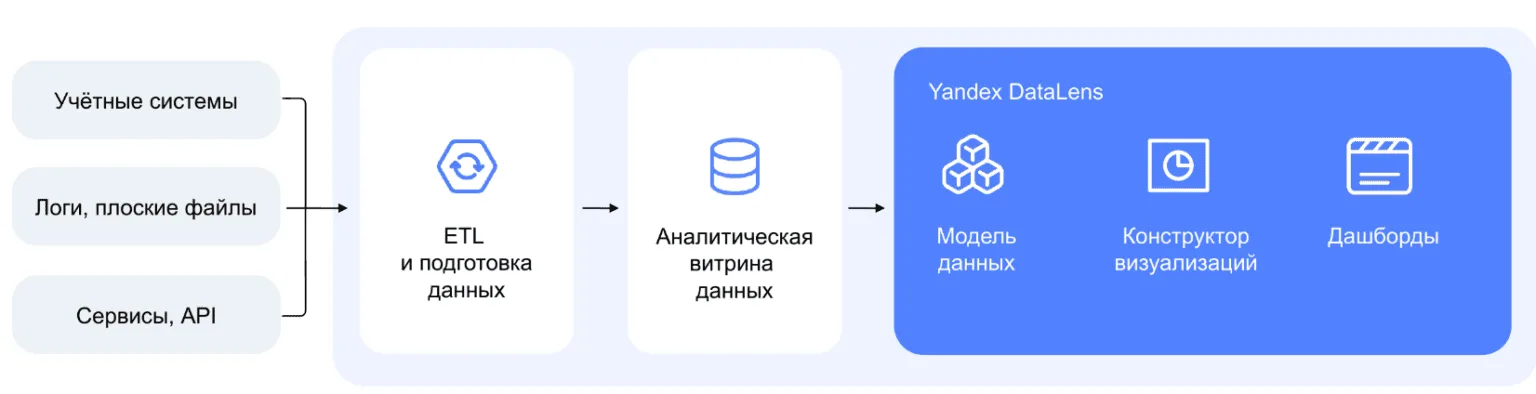
Если вы ищете инструмент для быстрой и эффективной аналитики без сложного внедрения и высоких затрат, обратите внимание на Yandex DataLens - современную платформу визуализации и анализа данных.
Сервис позволяет подключаться к различным источникам, строить дашборды и делиться аналитикой с командой — при этом он бесплатен, прост в освоении и подходит как для старта, так и для корпоративных решений. Благодаря экосистеме Yandex Cloud и возможности развертывания в закрытом контуре, DataLens становится универсальным инструментом для построения data-driven аналитики в компаниях любого масштаба.


