

Использование селекторов и сценариев обновления в отчетах
В рамках базового курса по Yandex DataLens тема селекторов и сценариев обновления относится к основам построения интерактивных отчетов: как пользователи выбирают данные, как эти выборы влияют на визуализацию, а также как грамотно организовать обновление данных и управление их свежестью в рамках бизнес-процессов. Глубокое понимание данных концепций позволяет повысить качество аналитической картины, обеспечить согласованность данных на уровне всей панели и минимизировать риск устаревших выводов.
Далее приведены ключевые принципы, методологические подходы и практические шаги внедрения, ориентированные на сбалансированное сочетание функций продукта и организационных практик. Особое внимание уделено тому, как селекторы усиливают взаимодействие пользователей с отчетами и как проектировать сценарии обновления так, чтобы поддерживать требуемый уровень точности и оперативности данных.
- Введение в концепции селекторов и сценариев обновления как элементы межфункциональной BI-архитектуры.
- Архитектура DataLens: как селекторы интегрируются в дашборды и какие слои отвечают за обработку запросов и обновления.
- Практические паттерны проектирования селекторов и их влияние на пользовательский опыт.
- Стратегии обновления данных: расписания, триггеры, зависимости и orchestration.
- Организационные аспекты: роли, процессы контроля качества и мониторинг обновлений.
Введение в концепцию селекторов и сценариев обновления
Селекторы в DataLens - это элементы управления, которые позволяют пользователю сузить набор данных, применить фильтры к нескольким источникам данных и привести к единой видимой картины все диаграммы на дашборде. Они поддерживают глобальные применения (на уровне всего дашборда) и локальные варианты, где фильтрация влияет только на конкретную карту или график. Принципиально важно обеспечить согласованную реакцию всех графиков на изменение значения селектора: пользователь ожидает, что выбор в одном месте сдвигает контекст во всех связанных визуализациях.
Обновления в отчётах реализуются через сценарии, которые определяют, как и когда данные из источников обновляются и становятся доступны для визуализации. В базовом виде сценарий обновления включает выбор источника данных, метод обновления (полное обновление против инкрементального), частоту выполнения и место хранения кэшированных результатов. Хорошо спроектированный сценарий обновления синхронизирует период обновления с ETL/ELT-процессами и обеспечивает согласованность данных между источниками и их отображением в дашбордах.
С точки зрения продукта, эффективная работа селекторов и сценариев обновления требует ясной архитектуры: где хранится определение селектора, как он маппится к данным, какие зависимости между фильтрами и визуализациями существуют, и как обновления проходят через конвейер данных. Важна прозрачная политика по умолчанию: какие селекторы загружаются сразу, какие - подгружаются по мере взаимодействия пользователя, какие значения считаются дефолтными и какие не должны влиять на критичные KPI без явного подтверждения.
С точки зрения процессов, ключевые практики включают управление изменениями в настройках фильтров, регламент тестирования новых сценариев обновления, а также мониторинг реакции пользователей на новые или изменённые селекторы. В этом контексте DataLens выступает как инструмент, который поддерживает не только техническую реализацию, но и управляемый процесс использования аналитических возможностей.
Архитектура и компоненты DataLens, связанные с селекторами
Архитектура DataLens строится вокруг взаимосвязанных компонентов: дашборды, карты (визуализации), источники данных и управляющие элементы, включая селекторы. Селекторы обычно представляют собой отдельный управляемый узел, который связывает параметры запроса пользователя с параметрами визуализации. На уровне архитектуры важно выделить три слоя:
- Уровень выражения контекста: здесь определяется, какие поля данных могут быть использованы в качестве фильтров и как они агрегируются в рамках конкретного дашборда. Регистрация и типизация полей обеспечивают корректную маршрутизацию фильтров к соответствующим источникам.
- Уровень запроса: механизм формирования запроса к источнику данных с учетом активных фильтров. В этом слое реализуется логика объединения условий фильтрации, поддержка каскадных зависимостей (cascade filters), а также оптимизации за счет кэширования и предварительной фильтрации.
- Уровень отображения: визуализации и их синхронность. После выполнения запросов ответ от сервера прокатывается через слой визуализации, где применяется общий контекст фильтров, чтобы все карты отражали единый выбор пользователя.
Эти слои работают в связке для обеспечения последовательности действий: пользователь меняет значение селектора → система формирует новый набор параметров запроса → данные запрашиваются у источников → результаты отображаются во всех соответствующих элементах дашборда. В идеале этот цикл должен занимать минимальное время и не приводить к рассогласованию между различными элементами панели.
Ключевой принцип здесь - единый контекст фильтров. Он помогает избежать ситуаций, когда разные визуализации показывают рассогласованную информацию при одном и том же выборе пользователя. В DataLens это достигается за счет механизма глобальных селекторов и корректной маршрутизации фильтров через слои запросов. Важным является также вопрос кэширования: кэшированные ответы следует обновлять синхронно с изменениями, чтобы не возникало ложных иллюзий о «быстроте», когда данные устаревают. Этим достигается баланс между производительностью и точностью.
Интеграционные точки включают REST API для управления конфигурациями дашбордов и событий обновления, а также интеграцию с оркестраторами данных. Практическая настройка может опираться на интеграцию с открытыми инструментами, например Apache Airflow, для планирования и мониторинга процессов обновления. В рамках продукта такие интеграции позволяют автоматизировать рутинные задачи по обновлению, уведомлять ответственных лиц о сбоях и обеспечивать непрерывность аналитического цикла.
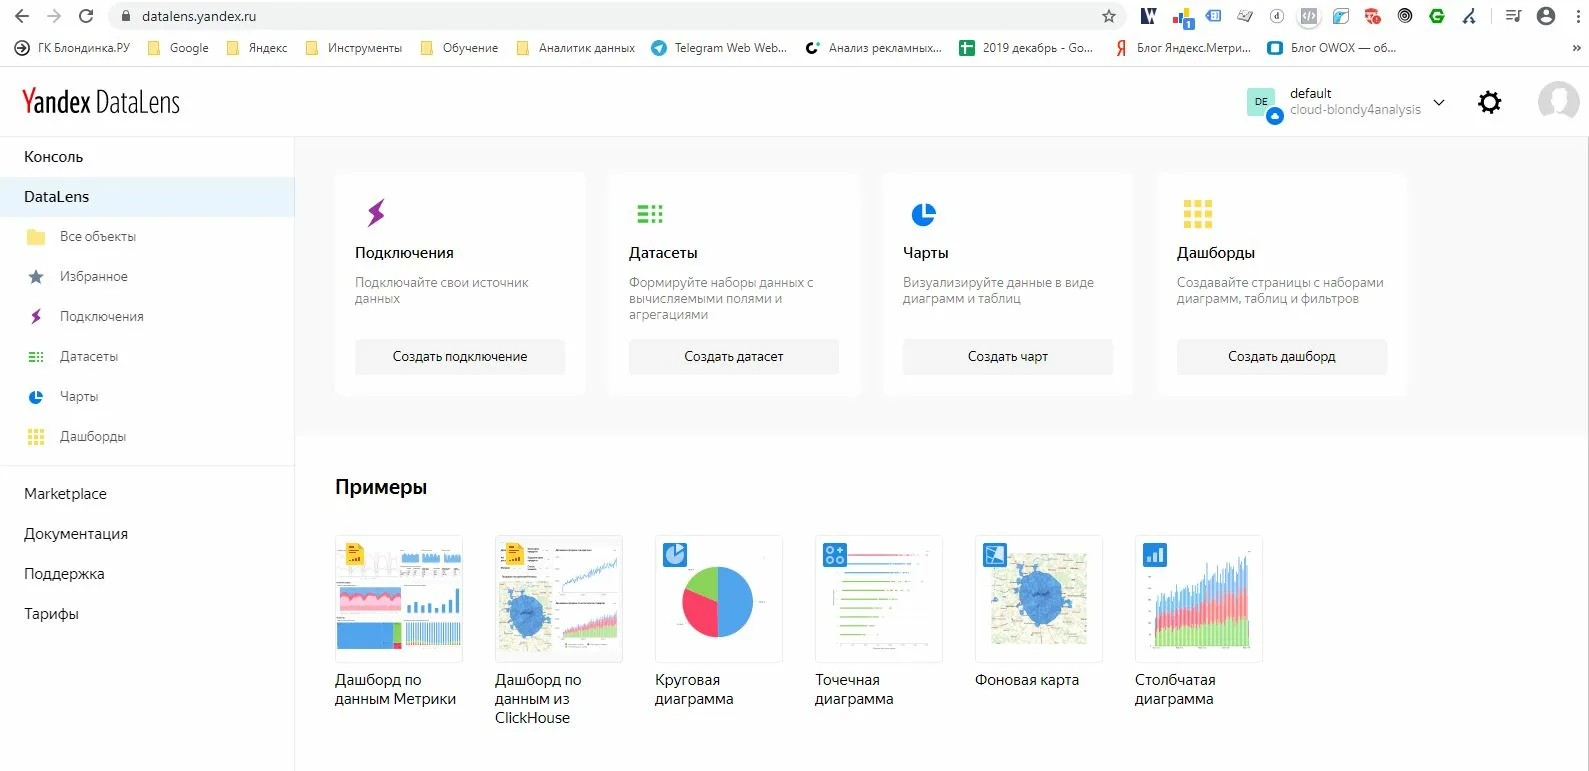
Селекторы в DataLens: типы, поведение, настройка
Типы селекторов в типичном DataLens-досье охватывают диапазон фильтрации по полям данных, выбору значений и временным рамкам. Важной характеристикой является способность настроить каскадность между селекторами: выбор в одном элементе может сузить доступные значения в другом. Это позволяет строить понятные и предсказуемые пользовательские сценарии анализа.
Настройка начинается с определения полей данных, которые наиболее часто востребованы как фильтры, а затем связывается их с конкретными визуализациями. Роль дизайнера состоит в том, чтобы обеспечить интуитивную логику фильтрации: какие поля лучше делать глобальными, какие - локальными, как обеспечить совместную работу нескольких селекторов без конфликтов. При этом следует соблюдать принципы минимализма и ясности: избыток селекторов усложняет интерфейс и снижает эффективность анализа.
Ключевые особенности настройки включают:
- Определение дефолтных значений и состояния фильтров при открытии дашборда. Это позволяет пользователю быстро получить валидную картину, не тратя время на настройку.
- Управление зависимостями между селекторами, чтобы избегать недопонимания пользователя и конфликтов в выборках. Например, календарный выбор может ограничивать доступные регионы, если данные по регионам недоступны в конкретном временном промежутке.
- Поддержка пользовательских представлений и контекстов. Можно создавать предвариантные наборы фильтров для разных сценариев использования: операционный мониторинг, стратегический анализ и т.д.
- Адаптивность и доступность: обеспечение корректной работы на разных устройствах, поддержка клавиатурной навигации и ясной визуальной индикации активных фильтров.
Практическое внедрение следует начинать с малого набора селекторов, проверяя их влияние на несколько визуализаций, затем наращивать их количество и сложность. Важно обеспечить тестовую среду, в которой можно воспроизводить поведение фильтров на разных сценариях, чтобы минимизировать риск негативного влияния на пользовательский опыт при последующих изменениях.
В качестве ориентиров по аналогиям стоит рассмотреть общие принципы управления фильтрами в открытых инструментах бизнес-аналитики, таких как Metabase или аналогичные платформы. Однако в DataLens фокус следует держать на тесной интеграции селекторов с конкретной бизнес-логикой и источниками данных вашей организации. В рамках методологического подхода можно рассматривать селекторы не только как средство фильтрации, но и как инструмент управления пользовательскими сценариями анализа, при этом обеспечивая прозрачность и контроль версий конфигураций.
Сценарии обновления в отчетах: источники данных, расписания, триггеры
Обновления данных в отчетах должны происходить с учетом циклов обработки данных в организации и требований к актуальности визуализации. В базовом виде сценарий обновления описывает, какие источники данных участвуют, как часто данные обновляются и какие триггеры запускают обновление. Важное требование - питание обновлений от «окна ETL/ELT», чтобы новые данные становились доступны без конфликтов и задержек.
Типичные источники данных для DataLens включают базы данных, хранилища данных и файлы, которые обновляются через ETL-процессы. Архитектурно важно обеспечить согласование времени обновления между источниками, особенно если дашборд агрегирует данные из нескольких систем. Это требует согласованных временных зон, версий схем и форматов данных, чтобы результаты визуализации оставались целостными.
Расписания обновлений зависят от частоты изменений бизнес-данных и требований к точности. В некоторых случаях достаточны дневные обновления, в других - реже или чаще. Нередко применяются стратеги инкрементального обновления: обновляется только та часть данных, которая изменилась после последнего обновления. Это снижает нагрузку на источники и ускоряет обновление визуализации.
Триггеры обновления могут быть:
- запланированными (ежедневно в оконном времени), что обеспечивает предсказуемость и синхронность с другими процессами;
- событийно-ориентированными (on-change), когда изменение в источнике данных инициирует обновление;
- гибридными, когда обновление сначала запускается по расписанию, а затем корректируется по событиям для критически важных наборов данных.
Организация процессов обновления требует документированных процедур: кто отвечает за настройку триггеров, как тестируются новые схемы обновления, какие метрики используются для мониторинга и как реагировать на сбои. В практике это включает чёткую коммуникацию с командами данных и бизнес-пользователями, чтобы своевременно информировать о задержках и изменениях в доступности данных.
Интеграции с внешними оркестраторами данных позволяют централизованно управлять обновлениями в нескольких системах. Например, внедрение orchestration с использованием Apache Airflow дает возможность планировать задачи, отслеживать статусы, управлять зависимостями и автоматически пересобирать дашборды DataLens после успешного выполнения ETL-работ. Это снижает риск рассинхронности между обновлениями и позволяет устанавливать политики повторной попытки и уведомления, что особенно важно в средах с высоким уровнем операционных рисков.
Практические паттерны внедрения в организации
Эффективная реализация селекторов и сценариев обновления в организационном контексте требует сочетания продуктовых возможностей и управленческих практик. Основные паттерны включают:
- Определение ролей и ответственных: выделение команд по BI, данных и эксплуатации. Роли должны охватывать конфигурацию дашбордов, настройку фильтров, управление расписаниями обновлений и мониторинг качества данных.
- Управление изменениями: внедрение формального процесса ревью изменений в конфигурациях селекторов и обновлениях. Это включает версионирование конфигураций, тестирование в тестовой среде и планирование перехода в продакшн.
- Контроль качества: внедрение проверок целостности данных, валидации фильтров и тестирования на предмет логических конфликтов между селекторами и визуализациями. Включение тестовых кейсов по сценариям обновления помогает выявлять проблемы до их попадания в продакшн.
- Мониторинг и алертинг: настройка дашбордов мониторинга статуса обновлений, времени отклика запросов и ошибок в кэшировании. Алерты должны быть понятны и направлять к конкретным ответственным.
- Обеспечение доступности и безопасности: разграничение прав на изменение селекторов, конфигураций и расписаний. Важна концепция минимальных прав доступа и аудита изменений, особенно в средах с большим количеством пользователей.
- Эволюция интерфейса: постепенное расширение набора селекторных возможностей, формирование библиотек стандартных фильтров и предикатов для разных доменов бизнеса. Это ускоряет обучение пользователей и повышает консистентность анализа.
Практически целесообразно внедрять концепцию "первоначальных сценариев" на пилотном дашборде с небольшим набором селекторов и простыми правилами обновления. По мере роста зрелости можно расширять набор фильтров, укреплять правила тестирования и внедрять более сложные механизмы мониторинга. Важной частью является документирование: как именно устроены выборы по селектору, какие данные могут быть затронуты, какие сценарии обновления применяются и как осуществляется контроль доступа.
Реализация и интеграции: практические шаги и минимальные рекомендации
-
Определить бизнес-кейсы для селекторов и сценариев обновления: какие вопросы аналитики решаются чаще всего, какие данные требуют наивысшей актуальности. Это поможет выбрать приоритетные поля для фильтрации и определить частоту обновления.
-
Спроектировать архитектуру дашборда: определить глобальные и локальные селекторы, их связи с визуализациями и последовательность загрузки данных. Включить в архитектуру слои запроса и отображения, чтобы обеспечить предсказуемую реакцию на изменение контекста.
-
Настроить процессы обновления: определить источники данных, окна обновления и виды триггеров. Согласовать расписания с ETL/ELT-компонентами и обеспечить корректную работу кэширования. Включить механизм повторных попыток и уведомления в случае ошибок.
-
Внедрить оркестрацию и мониторинг: подключить DataLens к оркестратору (например, Apache Airflow) для централизованного управления обновлениями. Разработать дашборды мониторинга, которые показывают статус обновлений, задержки и очаги возможных проблем.
-
Обеспечить контроль доступа и аудит: настроить роли пользователей и разграничение полномочий на изменение конфигураций и расписаний. Включить журнал изменений и процедуры релизов.
-
Обучение пользователей и поддержка: создать руководства по использованию селекторов, объяснить принципы каскадности фильтров, обеспечить доступ к обучающим материалам и примерам сценариев обновления. Регулярный сбор обратной связи поможет корректировать интерфейс и процесс обновления.
-
Оценка эффективности: определить KPI для селекторов и обновления (скорость загрузки, точность и своевременность обновлений, удовлетворенность пользователей). Использовать эти метрики для непрерывного улучшения.
В контексте инструментов можно привести ограниченное число примеров интеграций. Так, к DataLens напрямую относится возможность работы через REST API для управления дашбордами и их настройками. В качестве внешних механизмов поддержки обновлений можно упомянуть Apache Airflow как пример оркестрации и управления зависимостями между задачами. Эти примеры показывают, как можно сочетать внутренние возможности DataLens с внешними практиками эксплуатации для достижения высокой оперативности и надежности аналитического процесса.
Key takeaways
- Селекторы являются ключевым инструментом управления контекстом анализа в DataLens и должны работать в едином контексте с визуализациями.
- Архитектурно важно разделять слои контекста фильтров, формирование запросов и отображение, чтобы обеспечить предсказуемую реакцию на изменение условий.
- Эффективное проектирование селекторов требует баланса между функциональностью и простотой интерфейса, а также продуманной каскадной логикой фильтров.
- Сценарии обновления должны синхронизироваться с ETL/ELT-процессами и поддерживать инкрементальные подходы там, где это возможно.
- Оркестрация обновлений и мониторинг статуса являются критическими элементами для обеспечения свежести и надежности данных.
- Организационные практики: роли, процессы управления изменениями и контроль качества - необходимый контекст для устойчивой эксплуатации DataLens.
- Интеграции с внешними инструментами, такими как Apache Airflow и REST API DataLens, повышают управляемость и масштабируемость решений.
FAQ
1) Что такое глобальные и локальные селекторы в DataLens, и зачем они нужны?
Глобальные селекторы применяются ко всему дашборду и влияют на все визуализации в рамках панели, тогда как локальные селекторы ограничиваются конкретной картой или элементом. Глобальные селекторы обеспечивают единый контекст анализа для пользователя, а локальные позволяют настраивать специфические сценарии анализа для отдельных визуализаций. Правильное распределение ролей между глобальными и локальными селекторами упрощает интерфейс и повышает согласованность данных.
2) Какие типичные проблемы возникают при работе с селекторами и как их избежать?
Наиболее распространенные проблемы - несогласованность фильтров между картами, дублирование запросов и задержки из-за большого числа селекторов. Чтобы избежать этого, следует проектировать каскадность фильтров, ограничивать число активных селекторов на одном дашборде, и использовать единый контекст фильтров с предсказуемым порядком обработки запросов. Также важно тестировать сценарии на разных наборах данных и временных окнах.
3) Как выбрать частоту обновления данных в сценариях?
Выбор зависит от требований к точности и скорости реакции на изменения бизнес-данных. Для оперативного анализа чаще применяют более частые обновления или событие-ориентированные триггеры, тогда как для стратегических обзоров достаточно дневных или недельных окон. Важно синхронизировать обновления с ETL/ELT-процессами, чтобы избежать рассинхронности между источниками.
4) Как организовать интеграцию DataLens с внешними оркестраторами?
Важно определить точки входа: какие задачи нужно запускать через оркестратор, как обрабатывать зависимости между ними и как настроить уведомления. После этого следует настроить API-интерфейсы для управления дашбордами и обновлениями, а также обеспечить обратную связь между этапами конвейера и пользователями. Apache Airflow часто используется как надстройка над DataLens для централизованного планирования и мониторинга.
5) Какие практики best practice применимы к управлению изменениями в селекторах?
Рекомендуется иметь процесс ревью изменений в конфигурациях селекторов, тестировать новые сценарии в тестовой среде и использовать версионирование. Внесение изменений должно сопровождаться документацией по новым функциональным возможностям, а также регламентами по разворачиваемым средам (dev/stage/prod).
6) Какие показатели эффективности применимы к селекторам и обновлениям?
Ключевые метрики включают время отклика на изменение контекста, долю успешных обновлений, задержку между обновлением источника и доступностью визуализации, а также пользовательскую удовлетворенность. Регулярная проверка этих метрик позволяет выявлять узкие места и планировать улучшения.
7) Какие ограничения стоит учитывать при работе с DataLens в корпоративной среде?
Важно учитывать ограничения по доступу к данным, правила аудита и требования к безопасности. Следует ограничивать возможность изменения критических сценариев обновления и конфигураций селекторов только для нужных ролей, обеспечивая журнал изменений и возможность отката.
8) Какие примеры типовых сценариев обновления можно реализовать «из коробки»?
Типичным сценарием является дневной пакет обновления, обслуживаемый ETL-процессами, с инкрементальным обновлением для актуальных данных и сонной стратегией кэширования. Другой сценарий - обновление по событию, когда конкретное изменение в источнике инициирует обновление дашборда. В обоих случаях должно быть предусмотрено тестирование и мониторинг.
9) Что учитывать при миграции существующих дашбордов на новую архитектуру селекторов?
Необходимо проанализировать текущее состояние фильтров, понять, какие селекторы можно сделать глобальными, и как переразметить зависимости между визуализациями. Важным является сохранение консистентности данных и минимизация пользовательских изменений в процессе миграции. Рекомендовано проводить миграцию поэтапно, в тестовой среде сначала, затем в продакшн.
10) Как обеспечить устойчивость к сбоям в обновлении данных?
Необходимо предусмотреть резервные источники данных, альтернативные конфигурации фильтров и план отката к последнему рабочему набору данных. Контроль над состоянием обновления, уведомления о сбоях и возможность ручного вмешательства позволяют минимизировать влияние на аналитические выводы и бизнес-процессы.
Если вы ищете инструмент для быстрой и эффективной аналитики без сложного внедрения и высоких затрат, обратите внимание на Yandex DataLens - современную платформу визуализации и анализа данных.
Сервис позволяет подключаться к различным источникам, строить дашборды и делиться аналитикой с командой — при этом он бесплатен, прост в освоении и подходит как для старта, так и для корпоративных решений. Благодаря экосистеме Yandex Cloud и возможности развертывания в закрытом контуре, DataLens становится универсальным инструментом для построения data-driven аналитики в компаниях любого масштаба.


