

Устраняем «ад зависимостей» с помощью dbt
В Tiqets мы поддерживаем ряд производных представлений в нашем хранилище данных. Вместо того, чтобы всегда возвращаться к необработанным данным, стараясь найти ответ на вопрос, мы моделируем данные, чтобы они представляли более «высокоуровневые» абстракции, полезные для бизнеса. Например, получаем:
- активные клиенты из заказов
- распределение затрат на рекламу из заказов и отчетов Google Рекламы.
- последовательности конверсии из просмотров страниц и множества целей.
Эти представления очень полезны для предотвращения повторяющейся работы, и кроме того, они подходят также для улучшения понимания бизнеса. Однако управлять ими весьма непросто.
Мы активно использовали постоянные производные таблицы Looker (PDT), чтобы смоделировать около 80 представлений. Они создавались по расписанию, управляемому в Looker. Основная проблема заключается в том, что у нас не было возможности отслеживать зависимости между этими представлениями. Например, мы хотим убедиться, что последние данные о заказах поступили на склад, прежде чем обновлять представление активных клиентов. Все становится еще сложнее, когда PDT зависят от других PDT.
Чтобы убедиться, что все обновилось, мы создали сложное расписание, в котором учтены зависимости и время, необходимое для создания каждого PDT. В основном это срабатывало, но не всегда получалось. Прием данных может быть отложен, запросы могут занять больше времени, чем обычно, или мы можем увидеть сбои из-за изменений схемы. Это потребовало бы, чтобы кто-то вручную устранял этот «ад зависимостей» и обновлял PDT.
В этом посте мы расскажем, как используем dbt, чтобы упростить управление представлениями и укрепить доверие к данным, которые мы храним в нашем хранилище данных. Наше решение включает Gitlab CI для автоматизированных тестов и доставки и Apache Airflow для планирования, чтобы поддерживать их в актуальном состоянии.
Что такое dbt?
Исторически хранилища данных были медленными и дорогими системами с ограниченными ресурсами. Это привело к разработке шаблона ETL (извлечение, преобразование, нагрузка): процесс создания новых объектов базы данных путем извлечения данных из исходной базы данных, их преобразования на отдельном сервере и загрузки преобразованных данных в хранилище. Современные хранилища данных снизили стоимость хранения данных, увеличив при этом доступную вычислительную мощность и память. Это привело к появлению шаблона ELT (извлечение, загрузка, преобразование), при котором извлеченные необработанные данные сначала загружаются, а затем преобразуются в хранилище данных.
Инструмент Data Build Tool, dbt, становится де-факто стандартом для выполнения преобразований в современных хранилищах данных (и других механизмах SQL). С помощью dbt описываются преобразования существующих данных в новые представления, называемые моделями, с помощью написания SQL-запросов. Эти запросы построены по шаблону с помощью Jinja, что добавляет им некоторую гибкость. Шаблонный запрос выглядит так:
Скриншот: https://github.com/fishtown-analytics/jaffle_shop/blob/master/models/sta...
Директива ref в строке 7 – одна из самых мощных функций dbt. Создавая шаблоны ссылок на другие модели, она отслеживает зависимости. В результате она может строить модели в правильном порядке и даже выполнять запросы параллельно, когда это возможно.
Разработка с dbt
Для разработки мы используем типичный поток для разработки программного обеспечения с конвейером непрерывной интеграции (CI). Код хранится в git-репозитории. Изменения вносятся путем создания ветвей функций. Каждый раз, когда вносится изменение, автоматизированный конвейер CI запускает анализ и тесты (подробнее об этом позже). Затем код просматривает другой Tiqeteer. Если все проходит успешно, ветвь объединяется, что запускает автоматическое развертывание. Наконец, после развертывания конвейер генерирует документацию. Эта логика есть в конвейере Gitlab CI (аналогично людям из группы данных Gitlab).
Автоматизированные тесты позволяют нам уверенно вносить изменения. Это возможно благодаря двум функциям dbt:
- Тесты: предоставляют простой способ запуска утверждений в данных (например, является ли этот столбец уникальным?). Есть несколько встроенных тестов, но вы также можете протестировать все, что можете выразить с помощью SQL-запроса.
- Пользовательские схемы: это позволяет нам создавать модели с обновленным кодом без изменения моделей в нашей производственной среде.
Мы объединяем эти две функции, чтобы автоматически создавать модели в настраиваемой схеме и запускать для них тесты для каждой ветви функций.
В конвейере есть следующие этапы:
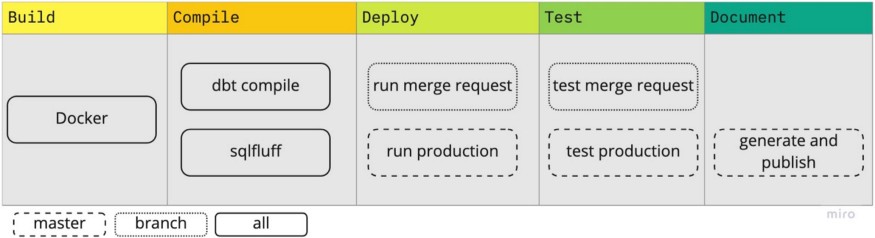
- Создание образа докера с помощью dbt и нашего проекта.
- Компиляция проекта dbt, чтобы отловить простые ошибки, далее проверка с помощью sqlfluff на предмет того, соответствуют ли запросы нашим стандартам.
- Разворачивание более 200 моделей с помощью dbt run.
- Тестирование модели с помощью dbt test, в настоящее время у нас есть более 1000 тестов в мастере.
- Документирование проекта с помощью dbt docs generate, мы обслуживаем результаты с помощью Gitlab Pages.
Интересные моменты есть на шаге 3 и шаге 4. Способ их работы зависит от того, предназначен ли конвейер для запроса на слияние или для основной ветви. Начнем с более простого случая: главные конвейеры. По сути, мы просто выполняем dbt run , ориентируясь на схему разработки. Если разработка выполнена успешно, мы сохраняем результаты (целевая папка target ) в корзину S3, которая будет использоваться при выполнении запросов на слияние.
Для запросов на слияние мы создаем схему на основе имени ветки. Например, ветка с именем feature/add_awesome_model создаст на нашем складе схему с именем dbt_feature_add_awesome_model . Поскольку создание каждой модели с нуля занимает много времени, мы строим только те модели, которые были созданы или изменены в ветке. Это возможно с функцией «тонкого CI», вот как это работает. Флаг --state ожидает результатов от предыдущего запуска базы данных (которые мы сохранили на S3 в нашем главном конвейере). На основе этого состояния dbt run может идентифицировать и строить только новые и измененные модели.
Интересная проблема возникает, когда одна из этих новых или измененных моделей зависит от немодифицированной модели и, следовательно, не создается конвейером запросов на слияние. Используя флаг --defer , вы можете указать dbt использовать последнюю производственную версию этой модели. Таким образом мы можем значительно сократить время, необходимое для запуска конвейера.
Тем не менее, некоторые модели очень дорого строить с нуля, просто в них слишком много рядов. В этом случае мы используем простой шаблон Jinja, который проверяет текущую цель. Если это не производство, мы ограничиваем количество строк с помощью специального условия where .
Наконец, тестирование после развертывания может быть обратным с точки зрения разработки программного обеспечения. Но dbt тесты – это утверждения на сгенерированных моделях, которые мы можем запускать только после того, как они будут построены. Часто мы обнаруживаем «ошибки» разработки в функциональных ветках, прежде чем объединить их. Сбои в главном конвейере редко случаются при первом слиянии функции. Однако они очень полезны при запланированных запусках, так как указывают на то, что что-то в исходных данных изменилось. Мы обсудим планирование в следующем разделе.
Планирование обновлений и тестов
Слияние ветки с master обновляет модели при обновлении кода. Нам необходимо решение, чтобы поддерживать модели в актуальном состоянии, когда новые данные попадают в хранилище. В Tiqets мы используем Apache Airflow для планирования наших конвейеров данных, поэтому мы реализовали DAG, который запускает наш CI Gitlab конвейер после загрузки данных из нашей производственной базы данных. Это выглядит так:

- wait_dwh_sync – датчик, который блокирует процесс до завершения экспорта из производственной базы данных
- start_pipeline вызывает API Gitlab для запуска конвейера CI, обновления моделей и запуска тестов.
- wait_pipeline – датчик, который проверяет статус и генерирует оповещение Slack в случае ошибок
- drop_feature_schemas – вспомогательная задача, которая отбрасывает все схемы, созданные для запуска конвейера CI для ветвей функций в Gitlab, обсуждаемых в предыдущем разделе.
Однако вскоре мы поняли, что хотим обновить модели, которые зависят от разных источников данных. В настоящее время мы реализовали два других варианта использования, которые мы называем «Распределение затрат на рекламу» и «Машина времени» (запланировано еще несколько). Процесс распределения затрат на рекламу зависит от отчетов Google Рекламы, Google Analytics и Bing Ads. Он преобразует данные в общий формат и распределяет затраты по заказам в соответствии с рядом бизнес-правил. Конвейер Time Machine – это модель, содержащая ежедневные снимки важных таблиц из производственной базы данных. Она позволяет нам путешествовать во времени и извлекать содержимое таблиц. Например, наличие продуктов в Рейксмузеуме на 2020–07–03 гг.
Эти модели имеют разные источники данных и потенциально могут выполняться с разной частотой. Для поддержки этих моделей мы реализовали настраиваемые хуки и операторы на основе проекта airflow-dbt. Нашим основным изменением была интеграция с Gitlab для получения проекта dbt. Перед любым выполнением мы клонируем новую копию репозитория. Таким образом, нам не нужно беспокоиться о том, как отправлять модели dbt в Airflow, мы выполняем все, что находится на главном сервере. Мы аутентифицируемся с помощью токена API, хранящегося в базе метаданных Airflow.
Эта настройка довольно проста и понятна, однако у нас есть некоторые болевые точки. Прежде чем описывать их, давайте сначала обсудим некоторые другие варианты использования dbt на Tiqets.
Другие варианты использования
Помимо запуска трех описанных выше конвейеров данных, у нас есть еще несколько вариантов использования.
Управление пользовательскими функциями (UDF): добавление UDF в наш репозиторий dbt дает нам возможность управлять версиями кода. UDF также являются частью нашего конвейера CI, то есть они присоединяются к настраиваемой схеме базы данных, что позволяет нам попробовать что-то новое, не затрагивая производственные данные. Бонусные баллы, если вы используете сиды для создания приложений и тестируете свои UDF перед отправкой!
Датчики свежести данных: проверьте, попали ли в таблицу свежие данные. Запуск процесса распределения затрат на рекламу до того, как все отчеты попадут на склад, стало большим источником путаницы. Поскольку некоторые отчеты предоставляются третьей стороной, мы не видим, когда задача реально была выполнена. Однако мы можем использовать актуальность, чтобы проверить, когда были получены данные за текущий день, а затем запустить процесс распределения.
Тесты целостности данных: не все данные в нашем хранилище находятся под контролем dbt (пока?). Тем не менее, мы все еще можем использовать dbt, чтобы делать утверждения на их базе. Например, у нас есть тесты, которые проверяют, имеют ли наши последние запуски парсера ожидаемый результат или мы обнаруживаем недопустимые данные в наших данных потока посещений.
Обнаружение аномалий: еще одно использование тестов – проверить, наблюдаем ли мы большие изменения в наших наборах данных. Все, что может быть выражено в SQL, может быть тестом, поэтому мы отслеживаем изменения в нашем канале сбора данных, вызывая сообщение Slack, если мы обнаруживаем большие изменения. Бонусные баллы, если вы отправите сообщение @stakeholder вместо @ data-team.
Моментальные снимки: мечта каждого инженера по обработке данных – неизменяемые данные, позволяющие реконструировать любое состояние путем повторного выполнения задач. К сожалению, в реальном мире данные часто меняются на месте. Снимки отслеживают изменения в любых моделях, создавая новую строку для каждого обновления. Это позволяет нам отслеживать обновления в наших отчетах Google Analytics.
Хотя мы очень довольны автоматическим управлением зависимостями, предоставляемым dbt, у нас есть несколько болевых точек.
Во-первых, отладить неудавшиеся тесты непросто. Запросы о неудачных тестах сохраняются в журналах, но после того, как они у вас появятся, все равно будет сложно найти строки с нарушением. Например, запрос на проверку уникальности в столбце возвращает количество повторяющихся строк. Вам нужно будет переписать запрос, чтобы понять, что происходит. Это известная проблема.
Вторая болевая точка – это не ограничение dbt, а ошибочное предположение с нашей стороны. Мы начали с того момента, когда модели dbt должны обновляться после того, как мы синхронизируем данные из нашей производственной базы данных с нашим хранилищем. Хотя верно и то, что большинство наших моделей основано на этих данных, у нас есть множество источников данных: CRM, инструменты электронной почты SaaS, системы продажи билетов и т. д. Разделение их на разные DAG группы дало нам некоторую гибкость, но теперь мы должны побеспокоиться о проблемах параллелизма: обновляют ли эти группы DAG одни и те же модели или UDF? Нам нужно будет разработать более гибкий способ организации и обновления моделей. Таким образом, наши модели всегда будут максимально свежими.
Третья проблема связана с запуском нашего конвейера CI для запросов функций. Некоторые модели очень дороги в сборке и требуют большого количества ресурсов нашего кластера Redshift. Поэтому, хотя мы можем теоретически протестировать все модели, не меняя того, что находится в производстве, у нас все еще могут быть проблемы с производительностью и появятся сердитые пользователи Looker, когда некоторые модели не будут работать как следует. В одном случае запуск модели в CI привел к тому, что у нас закончился диск
Помимо решения этих проблем, мы работаем над упрощением потока за счет того, что все «производственные» запуски dbt выполняются в Airflow. Это должно в основном решить проблему №2, позволяя нам использовать обновления источника данных для запуска dbt. К тому же оно круто смотрится.


