

Airflow vs. Prefect vs. Kestra — какой инструмент больше всего подходит для создания высокотехнологичного конвейера данных
Удаленный REST API + S3 + Удаленная БД Postgres = подробное сравнение Airflow, Prefect и Kestra.
Apache Airflow далеко не единственная платформа для создания, выполнения, отслеживания и управления операциями по обработке данных. Существует множество достойных бесплатных альтернатив, таких как Prefect и Kestra. Давайте поговорим о них подробнее.
Сегодня мы создадим конвейер, использующий более продвинутые функции. Если быть точным, наш конвейер будет загружать JSON-файл из удаленного API, выгружать его в бакет AWS S3, добавлять новый столбец и загружать его в базу данных Postgres.
Нам предстоит проделать серьезную работу, поэтому не будем терять ни минуты.
Конфигурация AWS для S3 и БД Postgres
Перед тем, как приступить к созданию конвейера, необходимо выполнить некоторые действия по настройке. Предполагается, что у Вас уже есть учетная запись AWS (можно воспользоваться бесплатной версией).
Войдите в консоль и создайте новый бакет S3. Вы можете использовать существующий, это неважно. Просто обратите внимание на имя бакета. Например, наш называется demos3bucket-dr:
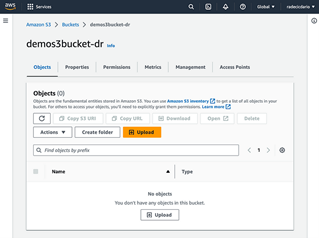
Каждой платформе по обработке данных понадобится способ доступа к этому бакету, и одного только названия в данном случае будет недостаточно.
Войдите в консоль AWS IAM, перейдите на вкладку Учетные данные безопасности и выберите Создать ключ доступа:
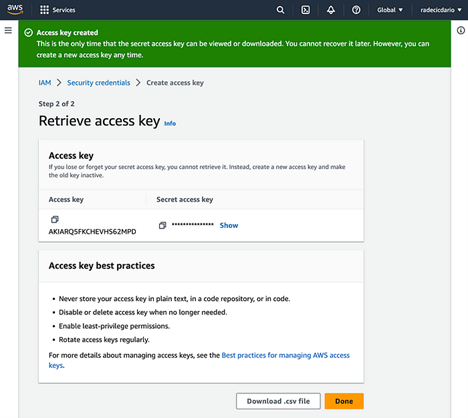
Обязательно скопируйте ключ доступа и секретный ключ доступа в какое-либо безопасное место.
Переходим к БД Postgres. Перейдите в раздел RDS - Базы данных и создайте новый экземпляр базы данных Postgres. Для дальнейшей работы бесплатной версии базы данных будет вполне достаточно. Убедитесь в том, что Вы запомнили введенные Вами имя пользователя и пароль.
Вот что Вы увидите, когда будет создана новая БД:

Мы практически у цели. Следующим шагом будет разрешение входящего трафика на порт 5432. В группе безопасности AWS добавьте правило входящего трафика, чтобы разрешить трафик из общедоступного IP-адреса:
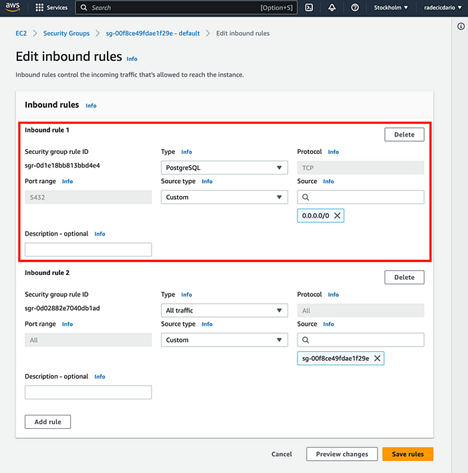
С базой данных S3 и RDS разобрались.
Последний шаг - создание новой таблицы в созданной базе данных. Установите соединение с помощью любого программного обеспечения с графическим интерфейсом (мы используем бесплатную версию TablePlus) и выполните следующую команду CREATE TABLE:
CREATE TABLE users(
  id INTEGER,
  name VARCHAR(128),
  email VARCHAR(256),
  gender VARCHAR(32),
  status VARCHAR(32),
  inserted_from VARCHAR(32)
);
Вот что Вы должны увидеть, выполнив эту команду:
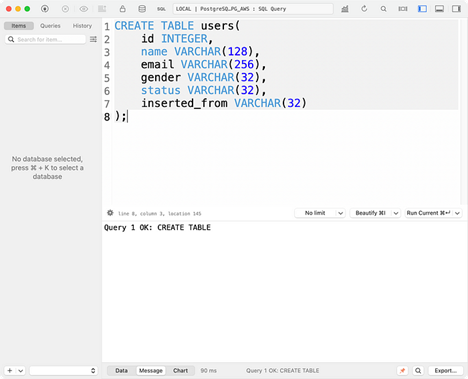
Эта таблица нужна нам, поскольку мы будем извлекать данные о пользователях из бесплатного REST API и вставлять их в эту таблицу. Дополнительный столбец inserted_from позволит нам отслеживать, с какой именно платформы по управлению данными были вставлены новые строки.
Поздравляю Вас, настройка завершена! Теперь создадим эффективный конвейер обработки данных с использованием платформы Apache Airflow.
Конвейер данных в Airflow
Написание вышеупомянутого конвейера данных в Airflow состоит из двух этапов:
- установление соединения для REST API, S3 и Postgres;
- написание конвейера по обработке данных.
Конфигурация соединения
Предполагается, что у Вас уже запущенны веб-сервер и планировщик Airflow. Откройте главную страницу и перейдите в раздел Admin - Connections. Для того, чтобы добавить новое соединение, нажмите на синий значок плюса.
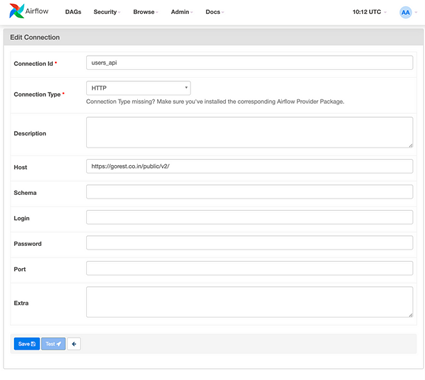
Первое соединение, которое необходимо установить, касается REST API. Обязательно добавьте новое HTTP-соединение и укажите хост, при этом не добавляйте маршрут /users:
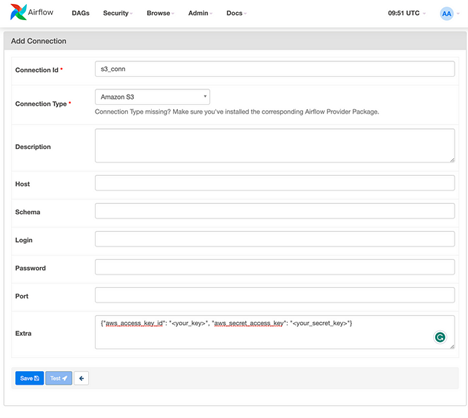
Следующее соединение касается бакета S3. Вам необходимо указать тип соединения - Amazon S3, а затем написать JSON в поле Extra. Здесь необходимо указать ключ доступа и секретный ключ:
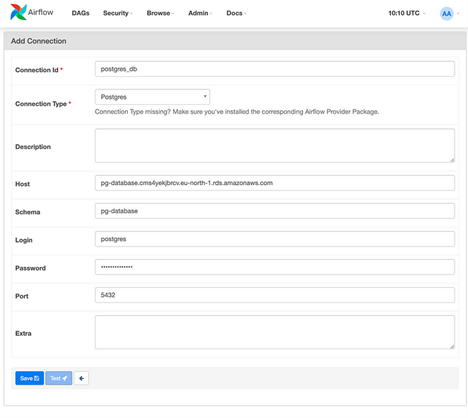
Затем устанавливаем соединение с БД Postgres. Здесь нужно заполнить больше полей, но, поверьте, это совсем не страшно. Убедитесь в том, что Вы скопировали хoст со страницы Amazon RDS для Вашей базы данных, не забудьте указать учетные данные для входа:
Итак, все необходимые нам соединения успешно установлены. Это гарантирует то, что никакие конфиденциальные данные не будут жестко закодированы в скриптах Python.
Написание DAG на языке Python
Для установления нужного типа соединений используйте Airflow Provider. Установить можно через обычный pip,. Нам нужно соединение с S3 и PostgreSQL:
pip install 'apache-airflow[amazon]'
pip install 'apache-airflow[postgres]'
Теперь переходим к DAG. Он реализует четыре задачи:
- task_api_fetch: вызывает оператор SimpleHttpOperator , задача которого состоит в том, чтобы выполнить HTTP запрос и вернуть ответ в формате JSON. Эта задача использует самое первое соединение, которое мы настроили;
- task_save_locally: простой оператор PythonOperator, вызывающий функцию save_users_locally(). Эта функция извлекает данные из предыдущей задачи из Xcoms Airflow, а затем сбрасывает JSON-файл на диск;
- task_save_to_s3: вызывает Python функцию save_users_to_s3() и указывает ключевые аргументы для имени файла на локальной машине, имени файла в бакете S3 и имени бакета S3. Эта функция также использует хук S3Hook для загрузки файла в бакет;
- task_save_to_pg: вызывает функцию save_users_to_pg(), которая считывает JSON-файл с диска (из задачи 1), преобразует его в Pandas DataFrame, добавляет новый столбец для того, чтобы указать, с какой именно платформы по обработке данных были вставлены данные, и, наконец, объединяет Pandas и SQLalchemy для отправки данных в базу данных.
Код для работы с DAG:
import json
import pandas as pd
from datetime import datetime
from airflow.models import DAG
from airflow.providers.http.operators.http import SimpleHttpOperator
from airflow.operators.python import PythonOperator
from airflow.hooks.S3_hook import S3Hook
from airflow.hooks.postgres_hook import PostgresHook
from airflow.providers.postgres.operators.postgres import PostgresOperator


# Save to disk in JSON format
def save_users_locally(ti) -> None:
    users = ti.xcom_pull(task_ids=["get_users"])
    with open("/home/airflow/users.json", "w") as f:
        json.dump(users, f)

# Save users to AWS S3
def save_users_to_s3(filename, key, bucket_name):
    hook = S3Hook("s3_conn")
    hook.load_file(filename, key, bucket_name)

# Save users to Postgres database
def save_users_to_pg():
    with open("/home/airflow/users.json", "r") as f:
      users = json.load(f)

    users = pd.DataFrame(users)
    users["inserted_from"] = "airflow"
    hook = PostgresHook("postgres_db")
    users.to_sql("users", hook.get_sqlalchemy_engine(), if_exists="append", index=False)


with DAG(
    dag_id="airflow_pg_s3",
    start_date=datetime(2023, 7, 17),
    schedule_interval="@daily",
    catchup=False
) as dag:
    # 1. Get the data from a remote API
    task_api_fetch = SimpleHttpOperator(
        task_id="get_users",
        http_conn_id="users_api",
        endpoint="users/",
        method="GET",
        response_filter=lambda response: json.loads(response.text)
    )

    # 2. Save the file locally
    task_save_locally = PythonOperator(
        task_id="save_users_locally",
        python_callable=save_users_locally
    )

    # 3. Push the raw file to S3
    task_save_to_s3 = PythonOperator(
        task_id="save_users_s3",
        python_callable=save_users_to_s3,
        op_kwargs={
            "filename": "/home/airflow/users.json",
            "key": f"users_{int(datetime.timestamp(datetime.now()))}.json",
            "bucket_name": "demos3bucket-dr"
        }
    )

    # 4. Push to a Postrgres database
    task_save_to_pg = PythonOperator(
        task_id="save_users_pg",
        python_callable=save_users_to_pg
    )


    task_api_fetch >> task_save_locally >> task_save_to_s3 >> task_save_to_pg
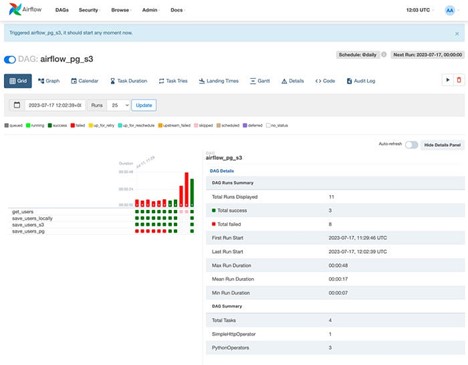
DAG заточен на ежедневное выполнение, но ее можно запустить и вручную. Не обращайте внимания на красные элементы графика:
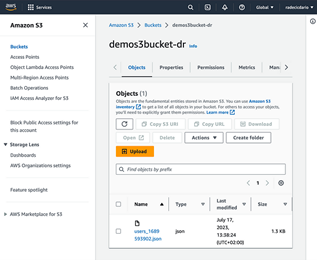
Итак, файл JSON был успешно загружен в бакет S3:
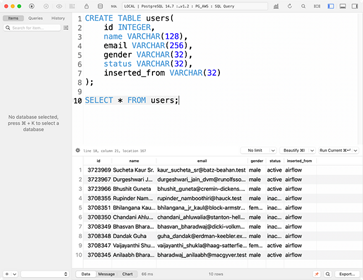
Как и следовало ожидать, данные также были успешно загружены в базу данных Postgres:
Это полный конвейер обработки данных Airflow.
Теперь давайте построим конвейер данных в Prefect.
Конвейер данных в Prefect
Мы считаем, что Prefect больше заточен на Python, нежели чем на Airflow, а это значит, что Вы можете легко хранить конфиденциальные данные в файле .env. Именно это обеспечим в первую очередь и только потом напишем Python-код для конвейера данных.
Конфигурация окружения
Если Вы хотите хранить учетные данные в файле .env, тогда Вам придется установить дополнительную зависимость:
pip install python-dotenv
Теперь создайте новый файл там, где Вы планируете разместить свой скрипт Prefect Python, и назовите его .env. Именно так, никакого имени файла, только расширение!
Вставьте в файл следующие строки:
API_USERS=
AWS_KEY=
AWS_SECRET=
S3_BUCKET=
PG_HOST=
PG_PORT=
PG_USER=
PG_PASS=
Заполните поля своими учетными данными. Окружать значения кавычками не нужно.
Написание конвейера данных в Prefect
Теперь перейдем к конвейеру. Для взаимодействия с бакетом S3 Вам понадобится еще одна зависимость:
pip install boto3
Теперь перейдем к потоку в Prefect, выполняющему следующие задачи:
- get_users(): задача Prefect, которая отвечает за получение JSON-ответа из заданного URL;
- save_users_locally(): выгружает предоставленный словарь в файл пути, который, в свою очередь, используется для сохранения JSON-файла на диск;
- save_users_to_s3(): использует boto3 для создания новой сессии с AWS, предоставляя ключ AWS API из файла .env. После установления сессии создается новый клиент S3 и файл загружается в соответствующий бакет;
- save_users_to_pg():использует модуль SQLalchemy для установления соединения с базой данных Postgres, преобразует словарь пользователей в Pandas DataFrame, добавляет новый столбец для того, чтобы указать, откуда были вставлены данные, и, наконец, добавляет данные в таблицу.
Эти четыре задачи должны быть объединены в один поток.
Считайте, что это главная функция программы, где Вы вызываете одну функцию за другой именно в том порядке, в каком должны выполняться задания.
Сниппет кода:
import os
import json
import boto3
import requests
import pandas as pd
from datetime import datetime
from dotenv import load_dotenv
from sqlalchemy import create_engine
from prefect import task, flow
from prefect.deployments import Deployment

# Load environment variables file
load_dotenv()


# Get users from remote API
@task
def get_users(url: str):
    req = requests.get(url=url)
    res = req.json()
    return res


# Save to disk
@task
def save_users_locally(users: dict, path: str):
    with open(path, "w") as f:
        json.dump(users, f)


# Save to an S3 bucket
@task
def save_users_to_s3(local_file_path: str, bucket_name: str, file_path: str):
    session = boto3.Session(
        aws_access_key_id=os.environ["AWS_KEY"],
        aws_secret_access_key=os.environ["AWS_SECRET"]
    )
    s3_client = session.client("s3")
    s3_client.upload_file(local_file_path, bucket_name, file_path)


# Save to Postgres database
@task
def save_users_to_pg(users):
    engine = create_engine(f"postgresql://{os.environ['PG_USER']}:{os.environ['PG_PASS']}@{os.environ['PG_HOST']}:{os.environ['PG_PORT']}")
    conn = engine.connect()

    users = pd.DataFrame(users)
    users["inserted_from"] = "prefect"
    users.to_sql("users", conn, if_exists="append", index=False)


# Actual flow - calls individual tasks
@flow
def s3_pg_flow():
    p_local_file = "users.json"
    p_s3_file_name = f"users_{int(datetime.timestamp(datetime.now()))}.json"

    users = get_users(os.environ["API_USERS"])
    save_users_locally(users, p_local_file)
    save_users_to_s3(p_local_file, os.environ["S3_BUCKET"], p_s3_file_name)
    save_users_to_pg(users)


if __name__ == "__main__":
    s3_pg_flow()
Вы можете запустить поток Prefect, используя следующий код:
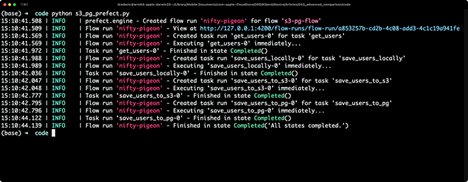
На первый взгляд никаких ошибок в потоке нет, но на всякий случай давайте проверим еще раз, были ли сохранены данные в S3 и Postgres.
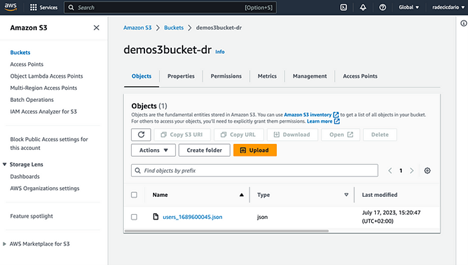
Перед выполнением потока мы удалили все содержимое бакета. Итак, Prefect удалось передать файл в бакет S3:
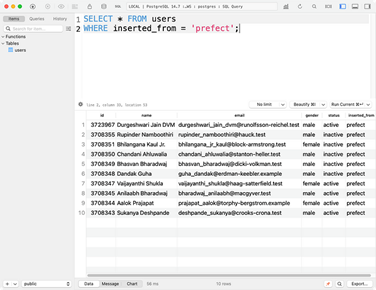
И он также смог вставить новые строки в нашу таблицу:
А что насчет развертывания?
Развертывание конвейера данных Prefect
Для того, чтобы развернуть конвейер данных Prefect, необходимо добавить еще одну функцию в Python-файл. Мы назвали ее deployment(). Она создаст развертывание конвейера Prefect, а затем будет вызываться при выполнении Python-файла:
...

# Deplpoy the flow so you can schedule it
def deployment():
    deployment = Deployment.build_from_flow(
        flow=s3_pg_flow,
        name="s3_pg_deployment"
    )
    deployment.apply()


if __name__ == "__main__":
    deployment()
Запустите файл Python, а затем сразу же выполните команду запуска сервера Prefect из Терминала.
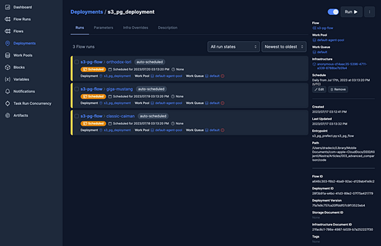
На порту 4200 откроется графический интерфейс Prefect, где вы можете щелкнуть на Развертывания и добавить расписание для Вашего потока Prefect:
В общем-то, и все! Просто, но довольно эффективно!
А теперь давайте посмотрим, что же предлагает еще одна вышеупомянутая альтернатива Airflow - Kestra.
Конвейер данных в Kestra
В отличие от Airflow и Prefect Kestra использует несколько иной подход к написанию потоков данных и конвейеров. Вы пишете все на YAML, что немного не привычно, но, с другой стороны, именно эта особенность делает систему более гибкой.
Вы можете запускать скрипты на любых языках программирования, и даже пользователи, не обладающие глубокими техническими знаниями, теоретически могут создать конвейер данных, поскольку YAML читается легче, чем Python.
Давайте сначала напишем поток, а затем поговорим о его планировании.
Написание потока Kestra
Предполагается, что Вы уже установили Kestra. Откройте веб-интерфейс на порту 8080, перейдите в раздел Потоки и создайте новый поток.
Мы работаем с файлами, сохраненными локально, поэтому лучше всего, чтобы задачи выполнялись в каталоге WorkingDirectory. Здесь на помощь приходит плагин Kestra.
Задачи:
- getUsers: Запускает скрипт Python, который делает GET-запрос к REST API, получает ответ в формате JSON и сбрасывает файл на диск;
- saveUsersLocally: проверяет, что наши данные сохранены в файле users.json, а также то, что мы можем получить к ним доступ из других задач Kestra;
- saveUsersS3: использует плагин S3 для загрузки файла JSON из предыдущей задачи в бакет S3. Убедитесь, что Вы заполнили отсутствующие значения, характерные именно для Вашего случая;
- input: Обеспечивает доступ JSON-файла для следующей задачи, которая сохраняет данные в базе данных Postgres;
- saveUsersPg: Запускает скрипт Python, который загружает JSON-файл с диска, преобразует его в Pandas DataFrame, добавляет новый столбец, чтобы отметить, откуда были вставлены строки, и, наконец, вставляет данные, комбинируя SQLalchemy и Pandas.
Это полный YAML-файл, необходимый для организации потока Kestra:
id: kesta-s3-pg
namespace: dev

tasks:
  - id: wdir
    type: io.kestra.core.tasks.flows.WorkingDirectory
    tasks:
      - id: getUsers
        type: io.kestra.plugin.scripts.python.Script
        runner: DOCKER
        docker:
          image: python:3.11-slim
        beforeCommands:
          - pip install requests > /dev/null
        warningOnStdErr: false
        script: |
          import json
          import requests

          URL = "https://gorest.co.in/public/v2/users"
          req = requests.get(url=URL)
          res = req.json()

          with open("users.json", "w") as f:
            json.dump(res, f)

      - id: saveUsersLocally
        type: io.kestra.core.tasks.storages.LocalFiles
        outputs:
          - users.json

      - id: saveUsersS3
        type: io.kestra.plugin.aws.s3.Upload
        from: "{{outputs.saveUsersLocally.uris['users.json']}}"
        key: users-kestra.json
        bucket:
        region:
        accessKeyId:
        secretKeyId:

      - id: input
        type: io.kestra.core.tasks.storages.LocalFiles
        inputs:
          data.users: "{{outputs.saveUsersLocally.uris['users.json']}}"

      - id: saveUsersPg
        type: io.kestra.plugin.scripts.python.Script
        beforeCommands:
          - pip install requests pandas psycopg2 sqlalchemy > /dev/null
        warningOnStdErr: false
        script: |
          import json
          import pandas as pd
          import requests
          from sqlalchemy import create_engine

          with open("data.users", "r") as f:
            users = json.load(f)

          df_users = pd.DataFrame(users)
          df_users['inserted_from'] = 'kestra'

          engine = create_engine(
            f"postgresql://<username>:<password>@<host>:<port>"
          )

          df_users.to_sql("users", engine, if_exists="append", index=False)
Kestra делает планирование очень простым, но сначала давайте протестируем поток, запустив его вручную. Как только Вы сохраните файл в редакторе, нажмите на кнопку Новое выполнение (в правом нижнем углу).
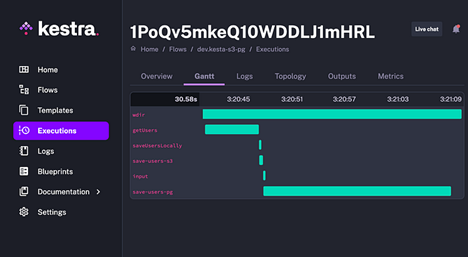
Это перенаправит нас к представлению Ганта о выполнении потока. Зеленый цвет означает "хорошо", а красный - "плохо". К счастью, в нашем случае все зеленое:
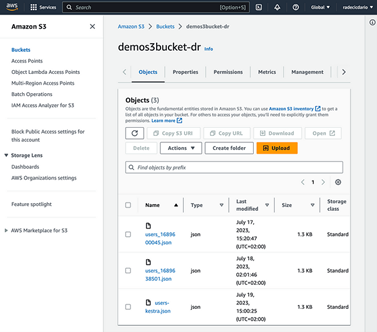
Итак, Kestra успешно загрузила JSON-файл в бакет S3:
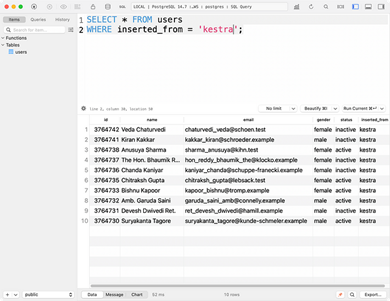
Аналогичным образом она успешно загрузила данные и в Postgres:
Если Вы не против написать более длинную задачу на Python, давайте упростим поток Kestra.
Как сделать поток Kestra более простым
Kestra предпочитает иметь дело с заданиями на Python, что позволяет ей упростить работу с IO.
По этой причине Вы можете значительно упростить поток, упомянутый выше:
- apiToPostgres: Использует задачу скрипта Python для загрузки JSON-файла из удаленного API, его локального сброса на диск, преобразования в Pandas DataFrame, добавления нового столбца и отправки в Postgres;
- s3upload: необходим для того, чтобы перенести локально сохраненный JSON-файл в бакет S3
Или используйте следующий код:
id: postgresS3PythonScript
namespace: dev

tasks:
  - id: apiToPostgres
    type: io.kestra.plugin.scripts.python.Script
    beforeCommands:
      - pip install requests pandas psycopg2 sqlalchemy > /dev/null
    warningOnStdErr: false
    script: |
      import json
      import pandas as pd
      import requests
      from sqlalchemy import create_engine

      URL = "https://gorest.co.in/public/v2/users"
      req = requests.get(url=URL)
      res = req.json()

      with open("{{outputDir}}/users.json", "w") as f:
            json.dump(res, f)

      df_users = pd.DataFrame(res)
      df_users["inserted_from"] = "kestra"

      engine = create_engine("postgresql://<username>:<password>@<host>:<port>")

      df_users.to_sql("users", engine, if_exists="append", index=False)

  - id: s3upload
    type: io.kestra.plugin.aws.s3.Upload
    from: "{{outputs.apiToPostgres.outputFiles['users.json']}}"
    key: kestra-users.json
    bucket:
    region:
    accessKeyId:
    secretKeyId:
При запуске потока Вы увидите следующее:
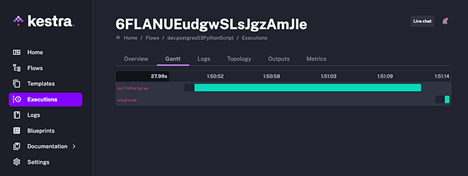
В целом, наш поток теперь состоит всего из двух задач, при этом код значительно короче. Говоря простым языком, он стал намного элегантнее.
Единственное, что мы пока не рассмотрели, - это планирование потока с помощью Kestra.
Планирование потока Kestra
Для того, чтобы запланировать поток Kestra, Вы можете просто вставить триггер Schedule в нижнюю часть Вашего YAML-файла. В отличие от задач Kestra, этот блок кода не должен иметь каких-либо отступов:
triggers:
  - id: schedule
    type: io.kestra.core.models.triggers.types.Schedule
    cron: "0 0 * * *"
Говоря простым языком, это расписание будет следить за тем, чтобы поток Kestra запускался каждый день в полночь.
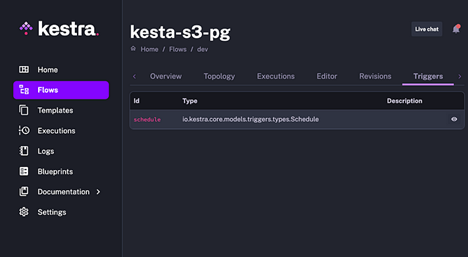
Вы можете увидеть, как он стартует, просмотрев вкладку Триггеры, а также увидеть "S" рядом с запуском потока, что указывает на то, что он был запущен планировщиком:
И все это - Kestra!
Вопрос, является ли Airflow безоговорочным лидером или у него все-такие есть достойнейшие альтернативы, такие как Kestra и Prefect, остается открытым … Давайте все же попробуем на него ответить.
Вердикт: какая платформа по управлению данными самая лучшая в 2023 году?
В данной статье мы рассмотрели конвейер данных, максимально приближенный к реально работающему варианту. В предыдущей статье были рассмотрены два более простых конвейера. Изучив все возможные варианты, мы можем со всей ответственностью вынести окончательный вердикт.
Выбор платформы по управлению данными целиком и полностью зависит от Ваших личных предпочтений и потребностей компании, в которой Вы работаете.
Если Вам нравится работать с Python, тогда обратите внимание на Airflow или Prefect. Если Вы предпочитаете более «легковесные» варианты, не привязанные к Python, смело выбирайте Kestra.
Так какую же платформу по управлению данными выберите Вы?


