

Загрузка данных — часть 2: стратегия выбора инструмента
Эта статья является второй в серии статей, посвященных загрузке данных. Для ознакомления с данной темой рекомендую прочитать самую первую статью.
Инструменты загрузки данных играют решающую роль в соединении операционных приложений ("операционная плоскость") с аналитическими инструментами, необходимыми для создания отчетов ("аналитическая плоскость"). Выбор правильных инструментов загрузки данных – это не просто какие-то личные предпочтения, это стратегическое решение, влияющее на эффективность и функциональные возможностей обработки данных в организации. Своевременность, корректность и надежность загрузки данных очень важны, поскольку данные, которые не могут быть оперативно введены в систему, просто - напросто теряют свою ценность для бизнеса.
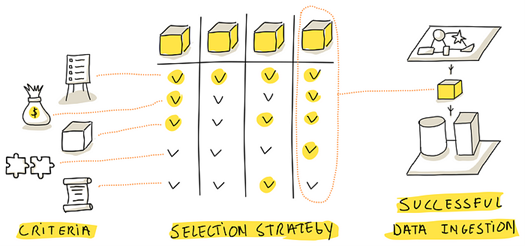
Данная статья разделена на три части, каждая из которых описывает определенный этап в процессе выбора оптимальных инструментов. В части "Критерии выбора инструментов" мы обсуждаем самые важные критерии выбора инструментов загрузки данных. Вторая часть под названием "Разновидности инструментов загрузки данных" представляет собой обзор различных типов доступных инструментов с акцентом на наиболее часто используемые экземпляры. Третья часть, "Стратегия выбора", описывает тонкости детальной оценки характеристик инструментов, которая необходима для того, чтобы выбрать наиболее оптимальный вариант из представленных исходя из потребностей именно Вашей организации. Каждая из этих глав призвана помочь Вам сделать правильный выбор инструмента загрузки данных.
Критерии выбора инструментов загрузки данных
Стратегические критерии
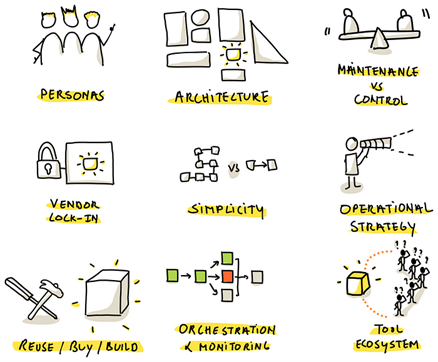
При выборе инструментов загрузки данных необходимо учитывать архитектуру данных и ИТ-стратегию Вашей организации:
- Пользователи: ключевое значение имеет определение пользователей и их опыт взаимодействия с инструментами загрузки данных. Например, будут ли это квалифицированные дата-инженеры или начинающие бизнес-аналитики? Будут ли они работать с существующими конвейерами обработки данных или активно расширять их? Все эти факторы влияют на оптимальный набор и сложность инструментов;
- Архитектура платформы данных: архитектура Вашей будущей платформы данных также играет важную роль в выборе инструментов. Как отмечалось в предыдущей статье, различные архитектурные паттерны, такие как ELT или ETL, предполагают различные типы инструментов;
- Простота: критерий простоты выступает в пользу выбора пути с наименьшим количеством шагов при перемещении данных от источника к продукту. Чем больше этапов, тем выше вероятность провала. Простота может быть достигнута за счет использования одного инструмента для выполнения как входящей (extract-load), так и преобразующей части конвейера обработки данных;
- Привязка к поставщику: учитывая постоянно меняющийся ландшафт данных, разумно выбирать инструменты, которые сводят к минимуму привязку к одному поставщику, что предполагает тщательное рассмотрение потенциальных стратегий выхода и их последствий. Обратите внимание, что подход "один инструмент подходит всем" (как описано в части "Простота") обычно приводит к привязке к поставщику;
- Стратегия операционной деятельности: выбор инструментов загрузки данных должен основываться и на текущей и потенциально возможной операционной деятельности (как правило, описанной в ИТ-стратегии). Переход к потоковой архитектуре, использование продуктов SaaS или локальных РСУБД предполагает применение совершенно разных инструментов;
- Компромисс между обслуживанием и уровнем контроля: очень часто между уровнем необходимого обслуживания и степенью контроля приходится искать компромисс. Инструменты с высоким уровнем обслуживания обычно подразумевают высокую степень контроля, поскольку предполагают обновления и изменения конфигурации. Инструменты с низким уровнем обслуживания (PaaS или SaaS) подразумевают ограниченный контроль, что позволяет высвободить ресурсы для решения других важных задач, таких как, например, преобразование данных;
- Мониторинг и оркестрация: эффективная загрузка данных требует точной синхронизации - либо по триггеру, либо по фиксированному расписанию. Кроме того, очень важна возможность легко отслеживать состояние этих процессов. Инструменты и организационные стратегии, которые Вы используете для мониторинга и оркестрации, также влияют на выбор инструментов загрузки данных;
- Повторное использование vs Покупка vs Разработка: при выборе инструмента загрузки данных также необходимо важно ориентироваться на подход Вашей компании к построению технологической инфраструктуре и разработке приложений. Предпочитает ли Ваша компания использовать существующие решения, приобретать новые или создавать собственные решения, если подходящего продукта не существует?
- Экосистема инструмента: даже если Вы найдете идеальный инструмент, может случиться так, что в случае необходимости Вы не получите должной технической поддержи. Такая ситуация часто возникает с устаревшими продуктами, которые больше не поддерживаются, или с инструментами, разработанными стартапами. Выбор подобных инструментов сопряжен с определенными рисками. В то же самое время вполне возможно, что именно эти инструменты откроют перед Вами уникальные возможности, поскольку эффективно решают именно Ваши специфические задачи.
Критерии ценообразования
Рынок инструментов загрузки данных пестрит самыми разными поставщиками, применяющими различные стратегии ценообразования. Для того чтобы получить представление о том, как будет меняться стоимость владения инструментом при различных сценариях, очень важно тщательно проанализировать все представленные модели ценообразования. Такой анализ позволит Вам предугадать, как будут меняться расходы по использованию инструмента по мере изменения Ваших потребностей и поможет Вам определиться с инструментом, который не только будет отвечать Вашим текущим требованиям, но и будет экономически эффективным в долгосрочной перспективе.
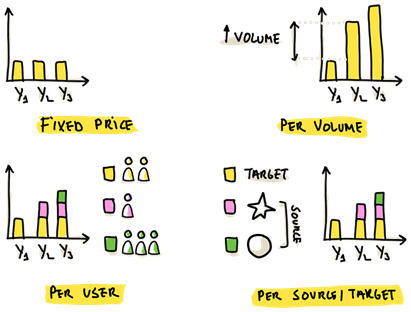
Наиболее распространенные стратегии ценообразования, представленные на рынке:
- Фиксированная цена: самый непопулярный вариант, но при этом очень удобный. Ключевое преимущество в данном случае – это предсказуемость: Вы заранее знаете стоимость использования инструмента независимо от масштаба и сложности Ваших операций с данными;
- Цена в зависимости от объема загружаемых данных: в данном случае плата взимается в зависимости от объема обрабатываемых данных. Типичным показателем является количество обработанных строк.
- Вариации этой стратегии включают такие сценарии, как бесплатная первоначальная загрузка с последующими платными обновлениями, тарификация на основе уникальных первичных ключей, обновленных в течение месяца и т.д.;
- Цена в зависимости от количества пользователей: цена варьируется в зависимости от количества пользователей, которые могут создавать или изменять конвейеры загрузки данных. Очевидно, что не стоит делать выбор в пользу данной модели, если Ваша цель - обеспечить доступ к возможностям загрузки данных большому количеству Ваших сотрудников;
- Цена в зависимости от источника данных: достаточно популярная схема, предполагающая определение стоимости в зависимости от источника данных. В данном случае могут также учитываться изменения в объеме загружаемых данных или вычислительные ресурсы (например, использование центрального процессора), которые необходимо задействовать при работе с тем или иным источником данных;
- Цена в зависимости от конвейера данных: в данном случае плата зависит от количества настроенных конвейеров загрузки данных.
Обратите внимание и на косвенные расходы. Запуск инструментов загрузки данных в облачной среде влечет за собой дополнительные расходы по использованию вычислительных ресурсов и ресурсов хранения. Аналогичным образом, локальное использование влечет за собой расходы на лицензирование и инфраструктуру, необходимую для работы инструмента.
Функциональные требования, предъявляемые к данным
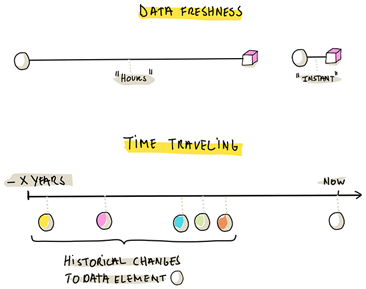
Предполагаемые сценарии использования данных, названные в предыдущей статье "Зачем", предполагают различные функциональные требования к данным.
Ключевые аспекты, которые необходимо учитывать при выборе инструмента загрузки данных:
- Свежесть данных: «своевременность» данных может варьироваться от ежедневных обновлений до доступности в режиме реального времени. Данный критерий является очень важным, поскольку инструменты, предназначенные для загрузки данных в режиме реального времени, значительно отличаются от тех, которые используются для ежедневных процессов;
- История данных: предполагает ли Ваша стратегия работы с данными ведение истории их изменений? Если да, то обратите свое внимание на инструменты, способные фиксировать и сохранять эти изменения;
- Объем данных: постарайтесь рассчитать примерный объем данных, который будут генерировать Ваши сценарии использования, а также темпы его роста в долгосрочной перспективе. Этот момент имеет ключевое значение как для ценовой политики, так и для масштабируемости инструмента. Согласитесь, что очень важно остановиться на инструменте, способном эффективно обрабатывать ожидаемый объем данных без лишних затрат;
- Разнообразие данных: оцените многообразие типов данных, которые необходимо обработать. Требования к вводу неструктурированных данных, таких как видео, изображения или документы, значительно отличаются от требований к обработке структурированных данных из традиционных РСУБД. Многообразие диктует необходимость в специализированных инструментах, способных эффективно работать с различными форматами данных.
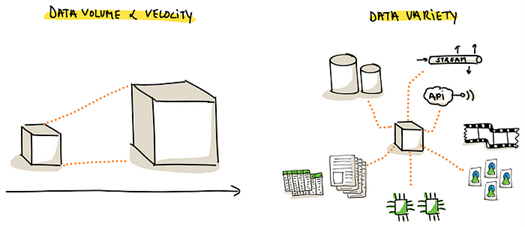
Понимание этих функциональных требований к данным помогает выбрать инструменты, которые не только соответствуют Вашим текущим запросам, но и способны удовлетворить Ваши потребности в долгосрочной перспективе.
Критерии источников и места назначения данных
Особенности того, как данные поступают и выходят из Вашей системы определяют следующие критерии выбора инструментов загрузки данных:
- Требования, предъявляемые к источникам данных: сфокусируйтесь на источниках, из которых Вы планируете получать данные. Важно учитывать типы API, которые поддерживают эти источники, особенности их развертывания в виде SaaS-приложений, а также протоколы, которые они используют для потоковой передачи данных. Особое внимание следует уделить движению данных между локальными и облачными средами (или наоборот), поскольку для этого часто требуется специализированное промежуточное ПО или шлюзовые решения;
- Требования, предъявляемые к месту назначения данных: поговорим о том, где будут храниться полученные данные, и как ими необходимо будет управлять. Механизмы хранения данных крайне важны. Это могут быть как озера данных, так и более традиционные системы управления реляционными БД. Каждый вариант хранения данных характеризуется уникальными требованиями и возможностями, которые влияют на выбор инструментов для обеспечения бесперебойного потока данных и их эффективного хранения.
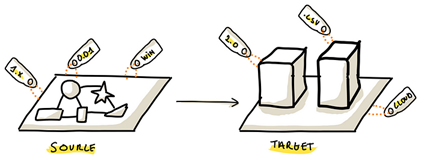
Тщательно изучив требования к источнику и месту назначения данных, Вы сможете выбрать инструменты, которые не только совместимы с Вашей существующей инфраструктурой, но и способны учесть все нюансы Вашей стратегии управления данными.
Критерии контракта данных
При передаче данных из исходной системы в Вашу платформу данных между ними фактически заключается "контракт данных", который определяет структуру передаваемых данных. В зависимости от источника данных эта структура может содержать различные атрибуты, например столбцы и типы данных в РСУБД, структуру JSON в REST API и т.д.
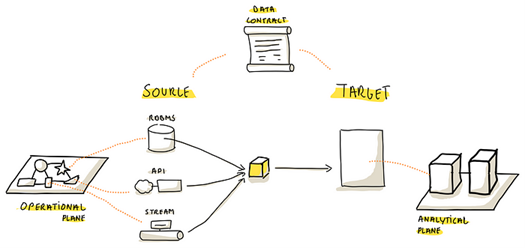
При выборе инструментов загрузки данных следует учитывать их способность управлять этими контрактами на данные, которые могут быть как явными, так и неявными:
- Явный контракт данных: инструмент должен обладать способностью адаптироваться к любым изменениям в контрактах данных и управлять ими, обеспечивая последовательность и надежность обработки данных;
- Устойчивость к изменениям в контракте: важно предусмотреть, как инструмент будет реагировать на неожиданные нарушения или изменения контракта данных. Остановится ли процесс загрузки данных, или инструмент предложит какой-либо запасной вариант? Учитывая частые изменения в структурах данных, способность инструмента справляться с такими сбоями имеет решающее значение для поддержания непрерывности обработки данных.
Понимание и соблюдение этих требований необходимо для обеспечения надежности процесса ввода данных и его адаптации к изменениям в структуре данных.

Разновидности инструментов загрузки данных
Теперь пришло время рассмотреть четыре наиболее распространенные категории инструментов загрузки данных, каждая из которых обладает определенными характеристиками и возможностями.
Инструменты пакетной загрузки данных
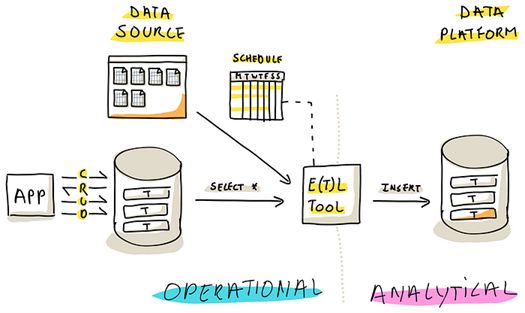
Инструменты пакетной загрузки данных предназначены для систематического извлечения данных из их источника и их передачи в определенное место назначения по заранее составленному расписанию, например, раз в сутки. Как правило, эти инструменты являются неотъемлемыми компонентами наборов инструментов ETL (Extract, Transform, Load) или ELT (Extract, Load, Transform). В данном случае различают два основных механизма:
- Полная загрузка: или перенос абсолютно всех данных из исходной системы в целевую. Это комплексный метод, который обеспечивает полную репликацию данных;
- Инкрементальная загрузка: в отличие от полной загрузки метод инкрементной загрузки направлен на передачу только тех данных, которые изменились с момента последней загрузки. Для этого требуется уникальный идентификатор для каждой записи и временная метка для отслеживания того, когда каждая запись была изменена в последний раз.
Пакетная обработка - это достаточно простой метод загрузки данных, однако у него есть свои недостатки, в частности, высокая нагрузка на систему исходных данных. Чтобы снизить влияние на производительность системы, пакетная обработка часто выполняется в непиковые часы, например, ночью. Однако эти процессы могут занимать слишком много времени, зачастую они растягиваются на несколько часов;
Инкрементная загрузка, ориентированная на передачу ограниченного объема измененных данных, оказывает меньшую нагрузку на исходную систему, благодаря чему можно загружать данные с более частыми интервалами, например каждые 5-10 минут. Однако проблема инкрементной загрузки заключается в требовании надежных первичных ключей и временных меток изменений, которые не всегда доступны во многих исходных системах.
CDC - инструменты
Система отслеживания измененных данных (CDC) — это техника, используемая в управление данными для идентификации и отслеживания изменений, внесенных в данные в базе данных, и применения этих изменений в целевой системе. CDC- инструменты , как правило, применяются в процессах ELT, где они управляют фазами извлечения и загрузки, преобразование данных происходит в самой платформе данных.
Среди различных методов репликации CDC наиболее широко используется репликация на основе журнала. В данном случае CDC- инструмент получает доступ к журналу записи (WAL) базы данных, в котором записываются все операции Create, Read, Update, Delete (CRUD. Доступ к WAL позволяет процессу CDC реплицировать эти операции на целевой платформе без дополнительной нагрузки на исходную базу данных.
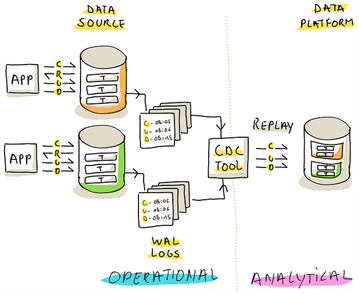
Для эффективного CDC на основе журналов очень важно, чтобы исходные системы сохраняли свои журналы WAL в течение долгого времени. Некоторые продвинутые CDC- инструменты способны интерпретировать и преобразовывать журналы из систем баз данных одного типа (например, Oracle) в системы другого типа (например, Delta Lake или аналитическое хранилище данных). При этом важно отметить, что CDC - инструменты в первую очередь предназначены для систем баз данных, и их использование с другими источниками данных является скорее исключением, чем нормой.
Инструменты на основе коннекторов
Третья категория инструментов загрузки данных работает, используя систему коннекторов "plug-and-play", которые облегчают постановку задач по передаче данных между источниками и местами назначения. Каждый коннектор в этой системе оснащен специальными механизмами для извлечения данных из источников и их загрузки в место назначения.
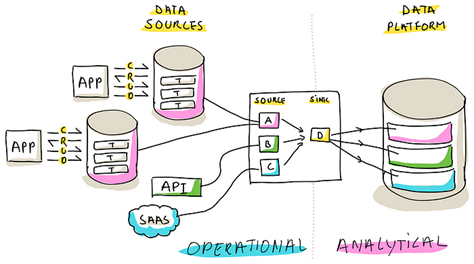
Как правило, выделяют три типа коннекторов:
- Коннекторы приложений: предназначены для загрузки данных из ведущих программных продуктов, используемых в CRM, ERP, Payroll, Project Management и т. д. Как правило, они используют методы извлечения данных на основе API, адаптированные к конкретным требованиям каждого приложения;
- Коннекторы баз данных: упрощают процесс загрузки данных из баз данных. В зависимости от коннектора базовый механизм может включать CDC-подобные процессы или стандартные методы пакетной загрузки;
- Универсальные коннекторы: предназначены для более универсальных задач извлечения данных, поддерживают целый ряд функций. Например, загрузка данных из CSV-файлов, взаимодействие с API REST или OData или извлечение данных из SFTP-источников.
В целом, коннекторы разработаны таким образом, чтобы дополнять различные платформы данных, обеспечивая беспрепятственную загрузку данных в хранилища данных, озера данных или более традиционные системы баз данных.
Загрузка данных на основе кода
Основные характеристики загрузки данных на основе кода:
- Высокий уровень контроля: создавая конвейеры с помощью кода, Вы получаете детальный контроль над каждым аспектом. Такой уровень контроля позволяет создавать конвейеры для очень специфических или необычных типов данных и достигать строгих SLA;
- Ограниченная привязка к поставщику: использование сразу нескольких языков программирования и (стандартизированных) метаданных обеспечивают более простые стратегии выхода, благодаря чему при необходимости Вам будет легче сменить поставщика;
- Возможности автоматизации: использование подхода, основанного на метаданных, позволяет полностью автоматизировать процесс загрузки данных;
- Сначала создать и только потом купить: разработка собственной системы загрузки данных с нуля влечет за собой более высокие первоначальные затраты по сравнению с готовыми решениями;
- Специалисты: привлечение настоящих профессионалов, разбирающихся в созданных на заказ конвейеров загрузки данных, может оказаться непростой задачей. Обслуживание разработанных конвейеров данных подразумевает использование проверенных методов кодирования, а также предоставление исчерпывающей документации.
Стратегия выбора инструмента загрузки данных
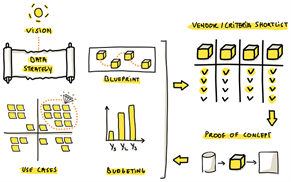
Выбор правильных инструментов загрузки данных - это итеративный процесс, при котором очень важно учитывать все критерии, описанные выше. Чтобы разработать стратегию выбора инструментов, начните со следующих шагов:
- Определите цели использования данных: определите и расставьте приоритетные цели использования продуктов данных. Определите конкретные типы данных, необходимые для анализа. Этот шаг поможет определить функциональные требования к данным и специфические потребности Ваших исходных систем;
- Разработайте предварительную стратегию в области данных: в данном случае мы говорим о стратегическом мышлении для определения критериев, относящихся к обработке данных в Вашей организации. Это могут быть решения о создании или покупке инструмента загрузке, его простоте или сложности, об избегании привязки к поставщику, централизованном мониторинге и определении основных пользователей инструментов загрузки данных. Помните, что эта стратегия является лишь отправной точкой, а не финальным вариантом;
- Набросайте эскиз архитектуры платформы данных: инструмент загрузки данных - это лишь один из компонентов архитектуры платформы данных. Необходимо понять, как будут храниться данные, как будут организованы конвейеры обработки данных, и как будет осуществляться мониторинг работы всей платформы. Эти факторы повлияют на требования, предъявляемые к инструментам загрузки данных;
- Бюджетирование: после определения потенциальной отдачи от использования данных важно оценить бюджет, необходимый для внедрения новых инструментов. Учитывайте финансовый подход Вашей организации, будь то бюджет на год или более гибкое поквартальное планирование.
Учитывая все эти 4 шага, составьте список критериев с учетом потребностей именно Вашей организации. Этот список послужит основой для создания шорт-листа поставщиков на основе их предложений, касательно инструментов загрузки данных. После того как Вы составите этот список, свяжитесь с ними для того, что убедиться в соответствии предлагаемых инструментов Вашим требованиям.
Заключительным шагом является проведение проверка концепции (POC). Этот шаг очень важен для того, чтобы убедиться в том, что решения потенциальных поставщиков обеспечат плавный переход от теории к практике. Если POC первого поставщика не оправдает Ваших ожиданий, смело переходите к следующему поставщику из Вашего списка. Результаты POC послужат основой для принятия окончательного решения о выборе поставщика инструмента загрузки данных.
Как Вы видите, этот процесс является итеративным. Активное взаимодействие с поставщиками может дать информацию, которая окончательно сформирует Ваши первоначальные потребности. Аналогичным образом, в ходе POC могут быть выявлены требования, которые Вы изначально упустили из виду. Такой итеративный подход обеспечивает тщательный и обоснованный процесс выбора инструмента загрузки данных.
Заключение
В этой статье дается подробное описание самых разных критериев выбора инструментов загрузки данных. При выборе наиболее оптимального варианта я настоятельно рекомендую ориентироваться на потребности и специфические задачи именно Вашей организации. В одной из последующих статей (часть 3) я расскажу Вам о своем исследовании рынка на предмет соответствия различных инструментов обсуждаемым здесь критериям.
Критерии, изложенные в этой статье, могут быть применены не только к выбору инструментов загрузки данных - ими вполне можно руководствоваться и при определении других компонентов платформы данных, таких как решения для хранения данных или технологии построения конвейеров обработки данных.


