

Архитектура конвейеров на потоках
Эта глава посвящена архитектуре конвейеров на потоках в рамках курса по построению хранилища данных на основе концепции Event Driven Architecture (EDA). Здесь мы дадим понятия, принципы и практические подходы, которые помогут новичку быстро включиться в работу над проектами, где данные поступают непрерывно, события происходят в реальном времени, а хранение и анализ требуют минимальной задержки и высокой надёжности. Мы опишем теоретическую часть, дамо реальные примеры и технические детали, рассмотрим риски внедрения и ограничения, а в завершение — блок вопросов и ответов, который поможет закрепить материал и подготовиться к практической работе.
Что такое конвейер на потоках
Конвейер на потоках — это последовательность взаимосвязанных компонентов, через которые непрерывно проходят события, записи или сообщения. Каждый элемент конвейера выполняет свою функцию: собирает данные, валидирует и нормализует формат, обогащает контекстом, агрегирует, передает дальше или сохраняет в целевых системах. Такой подход позволяет перерабатывать потоки данных в реальном времени или почти в реальном времени, обеспечивая актуальные данные для принятия решений, мониторинга и аналитики.
Основные термины и понятия
- Источник событий (производитель, producer): система, которая генерирует события и отправляет их в конвейер. Примеры: базы данных, веби мобильные приложения, сенсоры, логи.
- Шина событий (сообщений, брокер): компонент, который принимает события и распределяет их потребителям. Часто это строится на Apache Kafka, Apache Pulsar или аналогичных системах.
- Топик/пул тем и разделы (topic, partition): логические каналы внутри шины, которые позволяют параллелизм и масштабирование. Топик может состоять из нескольких разделов, каждый из которых хранит часть данных.
- Обработчик/потребитель (consumer, operator): сервис или задача, которая читает события из шины, выполняет преобразования, обогащение или вычисления.
- Этап обработки (processing): стадия, где выполняются вычисления — фильтрация, агрегация, соединение с дополнительными данными, вычисления скользящих окон и т.д.
- Хранилище данных (sink): место, куда уходят готовые данные — распределённое хранилище, Data Lake, хранилище аналитики или база данных.
- Schema registry: сервис управления схемами данных, который обеспечивает совместимость форматов и эволюцию схем без потери совместимости.
- Exactly-once / at-least-once semantics: гарантии доставки и обработки — критично для корректности аналитики.
- Backpressure: механизм, при котором потребители могут замедлять производство данных, чтобы не перегружать систему.
- Data lineage и observability: отслеживание происхождения данных, потери информации и мониторинг конвейера.
Архитектурные принципы и паттерны
- Архитектура на потоках против пакетной обработки: в потоковой архитектуре данные обрабатываются по мере поступления, задержка минимальна, но требования к idempotence и устойчивости к повторной отправке выше.
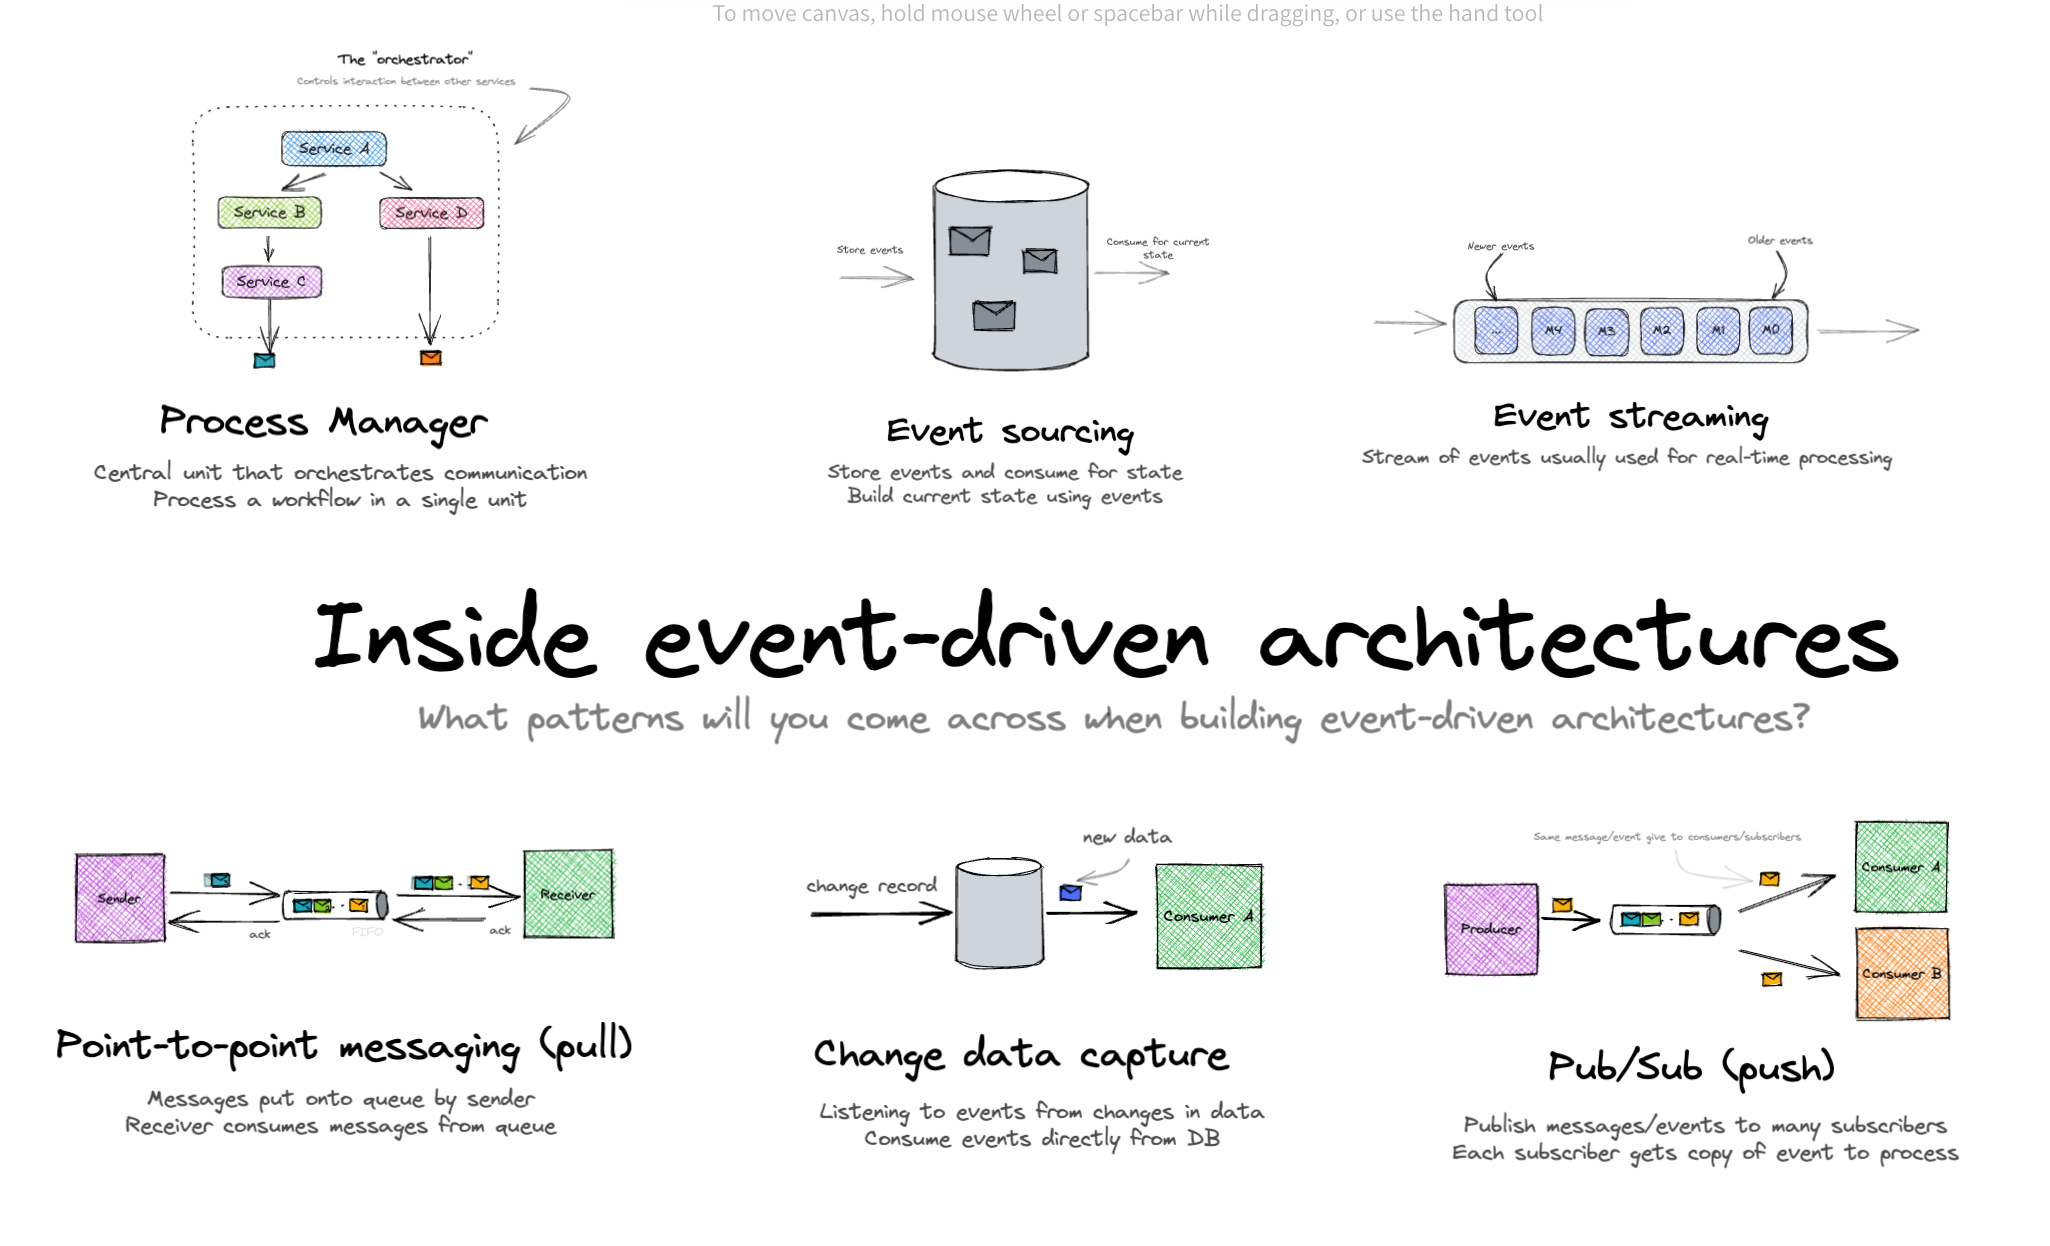
- Event-driven architecture (EDA): события служат триггерами для действий и изменений состояния в разных сервисах. Эталонная модель — события публикуются в шину, потребители реагируют на них автономно.
- Kappa против Lambda: Lambda объединяет обработку «скоростей» (потоковых) и пакетной обработки для сложной трансформации, что требует двойного кода и синхронизации. Kappa упрощает архитектуру, полагаясь только на потоковую обработку и устранение двойной обработки через идемпотентность и точные семантики.
- Change Data Capture (CDC): технология отслеживания изменений в источниках данных (например, в БД) и публикации этих изменений как событий в конвейер. Это позволяет получать почти реальное обновление хранилища без полного сканирования БД.
- Event sourcing и audit log: события полноценно записывают изменения состояния системы, что упрощает аудит, восстановление и ретроспективное анализирование.
- Управление схемами и совместимость: использование схем (Avro, Protobuf, JSON Schema) и центра регистрирования схем (schema registry) для поддержки изменений и совместимости.
- Управление качеством данных: валидация форматов, проверка консистентности, обработка дубликатов, защита от пропусков и ошибок в данных на разных этапах конвейера.
- Безопасность и соответствие требованиям: аутентификация, авторизация, шифрование на транспортном уровне (TLS) и в покое, контроль доступа к данным, аудит операций.
Этапы проектирования конвейера
- Определение целей и требований: какие данные, какая задержка допустима, какие показатели качества должны быть достигнуты.
- Выбор технологического стека: решение о брокере очередей, обработчиках, хранилищах и форматах данных.
- Проектирование схемы данных: единая модель событий, типы событий, обязательные поля, версия схемы.
- Архитектурная расстановка компонентов: какой компонент отвечает за ingest, обработку, хранение, мониторинг и регламент обновлений схем.
- Понимание характерных проблем: порядок обходов из-за задержек в источниках, обработка поздних данных, гарантии доставки, дубликаты и повторная обработка.
- План мониторинга и трассировки: какие метрики и логи собирать, как визуализировать поток ошибок и задержек.
Важные ограничители и риски
- Время задержки и пропускная способность: высокий объем событий требует масштабирования. Недостаточное число разделов topics или слабая конфигурация обработки ведут к узким горлышкам.
- За отсутствие порядка событий: в потоковых системах события могут приходить в разном порядке; проект должен учитывать порядок там, где он критичен, например через ключевые поля и окна.
- Schema evolution: изменение схемы без совместимости может привести к поломке конвейера. Требуется регистр схем и совместимости.
- Дубликаты и повторная обработка: сети могут повторно отправлять события; необходимы идемпотентные операции и idempotent sinks.
- Ограничения по задержке и латентности на отдельных стадиях: извлечение данных из источника, преобразование и запись в хранилище могут вносить задержку.
- Мониторинг и observability: сложность операций в реальном времени требует надлежащих инструментов мониторинга и трассировки.
- Безопасность и соответствие: конфиденциальные данные, доступ к данным, шифрование, контроль доступа.
- Вендорная зависимость и операционные риски: обслуживание и обновления инфраструктуры, зависимость от конкретного стека.
Практические примеры
1) Open-source стек для реального времени: PostgreSQL → Debezium CDC → Apache Kafka → Apache Flink → ClickHouse
- Ингест: Debezium подключается к PostgreSQL и публикует CDC-ивенты в Kafka. Каждый CDC-ивент отражает изменение строки в таблице (insert/update/delete).
- Шина и обработка: Kafka выступает транспортом; Flink подписывается на топики, выполняет обогащение и агрегацию в реальном времени (например, расчет показателей по окнам, обогащение’s dimension-таблицами).
- Хранение: результат отправляется в ClickHouse, который поддерживает быстрый аналитический запрос и горизонтальное масштабирование.
- Плюсы: хорошо подходит для построения лент изменений и полной истории изменений; высокий уровень экосистемы; возможность детальной аналитики через ClickHouse.
- Минусы: сложность настройки и мониторинга; требуется продвинутая операторская поддержка.
2) Пример сценария обработки кликов и событий пользователя
- Источник: фронтенд и мобильные клиенты публикуют события действий пользователей в Kafka.
- Преобразование: Spark Structured Streaming или Flink группируют события по пользователю и вычисляют показатели, такие как «время от первого клика до конверсии», «частота повторных визитов».
- Обогащение: подключение к dimension-данным в Redis или постгресе для контекстной информации о пользователях и рекламных кампаниях.
- Хранение: результат в ClickHouse, для аналитики в BI и отчётности в режиме реального времени.
- Риски: задержки сети, гетерогенность форматов; решение через схемы и единый формат событий.
3) Российские особенности и решения
- Хранилище и аналитика: ClickHouse (разработан и широко поддерживается в России; открытый код, активное сообщество и коммерческие поддержки). Пример использования: хранение событий и агрегаций, возможность быстрой фильтрации по времени и как данные группируются по сегментам.
- Управление данными и инфраструктура: PostgresPro как локальная дистрибуция PostgreSQL для производственных баз данных с поддержкой расширенного функционала и локализации.
- Яндекс и отечественные сервисы: Яндекс Data Streams или аналоги в рамках экосистемы Яндекс Облако — сервисы для потоковой передачи данных и интеграции, часто используемые российскими компаниями для устойчивой интеграции со стэком на базе ClickHouse и других решений.
- Применение в проектах: многие российские банки и телеком-компании применяют стек на основе Kafka + Flink + ClickHouse для реального времени и аналитики.
Техническая реализация и конфигурации
Kafka:
- Число брокеров, репликация и разделение: рекомендуется минимальный репликационный фактор 3 и количество разделов, пропорциональное объему нагрузки.
- Retention и compaction: для CDC-источников обычно используют логику compact-ing для ключевых изменений.
Debezium:
- Конфигурация коннектора: подключение к Source DB (PostgreSQL/MySQL), указание таблиц, исключение столбцов, которые не должны попадать в поток, включение логирования изменений.
- Резервное копирование и устойчивость: использование журналов и perioada.
Flink:
- Состояние и точность: state backend (RocksDB), частые checkpoint'и (например, каждые 5 минут), обработка событий с задержкой.
- exactly-once semantics: использование транзакционных sink-ов и флота.
ClickHouse:
- Хранение: использование таблиц типа MergeTree с разбиением по дате, TTL для удаления устаревших данных, настройка партитирования и индексов для ускорения запросов.
- Форматы: хранение в Parquet/ORC на стадии выгрузки, внутренние форматы эффективны для аналитических запросов.
Schema registry:
- Специализированные сервисы: Apicurio Registry или Confluent Schema Registry (часто встраиваются в стек) — позволяют валидировать события на входе и поддерживать совместимость при эволюции схем.
- Пример управления схемой: версионирование Avro схем, совместимость backwards/forwards, уведомление потребителей об изменениях схем.
Безопасность и доступ:
- TLS на транспортном уровне, авторизация в Kafka (ACL), контроль доступа к ClickHouse и БД, аудит операций.
Мониторинг и observability:
- Применение Prometheus + Grafana, OpenTelemetry для трассировки, логирование через ELK/EFK или Loki.
- Мониторинг задержек по стадиям конвейера: ingest, обработка, запись.
Рекомендации по проектированию и эксплуатации
- Начинайте с критичных сценариев: определите минимально необходимые показатели задержки и объём данных, чтобы спланировать масштабирование.
- Придерживайтесь единой модели данных: общие форматы событий, единая версия схемы и контролируемое изменение схем.
- Применяйте CDC там, где это возможно и выгодно: это снижает нагрузку на источники и поддерживает актуальность.
- Внедряйте идемпотентность на этапе потребления и записи в хранилище.
- Поддерживайте устойчивую архитектуру: резервирование, fallback-механизмы, повторная обработка и мониторинг.
- Обеспечьте безопасную эксплуатацию и соответствие требованиям: шифрование, управление секретами и аудит.
Риски и ограничения
1) Трудности управления временем и порядком событий
В потоках порядок событий может быть нарушен между разделами топиков или между разными конвейерами. Рекомендация: использовать ключи событий для сохранения последовательности в рамках одного ключа и применять оконную агрегацию, чтобы делать разрезы во времени, где порядок внутри окна важен.
2) Эволюция схем и совместимость
Часто схемы меняются; без регистного управления схемой можно получить несовместимые данные. Рекомендация: внедрить процесс версионирования схем и стратегию backward/forward compat, использовать registry.
3) Дубликаты и повторная обработка
При повторной отправке или неустойчивых соединениях возможна повторная обработка. Рекомендация: идемпотентные sink-операции, уникальные ключи событий, обработка повторных событий (dedup).
4) Поддержка задержек и задержки в конце конвейера
В реальности задержки могут накапливаться на любом этапе. Рекомендация: использовать backpressure, масштабирование, горизонтальное масштабирование компонентов, мониторинг задержек по стадиям.
5) Безопасность и соответствие
Объём данных может содержать конфиденциальную информацию; важно правильно настроить доступ, шифрование, журналы аудита и мониторинг действий.
6) Операционная сложность и требования к компетенции
Работа с потоковыми системами требует навыков в настройке брокеров, коннекторов, обработки и мониторинга. Рекомендация: поэтапно внедрять конвейеры, обучать команду и держать документированную архитектуру.
7) Зависимость от инфраструктуры и потенциальный vendor lock-in
Выбор сложного стека может привести к сильной зависимости. Рекомендация: строить модульный стек, использовать открытые форматы данных и практики, которые можно перенести между стеками.
8) Масштабирование и стоимость
Рост объема данных приводит к росту стоимости хранения, трафика и вычислений. Рекомендация: планировать масштабирование заранее, выбор оптимальных форматов и компрессии, применение кэширования и эффективной агрегации.
9) Качество данных и мониторинг
Неправильные данные, пропуски, несогласованность метаданных могут нивелировать ценность конвейера. Рекомендация: внедрить пайплайн верификации качества на входе и на выходе, строить прикладные правила очистки.
10) Совместное использование локальных и облачных сервисов
Миграции или гибридные решения добавляют сложность в сетевых соединениях и политики доступа. Рекомендация: створить стандартную политику безопасности, согласовать сетевые и управляемые политики.
Архитектура конвейеров на потоках играет ключевую роль в современных системах хранения и аналитики данных на основе EDA. Правильная реализация обеспечивает минимальные задержки, устойчивость к сбоям, масштабируемость и возможность оперативного принятия решений на основе актуальных данных. Важны выбор технологий, согласование схем данных, продуманное управление версиями и мониторинг. При построении конвейера следует учитывать паттерны CDC, event sourcing, выбор между Lambda и Kappa архитектурами, а также особенности российского рынка и инструментов, где в качестве опорной базы часто выступает ClickHouse как надёжное и производительное аналитическое хранилище, а стек может включать Debezium, Kafka, Flink, и регистр схем для устойчивого эволюционирования данных. Реализация должна сопровождаться чётким планом мониторинга, тестирования и документирования, чтобы снизить операционные риски и обеспечить долгосрочную устойчивость проекта.
FAQ — Вопрос–Ответ
1) Что такое конвейер на потоках и чем он отличается от традиционной пакетной обработки?
Конвейер на потоках обрабатывает данные по мере их поступления и стремится минимизировать задержку от источника до целевой системы. Пакетная обработка собирает данные за фиксированные интервалы и затем выполняет анализ. Потоковая архитектура позволяет реагировать на события в реальном времени, в то время как пакетная обработка может быть более эффективной для больших объемов и сложной агрегации без требований к мгновенной актуализации.
2) Что означает CDC и зачем он нужен в конвейере?
CDC (Change Data Capture) — это технология отслеживания изменений в источнике данных и передачи изменений в конвейер в виде событий. Она позволяет получать актуальные данные без полного повторного чтения базы, уменьшает нагрузку на источники и ускоряет обновление целевых хранилищ.
3) Какие инструменты чаще всего применяются в open-source стеке и почему?
Часто применяются Apache Kafka (шина сообщений), Debezium (CDC коннектор), Apache Flink (потоковая обработка), Apache Spark Structured Streaming (поточная аналитика), Apache NiFi (интеграция потоков), Apache Avro/Protobuf (форматы схем). Эти инструменты хорошо документированы, поддерживаются крупными сообществами и легко масштабируются.
4) Какие российские решения и локальные практики можно использовать в таком конвейере?
В качестве хранилища часто выбирают ClickHouse — российское происхождение и открытый код, оптимизирован для аналитических запросов. В рамках инфраструктуры — PostgresPro (российская дистрибуция PostgreSQL). В рамках облачных сервисов возможны отечественные решения и сервисы Яндекс Облака, а также использование локальных решений для соответствия требованиям и безопасности.
5) Какие ключевые риски предъявляет организация потокового конвейера?
Основные риски — задержки и пропуски, дубликаты и повторная обработка, несовместимость схем, безопасность и соответствие требованиям, операционная сложность, а также возможная зависимость от конкретного стека. Важно планировать мониторинг, обработку ошибок, регламентировать схему данных и тестировать конвейеры под нагрузкой.
6) Как обеспечить гарантию надёжности обработки (exactly-once) в реальном времени?
Для достижения exactly-once применяется идемпотентная обработка на стороне потребителя и транзакционные sink'и, совместимые с системой хранения. В Kafka можно использовать транзакции, в Flink — stateful processing с контрольными точками (checkpoints) и точной семантикой выхода.
7) Какие методики можно применить для эволюции схем без остановки конвейера?
Использование schema registry для версионирования схем и согласование совместимости, проведение деградации схем, тестирование новых версий на неактивных конвейерах, поддержка backward и forward совместимости, а также миграции данных и тестирование с «плавающей» схемой.
8) Как обеспечить observability и мониторинг конвейера?
Необходимо собирать метрики на каждом этапе (ингест, обработка, запись), использовать трассировку (OpenTelemetry), логи и дашборды в Grafana/Prometheus. Важно регламентировать алерты по задержкам, объему загрузки и количеству ошибок.
9) Какие факторы надо учитывать при выборе стека для проекта в России?
Важны требования к локализации, безопасности и соответствию регуляциям, поддержка отечественных технологий и сервисов, активность сообщества, доступность квалифицированных специалистов, а также интеграция с локальными решениями, такими как ClickHouse и PostgresPro.
10) Какие практические шаги помогут начать проект конвейера на потоках?
Определить главный сценарий использования и требования к задержке, выбрать базовый стек (например, Kafka + Debezium + Flink + ClickHouse), разобраться с CDC источниками и схемами, внедрить регистр схем, настроить мониторинг и алертинг, начать с пилота на ограниченном объёме данных, затем масштабировать и оптимизировать.


