

ClickHouse и видеоаналитика
Уроки, извлеченные в процессе реализации проекта по миграции видеоаналитики с одной СУБД на другую.
Видеоаналитику используют миллионы пользователей Vimeo - от индивидуальных создателей контента до крупных компаний. Благодаря информации о потребителях и используемых ими методах работы с видео мы можем сформировать всестороннее представление о моделях просмотра сотен миллионов видео, «гуляющих» в Интернете. Получая данные в режиме реального времени, наша аналитическая платформа ежедневно обрабатывает более миллиарда событий журнала просмотров видеоматериала.
В этой статье я хотел бы рассказать Вам о нашем опыте перехода с традиционной архитектуры, основанной на Apache Phoenix и HBase на ClickHouse. Проект был реализован примерно 1,5 года назад. По ходу повествования я поделюсь с Вами ключевыми выводами, а также и советами по оптимизации данного процесса. Обещаю, будет интересно!
Что такое видеоаналитика?
Видеоаналитика разбивается на пользовательские сессии. Эти сессии целесообразно рассматривать как индивидуальный опыт просмотра видео, характеризуемый такими параметрами, как устройство просмотра, местоположение пользователя и источник информации. Благодаря этим данным мы можем определить , чтобы получить такие показатели просмотра, как количество просмотров, время просмотра и т.д. У одного пользователя может быть один или несколько сеансов просмотра видеоматериала - он может посмотреть часть видео, поставить его на паузу, вернуться к нему чуть позже или даже спустя несколько дней и месяцев.
На бэкенде мы фиксируем микрособытия, которые формируют каждый сеанс в режиме реального времени: воспроизведение и загрузку видео, а также действия пользователя. Эти данные позволяют нам определять надежные видеометрические показатели, агрегируя их на любом временном интервале и уточняя с помощью огромного количества собираемых нами метрик.
Над решением каких проблем мы работаем?
В течение нескольких лет наша платформа работала с наиболее распространенными БД: HBase (БД типа «ключ-знание»), Hadoop JVM и Apache Phoenix. Такие решения довольно популярны в аналитической сфере, в частности это присуще таким платформам, как BigQuery.
Сначала все работала отлично, но, по мере того, как наши потребности и аппетиты росли, начали возникать различные проблемы. С увеличением количества пользователей платформы и расширением аналитических возможностей мы столкнулись с такими неприятностями, как зависание HBase Garbage Collection, сбои в работе региональных серверов и регулярные таймауты запросов. Наши корпоративные и даже не корпоративные пользователи не могли получить всю необходимую им информацию, система еле-еле справлялась с огромным количеством запросов... Баланс между производительностью системы и расходами на ее обслуживание нарушился - масштабирование стало непомерно дорогим, а рентабельность инвестиций стабильно снижалась.

Оценка возможных альтернатив
Есть такая поговорка: “Не чини того, что не сломано”. В нашем случае все было с точностью да наоборот. Наша система аналитики разваливалась, и, учитывая наши обязательства по соблюдению SLA/SLO, мы были просто обязаны провести модернизацию системы.
Так было принято решение о поиске альтернативы используемым решениям и технологиям.
В результате всестороннего исследования, исходя из наших требований в краткосрочной и долгосрочной перспективах, мы остановились на базах данных OLAP. Что нас интересовало?
- Компрессия. Может ли система эффективно обрабатывать петабайты журналов сеансов?
- Производительность обработки запросов. Удовлетворяет ли решение текущие и будущие требования к скорости и эффективности обработки запросов?
- Пропускная способность. Способна ли система управлять более чем 1 миллиардом событий журнала сеансов ежедневно?
- Удобство использования и обслуживания. Есть ли у решения активное сообщество, готовое в любую минуту прийти на помощь?
- Инфраструктура. Сможет ли решение удовлетворить наши требования по целому ряду критериев, от процессоров и памяти до совместимости с Kubernetes
- Экономическая эффективность. Безусловно, все вышеперечисленные критерии очень важны, но не стоит забывать и о разумном соотношение «цена - качество» с учетом роста наших потребностей в долгосрочной перспективе.
В результате исследования мы сузили круг поиска до четырех решений, которые наилучшим образом соответствовали нашим ожиданиям. В наш шорт-лист вошли Apache Druid, MemSQL/SingleStoreDB, улучшенная HBase, а также ClickHouse
Для тестирования работы каждого кандидата мы использовали 25 % наших данных, мы протестировали результативность обработки больших массивов данных, обычную нагрузку на обработку запросов пользователей, а также экстремальные нагрузки. Кроме того, мы оценили производительность запросов с помощью квантилей для того, чтобы получить полное представление о спектре запросов, с которыми может справиться каждый кандидат - от легких до достаточно сложных. Мы оценили эффективность хранения данных, их загрузки в режиме реального времени, а также протестировали системы на предмет устойчивости к сбоям, потерям данных, возможности резервного копирования и т. д.
Оценив каждую систему по ряду важных для нас критериев (от эффективности обработки запросов до затрат), мы выбрали Clickhouse, безоговорочного лидера нашего шорт-листа. Он удивил нас своими результатами по нескольким критериям оценки и оказался наиболее выгодным с точки зрения затрат. На обработку запросов у Clickhouse уходило чуть меньше времени, чем у других претендентов. Кроме того, он больше всего подошел нам с точки зрения возможностей по хранению данных (исходя из нашего объема данных).
Установка инфраструктуры ClickHouse на Kubernetes
Мы отслеживаем данные о сессиях, начиная с 2007 года (каждый год проходит более 100 млрд сессий). Общий объем аналитических данных, с которыми мы работаем, исчисляется в петабайтах.
И как же Вы все это храните?!
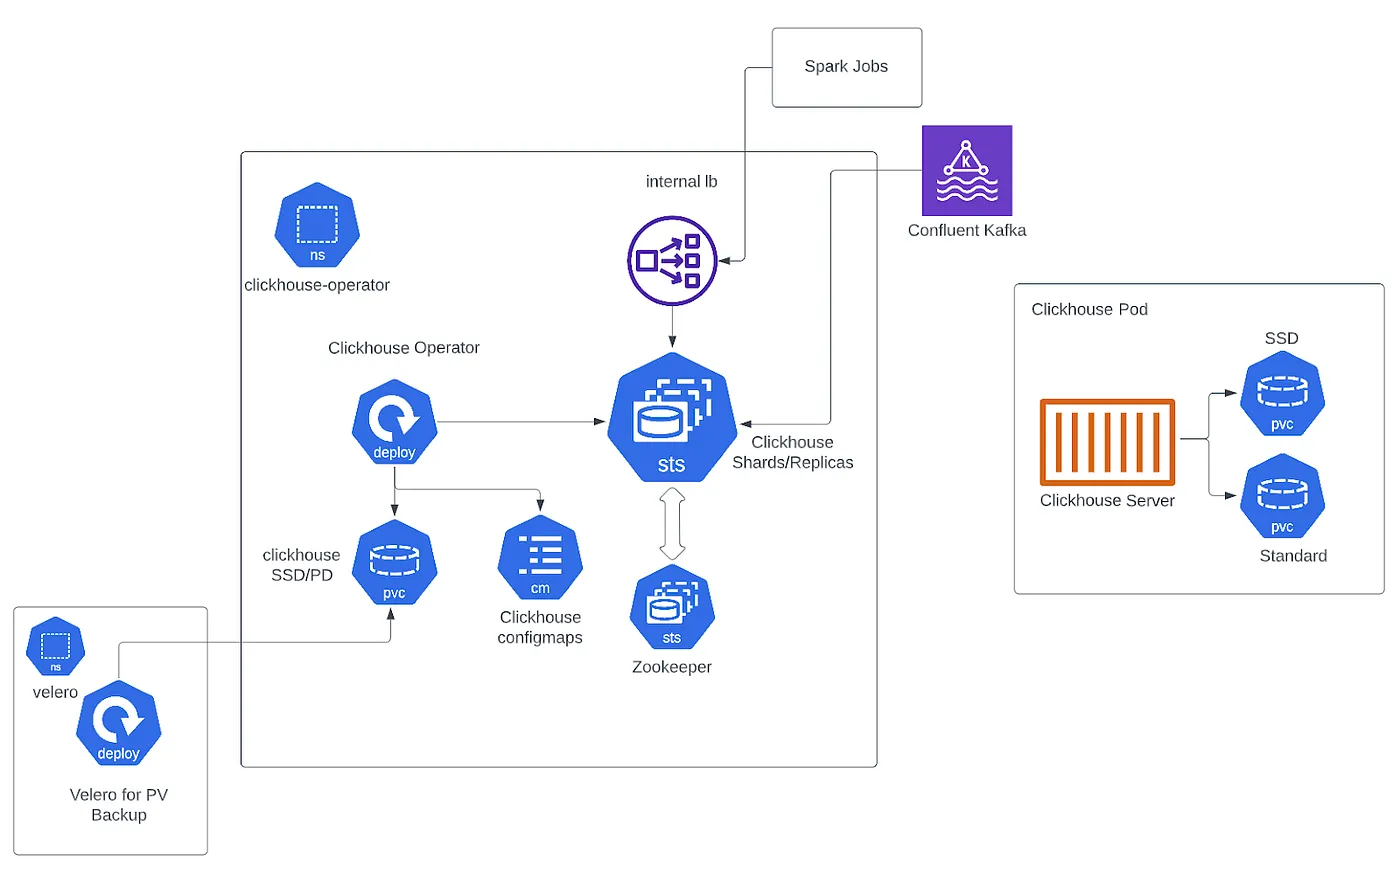
В любой распределенной системе, подобной ClickHouse, отказоустойчивость является обязательным условием. Как этого можно достичь? С помощью как минимум одной дополнительной реплики. Как повысить скорости чтения и записи? В этом случае на помощь приходит шардинг, распределяющий работу между несколькими экземплярами ClickHouse. В нашем случае у нас есть кластер ClickHouse с десятками шардов (не так уж и много, как Вы могли бы подумать) и двумя репликами. Добавьте к этому несколько терабайт постоянного диска, 500 ГБ твердотельных накопителей и поддержку пяти узлов Apache ZooKeeper, и мы в дамках - готовы к аналитике данных на все 200 %!
Звучит круто, но как Вы сможете все это развернуть?
Мы используем ClickHouse operator для Kubernetes от компании Altinity, который контролирует создание, обновление, настройки и управление кластером ClickHouse на Kubernetes. С его помощью можно виртуозно управлять изменениями, связанными с POD, конфигурациями серверов, правами доступа пользователей и т.д. Мы развернули ClickHouse на Google Cloud Platform, используя специальные настройки. Одним из важнейших условий было обеспечение постоянного пространства для журналов транзакций, необходимого для быстрого восстановления системы после перезапуска.
А это все можно еще как-то улучшить?
Безусловно. ClickHouse предоставляет возможность вносить изменения в файлы конфигурации в зависимости от Ваших потребностей. Одним способом оптимизации затрат и производительности системы является использование многоуровневых политик хранения данных. Каждую таблицу семейства MergeTree можно связать с определенной политикой хранения, описывающей то, как и где хранятся Ваши данные, и определяющей порядок операций чтения в рамках того или иного объема данных (см. рисунок 3). MergeTree в ClickHouse – это семейство движков, предназначенных для вставки огромных массивов данных.
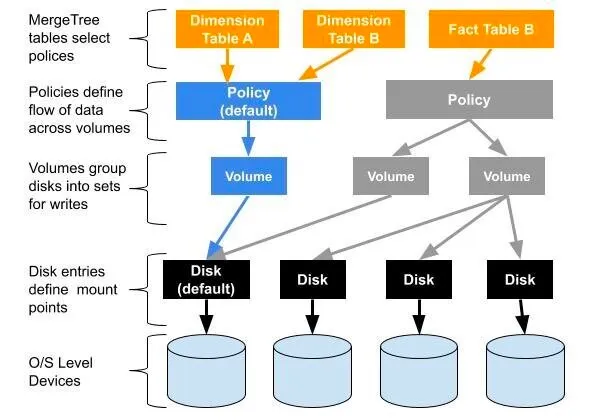
Для оптимизации расходов и повышения производительности системы «свежие» данные можно направить на твердотельные накопители (которые стоят дороже), а старые данные можно направить на менее дорогие и чуть менее производительные диски.
Поглощение данных: что это такое и как это происходит?
Прежде чем перейти к моделированию данных, предлагаю рассмотреть типы данных, которые мы «заливаем» в ClickHouse , а также поговорить о том, как мы это делаем.
Что такое поток данных
Наша система заполнена несколькими событиями, происходящими в рамках сессии: загрузки, проигрывания видео, окончание просмотра и взаимодействие пользователей. Чтобы повысить производительность обработки запросов и хранения данных, мы отправляем разницу, или дельты, этих сессий по мере поступления событий. Короче говоря, такие показатели, как общее время просмотра, передаются по частям.
В качестве примера возьмем 90-секундный сеанс просмотра видео: вместо одной 90-секундной точки данных передаются три части по 30 секунд, в результате чего мы получаем те же самые 90 секунд.
Роль Apache Spark
Учитывая тот факт, что поддержка ACID-требований к транзакциям в ClickHouse пока является экспериментальной, нам пришлось дорабатывать наши конвейеры обработки данных. Здесь на помощь пришел Apache Spark, который помог нам вычислять и отправлять дельты для обновления показателей. В Apache Spark 3.3 для хранения изменений каждой сессии и отправки дельт в ClickHouse мы создали структурированные потоковые задания. Результат? Упрощенные запросы и более высокая скорость их обработки без необходимости писать сложные подзапросы.
Как мы вставляем данные в столбцы?
Используя таблицы типа null. При записи данных в таблицу null данные не сохраняются, поэтому мы направляем их прямо из заданий Spark через JDBC в конечную точку балансировщика нагрузки.
Пример таблицы типа null:
CREATE TABLE vimeo.session_event_ingestion ON CLUSTER analytics
(
    video_owner_id UInt32,
    event_ts UInt64,
    video_id UInt32,
    session_id String,
    country Nullable(FixedString(2)),
    device Nullable(String),
    source_domain Nullable(String),
    ...
    live Nullable(UInt8),
    ...
    )
    ENGINE = Null;
Помимо механической стороны вопроса мы используем материализованные представления, добавляемые в таблицу распределенного движка с помощью разделения ключей для оптимального распределения данных в ClickHouse. Такая настройка позволяет ClickHouse эффективно распределять данные, освобождая конвейер от необходимости обработки всех нюансов распределения.
Поглощение данных – это легкий процесс или сложный?
Поглощение данных - это не просто их перемещение. Это еще и очередь репликации, потенциальное дублирование данных с целью минимизации рисков, связанных со сбоями работы конвейеров по обработке данных конвейере. Для борьбы с потенциальным дублированием данных мы используем настройкуinsert_deduplicate=1, обеспечивающую уникальность данных.
Каждая вставка данных в таблицы (за исключением таблиц типа null) создает серию. Частые вставки в течение короткого промежутка времени могут привести к появлению чрезмерного количества частей, что, в свою очередь, может перегрузить очередь репликации и поставить под угрозу стабильность работы всего кластера. Баланс между размером серий, который влияет на память и производительность, и их количеством крайне важен, особенно если это существенно влияет на очередь репликации и работу ZooKeeper.
Моделирование данных и оптимизация данного процесса
Вот здесь-то и раскрывается вся магия ClickHouse. Вы можете выбирать движки таблиц, конфигурации, схемы, гранулярность индексов, TTL и ключи исходя из Ваших потребностей. Тонкая настройка всех этих компонентов может значительно повысить эффективность работы системы и при этом не допустить роста затрат. На рисунке, расположенном ниже, показана упрощенная диаграмма таблицы типа null, которая разветвляется на множество таблиц, ориентированные на потребности пользователей.
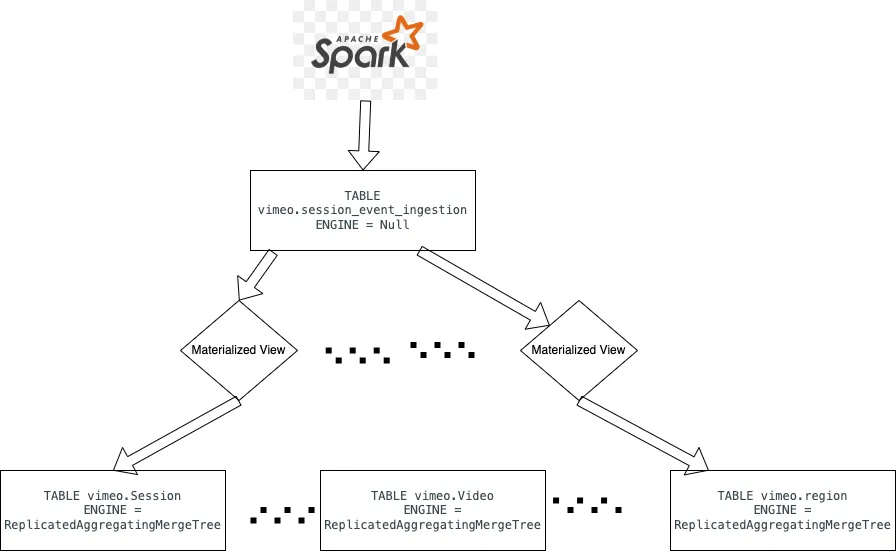
Наша модель включает в себя таблицы, сформированные исходя из категорий сессий, видео и другим ключевым параметрам. Кроме того, мы ведем комплексную сводную таблицу по видео.
Ok, а движок-то какой?
Очевидно, что мы предпочитаем использовать движки семейства MergeTree. В частности для плавного объединения событий в сессии, распределенные между шардами и репликами по ключу шардинга, мы используем механизм ReplicatedAggregatingMergeTree.
CREATE TABLE vimeo.session_local ON CLUSTER analytics
(
    video_owner_id UInt32 ..,
    video_id UInt32 ..,
    event_ts  DateTime ..,
    view_time SimpleAggregateFunction(sum, Int64)....,
    views SimpleAggregateFunction(sum, Int64) ...,
    ....
    )
    ENGINE = ReplicatedAggregatingMergeTree
    PARTITION BY ..
    PRIMARY KEY ...
    ORDER BY ...
    TTL ts + ... DELETE
SETTINGS index_granularity = ...;
Эти события или серии ClickHouse в конечном итоге объединяются на основе функций, указанных для каждого столбца.
Важность таблицы распределения сложно переоценить. Эффективное распределение данных по машинам и минимизация перекосов (что часто встречается даже у самых опытных пользователях) – задача не из легких. Соблюдение этого баланса напрямую влияет на производительность обработки запросов и функционирования хранилища данных. Слишком сильная диверсификация данных может привести к перегрузке очереди репликации, увеличению количества сетевых переходов и снижению производительности обработки запросов. Соблюдение этого баланса становится еще более важным в случае распределения данных на основе логических ключей: оптимальное распределение позволяет запрашивать меньшее количество шардов, что ускоряет процесс поиска данных.
CREATE TABLE vimeo.session ON CLUSTER analytics AS vimeo.session_local
    ENGINE = Distributed(analytics, vimeo, session_local, cityHash64(video_owner_id,toStartOfHour(event_ts)));
Что еще можно сделать?
Процесс настройки ClickHouse под наши потребности научил нас тому, что крайне важно обращать внимание и учитывать каждую деталь. Это особенно верно при оптимизации хранения и поиска данных.
Одним из наших ключевых решение стало сжатие размера столбцов. Существует множество алгоритмов сжатия, таких как DoubleDelta, Delta и Gorilla; например, CODEC(ZSTD(1)). Кстати, Gorilla отлично подходит для работы с временными рядами. Однако учтите, что выбор алгоритма во многом будет зависеть от природы данных - их важности и «поведения» с течением времени.
Если в сфере производительности обработки запросов есть такое понятие, как высший пилотаж, то это искусство разбиения на разделы и выбора ключей:
- PARTITION BY. Речь идет о взаимосвязанности данных. Одна партиция в идеале должна охватывать 1-300 ГБ данных (или от 400 МБ до 40 ГБ для определенных агрегаций). Стремитесь к тому, чтобы одиночные вставки заполняли одну или несколько партиций, а типичные запросы SELECT затрагивали минимальное количество партиций. Чем меньше партиций, тем лучше;
- ORDER BY и PRIMARY KEY. Их расположение имеет очень большое значение. Выбирайте от одного до четырех столбцов, организованных по кардинальности - от наименьшего к наибольшему. Золотое правило? Столбцы, которые чаще всего запрашиваются и фильтруются, должны быть на первом месте. В ClickHouse порядок напрямую влияет на эффективность объединения данных, поэтому это ключевой аспект, который необходимо настроить для достижения оптимальной производительности.
Пример:
CREATE TABLE vimeo.session_local ON CLUSTER analytics
(
    video_owner_id UInt32 CODEC(ZSTD(1)),
    video_id UInt32 CODEC(ZSTD(1)),
    event_ts  DateTime CODEC(ZSTD(1)),
    view_time SimpleAggregateFunction(sum, Int64) CODEC(ZSTD(1)) TTL ts + INTERVAL 1 MONTH,
    views SimpleAggregateFunction(sum, Int64) CODEC(ZSTD(1)) TTL ts + INTERVAL 1 MONTH,
    ....
    )
    ENGINE = ReplicatedAggregatingMergeTree
    PARTITION BY toMonth(ts)
    PRIMARY KEY (video_owner_id, toStartOfDay(event_ts), video_id)
    ORDER BY (video_owner_id, toStartOfDay(event_ts), video_id, event_ts)
    TTL ts + toIntervalYear(1) DELETE
SETTINGS index_granularity = 8192
На производительность и скорость выполнения операций чтения/записи могут влиять и другие параметры, например, гранулярность индекса.
А не пропустили ли мы еще что-то важное?
Материализованные представления ClickHouse, которые похожи на триггеры вставки, являются поистине революционными. Действуя в режиме реального времени, они объединяют группы строк из только что вставленных частей и направляют их в отдельные таблицы. Эти представления выходят на первый план, когда перед ними ставится задача предварительной агрегации данных. Результат? Умопомрачительная производительность запросов, достигаемая за счет обработки меньшего количества предварительно агрегированных строк данных.
Чтобы использовать весь потенциал материализованных представлений, используйте следующие методы оптимизации данных:
- Тип данных. Для измерений, содержащих менее 10 000 уникальных значений, используйте тип данных LowCardinality.
- Индекс H3. Работаете с географическими координатами? Преобразуйте широту и долготу в лаконичный H3 индекс с помощью функции geoToH3.
- Оптимизация UUID. Для UUID-строк не целесообразно использовать собственный тип UUID.
- Хеширование строк. Длинные строки лучше преобразовывать в целые числа с помощью функций типа sipHash64.
- Сжатие шестнадцатеричных строк. Длинные шестнадцатеричные строки? Уменьшите их размер вдвое с помощью таких функций, как unhex
Сколько методов оптимизации, перечисленных выше, Вы сможете найти в следующем примере?
CREATE MATERIALIZED VIEW vimeo.session_mv ON CLUSTER analytics TO vimeo.session
    AS
SELECT
    video_owner_id,
    video_id,
    fromUnixTimestamp(toUInt64(event_ts/1000)) AS event_ts,
    session_id,
    toLowCardinality(coalesce(country, '')) AS country,
    coalesce(geoToH3(longitude, latitude, 15), 0) AS h3Index,
    coalesce(domainWithoutWWW(referer),'') AS source_domain,
    ....
    toUUIDOrZero(lead_id) AS lead_id,
    if(coalesce(viewer_unique_id,'') = '', 0, sipHash64(viewer_unique_id)) AS viewer_unique_id,
   ....
FROM vimeo.session_event_ingestion;
А что насчет уникальности?
Решение проблемы уникальности в крупномасштабных системах баз данных, как известно, требует особого внимания. В качестве незаменимого помощника компания ClickHouse предлагает утилиту HyperLogLog. Как ее использовать:
- Вместо строк преобразуйте данные в беззнаковые целые числа с помощью функций хэширования, например sipHash64;
- Преобразуйте беззнаковые целые числа в HyperLogLog с помощью команды uniqCombinedState(num). Здесь num отображает точность HyperLogLog, которая по умолчанию равна 17.
Для таблицы ReplicatedAggregatingMergeTree обозначьте уникальный столбец как AggregateFunction(uniqCombined(15),Nullable(UInt64)). В данном случае UInt64 соответствует исходному типу столбца, например num=15.
А что насчет преобразования материализованного представления? При сопоставлении с state(uniqCombinedState(15)) в вашем материализованном представлении это должно выглядеть примерно так:
CREATE MATERIALIZED VIEW vimeo.video_summary_mv ON CLUSTER analytics TO vimeo.video_summary AS
SELECT
    video_owner_id,
    video_id,
    sum(views) as views,
    ..
    uniqCombinedState(15)(sipHash64(viewer_unique_id)) AS uniqe_views
FROM vimeo.session_event_ingestion
GROUP BY
    video_owner_id,
    video_id
Этот процесс переводит Ваши данные в состояние HyperLogLog. Во время последующих операций агрегированная таблицы объединит эти состояния.
А как насчет запроса к таблице уникальности? Чтобы извлечь данные из этой таблицы, выполните следующие действия:
select ...,uniqCombinedMerge(15)(uniqe_views) as uniqe_views
from vimeo.video_summary
where ....
Миграция и архивирование данных
Перенос данных из полностью функционирующего кластера HBase сопряжено с рядом трудностей. Наша стратегия бесперебойную работу системы. Наш лайфхак заключался в архивировании HF-файлов HBase в более удобный формат Parquet.
Затем для получения данных из этих файлов Parquet мы использовали HDFS-движок ClickHouse. Этот процесс включал в себя выборку данных и их вставку в таблицы типа null, содержащие материализованные представления для облегчения проведения необходимых преобразований:
clickhouse-client --receive_timeout=180000
-q """ insert into vimeo.session_event_ingestion
       SELECT video_owner_id, ....
       FROM hdfs('hdfs://hostname:8020/tmp/table_dir/*/*/*/*/*','Parquet',
         video_owner_id UInt32, event_ts UInt64, video_id UInt32, session_id String, ...') """
Учитывая возможность тайм-аута при больших операциях с файлами Parquet, мы разделили наши данные на более мелкие и управляемые файлы, размером до нескольких гигабайт каждый. Такая сегментация позволила нам программно получать данные систематическими этапами. В тех случаях, когда возникали несоответствия данных или запросы не выполнялись, мы принимали меры по исправлению ситуации, либо отменяя и заново загружая данные, либо используя словари ClickHouse для обновления.
Оптимизация запросов
Наш основной метод запроса к ClickHouse – использование его интерфейс JDBC. Одна из проблем, с которой мы столкнулись, - это слияние частей в ClickHouse, особенно в агрегированных таблицах слияния. Однако, используя альтернативные шаблоны запросов, мы справились с ними достаточно быстро.
Для повышения скорости обработки запросов мы внедрили два параметра:
- os_thread_priority =-10 - определяет приоритетность потока запросов от -20 (самый высокий) до 19 (самый низкий).
- optimize_skip_unsused_shards=1 - позволяет пропускать неиспользуемые шарды для запросов select, основанных на пенвичном ключе шардинга.
Эти доработки позволили приоритизировать наши запросы, отодвинув другие запросы на второй план, оптимизируя работу с ClickHouse.


