

Как работают первичные ключи Clickhouse
Система индексирования и хранения данных Clickhouse довольно сложная, что обеспечивает непревзойденную производительность СУБД. При создании таблицы MergeTree в первую очередь необходимо выбрать первичный ключ, который как раз и будет влиять на производительность большинства аналитических запросов. Как работают эти первичные ключи? Как выбрать наиболее подходящий? Давайте разбираться вместе!
Указываем первичный ключ
Каждая таблица MergeTree может иметь только один первичный ключ, который должен быть указан при создании таблицы:
CREATE TABLE test
(
    `dt` DateTime,
    `event` String,
    `user_id` UInt64,
    `context` String
)
ENGINE = MergeTree
PRIMARY KEY (event, user_id, dt)
ORDER BY (event, user_id, dt)

В данном случае мы создали первичный ключ для 3 столбцов в следующем порядке: event, user_id, dt. Обратите внимание на то, что первичный ключ должен быть таким же, как и ключ сортировки (заданный выражением ORDER BY) или представлять собой его префикс.
Ключ сортировки определяет порядок, в котором данные будут храниться на диске, а первичный ключ определяет то, как данные будут структурированы для выполнения запросов. Обычно они совпадают (в этом случае Вы можете опустить выражение PRIMARY KEY, Clickhouse возьмет эту информацию из выражения ORDER BY).
Гранулы
Clickhouse логически разделяет каждый набор данных на группы или гранулы:
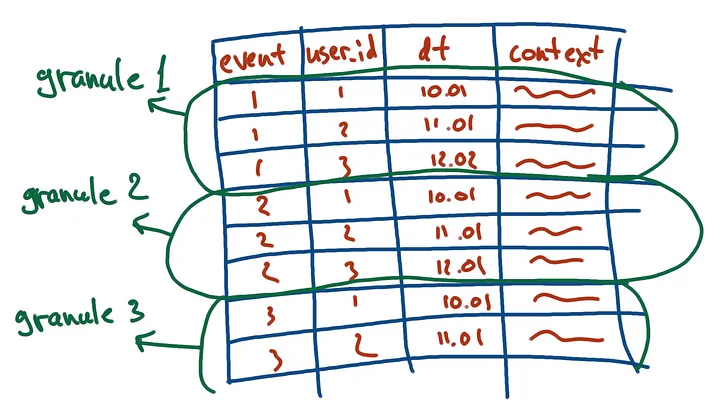
Количество гранул определяется автоматически в зависимости от настроек таблицы. По умолчанию размер гранулы составляет 8192 записи, поэтому количество гранул для нашей таблицы будет равно:
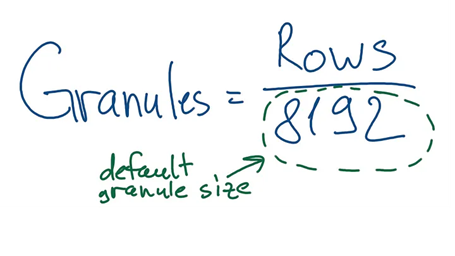
Гранула – это что-то вроде виртуальной «минитаблицы» с небольшим количеством записей (по умолчанию 8192), которые являются подмножеством всех записей основной таблицы.
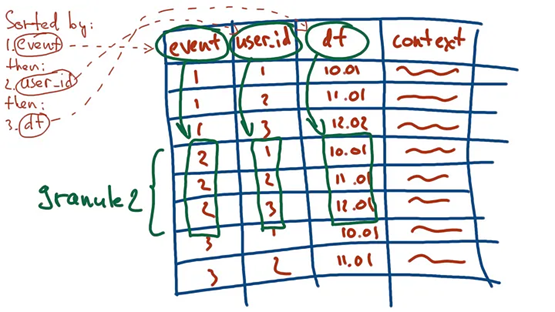
Каждая гранула хранит в себе строки в отсортированном порядке, который определяется при создании таблицы выражением ORDER BY:
Первичные ключи и индексы
Первичный ключ хранит только первую строку каждой гранулы:
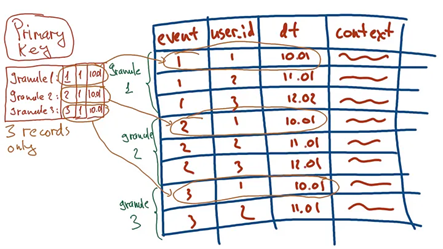
Именно поэтому Clickhouse работает так быстро. Вместо того чтобы хранить все значения, он сохраняет только их часть, именно поэтому первичные ключи такие короткие. Вместо того, чтобы искать отдельные строки, Clickhouse сначала находит гранулы, а затем выполняет их полное сканирование (что очень эффективно ввиду небольшого размера каждой гранулы)
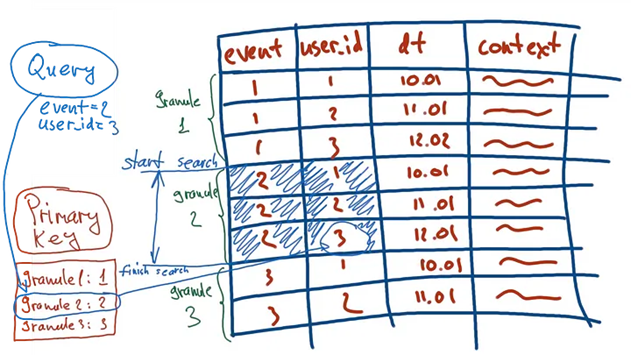 :
Производительность запросов
Занесем в нашу таблицу 50 млн случайных записей:
INSERT INTO test
SELECT * FROM generateRandom(
  'dt datetime, event Text, user_id UInt64, context Text'
) LIMIT 50000000;
Как указано выше, первичный ключ нашей таблицы состоит из 3 столбцов:
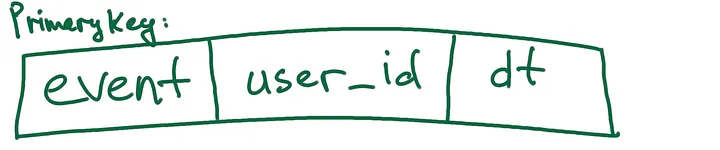
Clickhouse сможет использовать первичный ключ для поиска данных, если в запросе мы будем использовать столбец (столбцы), входящий в его состав:
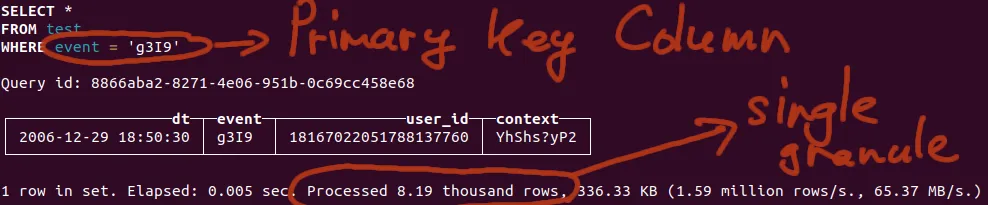
Итак, в результате поиска по определенному значению столбца мы получили только одну гранулу, что можно подтвердить с помощью EXPLAIN:
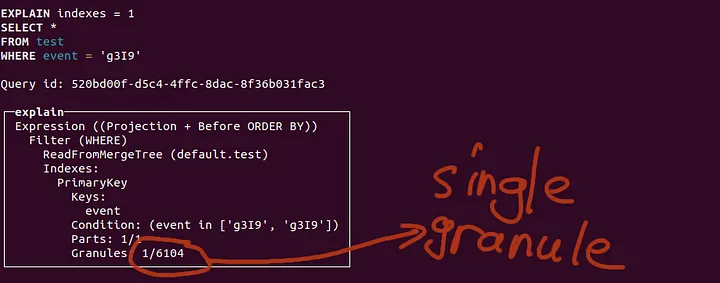
Так произошло потому, для фильтрации релевантных гранул вместо сканирования всей таблицы Clickouse использовал только индекс первичного ключа. Мы также можем использовать в запросах несколько столбцов из первичного ключа:
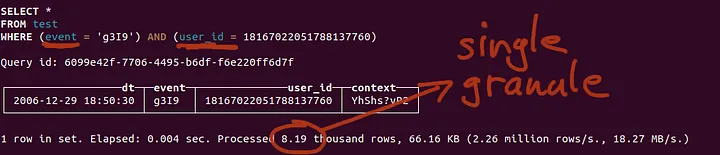
Если мы будем использовать столбцы, не входящие в состав первичного ключа, то для того, чтобы Clickhouse мог найти интересующие нас данные, ему придется просканировать всю таблицу:
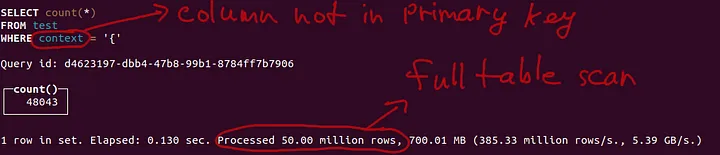
В то же самое время, если мы будем использовать столбец(ы) из первичного ключа, но пропустим начальный столбец(ы), Clickhouse не сможет полностью использовать индекс первичного ключа:
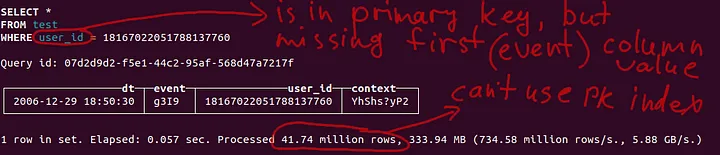
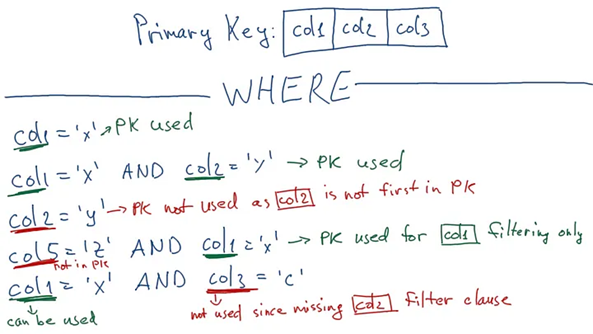
В каких случаях используется индекс первичного ключа
Clickhouse использует индекс первичного ключа в следующих случаях:
- Запрос WHERE или ORDER содержит первый столбец первичного ключа.
- Запрос WHERE содержит первые X столбцов первичного ключа, а ORDER (если есть) - следующие столбцы первичного ключа.
- Запрос WHERE содержит все столбцы первичного ключа.
В других случаях для того, чтобы найти искомые данные, Clickhouse придется просканировать всю таблицу.
Заключение
Учитывая тот факт, что Clickhouse использует высокоинтеллектуальную систему структурирования и сортировки данных, правильный выбор первичного ключа поможет сэкономить ресурсы и существенно повысить производительность запросов. При выборе столбцов первичного ключа следуйте нескольким простым правилам:
- Выбирайте только те столбцы, которые планируете использовать в большинстве запросов;
- Определите порядок, который будет охватывать большинство случаев частичного использования первичного ключа (например, в запросе используется 1 или 2 столбца, а первичный ключ содержит 3).
- Если Вы не уверены, используйте сначала столбцы с низкой кардинальностью, а затем - столбцы с высокой кардинальностью. Благодаря этому сжатие данных пройдет более эффективно.


