

Методы обнаружения аномалий: статистика, машинное обучение и правила
В рамках дисциплины Data Observability наблюдение за качеством, доступностью и доверием к данным требует системного подхода к идентификации аномалий. Аномалия в данных может проявляться как единичная выбросная точка, как временная всплеска значения или как неконсистентная связь между несколькими признаками. Эффективная детекция должна сочетать статистические методы, машинное обучение и правила делегирования ответственности, обеспечивая как оперативность реакции, так и интерпретируемость решений. В данной главе рассматривается синергия трёх подходов, их архитектурные принципы, требования к данным, а также практические схемы внедрения в производственные пайплайны.
Аномалии нельзя рассматривать как абстрактную математическую конструкцию вне контекста бизнес-логики и цикла данных. Разделение по уровням наблюдаемости — точечная, контекстная и коллективная аномалия — позволяет формализовать сигналы тревоги, согласовать их с целями сервиса и задать корректные пороги. Современная архитектура обнаружения аномалий должна быть встроена в общий конвейер наблюдения за данными: от источника данных и схемы до обработки, валидации и оповещения, включая обратную связь от бизнес-подразделений и корректировку моделей.
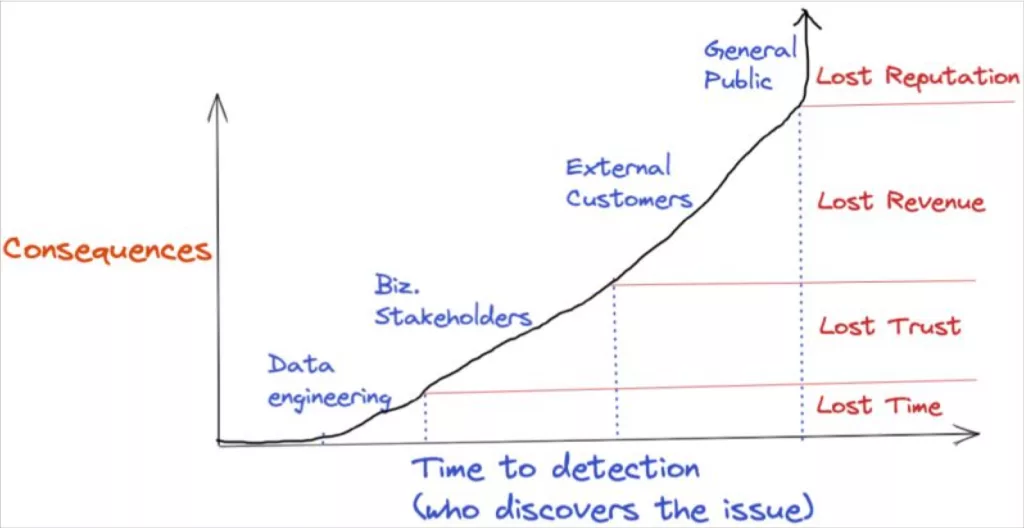
Краткое содержание главы
- Понимание типов аномалий, их влияния на бизнес-кейсы и выбор сигналов измерения.
- Архитектура пайплайна обнаружения: источники, обработка, хранение признаков, детекторы, алерты и обратная связь.
- Статистические методы: когда применяются, как строятся пороги, как учитывается многомерность и устойчивость к выбросам.
- Машинное обучение: выбор моделей, процессы обучения, мониторинг дрейфа концепций и внедрение в продакшн.
- Правила и политики: пороговые схемы, сигнатуры аномалий, управление изменениями и поддержка аудита.
- Интеграции и эксплуатация: интеграции с системами мониторинга, данными контрактами и котролируемыми выпусками.
- Прозрачность, аудит и доверие: объяснимость моделей, учёт регуляторных требований и управление изменениями.
Контекст и определения аномалий
Аномалия в контексте Data Observability — это наблюдаемое отклонение от ожидаемого поведения данных, заданного как бизнес-правила, статистической моделью или исторической базой. Типы аномалий чаще всего делят на три категории:
- Точечные аномалии (point anomalies) — единичные выбросы в конкретном измерении, не повторяющиеся в соседних точках данных.
- Контекстуальные аномалии (contextual anomalies) — нормальные значения могут считаться аномальными в рамках определённого контекста времени, сезона, географии или конфигурации источника.
- Коллективные аномалии (collective anomalies) — паттерны в группе точек, где поведение в совокупности отличается от нормы, даже если отдельные точки выглядят нормально.
Важно различать техническую аномалию (ошибка сбора, задержка, дубликаты) и бизнес-аналогию (изменение бизнес-логики, структурные изменения в источнике). В архитектуре обнаружения это различие диктует режим тревоги, частоту ретрансляции и требования к объяснимости решений. Для корректной постановки задач детекции необходимы: единые сигнатуры качества данных, контекстуальные правила, а также прозрачная история изменений через версии схем, контрактов и моделей.
Ключевым элементом является формирование набора метрик-слуг: валидность схем, полнота температурного мониторинга, консистентность между источниками и дата-слитом, задержки и пропуски. Эти сигналы становятся входом для детекторов и служат основанием для принятия управленческих решений: что считать критичной аномалией, как реагировать и какой порог допустим.
Архитектура обнаружения аномалий
Архитектура обнаружения должна быть встроена в конвейер данных с явной разгрузкой функций и детальной маркировкой ответственности. Типичный стек включает источники данных, коннекторы и инжест, слой обработки с признаками и детекторами, систему хранения событий и сигналов тревоги, а также обратную связь и аудит. Ниже представлен обобщённый архитектурный шаблон.
- Источники данных и контракты данных: источники могут быть базы данных, файловые хранилища, потоки сообщений (Kafka и т.п.). Необходимы схемные контракты и версионирование форматов.
- Слой инжеста и нормализации: приведение данных к унифицированной схеме и единицам измерения, обработка времени, коррекция задержек, дедупликация.
- Переменные признаки и feature store: извлечение характеристик, которые повлияют на детекцию, хранение версий признаков для воспроизводимости.
- Модуль детекции: включает статистические детекторы, ML-модели и правила. В этой точке выносится основной сигнал тревоги и рейтинг аномалии.
- Платформа алертов и оркестрация: маршрутизация тревог в Slack, PagerDuty, 이메일 или другие каналы, поддержка уровня приоритета и сроки реакции.
- Обратная связь и аттестация: сбор отклика бизнес-единий, корректировка сигналов, обновление моделей и правил.
- Аудит и соответствие: запись действий, объяснимость решений, хранение журналов для регуляторных требований.
Технические решения должны соответствовать требованию об одном источнике истины для данных о наблюдаемости и поддерживать версионирование контрактов, моделей и детекторов. Архитектура должна быть совместима с микроархитектурой сервисов, поддерживать непрерывную интеграцию и доставлять сигналы тревоги с минимальной задержкой. В рамках продакшн-окружения особенно важны: устойчивость к сбоям, идемпотентность действий в ответ на сигнал, журналирование и мониторинг состояния детекторов как сервисов.
В качестве практических трактовок архитектуры полезно выделить следующие элементы:
- Схема данных и контракт (data schema and contracts): схематическое описание полей, типов и допустимых значений, включая временные метки и бизнес-идентификаторы. Контракты позволяют автоматизировать проверки целостности на входе и гарантируют повторяемость детекции.
- Стратегии хранения признаков (feature store): версия признаков, контроль зависимостей и лимитов на характеристики для разных доменов. Это критично для диагностики и повторного вычисления детекторов.
- Платформа для обработки (streaming vs batch): для оперативной детекции предпочтительно использование потоковой обработки (например, с Apache Flink) для снижения задержек, в то время как пакетные этапы пригодны для тренировки ML-моделей и ретроспективной оценки.
- Механизмы алертинга (alerting and incident management): правила маршрутизации сигналов, эскалация, связь с инцидент-менеджментом и управление временем реакции (SLO/SLI).
- Обратная связь и аудит (feedback and audit): система сбора откликов, корректировок параметров и прозрачного аудита по версиям детекторов и правил.
Пример элементарной реализации архитектурного паттерна: детекция на основе временного окна и нормы распределения. В контексте streaming-пайплайна целесообразно держать окно сдвига на временной оси и вычислять локальные статистики. Это позволяет снижать зависимость от глобального распределения и адаптироваться к сезонности и дрейфу.
# Пример: простая детекция аномалий в рамках окна
# Псевдо-код: вычисление z-score по скользящему окну
# Источник данных: поток значений по одному признаку
window = []
WINDOW_SIZE = 100
def process(value):
    window.append(value)
    if len(window) > WINDOW_SIZE:
        window.pop(0)
    mean = sum(window) / len(window)
    std = (sum((x-mean)**2 for x in window) / len(window))**0.5
    z = (value - mean) / (std if std > 0 else 1)
    if abs(z) > 3:
        alert("Anomaly detected", value=value, z=z)
Такой подход иллюстрирует синергию простоты и эффективности: с помощью скользящего окна можно быстро реагировать на локальные аномалии, не зависимо от глобального распределения данных. Однако в реальных условиях для устойчивости требуется учитывать мультидименсиональность, скорректировать пороги под контекст домена и внедрить дополнительные детекторы для синхронной проверки.
Методы обнаружения
Детекция аномалий может строиться из трёх взаимодополняющих компонент: статистических методов, моделей Машинного обучения и правил/порогов. В этом разделе приведены принципы выбора и реализации каждого направления, а также условия их применения в продакшене.
Статистический подход
Статистические детекторы опираются на предположения о распределении данных и характере их вариативности. Классика включает одновременную работу над несколькими уровнями: univariate и multivariate анализ, сезонные компоненты и устойчивость к выбросам. Основные методы:
- z-score и его устойчивые варианты (MAD-based z-score): простые и эффективные для точечных аномалий в стационарных данных.
- EWMA (экспоненциально взвешенное скользящее среднее) и CUSUM: детекция дрейфа и резких изменений в средних значениях во времени.
- Robust статистика (MAD, Winsorized statistics): устойчивость к выбросам и асимметриям распределения.
Преимущества статистических методов заключаются в скорости, явной интерпретируемости и минимальном объёме обучающей выборки. Их слабость — ограниченная способность улавливать сложные зависимости между признаками и адаптироваться к резким дрейфам, особенно в многомерном пространстве. Для борьбы с этим применяется мультимодальный подход, включающий независимые детекторы по каждому признаку и коррелирующий детектор, который учитывает связи между признаками.
# Пример: мультимодальная детекция по двум признакам import numpy as npdef detect(pair_series, threshold=3.0): x, y = pair_series mean_x, mean_y = np.mean(x), np.mean(y) std_x, std_y = np.std(x, ddof=1), np.std(y, ddof=1) z_x = (x - mean_x) / (std_x if std_x else 1) z_y = (y - mean_y) / (std_y if std_y else 1) anomaly_mask = (np.abs(z_x) > threshold) | (np.abs(z_y) > threshold) return anomaly_mask
Применение данного подхода позволяет быстро локализовать аномалии на уровне отдельных признаков и выявлять сочетания, которые неочевидны при рассмотрении признаков по-отдельности. Однако требуется аккуратное управление множеством тестов и коррекцией на множественное сравнение, чтобы избежать ложных срабатываний.
Модели машинного обучения
ML-подходы разделяются на несупервизируемые, слабо supervisируемые и супервизируемые. В контексте обнаружения аномалий в данных часто применяются:
- Несупервизируемые методы: Isolation Forest, One-Class SVM, локальные похожественные выбросы (LOF), Autoencoders в режиме обучения на нормальных данных. Они строят модель поведения данных и сигнализируют о точках, которые выходят за рамки нормы.
- Полу-супервизируемые и надзор: когда есть ограниченное количество известных аномалий; применяется кластеризация с метками иOnline-learning для адаптации к дрейфу.
- Обучение на реконструкциях: автоэнкодеры, VAR-диаграммы, детекторы редких событий, построенные на реконструкции входного сигнала; высокие значения ошибок реконструкции указывают на аномалии.
Ключевые принципы реализации в продакшене:
- Подбор признаков и инженерия: нормализация, масштабирование, создание временных признаков (скользящие окна, задержки, разности).
- Разделение данных: train/validation/test с учётом дрейфа концепций, кросс-доменные проверки.
- Мониторинг дрейфа: регулярная переобучаемость, оценка деградации точности, столбцы как сигналы к обновлению модели.
- Взаимодействие с системами мониторинга: интеграция с системами алертинга и журналирования.
Пример архитектуры детектора на базе Isolation Forest:
- Источник: набор нормальных примеров за период без известных аномалий.
- Обучение: обучение на нормальных данных с последующей валидацией.
- Детекция: вычисление аномалий на входных данных в реальном времени или пакетно.
- Оповещение: пороговая функция для раннего предупреждения, с возможностью ручной пересмотры.
# Пример на scikit-learn: Isolation Forest from sklearn.ensemble import IsolationForest import numpy as npX = load_features() # матрица признаков model = IsolationForest(contamination=0.01, random_state=42) model.fit(X) scores = model.decision_function(X) anomalies = scores < 0 # негативные значения указывают на аномалии
Использование ML-моделей требует постоянного контроля за дрейфом, расширения обучающей выборки и внедрения автоматизированной переобучаемости. В продакшене целесообразна и концептуальная стратегія: периодический пересмотр модельной политики (policy), A/B-тестирование новой версии детектора и rollback-планы на случай ухудшения качества сигналов.
Правила и пороговые политики
Правила — это явные, понятные и управляемые директивы, которые можно версионировать и тестировать. Они дополняют статистические и ML-детекторы, обеспечивая детерминированные сигналы тревоги, устойчивые к дрейфу, и дают бизнес-подразделениям возможность напрямую управлять порогами без вмешательства в кодовую базу.
Элементы правил:
- Пороговая настройка по признакам: фиксированные или адаптивные пороги, зависящие от контекста, временных окон и бизнес-правил.
- Правила, основанные на парах признаков: корреляционная аномалия, когда комбинации признаков ведут к неожиданной связке.
- Временные окна и эвристики: скользящие пороги, двойные тройные сигналы в разные интервалы времени, чтобы уменьшить ложные срабатывания.
- Эскалация и контекст: правила, которые определяют уровень тревоги и канал уведомления, а также требуют подтверждения вручную.
Преимущество правил в том, что они являются простыми для аудита и объяснимыми, легко тестируются на исторических данных и быстро адаптируются под новые требования. В сочетании с статистикой и ML они образуют устойчивую систему обнаружения: статистика даёт быструю подпорку для типичных изменений, ML — ловит сложные зависимые аномалии, а правила — управляют поведением и контролем.
Ключевой аспект — управление дрейфом и обновление правил. Любой порог или сигнатура должны проходить через процессы контроля изменений, тестирования на регрессию и документирования причин изменения. В идеале правила сопровождаются метаданными: причина, контекст, дата выпуска, предполагаемая дальняя цель и последствия.
Интеграции и оперативная эксплуатация
Эффективная детекция требует тесной интеграции с инфраструктурой наблюдаемости и бизнес-процессами. В продакшене целесообразно реализовать единый пайплайн, который обеспечивает:
- Контракты данных и версионирование: схема и правила формирования сигнатур аномалий должны быть под контролем версий.
- Интеграция с системами мониторинга: сбор и публикация метрик детекции в Prometheus/Grafana, отправка событий в системы манифестации инцидентов.
- Потоки обработки и диспетчеризация сигналов: единая очередь сообщений, маршрутизатор тревог по каналам и уровням важности.
- Обратная связь и улучшения: автоматизация запроса на дополнительную валидацию от бизнес-пользователей, сбор откликов и корректировка детекторов.
- Безопасность и соответствие: хранение журналов, прослеживаемость действий и аудит изменений.
При проектировании интеграций следует избегать монолитных структур и переходить к модульности: модуль детекции должен быть независимым сервисом с чётко определённым контрактом на вход и выход, чтобы его можно было заменить без влияния на остальные компоненты конвейера.
Безопасность, прозрачность и доверие
Детекция аномалий должна обеспечивать не только оперативность, но и прозрачность решений. В секторе управления данными требования к объяснимости, аудиту и надёжности усиливаются, поэтому следует внедрять:
- Explainability: возможность объяснить, почему конкретный сигнал помечен как аномальный, какие признаки повлияли и какие пороги применялись.
- Регистрация и аудит: чёткая история версий детекторов, изменений правил, журнал действий немедленно доступен для аудита.
- Управление изменениями: процессы одобрения, тестирования и выпуска обновлений детекторов и правил.
- Контроль доступа и безопасность: минимизация прав, аудит доступа к данным и сигналам тревоги, шифрование и надёжная аутентификация.
- Управление доверием через контракты: бизнес-толкование аномалий и согласование действий, включая SLA/OLA, даёт возможность быстро выравнивать ожидания между командами данных и бизнес-единицами.
Эти механизмы особенно важны для регуляторных требований в некоторых секторах и для обеспечения устойчивости бизнеса к непредвиденным изменениям во внешних условиях.
Key takeaways
- Обнаружение аномалий требует синергии статистических методов, ML-моделей и правил, каждая из которых дополняет другие аспекты детекции и управления инцидентами.
- Архитектура детекции должна быть модульной, с четкими контрактами на вход/выход, поддержкой версионирования и обратной связи.
- Статистические методы обеспечивают быструю и понятную детекцию, ML-модели позволяют находить сложные зависимости и адаптироваться к дрейфу, а правила — управляемость и объяснимость.
- Интеграции с системами мониторинга, алертинга и данными контрактами упрощают эксплуатацию и повышают надёжность реакции на аномалии.
- Прозрачность, аудит и безопасность являются неотъемлемой частью решений по обнаружению аномалий, особенно в рамках цифровой трансформации и регуляторных требований.
FAQ
- Какие типы аномалий чаще встречаются в данных и как они влияют на бизнес-решения?
- Чаще встречаются точечные, контекстуальные и коллективные аномалии. Их влияние может варьироваться от ложных тревог, вызывающих усталость команд и расход ресурсов, до реальных производственных сбоев или ошибок в бизнес-процессах. Важно различать контекст: сезонность, алиасы источников и бизнес-правила. Правильная система сигналов опирается на контекст-ориентированные пороги и мультимодальные сигнальные схемы, чтобы повысить точность и снизить ложные срабатывания.
- Как выбрать между статистическими методами и ML-моделями для детекции аномалий?
- Статистические методы хороши на стабильных данных с ясной нормальностью или устойчивыми сезонными паттернами; они fast и explainable. ML-модели эффективны, когда данные демонстрируют сложные, нелинейные зависимости и требуют адаптации к дрейфу концепций. Рекомендуется использовать гибридный подход: базовую детекцию на статистических принципах дополнять ML-декодерами и правилами для управления сигналами.
- Какие показатели эффективности следует мониторить для детекции аномалий?
- Включайте точность тревог (precision) и полноту (recall) относительно бизнес-уровней риска, показатель ложных тревог (false positive rate), время реакции, задержку между возникновением аномалии и её обнаружением, а также устойчивость к дрейфу и регрессии на исторических данных.
- Как обеспечить explainability для ML-моделей детекции?
- Используйте объяснимые модели или пост-объяснения (SHAP, LIME) для ключевых признаков, документируйте пороги и вероятностные оценки, предоставляйте контекст на уровне признаков в каждый тревожный сигнал и храните версионирование моделей и сигнатур.
- Какие практики оптимальны для внедрения правил в продакшене?
- Внедряйте правила через процессы управления изменениями, тестируйте их на исторических данных, применяйте canary-выпуски и A/B-тестирование, документируйте причины и ожидаемые эффекты, а также обеспечьте возможность быстрого отката к предыдущей версии.
- Как организовать интеграцию детекторов аномалий с данными контрактами?
- Определите единые схемы и форматы входных данных, поддерживайте версионирование контрактов, внедрите автоматическую валидацию схем, а также обеспечьте мониторинг согласованности между контрактами и реализацией детекторов.
- Какие существуют стратегии минимизации задержек в реакции на аномалии?
- Используйте потоковую обработку данных, локальные вычисления на краю данных там, где возможно, кэшируйте сигналы тревоги и используйте асинхронные уведомления. Разделение обработки на компактные, повторяемые задачи снижает задержки и упрощает мониторинг производительности.
- Какие риски следует учитывать при использовании ML-детекторов?
- Риски включают дрейф концепций, штрафы за ложные срабатывания, переобучение на исторических данных, зависимость от качества входных признаков и сложность объяснимости решений. Важно внедрить drift-detection, регулярное переобучение и детальные журналы решений.
- Как устроить обратную связь от бизнес-подразделений?
- Организуйте циклы обратной связи, позволяющие бизнесу подтверждать или отклонять тревоги, фиксировать контекст и доказывать важность сигналов. Используйте формальные процессы эскалации и документируйте влияние тревог на бизнес-показатели.
- Какие открытые инструменты стоит рассмотреть в рамках архитектуры?
- В рамках открытых инструментов можно упомянуть scikit-learn для ML-детекции и Apache Flink для потоковой обработки, а также платформы мониторинга и алертинга (Prometheus, Grafana, alertmanager). При этом следует соблюдать требование ограничивать число инструментов и избегать перегружения архитектуры.
- Как совместить аномалию в данных с требованиями к ответственности и аудиту?
- Включите регистры версий детекторов, правил и контрактов, хранение журналов детекции и действий по инцидентам, а также обеспечение прозрачности в выборе порогов и методов. Это облегчает аудит и повышает доверие к системе.
- Как обеспечить устойчивость к изменениям внешней среды (дрейф)?
- Регулярно обновляйте обучающие данные, внедрите механизмы drift-детекции, используя адаптивные пороги и переобучение моделей, а также проводите периодические регрессионные тесты на исторических сценариях. Комбинация стратегий — ключ к устойчивости.
- Какие шаги предпринять для начала реализации в организации?
- Определите единый набор бизнес-правил и сигнатур, создайте минимально жизнеспособный пайплайн детекции на одном домене, внедрите базовые статистические детекторы и простую ML-модель, организуйте каналы уведомления, запустите цикл обратной связи, затем постепенно расширяйте функциональность и индустриальные сигнатуры на соседние домены.
- Какие требования к компетенциям команды при внедрении?
- Необходимо сочетать Data Engineering для инфраструктуры и пайплайнов, Data Science для разработки и обучения детекторов, и специализированные роли по Data Governance, чтобы обеспечить соответствие правилам и аудитируемость решений.
- Какой подход к тестированию детекторов наиболее эффективен?
- Рекомендуется использовать исторические наборы данных с настроенными аномалиями, симулированные сценарии и регрессионные тесты для проверки совместимости обновлений с существующими сигналами. Важно обеспечить тестовую среду, близкую к продакшн, и поддерживать версионирование тестовых наборов.
Продакшн-ориентированное обеспечение обнаружения аномалий требует баланса между точностью сигналов, скоростью реакции и прозрачностью принятия решений. Комбинация статистических методов, ML-моделей и правил позволяет формировать устойчивый цикл наблюдаемости за данными, который адаптируется к бизнес-логике, дрейфу данных и регуляторным требованиям. В дальнейшем следует углубляться в конкретные домены, подбирать инструменты и настраивать пороги под специфику источников данных и сервисов.
Data Observability — это не техническая инициатива, а инструмент снижения стратегических рисков и повышения прозрачности управления бизнесом. Если вы отвечаете за устойчивость процессов, соответствие требованиям и доверие к аналитике, важно рассматривать наблюдаемость данных в связке с практиками Data Governance — как единую систему контроля, ответственности и измеримых бизнес-результатов.
Перейдите к разделу Data Governance, чтобы понять, как выстроить управляемую модель владения данными, закрепить зоны ответственности и превратить качество и прозрачность данных в конкурентное преимущество.


