

Производительность и масштабируемость: хранение, вычисления и стоимость
Data Observability выступает опорой для доверия к данным и оперативного принятия решений. В этой главе рассматриваются вопросы производительности и масштабируемости наблюдаемости: как проектировать хранение и вычисления метрик наблюдаемости так, чтобы они не становились узким местом в инфраструктуре, и как управлять стоимостью владения при росте объема данных и числа источников. Рассматриваются архитектурные принципы, схемы данных, алгоритмы обработки и подходы к интеграции с существующими системами обработки данных и бизнес-процессами.
Наблюдаемость данных в современных условиях должна обеспечивать не только доступность и качество, но и предсказуемость затрат и предсказуемость исполнения. Архитектура обмена данными, выбор форматов, стратегий хранения, подходы к вычислениям и кэшированию, а также управление себестоимостью на разных этапах жизненного цикла данных становятся критическими факторами устойчивости цифровой трансформации.
- Архитектурные принципы хранения и вычислений для observability, включая форматы данных, слои хранения, потоки событий и вычислительные цепочки.
- Метрики производительности, масштабирование и алерты, а также шаблоны проектирования для устойчивой наблюдаемости на больших объемах.
- Модели расчета стоимости владения, методы оптимизации затрат и практические шаги внедрения с учетом требований к доступности и задержкам.
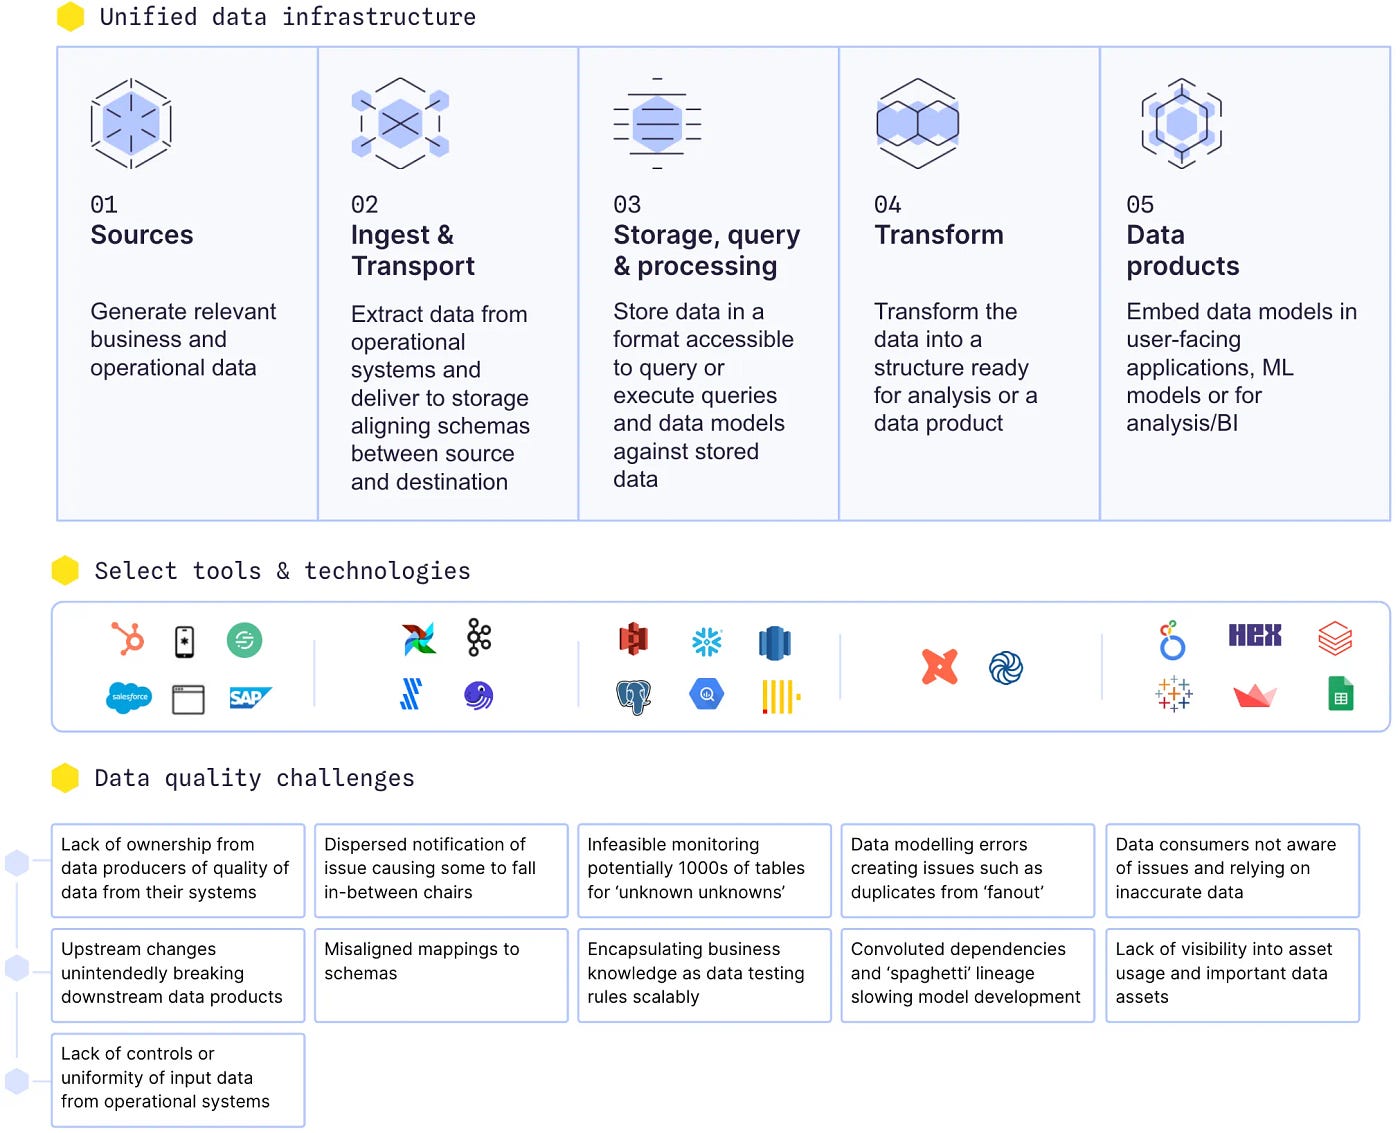
Краткое содержание главы
- Архитектура хранения и вычислений для наблюдаемости: слои, форматы и потоки данных.
- Метрики, мониторинг и управление производительностью в масштабе: SLA, SLO, латентности и алерты.
- Стоимость владения: модели расходов, оптимизации хранения, вычислений и сетевого трафика.
- Интеграции, протоколы и безопасность:如何 обеспечить эффективную совместную работу систем мониторинга и бизнес-логики.
- Практические принципы реализации и пошаговый план внедрения в инфраструктуру observability.
Контекст и требования к производительности
Уровень требований к производительности наблюдаемости во многом определяется целями бизнеса: скорость обнаружения проблем, задержки в обновлении метрик, достоверность сигналов и пропускная способность системы мониторинга. Важно устанавливать ясные границы для задержек и консистентности:
- Задержки на уровне источников данных и пакетов метрик должны быть согласованы с требованиями к freshness: некоторым источникам достаточно обновления каждые несколько минут, другим — в реальном времени.
- Консистентность сигналов наблюдаемости часто компрометируется форматом и латентностью обработки. Необходимо определить, какие данные должны идти через потоковую часть и какие — через пакетную обработку.
- Масштабируемость вычислений и хранения напрямую связана с количеством источников, частотой выборок, количеством правил согласования качества и объёмами дополнительных индикаторов качества (метаданные, lineage, версии схем).
Эти требования диктуют выбор архитектурных решений: какие компоненты следует располагать в кластере обработки (streams vs batches), какие слои кэширования необходимы, как организовать хранение метрик, как проектировать схемы и наборы метрик для качественной телеметрии. Важным аспектом является разделение ответственности между источниками данных и системами агрегации: источники должны обеспечивать достаточную детализацию, а агрегаторы — устойчивую сводку без потери существенных сигналов.
Архитектура хранения и вычислений
Хранение: схемы, форматы и слои
Для observability характерны большой поток событий и метрик, большой спектр источников и потребителей. Эффективное хранение требует многоуровневого подхода:
- Слоевое разделение данных: сырые данные (raw/bronze) и агрегированные/интермедийные слои (silver/observability-curated) с четко описанными схемами и жизненным циклом. Это позволяет хранить минимально необходимый объем в быстром доступе и более объемные данные — в более экономичных слоях.
- Форматы данных: столбчатые форматы (например, Apache Parquet, ORC) для долговременного хранения и ускоренной аналитики; оптимизация схем под запросы на агрегацию, сканирование и сортировку. В потоках для оперативной обработки применяются компактные форматы, такие как Avro или JSONL, с поддержкой схем через реестр схем (Schema Registry).
- Метаданные и lineage: хранение информации о происхождении данных, версиях источников и трансформаций, что критично для доверия и воспроизводимости. Метаданные должны быть доступными для запросов и визуализации, а также поддерживать автоматическое обновление через события изменений в источниках данных.
- Инфраструктура хранения: использование гибридной архитектуры с локальным кэшом и дальним хранением. Архитектура может включать Data Lakehouse-компоненты, где совместимы требования скорости и экономии, например слои на основе форматов Parquet в сочетании с ускорителями типа кэш-памяти и materialized views.
Пример распределения данных:
- Bronze: сырые события из источников наблюдаемости (лог-файлы, сигналы мониторинга, трассировки).
- Silver: агрегированные сигналы и метрики качества, нормализация полей, соотношение времени обновления и полноты.
- Gold: бизнес-ориентированные представления (например, показатели качества данных по доменам и источникам) и подготовленные наборы данных для аналитики и алертинга.
Форматы хранения должны соответствовать целям доступа. Например, для пакетной обработки больших объемов лучше выбрать Parquet или ORC, поддерживающие колоночное считывание и эффективные операции агрегации. Для потоков целесообразно поддерживать структуру с компоновкой событий и совместимостью схем, чтобы снизить задержку и упростить встроенные проверки качества.
Вычисления: движки, параллелизм и потоковая обработка
Обеспечение производительности наблюдаемости требует продуманной архитектуры вычислений:
- Разделение операций на два уровня: онлайн-вычисления для реального времени и оффлайн-вычисления для глубокой аналитики. Реальное время обеспечивает задержки в пределах секунда, оффлайн — в минуты или часы.
- Вычислительные движки: сочетание стриминговых и пакетных обработчиков. В реальном времени применяются Flink или Spark Structured Streaming, в пакетной обработке — Spark Batch, Presto/Trino для быстрых ответов на запросы. Выбор зависит от требований к задержке, объему данных и потребности в stateful обработки.
- Параллелизм и масштабируемость: горизонтальное масштабирование вычислительной мощности и кэширования. Важны стратегии шардинга, управление состоянием в стриминге и оптимизация памяти. Стоит учитывать требования к дедупликации, Windowing и точному времени задержки.
- Архитектуры совместной обработки: использование streaming-путь и чуть менее latency-чувствительных batch-пайпов с оконной агрегацией, чтобы снизить нагрузку на систему и поддержать нужный коэффициент детализации.
- Технологии интеграций: стандартные интерфейсы доступа (REST, gRPC, JDBC/ODBC) и обмен сообщениями через Kafka или аналогичные брокеры. Реестр схем и политики эволюции схем уменьшают риск деградации качества данных при изменениях источников.
Пример архитектурного паттерна: потоковая передача метрик через Kafka, их преобразование и агрегация в Flink, сохранение в Bronze-Silver-Gold слои Parquet, ответы на запросы в Presto через слои кэшей и материализованные представления.
-- Пример упрощенного SQL-запроса для оценки свежести сигнала наблюдаемости
SELECT
  source,
  AVG(EXTRACT(EPOCH FROM NOW() - event_timestamp)) AS avg_latency_seconds,
  COUNT(*) AS total_events
FROM raw_observability_events
GROUP BY source;
Интеграции и протоколы: мероприятия по синхронизации и совместимости между источниками и вычислительной платформой достигаются за счет общего реестра схем, контрактов по форматам сообщений и четко определённых контрактов между продюсерами и консюмерами. Важны безопасность и управление доступом, особенно при масштабировании событий и метрик по многим доменам.
Модели данных и схемы
Структура данных для observability должна поддерживать гибкость и эволюцию схем без неконтролируемого роста сложности. Рекомендуется:
- Использовать схему данных, ориентированную на ключевые поля: источник, тип сигнала, временная метка, уровень качества, версия источника, контекст события.
- Вести версионирование схем и поддерживать обратную совместимость, чтобы не нарушать существующие пайплайны при эволюции сигнатур сигналов.
- Обеспечить возможность lineage и provenance: откуда пришли данные, какие трансформации применялись, какие правила качества были применены.
- Включить метаданные, связанные с контекстом домена: бизнес-направление, соответствие регуляторике, путь аудита.
Хранение метаданных и схема должны позволять быстрый доступ к информации о качестве, полноте, задержке и других сигналах, необходимых для принятия решений. В качестве технологических примеров можно рассмотреть легкие реестры схем (Confluent Schema Registry, Apache Avro) и решения по управлению метаданными (open-source варианты) в сочетании с хранилищами Parquet/ORC для больших массивов.
Мониторинг производительности наблюдаемости: метрики, алерты и архитектурные паттерны
Эффективность наблюдаемости зависит от того, как быстро система может сигнализировать об отклонениях и как управлять нагрузкой в пиковые периоды. Важны:
- SLA/SLO для задержек обработки сигналов, времени обновления дашбордов и времени реакции на инциденты.
- Метрики производительности самой observability-платформы: latency of ingestion, end-to-end latency, throughput (events per second), failover time, error rates, availability.
- Правила алертирования, которые учитывают не только пороги, но и контекст первичных источников: например, снижение полноты данных у определенного источника в рамках заданного окна.
- Архитектурные плацдармы для масштабируемого мониторинга: шардинг и изоляция слоев, чтобы проблема в одном источнике не приводила к деградации всей системы.
Методы мониторинга включают в себя сбор телеметрии внутри самой наблюдаемой системы, реализацию каркасов качественной проверки (data quality checks) и автоматическое тестирование сигнатур качества. Для управляемости целесообразно использовать набор готовых шаблонов наблюдаемости и конвенций по именованию метрик, что упрощает кросс-доменные анализы.
- В качестве примера: можно построить набор метрик, который включает полноту, точность, согласованность и временную задержку сигнала по каждому источнику. Эти показатели могут быть агрегированы по доменам и видам сигнала, что дает бизнес-оператору ясную картину состояния данных.
Стоимость владения: расчеты и оптимизация
Рост объема данных и числа источников напрямую влияет на стоимость. В рамках этой главы следует рассмотреть три основное направления затрат: хранение, вычисления и сетевые операции, а также затраты на инфраструктуру мониторинга и менеджмент.
- Модель затрат: C_total = C_storage + C_compute + C_network + C_management + C_tooling. Каждую компоненту следует оценивать по отдельности и регулярно обновлять бюджеты по мере изменения нагрузки.
- Хранение: ключевые факторы — объем данных, частота обновления, срок хранения, выбор форматов и слоев. Эффективное хранение предполагает многослойную стратегию (bronze/silver/gold) и политику жизненного цикла, чтобы удалять устаревшие данные и применять компрессию.
- Вычисления: стоимость вычислений зависит от объема данных, сложности запросов и продолжительности выполнения пайплайнов. Важна оптимизация плана выполнения, параллелизм, кэширование, материализованные представления и выбор между стриминговой и пакетной обработкой в зависимости от требований к задержкам.
- Сетевые затраты: передача больших объемов сигнала между источниками и обработчиками может быть значительной. Необходимо планировать пропускную способность и использовать поблочные архитектуры, чтобы минимизировать трансферные затраты.
- Инструменты и лицензии: выбор инструментов для мониторинга и управления данными определяется балансом между функциональностью и стоимостью владения. В рамках инфраструктуры с открытым кодом часто можно снизить затраты, но следует учесть затраты на эксплуатацию и интеграцию.
Практические рекомендации по снижению затрат:
- Внедрить политики хранения: хранение только необходимого объема данных на быстром слое и периодическое архивирование или удаление устаревших записей.
- Применять форматы данных с эффективной компрессией и колоночное чтение для ускорения аналитики.
- Оптимизировать вычисления: избегать повторной переработки, использовать материализованные представления там, где расчеты повторяются, и применить ленивую загрузку.
- Разграничивать уровни доступа и размер кластера в зависимости от нагрузки: динамическое масштабирование и автоматическое отключение неиспользуемых узлов.
- Внедрять протоколы контроля качества данных, чтобы заранее отказывать в обработке данных, которые не соответствуют базовым требованиям, тем самым экономя ресурсы.
Практические сценарии внедрения: выбор технологий и шаги реализации
- Многоуровневая архитектура хранения с поддержкой реестра схем и потокового вычисления.
- Выбор форматов и слоев: Bronze (сырые события) → Silver (нормализованные, с дефектами устранены) → Gold (пользовательские аналитические представления).
- Инструменты: открытые решения для хранения (Apache Iceberg, Delta Lake) совместно с потоковыми обработчиками (Apache Flink, Spark Structured Streaming) и системой метрик (Prometheus, OpenTelemetry).
- Распределение нагрузки и кэширование.
- Разделение нагрузки между локальным кэшем и удаленным хранилищем.
- Внедрение материализованных представлений и индексов для ускорения типовых запросов по качеству данных.
- Управление стоимостью и жизненным циклом данных.
- Введение политики хранения с временными окнами, в рамках которых данные держатся на быстром слое, а устаревшие — переходят в экономичный слой или архивируются.
- Мониторинг затрат в реальном времени с использованием бюджетов и предупреждений для предотвращения перерасхода.
- Интеграции и безопасность.
- Институционализация контрактов по форматам сообщений, схема-менеджмент, политики доступа и аудит изменений.
- Обеспечение совместимости с регуляторными требованиями и средствами аудита.
# Пример шага реализации: согласованные политики хранения и вычисления
- Определить слои Bronze/Silver/Gold.
- Настроить хранение в Parquet с компрессией Zstandard.
- Развернуть Flink-пайплайн для стриминга в Bronze, агрегацию в Silver и материализацию в Gold.
- Подключить реестр схем для управления эволюцией полей.
Внедрение: процесс и организационные изменения
Успешная реализация требует not только выбора технологий, но и изменений в процессах, ролях и обязанностях:
- Определение архитектурной ответственности: кто отвечает за хранение, вычисления и качество сигналов.
- Внедрение процессов управления изменениями в схемах и правилах качества данных, включая тестирование на устойчивость к изменениям и регрессионное тестирование.
- Обеспечение прозрачности для бизнес-пользователей: четкие сигналы, понятные дашборды и доступ к контексту сигнала (источник, версия, контекст домена).
- Постепенное внедрение и фазы: пилотный проект, расширение на новые источники и домены, затем масштабирование по всей организации.
Key takeaways
- Эффективная производительность наблюдаемости достигается через многоуровневую архитектуру хранения и вычислений, четко разделённые слои данных и правильный выбор обработчиков (стриминг против пакетной обработки).
- Форматы данных и схемы должны поддерживать эволюцию без прерывания потребителей: использовать схему-реестры и версионирование схем.
- Метрики производительности и алерты должны соответствовать бизнес-целям и SLA, а не только техническим индикаторам.
- Эффективное управление стоимостью включает многоуровневое хранение, оптимизацию вычислений, кэширование и контроль расходов на сетевой трафик.
- Интеграции с источниками и потребителями должны быть четко зафиксированы в контрактах форматов, API и политик доступа.
- Внедрение должно сопровождаться организационными изменениями: распределение ролей, процессы изменения схем и мониторинга качества данных, а также обучение команд.
- Постоянное улучшение архитектуры и процессов наблюдаемости требует цикличности: сбор требований, архитектурные решения, тестирование, эксплуатация и ретроспектива.
FAQ
- Какие главные архитектурные принципы при проектировании хранения для observability?
- Ответ: При проектировании хранения для observability критически важно разделение данных по слоям (Bronze, Silver, Gold), выбор форматов Parquet/ORC для эффективной аналитики, обеспечение устойчивого lineage и версионирования схем, а также наличие реестра схем и политики эволюции. Эти принципы позволяют сохранять детализацию сигналов, снижать стоимость и поддерживать контроль версий данных.
- Как выбрать между стримингом и пакетной обработкой в контексте наблюдаемости?
- Ответ: Стриминг обеспечивает минимальные задержки и реальное время, что критично для инцидент-менеджмента и алертинга. Пакетная обработка эффективна для глубокой аналитики, ретроспективного анализа и обучения моделей качества данных. Гибридная архитектура, где основной поток обрабатывается стриминговыми пайплайнами, а сложные расчеты — пакетно, часто оптимальна.
- Какие форматы и технологии выбрать для форматов хранения и обмена сигнала?
- Ответ: Для долговременного хранения подходят колоночные форматы Parquet/ORC с компрессией. Для потоков — Avro или JSONL с поддержкой схем через Schema Registry. При необходимости реального времени полезны стриминговые движки вроде Apache Flink или Spark Streaming. В качестве референсов можно рассмотреть Iceberg/Delta Lake для управляемого слоя хранения.
- Какие метрики важны для мониторинга производительности наблюдаемости?
- Ответ: Необходимо отслеживать ingest_latency (задержка поглощения сигнала), end_to_end_latency (конечная задержка от источника до агрегированного сигнала), throughput (объем обрабатываемых событий в секунду), availability системы, error_rate и полноту данных по источникам. Эти метрики должны быть согласованы с бизнес-целями и SLA.
- Какой подход к стоимости владения наиболее эффективен в условиях роста объема данных?
- Ответ: Эффективность достигается многослойной стратегией хранения с политиками жизненного цикла, использованием компрессии и колоночных форматов, кэшированием и материализованными представлениями для часто используемых запросов, а также динамическим масштабированием вычислительных кластеров. Важна регулярная пересборка бюджетов и KPI по затратам.
- Как обеспечить эволюцию схем без разрушения потребителей?
- Ответ: Внедрить версионирование схем и строгий реестр схем, поддерживать обратную совместимость, применять миграции схематических изменений через слой преобразований и тестирование на совместимость. Это позволяет безопасно эволюционировать сигнатуры сигналов без простоев.
- Какие вызовы стоят при интеграции с внешними источниками сигнала?
- Ответ: Вызовы включают согласование форматов, версий данных, согласование частоты обновления и обеспечение устойчивости к сбоям источников. Необходимо определить контракт на обмен данными, поддерживать реестр схем и обеспечить мониторинг интеграционных точек на уровне устойчивости и детальности сигналов.
- Что наиболее критично для доверия к данным в контексте производительности?
- Ответ: Надежная скорость обновления сигналов, прозрачность происхождения данных и их трансформаций, контроль версий и однозначная идентификация источников. Производительность не имеет смысла без способности объяснить, откуда пришли данные, как они были обработаны и какие ограничения применялись.
- Какие типичные ошибки следует избегать при масштабировании observability?
- Ответ: Игнорирование политики жизненного цикла данных, перегрузка системы избыточным историческим сигналом без экономии, недооценка необходимости кэширования и материализации часто запрашиваемых представлений, неполное управление изменениями в схемах и слабая инфраструктура для мониторинга самой наблюдаемой системы.
- Какие открытые и коммерческие решения можно использовать в рамках технической главы?
- Ответ: В открытом виде можно рассмотреть Apache Iceberg/Delta Lake для хранения, Apache Flink или Spark Structured Streaming для вычислений, Apache Kafka как брокер потоков и реестр схем через Confluent Schema Registry. Коммерческие альтернативы могут включать платформы, предоставляющие готовые пайплайны для observability, однако следует внимательно сравнивать стоимость и гибкость интеграций. В любом случае выбор зависит от конкретных требований к задержкам, объему данных и бюджету.
Data Observability — это не техническая инициатива, а инструмент снижения стратегических рисков и повышения прозрачности управления бизнесом. Если вы отвечаете за устойчивость процессов, соответствие требованиям и доверие к аналитике, важно рассматривать наблюдаемость данных в связке с практиками Data Governance — как единую систему контроля, ответственности и измеримых бизнес-результатов.
Перейдите к разделу Data Governance, чтобы понять, как выстроить управляемую модель владения данными, закрепить зоны ответственности и превратить качество и прозрачность данных в конкурентное преимущество.


