

Роль признаков в бизнес-целях и цифровой трансформации
Краткое введение
В контексте курса «Feature Store и повторное использование признаков: проектирование, версии, доступы и интеграция с пайплайнами обучения» роль признаков выходит на уровень стратегического ресурса. Признаки - это не просто данные, это смысловые единицы, на которых строятся продукты, принимаются решения и управляется риск. Эффективность цифровой трансформации во многом определяется тем, насколько бизнес-цели переводятся в спецификации признаков, как обеспечивается повторное использование фич, как управляется качество, версия и доступ к набору признаков, и как эти особенности интегрируются в конвейеры обучения и эксплуатации моделей. Данная глава рассчитана на аналитиков, архитекторов и ИТ-директоров: она разворачивает концепты в практические паттерны, показывая, зачем и как формулировать признаки под цели бизнеса, как выровнять процесс разработки признаков с продуктовой дорожной картой компании и как выстроить управляемый, воспроизводимый и масштабируемый поток фич через фич-стор.
Введение
Признаки представляют собой параметризованные характеристики, которые моделируют поведение объектов бизнеса: клиентов, транзакций, продуктов, процессов. В ML-пайплайнах признаками становятся входами алгоритмов, на которых зависят точность, устойчивость и скорость внедрения решений. Цифровая трансформация во многом сводится к превращению неструктурированных данных в управляемые, легко повторяемые фрагменты знаний - признаки, которые можно продавать как продукт внутри организации и использовать повторно в разных моделях и направлениях.
Ключевые идеи, которые мы разберём в главе:
- Признаки как элемент бизнес-целей: как именно признаки помогают достигать целевых показателей (выручка, конверсия, удовлетворённость, риск-индексы).
- Повторное использование признаков: снижение затрат на разработку моделей, ускорение времени до бизнес-решения и минимизация дублирования логики.
- Управление качеством и версионированием признаков: как обеспечить воспроизводимость, трассируемость и совместную работу команд.
- Интеграция признаков с пайплайнами обучения: как обеспечить согласование между данными, обучением и деплоем.
- Архитектура feature store как основа цифровой трансформации: хранение, версии, онлайн- и оффлайн-хранилища, согласование доступа.
Теоретические основы и терминология
Основные понятия
- Признак (feature): числовой, категориальный или текстовый объект, который может быть использован в модели как входной параметр.
- Feature engineering: процесс создания признаков из исходных данных путём преобразований, агрегаций, разностной обработки, лексических и временных трансформаций.
- Feature store (хранилище признаков): централизованное хранилище, которое обеспечивает хранение, версионирование, доступ к признакам и их повторное использование во множестве пайплайнов.
- Online vs Offline feature store:
- Offline store: хранение признаков в долговременном хранилище (data lake/warehouse) для обучения и тестирования.
- Online store: быстрый доступ к актуальным признакам для онлайн-вычислений и реального времени.
- Feature registry и lineage: каталог признаков и их происхождение, позволяющее понять, как где и когда были созданы признаки.
- Feature group: логическая группировка признаков по предметной области или бизнес-домену (например, «клиенты», «сессии», «транзакции»).
- Versioning: управление версиями признаков и их схем, чтобы обеспечить воспроизводимость и развивающиеся модели.
- Data contract: соглашение между командами об ожидаемом формате, единицах измерения, частоте обновления и качественных показателях признаков.
- Governance, RBAC/ABAC: контроль доступа, аудит изменений, соответствие требованиям безопасности и регуляторным нормам.
- Drift и качество признаков: мониторинг изменений распределения признаков и их влияния на modelos, а также валидация на предиктивность и корректность.
Термины и принципы
- Признаки как продукт (Feature as a Product): подход, при котором команда, отвечающая за признаки, выносит их на рынок в виде устойчивого сервиса для потребителей признаков - дата-синерджи, аналитики, data science и бизнес-инициативы.
- Semver для признаков: семантическая версионизация признаков и их контрактов, чтобы изменения не ломали существующие пайплайны.
- Контракты данных: понятные спецификации форматов, типов, единиц измерения, latency и требований к качеству.
- Холодное/горячее кэширование признаков: баланс между пропускной способностью и актуальностью признаков для онлайн-инференса.
Методологии и подходы
Архитектурные паттерны
- data-driven подход: признаки формируются как часть конвейера данных, проходящего через этапы очистки, нормализации, агрегации и проверки качества.
- Feature as a Service: API, через которые потребители признаков получают данные по контрактам, включая онлайн/почти онлайн доступ.
- GitOps для признаков: хранение определения признаков и инфраструктуры в version-controlled репозиториях, автоматизированное развёртывание через CI/CD.
- Data contracts first: фиксация форматов и ограничений до начала разработки новых признаков.
Жизненный цикл признаков
- Идентификация бизнес-цели: какие задачи ML должны поддержать бизнес-метрику.
- Проектирование признаков: какие признаки и как они будут формироваться.
- Версионирование и контракт: фиксация версии, контрактов и схем.
- Валидация и качество: автоматические тесты, проверки соответствия контрактам.
- Развертывание в оффлайн/онлайн_STORE: настройка источников, кэширования, согласование задержек.
- Мониторинг и обновление: drift, качество, регрессионные тесты.
- Эволюция и де-публикация: управление устареванием признаков, миграции версий.
Метрики и KPI
- Скорость внедрения признаков: время от идеи до рабочего признака в пайплайне.
- Повторное использование признаков: коэффициент повторного использования признаков между моделями.
- Точность и качество моделей: влияние признаков на метрики (AUC, RMSE, log loss).
- Блокирующие зависимости: время простоя пайплайна из-за изменений в контрактах признаков.
- Безопасность и соответствие: соблюдение регламентов, аудит доступа к признакам.
Архитектура и технологическая реализация
Архитектурная модель
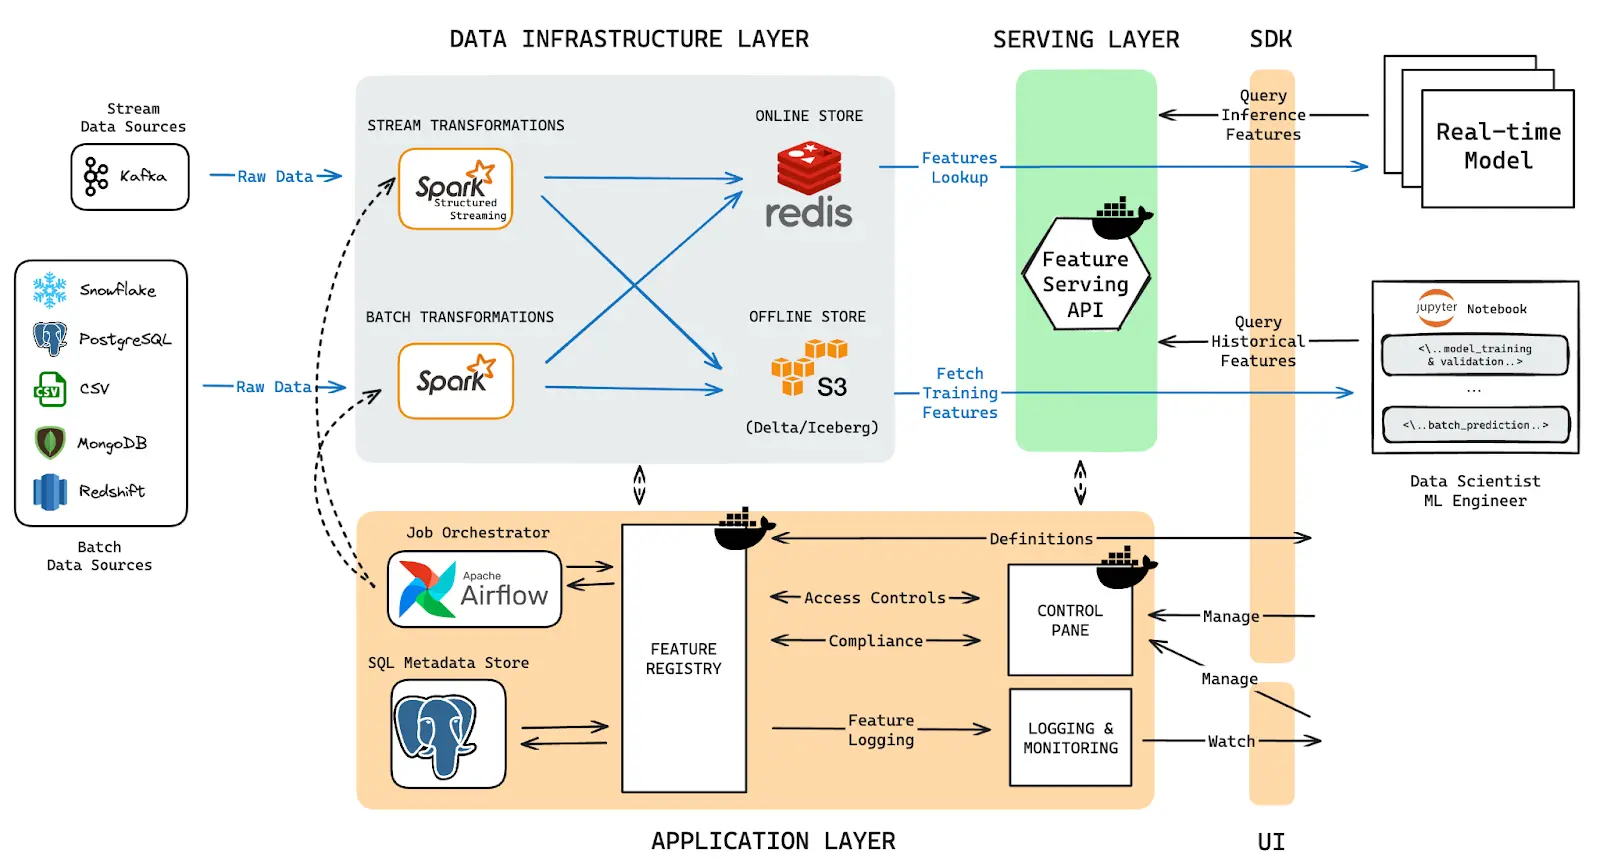
- Источник данных → Preprocessing/Feature Engineering → Feature Store (offline) → Feature Serving Layer (online) → ML модели/пайплайны обучения → Monitoring/Validation → Управление версиями и контрактами.
- Разделение онлайн и оффлайн слоев обеспечивает баланс между задержкой и доступностью признаков для обучения и инференса в реальном времени.
Компоненты и их взаимодействие
- Data Lake/Data Warehouse: источник «сырых» признаков и агрегированных признаков.
- Feature Store: хранение признаков с сервисами версии, контрактов и управления доступом.
- Feature Serving: API доступа к признакам в онлайн-режиме и для реального времени.
- Оркестраторы пайплайнов: планировщики заданий для обновления признаков (Airflow, Kubeflow Pipelines, Prefect и т.д.).
- Метаданные и каталог: реестр признаков, lineage, версии, контракты.
- Контракты качества и тестирования: единицы измерения, диапазоны значений, аномалия, дрейф.
Пример схемы данных
- Таблица признаков (FeatureGroup) может включать: feature_name, feature_type, domain, source_table, aggregation, window, default_value, version, last_updated, owner.
- В онлайн-слое признаки кэшируются в низкой задержке (например, Redis, RedisTimeSeries) с TTL и ретрибьюцией к оффлайн-значениям.
Пример кода: определение признаков и версия
feature_group: clients
version: v1.0.0
description: Основные признаки клиента для моделей удержания и рекомендации
features:
- name: tenure_days
    type: int
    description: Длительность сотрудничества в днях
- name: avg_session_value
    type: float
    description: Средняя стоимость сессии за последние 30 дней
- name: churn_risk
    type: float
    description: Оценка риска ухода за клиентом
- name: last_contact_days
    type: int
    description: Количество дней с последнего контакта
{
  "feature_group": "clients",
  "version": "v1.0.0",
  "online_store": "redis",
  "offline_store": "clickhouse",
  "license": "internal",
  "owner": "ML Platform Team",
  "validation": {
    "min_values": {"tenure_days": 0},
    "max_values": {"tenure_days": 3650},
    "quantile_checks": {"avg_session_value": [0.0, 1000.0]}
  }
}
Интеграционные сценарии
- Интеграция с пайплайнами обучения через REST/gRPC API: запрос признаков по контракту, кэширование и логирование.
- Мониторинг качества признаков: сигналы drift, пропуски, изменение распределения. Примеры инструментов: Prometheus/Grafana, OpenTelemetry, валидации через Great Expectations.
- Управление доступами: RBAC/ABAC на уровне API признаков, журналирование доступа, соответствие политикам безопасности.
Безопасность и комплаенс
- Встроенная модель разрешений на уровне признаков и контрактов.
- Логирование изменений и аудита доступа к признакам.
- Защита конфиденциальных данных: маскирование, минимизация вывода, контроль над выводом PII-значений.
Организационные и процессные аспекты
Роли и ответственности
- Владельцы признаков (Feature Owners): отвечают за качество, контракт, жизненный цикл и согласование с бизнес-целью.
- Инженеры признаков (Feature Engineers): создание признаков, валидация, тесты качества.
- Архитекторы данных: проектирование архитектуры feature store, интеграций и совместимости между системами.
- Data Scientists и ML-инженеры: потребители признаков, разработка и итерация моделей.
- DevOps/Platform Engineers: CI/CD для признаков, управляемые инфраструктурные пайплайны и мониторинг.
- Контролеры безопасности и комплаенс: обеспечение соответствия политик и регуляторных требований.
Процессы и управление изменениями
- Управление контрактами: формальная фиксация форматов, частоты обновления и ограничений.
- Версионирование признаков: применение semantic versioning (major/minor/patch) для стабильности пайплайнов.
- CI/CD для признаков: автоматическая валидация контрактов, тестовые прогонки на исторических данных, верификация зависимостей.
- Управление данными в продуктах: выпуски фичей по плану, миграции версий, ретропривязки к моделям.
- Непрерывное обучение и обслуживание: циклы обучения, обновление признаков, обратная совместимость.
Практические примеры и кейсы (open-source и российские решения)
Open-source решения
- Feast: один из самых известных открытых фич-стооров. Позволяет хранить признаки оффлайн и онлайн, обеспечивает совместное использование между командами, поддерживает версионирование и контрактную валидность. Пример сценария: построение набора признаков «клиенты» и их использование в нескольких моделях: удержание клиентов, кросс-селлинг.
- Hopsworks Feature Store: интегрированная платформа, предлагающая Feature Store, управление данными и ML-пайплайнами. Хорошо подходит для крупных и сложных сценариев с требованием к качеству и мониторингу.
- ZenML и другие пайплайн-оркестраторы: предоставляют фреймворк для повторяемых ML-конвейеров, включая интеграцию с фич-сторами.
- Apache Iceberg/Delta Lake в связке с фич-архитектурами: обеспечивает управления версионированием больших таблиц признаков и их совместную работу с оффлайн-хранилищами.
Пример сценария использования open-source стеков:
- Архитектура: Feast как слой хранения/доступа к признакам; Redis как онлайн-store; Parquet/ORC в Data Lake как оффлайн-store; Airflow/Kubeflow Pipeline как оркестратор; Great Expectations для тестирования данных и признаков.
- Взаимодействие: аналитики и ML-инженеры публикуют признаки в Feast; модели запрашивают признаки через API Feast; пайплайны обновляют признаки, выполняют валидацию контрактов и регистрируют новые версии.
Российские решения и кейсы
- Применение отечественных технологий в крупных организациях: деплой в рамках инфраструктуры на базе отечественных облачных и локальных решений, с упором на безопасность, соответствие регуляторным требованиям и управляемые единицы доступа. В российском контексте широко применяются открытые стандарты и инструменты (Kubeflow, MLflow, Apache Kafka, ClickHouse, Redis) в сочетании с внутренними сервисами мониторинга и управления доступами.
- Кейс-курсы и пилоты: в банковском секторе и крупных телеком-компаниях регулярно проводятся пилоты по созданию локальных фич-сторов, где онлайн-store реализуется через внутренние кэш-сервисы, а оффлайн-store - через отечественные хранилища данных. Эти проекты подчеркивают важность контрактов данных, согласования частоты обновления и обеспечения устойчивости к регуляторным требованиям.
- Образовательные и исследовательские инициативы: в академических и индустриальных проектах часто демонстрируются архитектурные принципы и методы с применением открытых стеков, адаптированных под отечественные требования к безопасности и управлению данными.
Пользовательский опыт и практические выводы:
- Повторное использование признаков заметно сокращает время разработки моделей и ускоряет цикл ML-проекта.
- Важность контрактов и версионирования: без строгого контроля изменений признаки приводят к несогласованности между обучением и инференсом.
- Непрерывный мониторинг признаков и управление дрейфом: обнаружение и устранение деградаций признаков критично для устойчивости бизнес-метрик.
- Безопасность и доступ: granular access control, аудит и соответствие политикам критичны в банковской и телеком-среде.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
Алгоритмы в контексте видов признаков
- Временные признаки: скользящие агрегаты, окна обновления, экспоненциальное сглаживание.
- Категориальные признаки: целочисленные кодировки, one-hot, частотная кодировка.
- Нормализация и стандартизация: масштабирование для устойчивых моделей.
- Валидация признаков: тесты на валидность значений, пропуски, корректность распределения.
Механизмы версионирования и контрактов
- SemVer для признаков: версии по формату MAJOR.MINOR.PATCH.
- Контракты признаков: спецификации входов/выходов, единицы измерения, частота обновления, зависимые признаки.
- Эдитинг-режим и миграции: поддержка миграций и возврат к предыдущим версиям в случае проблем.
Протоколы взаимодействия
- REST/gRPC API для доступа к признакам онлайн: поддержка аутентификации, авторизации и трассировки.
- Протоколы обмена метаданными: OpenAPI/Protobuf-описания контрактов.
- Репликация и консистентность: стратегии eventual consistency для оффлайн-признаков и строгая согласованность для онлайн-наборов.
Интеграции с пайплайнами обучения
- Пайплайны извлекают признаки через единый контракт, обеспечивая согласование версий и форматов.
- Мониторинг и валидация: интеграция с тестами данных, SLA по задержкам и качеству.
- Автоматизация CI/CD: авто-версионирование признаков, регламентные проверки и откаты.
Примеры архитектурных конфигураций
- Конфигурация 1: Feast + Redis (online) + ClickHouse (offline) + Kubeflow Pipelines (орку) + Prometheus/Grafana (мониторинг).
- Конфигурация 2: Hopsworks Feature Store + Apache Spark на оффлайн-слое и собственный онлайн-слой на Redis, интеграция через AK/SAML-поддержку и роли.
Риски, ограничения и типовые ошибки
- Несоответствие контрактов и реальных данных: выявление несоответствий на ранних стадиях через тесты качества.
- Перекосы в версиях: несогласованность между обучением и инференсом при обновлениях признаков; решение - строгие миграции и откаты.
- Неполный контроль доступа: нарушение регуляторных требований; требуется многоуровневая модель RBAC/ABAC и аудит.
- Задержки в онлайн-поиске признаков: баланс между latency и точностью; выбор оптимального онлайн-store и кэширования.
- Сложности интеграции с устаревшими пайплайнами: миграции к новым инструментам должны быть поэтапными и с тестовой зоной.
- Объемы данных и стоимость: хранение признаков больших объёмов требует эффективных форматов, компрессии и очистки.
Типовые ошибки:
- Пренебрежение версиями контрактов: новые версии без поддержки обратной совместимости.
- Пренебрежение тестированием признаков: отсутствие валидаторов и тестов качества.
- Неправильное управление доступами: слишком широкие разрешения на признаки, риск утечки данных.
- Неэффективное мониторирование: отсутствие сигналов о дрейфе и деградации признаков.
Перспективы развития направления
- Расширение моделирования признаков: автоматическое создание признаков на основе событий и паттернов поведения.
- Улучшение управления контрактами: более формальные контракты и автоматизированная валидация на стадии разработки.
- Более тесная интеграция с бизнес-дрорами: признаки как продукт; сервисы поддержки принятия решений для бизнес-единиц.
- Расширение возможностей онлайн-обработки: ускорение инференса и адаптация к микросервисной архитектуре.
- Укрепление безопасности и комплаенса: усиление мониторинга доступа и аудита.
Заключение
Признаки - это не только технические артефакты. Это связующее звено между бизнес-целями, данными и моделями, которое, правильно управляемое, превращает данные в ценность. Эффективная архитектура feature store, версионирование признаков, управление контрактами и продуманная интеграция с пайплайнами обучения позволяют организациям быстро разворачивать новые решения, снижать издержки и минимизировать риски. В цифровой трансформации именно способность повторно использовать признаки и управлять ими становится критическим фактором успеха: она ускоряет обучение, повышает качество моделей и обеспечивает прозрачность процессов для бизнеса и регуляторов.
FAQ (Вопрос-Ответ)
Что такое признак и зачем нужен feature store?
Признак - это параметризованный объект, который может использоваться ML-моделями как входной фактор. Feature store централизует хранение, версии и доступ к признакам, обеспечивает повторное использование и согласование контрактов между командами, что снижает дублирование логики и ускоряет разработку.
Как связаны бизнес-цели и признаки?
Бизнес-цели переводятся в набор KPI, которые можно поддержать через признаки. Например, удержание клиента может зависеть от признаков активности, вовлеченности и времени отклика; признаки позволяют моделям предсказывать риск и формировать действия бизнеса.
В чем разница между оффлайн и онлайн store в feature store?
Оффлайн-store предназначен для обучения и исторического анализа; онлайн-store - для быстрого доступа к актуальным признакам во время инференса. Совместными они образуют полный цикл управления признаками.
Какие стратегии версионирования применяют к признакам?
Семантическая версионизация (SemVer) и контрактное версионирование: версии обозначают изменения в формате, диапазонах значений и обновлениях источников. Это позволяет откатывать изменения и поддерживать совместимость.
Какие риски наиболее часты при внедрении feature store?
Несоответствие контрактов данным, неверная миграция версий, нарушение доступа и регуляторных требований, задержки в онлайн-доступе. Планирование тестирования, мониторинга и аудита снижает такие риски.
Какие методы контроля качества признаков существуют?
Валидаторы контрактов, тесты на распределение значений, проверки на пропуски, drift-мониторинг, тестовые прогонки на исторических данных, мониторинг латентности и доступности онлайн-слоя.
Какие практические шаги к началу реализации...?
Определить бизнес-цели и ключевые модели, сформировать набор признаков, согласовать контракты и версии, выбрать стек технологий, внедрить CI/CD вокруг признаков, наладить мониторинг и аудит, запустить пилот и расширение на новые домены.
Как избежать типовых ошибок в интеграции признаков с пайплайнами обучения?
Сформировать единый контракт признаков, задать инструкции по миграциям версий, внедрить тесты качества, обеспечить согласование между командой данных и бизнес-единицами, постепенно расширять круг потребителей.
Каковы ориентиры по выбору технологий для российского рынка?
В российском контексте разумно сочетать открытые решения ( Feast, Kubeflow, MLflow, Redis/ClickHouse и т. п.) с локализованными сервисами мониторинга, аудита и управления доступами, ориентируясь на требования безопасности, регуляторные нормы и характер инфраструктуры.
Что считается лучшей практикой при управлении признаками?
Принцип «признаки как продукт»: сервисное обеспечение, документация, контракт и метаданные; строгие политики версионирования; автоматическая валидация и тестирование; комплексный мониторинг и управление доступом; ориентация на повторное использование между моделями и проектах.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


