

Kubernetes как основа ML-инфраструктуры: управление ресурсами и оркестрацией
Краткое введение
Эта глава раскрывает роль Kubernetes как фундаментального элемента инфраструктуры для ML-платформ: от планирования ресурсов и изоляции рабочих нагрузок до сложной оркестрации конвейеров ML и сервинга моделей. В условиях смешанной среды облачных и локальных развертываний (on-premise) Kubernetes обеспечивает единый API, повторяемость инфраструктуры, масштабируемость и управляемость. Понимание механик управления ресурсами, политики безопасности, мониторинга иCOST поможет снизить задержки, избежать перерасхода и повысить надежность ML-операций в рамках MLOps.
Введение
Современные ML-решения проходят путь от экспериментов до промышленной эксплуатации. Это требует не только мощных моделей, но и дисциплины в управлении данными, версиями кода, конфигурациями окружения и затратами. Kubernetes выступает как «операционная платформа» для ML: обеспечивает контейнеризованные сервисы, оркестрацию задач по конвейерам, гибкое масштабирование и защиту multi-tenant окружения. В этой главе мы формируем концептуальные основы, затем переходим к архитектуре и практическим решениям, которые применяются в реальных проектах, включая примеры open-source и российские решения.
Теоретические основы и терминология
- MLOps и DevOps для ML: различие в цикле обучения и развёртывания, требования к повторяемости, аудитируемости и управлению версиями.
- Kubernetes: кластеры, ноды, поды, контейнеры, namespace, kube-apiserver, контроллеры, scheduler.
- Управление ресурсами: requests/limits, очередь планирования, QoS, лимиты по CPU/GPU, выделение памяти и видеокарт.
- Маштабирование: вертикальное (vertical scaling) и горизонтальное (horizontal scaling); Horizontal Pod Autoscaler (HPA), Cluster Autoscaler, KEDA.
- Оркестрация конвейеров: Argo Workflows, Tekton, Kubeflow Pipelines; CRD-based расширения для ML-пайплайнов.
- Сервинг моделей: KFServing, Seldon Core, KServe; онлайн и офлайн индексация моделей.
- Наблюдаемость: Prometheus, Grafana, OpenTelemetry; телеметрия по метрикам качества модели, задержкам, затратам.
- Безопасность и соответствие: RBAC, IAM в облаках, сетевые политики, секреты и управляемый доступ к данным.
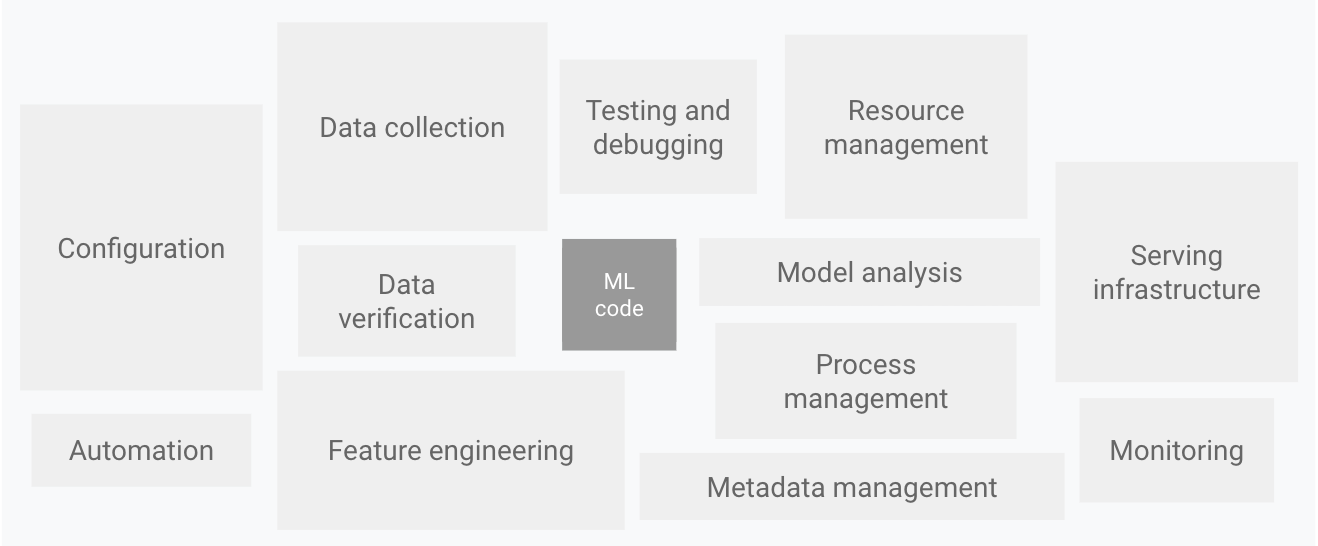
Термины и концепты представлены здесь как единый набор: чем более вы точно поймете их сопоставления, тем эффективнее будет внедряться инфраструктура под ML в рамках вашей организации.
Методологии и подходы
- GitOps для ML: хранение конфигураций инфраструктуры и конвейеров в Git, применение изменений через автоматизированные пайплайны и источники правды.
- Инфраструктура как код (IaC): Terraform, Pulumi, Kubernetes manifests и Helm чарты для единообразного развёртывания.
- Управление затратами через ресурсоориентированное планирование: лимитирование GPU/CPU, квоты на namespace, мониторинг затрат по сервисам.
- Многоарендность и изоляция: пространственная и временная сегрегация; политические и технологические способы защиты данных.
- Стратегии выкатывания: canary, blue/green, A/B тестирование моделей на проде; мониторинг бизнес-метрик контроля качества.
Как правило, успешная MLOps-реализация строится на сочетании этих подходов: GitOps + IaC + продвинутое управление ресурсами в Kubernetes + устойчивые конвейеры ML.
Архитектура и технологическая реализация
Архитектурная модель
- Уровень данных: Data Lake / Feature Store; доступ к данным через безопасные каналы, контроль версий наборов данных.
- Compute и управление ресурсами: Kubernetes кластер (облако, on-premise или гибрид), узлы с CPU, GPU (NVIDIA), TPU-аналоги, с поддержкой device plugins.
- Платформа ML: набор сервисов для обучения, валидации, тестирования и сервинга моделей (Kubeflow Pipelines, MLflow, Seldon/KServe).
- Наблюдаемость и безопасность: централизованный сбор метрик, журналирование, мониторинг затрат, политики безопасности и сетевые ограничения.
Компонентный состав
- Kubernetes-кластер с поддержкой GPU и мульти-ардо-сетей.
- Argo Workflows / Kubeflow Pipelines для оркестрации пайплайнов.
- Сервисы сервинга моделей: Seldon Core / KServe (KFServing) для масштабируемого онлайн-сервинга.
- Инструменты наблюдаемости: Prometheus, Grafana, Loki, OpenTelemetry.
- Инструменты CI/CD: Jenkins X, Argo CD, Flux для GitOps.
Пример конфигурации ресурса и ресурсоориентированной установки
- Пример Deployment для сервинга модели с ограничениями ресурсов:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: model-service
  namespace: ml
spec:
  replicas: 3
  selector:
    matchLabels:
      app: model-service
  template:
    metadata:
      labels:
        app: model-service
    spec:
      containers:
- name: model
        image: registry.example.com/ml/model-serving:latest
        resources:
          requests:
            cpu: "2"
            memory: "8Gi"
            nvidia.com/gpu: "1"
          limits:
            cpu: "4"
            memory: "16Gi"
            nvidia.com/gpu: "1"
        ports:
- containerPort: 8080
        livenessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 30
          periodSeconds: 15
        readinessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
- Пример Argo Workflow для обучения и реинференсации модели:
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: ml-train-
spec:
  entrypoint: train
  templates:
- name: train
    dag:
      tasks:
- name: data-prep
        template: script
        arguments:
          parameters: [{name: dataset, value: "s3://bucket/feature-data-v1"}]
- name: train-model
        template: script
        dependencies: [data-prep]
        arguments:
          parameters: [{name: data, value: "{{workflow.inputs.parameters.dataset}}"}]
- name: register-model
        template: script
        dependencies: [train-model]
- name: script
    container:
      image: registry.example.com/mlops/scripts:latest
      command: ["bash", "-c"]
      args: ["python run.py --param {{inputs.parameters.dataset}}"]
- Пример конфигурации Kubeflow Pipelines для рабочего конвейера обучения и валидации модели (упрощённо):
apiVersion: tekton.dev/v1beta1
kind: Pipeline
metadata:
  name: ml-pipeline
spec:
  workspaces:
- name: workspace
  tasks:
- name: acquire-data
    taskRef:
      name: fetch-data
- name: train
    runAfter: [acquire-data]
    taskRef:
      name: train-model
- name: evaluate
    runAfter: [train]
    taskRef:
      name: evaluate-model
Разграничение окружений и безопасная интеграция
- Разделение окружений через namespace: dev, staging, prod.
- Секреты и конфигурации: Kubernetes Secrets, интеграция с Vault или AWS Secrets Manager; минимизация объёмов секретов в образах.
- Сетевые политики и service mesh: Istio или Linkerd для контроля трафика, аутентификации и шифрования между компонентами.
Управление затратами и ресурсоориентированное планирование
- Градиентная настройка лимитов: строгое требование по requests/limits для CPU, памяти и GPU, чтобы избежать «проскальзывания» в счетах.
- Автоматическое масштабирование: Cluster Autoscaler по размеру кластера и Horizontal Pod Autoscaler по нагрузке на сервисы.
- Гибридное размещение: перенос вычислений между облачными узлами и on-prem узлами с учётом латентности и стоимости.
- Мониторинг затрат в реальном времени: метрики по использованию GPU, задержкам сервиса, стоимости операций и хранения.
Организационные и процессные аспекты
- Роли и ответственность: МL-инженеры, SRE, Data Engineers, DevOps; роли должны быть четко определены в рамках Policy-as-Code.
- Управление версиями и аудита: все конфигурации и конвейеры версионируются в Git; каждое изменение сопровождается ревью и тестированием.
- Политики доступа и соответствие: RBAC, разделение прав доступа по проектам и данным; соответствие требованиям GDPR/локализации данных в зависимости от региона.
- Управление данными и метаданными: версии наборов данных, контроль целостности, линейная история изменений, Data Lineage.
- Контроль качества и валидации моделей: наборы тестов, проверка drift, мониторинг промахов и мануалового отката.
Практические примеры и кейсы (open-source и российские решения)
Open-source решения
- Kubernetes как база для MLOps: управляемые кластеры, мульти-tenant окружения, гибкое масштабирование.
- Kubeflow Pipelines: оркестрация ML-конвейеров; интеграция с Argo Workflows.
- Seldon Core / KServe: сервисинг моделей; canary-обновления, A/B-тестирование моделей.
- KFServing / KServe: modern serving и адаптация к различным фреймворкам.
- Argo CD / Flux: GitOps для развертывания инфраструктуры и конвейеров.
- Prometheus, Grafana, OpenTelemetry: мониторинг и трассировка производительности.
Российские решения и примеры внедрений
- Яндекс DataSphere: отечественная платформа для моделирования и поставки ML-сервисов в рамках экосистемы Яндекс.Облако; обеспечивает интеграцию с Kubeflow/KServe-слоем и управление данными.
- Локальные интеграции Kubeflow на инфраструктуре российских дата-центров: проекты, реализующие совместное использование открытых инструментов с требованиями локализации данных и соответствия регуляторным нормам.
- Партнёрские экосистемы и вендоры: отечественные системные интеграторы, предлагающие готовые решения на базе Kubernetes для ML, включая настройку пайплайнов, безопасную обработку данных и управление затратами.
Важно помнить: российские решения чаще всего выступают как адаптации открытых проектов под требования локализации, регуляторики и поддержки отечественных сервисов. Выбор зависит от требований к хранению данных, доступности специалистов и уровня поддержки.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Планирование ресурсов и расписание задач: алгоритмы планирования Kubernetes, использование QoS классов, привязка GPU через device plugins.
- Обеспечение изоляции: создание отдельных namespaces, ограничение network policy, RBAC, секреты и шифрование.
- Контейнеризация и окружения: управление образами, версионирование окружения, артефакты и контейнерная совместимость между обучением и сервингом.
- Интеграция пайплайнов: Kubeflow Pipelines / Argo Workflows связывают этапы подготовки данных, обучения, валидации и деплоймента модели.
- Протокол уровня сервинга: REST/gRPC API для сервинга, настройка автомасштабирования, сигналы health-check и graceful shutdown.
- Учет данных и Feature Store: интеграция с источниками данных и хранение фичей, версионирование признаков, доступность к конвейерам и моделям.
- Безопасность и управление доступом к данным: управление ключами, секретами и доступом к данным по ролям и политикам.
- Мониторинг и телеметрия: метрики задержек, ошибок, точности моделей, деградации; сбор и агрегация логов.
Риски, ограничения и типовые ошибки
- Недостаточное планирование ресурсной политики и GPU-агрегирования, что приводит к перерасходу или задержкам.
- Отсутствие единого репозитория конфигураций и артефактов, что усложняет воспроизведение экспериментов.
- Некачественные конфигурации сетевых политик и секретов, риск утечки данных.
- Несогласованность между окружениями dev/stage/prod: различия в версиях зависимостей, образов и пайплайнов.
- Неполноценная система мониторинга качества моделей и drift-детекции, что повышает риск деградации продовых сервисов.
- Ограничения в локализации данных и соответствие регуляторным требованиям в рамках российского рынка.
Перспективы развития направления
- Гибридная многокластерная архитектура: единая платформа управления в условиях разных облаков и локальных дата-центров.
- Edge-вычисления и удалённый сервинг: адаптация моделей на краю сети с минимальной задержкой и локальной обработкой данных.
- Federated и privacy-preserving ML: обучение на распределённых данных без их передачи.
- Повышение автоматизации: автономное управление затратами, автоматизированное тестирование моделей, self-healing пайплайнов.
- Усовершенствование мультилинейных архитектур и сервисов сервинга: ускорение инкрементных обновлений, поддержка гибридных пайплайнов и новая волна инструментов для QoS и latency-требований.
Заключение
Kubernetes выступает не просто как инструментарий развертывания, а как фундаментальная платформа для масштабируемого, воспроизводимого и управляемого ML в условиях cloud и on-premise. Правильная архитектура, дисциплинированные процессы и интеграции с современными инструментами позволяют строить устойчивые ML-операции, где скорость экспериментов сочетается с надёжностью продакшена и эффективностью затрат.
Вопрос-Ответ (FAQ)
Почему Kubernetes считается основой ML-инфраструктуры?
Потому что он обеспечивает единый API для развертывания и масштабирования контейнеризованных сервисов, позволяет управлять ресурсами (CPU, память, GPU), гарантирует изоляцию и повторяемость окружений, а также упрощает интеграцию с пайплайнами и сервисами сервинга моделей. Это уменьшает фрагментацию инфраструктуры между экспериментами и продакшеном.
Какие существуют способы сервинга моделей в Kubernetes?
KFServing / KServe: современная инфраструктура сервинга, поддерживающая разные фреймворки и стратегии обновления.
Seldon Core: платформа для развёртывания моделей и их масштабирования с поддержкой canary и drift-мониторинга.
Argo Rollouts и Canary/Blue-Green: управление стратегиями развёртывания сервисов.
Встроенная инфраструктура через Kubeflow или MLflow для управления конвейерами и артефактами.
Как эффективно управлять затратами в мультиоблачной среде?
Вводите квоты на namespace и лимиты на темп роста пулов ресурсов.
Используйте автоскейлинг кластеров и HPA для рабочих нагрузок; разделяйте нагрузку между облаком и on-prem.
Мониторьте GPU-использование и задержки сервиса; оптимизируйте размер батчей и параллелизм.
Применяйте GitOps и IaC для прозрачного контроля изменений и снижения избыточности конфигураций.
Как обеспечить воспроизводимость и управляемость экспериментов?
Версионируйте данные, код и конфигурации в Git; применяйте Data Version Control для набора данных.
Используйте артефакт-репозитории для моделей и конвейеров; фиксируйте зависимости в образах.
Протоколируйте параметры пайплайна и результаты экспериментов; храните линейную историю изменений.
Какие риски безопасности чаще всего возникают в ML-кластерах?
Неправильные конфигурации RBAC и сетевых политик; утечки секретов через неправильное хранение.
Нарушение конфиденциальности данных при использовании общих пайплайнов.
Недостаточная сегрегация между проектами и недостаточный контроль доступа к данным.
Какие преимущества дает использование Kubeflow Pipelines или Argo Workflows?
Автоматизация и трекерование конвейеров; воспроизводимость результатов; разделение ролей между учётом данных и обучением.
Поддержка повторяемых пайплайнов с повторной сборкой артефактов и повторной тренировкой моделей.
Какие открытые и российские решения применимы в рамках такой архитектуры?
Open-source: Kubernetes, Kubeflow Pipelines, Argo, Seldon Core, KFServing/KServe, Prometheus/Grafana.
Российские решения: Яндекс DataSphere и отечественные интеграционные проекты на базе Kubeflow/KServe, адаптированные под локальные требования локализации данных, регуляторику и техническую поддержку.
Какие типичные ошибки при внедрении ML-инфраструктуры на Kubernetes?
Игнорирование resource requests/limits, что приводит к нестабильности и перерасходу.
Отсутствие единообразия в окружениях dev/stage/prod.
Неполная защита секретов и недостаточная сегрегация между проектами.
Недостаточный мониторинг качества моделей, drift и задержек.
Каковы перспективы использования edge-вычислений в сочетании с Kubernetes?
Возможность разворачивания сервисинга ближе к данным и пользователям, снижение задержек и e2e стоимости.
Управление конвейерами и моделями на краю через облегчённые кластеры Kubernetes или Kubernetes-самодостаточные решения.
Как начать внедрение Kubernetes в ML в вашей организации?
Определите требования к данными, ответственностям и регуляторике.
Спроектируйте архитектуру кластера с учётом рабочих нагрузок (обучение, валидация, сервинг), выберите соответствующие инструменты (Kubeflow/KServe).
Реализуйте IaC и GitOps-подход, настроьте мониторинг и безопасность.
Постепенно внедряйте конвейеры обучения и сервинга, добавляйте верификацию и drift-мониторинг, развивайте культуру воспроизводимости.
Эта глава обеспечивает прочную основу для понимания того, как Kubernetes формирует основу ML-инфраструктуры, и предлагает конкретные практические решения для эффективной реализации в условиях облака, on-premise и гибридных сценариев.
Если ваша компания планирует внедрение машинного обучения или масштабирование AI-решений, ключевым фактором успеха становится правильная архитектура платформы данных и MLOps-инфраструктуры.
Узнайте, как реализовать искусственный интеллект для бизнеса от стратегии до внедрения: от оценки готовности компании и выбора архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы.


