

Практические кейсы: розничная торговля и производство
Краткое введение
Эта глава иллюстрирует практические применения MLOps в двух типах отраслей - розничной торговле и производстве - на стыке облака и on-premise. Мы рассмотрим не только технологические решения, но и архитектурные паттерны, организационные роли, процессную культуру и экономику владения инфраструктурой. Цель - показать, как правильно сформировать инфраструктуру, чтобы обеспечить масштабирование, управляемые затраты и спокойное внедрение моделей в продакшн в условиях реальных бизнес-требований.
Введение
Rоль MLOps в современной организации выходит за рамки «построить модель обучить и запустить» и превращается в управляемый жизненный цикл, где данные, инфраструктура и процессы взаимосвязаны. В розничной торговле и на производстве ставки высоки: скорость реакции на спрос, точность прогнозов, качество продукции и устойчивость к сбоям критически важны. В такой среде целесообразно реализовывать гибридные архитектуры, которые объединяют преимущества облака - эластичность, управляемость и скорости вывода новых сервисов - и преимущества on-premise - контроль над данными, соответствие регуляторным требованиям и возможность низкоуровневой оптимизации стоимости.
Теоретические основы и терминология
- Облако против on-premise: компромиссы между скоростью разработки, задержками в цепочке поставок данных, юридическими ограничениями и общей стоимостью владения (TCO).
- Гибридная архитектура: стратегия, когда часть данных и вычислений сохраняется локально, а обработка и обучение моделей выполняются в облаке или в гибридном окружении.
- МLOps-цикл: сбор данных → подготовка данных → обучение моделей → валидация → развёртывание → мониторинг → обновления.
- Функциональные компоненты инфраструктуры:
- Data Lake / Data Warehouse: репозиторий «сырого» и агрегированного набора данных.
- Feature Store: централизованное хранилище признаков с версиями и доступностью для повторного использования.
- Model Registry: реестр версий моделей, зависимостей и метаданных.
- Training & Serving Infrastructure: окружение для обучения, валидации и онлайн/оффлайн сервирования.
- Monitoring & Observability: сбор и анализ метрик качества, задержек, деградации модели.
- Open-Source технологии: Kubeflow, MLflow, Apache Airflow, Feast, DVC, Seldon Core, KServe.
- Российские решения и экосистема: Яндекс DataSphere, Яндекс.Облако MLOps-инструменты, интеграции с локальными дата-центрами и средствами управления безопасностью данных.
Методологии и подходы
- Архитектура по слоям: данные, признаки, модели, сервисы, мониторинг. Каждый слой должен иметь собственные политики доступа, версионирование и тестирование.
- Контроль доступа и соответствие требованиям: роль-ориентированное управление, пониженный доступ на уровне инфраструктуры, аудит и ретроспективы изменений.
- Управление затратами: построение экономических моделей на основе сценариев использования (пиковые нагрузки, прогон тестирования, регрессионное тестирование) и применение политики масштабирования.
- Гибридное управление данными: локальное хранение чувствительных данных, репликация в безопасном режиме в облаке, использование инфраструктурных протоколов для согласования схем и трансформаций.
- Observability как ядро: прозрачность во всех стадиях цикла, раннее обнаружение деградаций, информирование бизнес-заинтересованных лиц.
Архитектура и технологическая реализация
Общие принципы
- Архитектурный паттерн «единая платформа - разнесённые исполнители»**: единая платформа данных и моделей поддерживает множество доменов и бизнес-сценариев.
- Модели «первичных источников» (data-first) и «модели как код» (MLOps как код) - управление через инфраструктуру как код (IaC).
- Data locality и latency considerations: регионализация данных, дата-сегментация по странам и по сетевым траекториям, чтобы минимизировать задержки и соответствовать регуляторике.
- Инфраструктура как код: Terraform, Ansible, Kubernetes manifests, GitOps-подходы для автоматизации развёртывания.
Компоненты архитектуры
- Data Ingestion и Processing:
- Потоки данных POS/ERP, онлайн-события из e-commerce, IoT-сенсоры на производстве.
- Streaming + Batch обработка: Apache Kafka + Spark Structured Streaming, Apache Flink.
- Data Layer и Feature Store:
- Raw Layer, Cleansed Layer, Feature Layer.
- Feast (open-source) для управления признаками, версии признаков и совместного использования между командами.
- Model Lifecycle:
- Experiment Tracking: MLflow, Kubeflow Experiments.
- Model Registry: MLflow Registry, Kubeflow Metadata, или интеграции с собственным реестром.
- Training и Validation:
- Эндпойнты для обобщённых пайплайнов обучения, автоматическое сравнение моделей, сиды для воспроизводимости.
- Serving и Inference:
- Online serving (REST/GRPC) и Batch inference.
- Сервисы на Kubernetes, Seldon Core / KServe для моделей в режиме контейнеров.
- Monitoring, Observability и Governance:
- Метрики точности, задержки, деградации, drift, качество данных.
- Роли и политики доступа, аудит изменений, регламент управления версиями.
- Edge и Local Processing:
- Предобучение и базовая обработка на периферийных устройствах, локальные инфра-структуры для минимизации задержек и сохранения данных внутри локального периметра.
Организационные и процессные аспекты
- Роли и ответственности:
- data engineer, ML engineer, data scientist, platform engineer, devops-инженер, бизнес-аналитик.
- Владельцы доменов (product owners) за KPI проектов: точность прогноза, SLA сервиса, циклы обновления.
- Управление данными и безопасностью:
- Политики доступа по нуждам домена, аудит, защита личных данных, соответствие регламентам (регламент GDPR/РФ-ЮЛ).
- Процессы разработки и внедрения:
- Ревью моделей, непрерывная интеграция моделей, контроль качества данных, регуляции обновлений.
- Непрерывная доставка (CD) пайплайнов: от pipeline-definition до продакшн-реализаций.
- Экономика владения инфраструктурой:
- Сценарии использования: часы пик, ночное моделирование, еженедельное обновление.
- Распределение расходов между облаком и локальной инфраструктурой, мониторинг затрат на уровне проектов.
- Управление изменениями и образование персонала:
- Подготовка специалистов, внутренние курсы, обмен опытом между командами.
Практические примеры и кейсы (open-source и российские решения)
- Розничная торговля:
- Сектор спроса и запасов: прогнозирование спроса по SKU, управление запасами на уровне склада и магазина, динамическое ценообразование.
- Реализация через гибридную архитектуру:
- Облако для обработки больших данных, обучения сложных моделей, хранения артефактов.
- On-premise для чувствительных данных, задержек, реального времени в торговых точках.
- Open-source примеры:
- Kubeflow Pipelines для оркестрации пайплайнов.
- Feast как центральный слой признаков.
- Seldon Core для онлайн-сервинга моделей.
- Российские решения и интеграции:
- Яндекс DataSphere и экосистема Яндекс.Облако: инструменты для подготовки данных, управления моделями и мониторинга на уровне корпоративной инфраструктуры.
- Интеграции с локальными дата-центрами через безопасные каналы, соответствие требованиям по защите данных.
- Производство:
- Предиктивное обслуживание и контроль качества продукции: анализ данных с датчиков, изображений, операционных журналов MES/SCADA.
- Архитектура:
- Edge-вычисления для первичной фильтрации и предсказаний на месте (периферия производства).
- Облачная обработка для обучения, ретроспективного анализа и долговременного хранения.
- Open-source примеры:
- Apache Kafka + Spark для потоков данных, MLflow для управление экспериментами и ветками моделей.
- Kubeflow/TFServing/KServe для развёртывания моделей в промышленной инженерной среде.
- Российские решения:
- Локальная интеграция через Яндекс DataSphere и инструменты управления доступом, встроенная безопасность и соответствие регуляторным требованиям.
- Взаимодействие с MES/SCADA через адаптеры и коннекторы, обеспечение согласованности времени и синхронизации метрик качества.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
Алгоритмы и подходы
- Модели прогнозирования спроса в рознице:
- Модели временных рядов: Prophet, ARIMA, SARIMA.
- Градиентные бустинги и нейронные сети для мультисерийных данных: XGBoost, LightGBM, DeepAR.
- Рекомендательные системы: Matrix Factorization, распространение через нейронные сети.
- Производственные модели и анализ качества:
- Обнаружение отклонений: Isolation Forest, LOF, Autoencoder для аномалий.
- Визуальные модели для контроля качества: CNN/Transformers для инспекции изображений продукции.
- Обучение и ресурсная эффективность:
- Градиентный бустинг против нейронных сетей: выбор по объёму данных и требуемой точности.
- Гиперпараметрический поиск: Bayesian Optimization, Population-based Training.
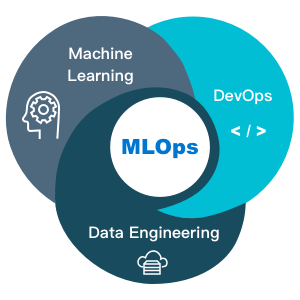
Архитектура реализации
- Пайплайны:
- Data Ingestion -> Data Cleaning -> Feature Engineering -> Model Training -> Validation -> Registry -> Serving.
- Инфраструктура как код:
- Terraform / Kubernetes manifests / Helm charts.
- GitOps: ArgoCD, Flux для автоматизированного развёртывания пайплайнов и сервисов.
- Безопасность и соответствие:
- Шифрование в покое и в передаче, управление ключами (KMS), аудит доступа, контроль версий.
- Интеграции:
- MES/ERP в производстве, POS/CRM в рознице, Data Lakehouse для унификации данных.
- API-шлюзы для взаимодействия между сервисами, Kafka для обмена событиями.
- Протоколы и форматы данных:
- Apache Parquet/ORC для столбцовых форматов, JSON/Avro для потоков.
- REST/GRPC для взаимодействия сервисов, MQTT для IoT-устройств.
Кейс-ориентированные примеры реализации
- Пример реализации для розничной торговли (Open-Source):
- Архитектура пайплайна: Ingestion (Kafka) → Cleaning (Spark) → Features (Feast) → Training (Kubeflow) → Serving (Seldon Core) → Monitoring (Prometheus + Grafana).
- Пример сценария: прогноз спроса по SKU на горизонте 28 дней, обновление модели каждую неделю, A/B тестирование изменения требований по регионам.
- Таблица сравнения: тестовый сценарий vs продакшн, метрики точности и отзывов бизнеса.
- Пример реализации для производства (Российские решения):
- Архитектура: Edge-сервисы для сбора датчиков → локальная обработка → отправка агрегированных данных в Яндекс DataSphere → тренинг облачных моделей → онлайн-сервинг через локальные шлюзы.
- Пример интеграции: CCTV-аналитика для контроля качества, соединение с MES-системой через адаптеры и коннекторы.
- Безопасность: локальная обработка критичных данных, централизованный аудит и соответствие регламентам.
Технические детали реализации (конкретные шаги)
- Настройка пайплайна в Kubeflow Pipelines:
- Шаги: данные, предобработка, обучение, валидация, деплоймент.
- Включение метрик качества и отслеживания деградаций.
- Внедрение Feast для признаков:
- Определение схем признаков, версии признаков, политика обновления и доступности.
- Управление моделями в реестре:
- Регистрация артефактов, метаданных и зависимостей; механизмы отката к предыдущим версиям.
- Настройка мониторинга и алёртов:
- Метрики точности, задержек сервиса, деградации качества данных, drift признаков.
- Пример конфигурации (yaml-фрагмент):
- Конфигурация пайплайна Kubeflow, контейнеры с версиями моделей, параметры гиперпараметров, политики обновления.
Климат затрат: риски, ограничения и типовые ошибки
- Риски и ограничения:
- Недостаточная прозрачность источников данных и качество данных (data quality).
- Сложности с интеграцией данных из разных систем и эпох.
- Непредсказуемые затраты при масштабировании и миграции между облаком и локальной инфраструктурой.
- Проблемы соответствия: регулирование по данным, локализация хранения, контроль доступа.
- Типовые ошибки:
- Бездумная миграция в облако без учета регуляторных ограничений и скорости доступа к данным.
- Игнорирование роли данных и признаков внутри пайплайна - проблемы с повторным использованием.
- Недооценка важности мониторинга: деградации и drift остаются незамеченными.
- Митигирующие практики:
- Пошаговая миграция: сначала тестовые проекты, затем по доменам, затем масштаб.
- Четкое определение SLA и KPI для каждого сервиса.
- Внедрение observability на ранних этапах разработки.
Перспективы развития направления
- Технические тенденции:
- Развитие гибридной инфраструктуры и политики data residency.
- Усовершенствование организаций пайплайнов с использованием AI-driven governance.
- Расширение возможностей edge вычислений для производства.
- Повышение эффективности обучения за счёт автоматического выбора архитектур и гиперпараметров.
- Организационные перспективы:
- Введение роли платформа-инженера, ответственного за единое управление пайплайнами и ресурсами.
- Укрепление взаимодействия между ИТ, бизнес-единицами и отделами data science.
- Расширение использования российских решений и интеграций с глобальными инструментами (оптимизация соответствия и локализации).
Заключение
Практические кейсы в розничной торговле и производстве демонстрируют, как архитектура MLOps должна быть спроектирована с учётом требований к скорости, точности и управляемости. Гибридные подходы позволяют сочетать сильные стороны облака и локальных инфраструктур, обеспечивая соответствие регуляторным требованиям и минимизацию затрат. Внедрение продуманной архитектуры, методологий разработки и операционного контроля превращает ML в системный ресурс бизнеса, который способен адаптироваться к изменениям спроса и условий производства, обеспечивая устойчивый и предсказуемый рост.
Вопрос-Ответ (FAQ)
В чем основное преимущество гибридной инфраструктуры для MLOps?
Гибридная инфраструктура позволяет сочетать масштабируемость и скорость разработки облака с контролем над данными и задержками, которые критичны в производстве и рознице. Она обеспечивает соответствие требованиям по данным и регуляторике, снижая риски потери доступности и задержек. В реальных сценариях это означает возможность обучать модели в облаке на больших данных, а обслуживать в реальном времени на локальных узлах ближе к источникам данных.
Какие архитектурные слои наиболее критичны в розничной торговле?
Data Layer (raw, cleansed, feature), Feature Store, Model Registry, Training/Serving Infrastructure, Monitoring. Важна тесная связь между слоями для быстрой адаптации к изменению спроса и обновлениям моделей.
Как выбирать между использованием Feast и локальным решением для признаков?
Feast обеспечивает единое хранилище признаков, совместное использование между командами и версионирование признаков. Локальные решения могут потребовать больше усилий на интеграцию, но дают больший контроль над данными и политиками доступа. Выбор зависит от потребности в скорости обновления признаков, регуляторных требований и масштаба проектов.
Какие open-source инструменты наиболее применимы в производственных условиях?
Kubeflow (для пайплайнов и экспериментов), MLflow (для отслеживания экспериментов и реестра моделей), Apache Airflow (оркестрация), Seldon Core / KServe (для онлайн сервинга), Feast (для признаков). Для edge-части часто используют контейнеризацию и lightweight сервисы, оптимизированные под аппаратное обеспечение.
Какие российские решения можно использовать в рамках MLOps?
Яндекс DataSphere и экосистема Яндекс.Облако предлагают инструменты для подготовки данных, обучения и мониторинга на корпоративном уровне, а также интеграции с локальными дата-центрами и соблюдением регуляторных требований. Интеграции с MES/SCADA и локальными шлюзами обеспечивают защиту и локализацию данных внутри российского периметра.
Какие важные экономические показатели представлять бизнесу?
Стоимость владения инфраstructure (CAPEX/OPEX), затраты на обучение и хранение данных, стоимость поддержки пайплайнов, задержки и SLA, эффективность алгоритмов (ROMI - return on ML investment). Важно вести моделирование сценариев, чтобы понять, как изменения архитектуры влияют на общую экономику проекта.
Как минимизировать риски деградации моделей?
Внедрить мониторинг drift и деградации на уровне данных и моделей, автоматическую регрессию и тесты качества на продакшне, регулятивную политику контроля версий и отката. Регулярные воспроизводимые тесты и обновления помогают сохранить предсказательную способность моделей.
Как обеспечить соответствие регуляторным требованиям в разных регионах?
Разграничение данных по регионам, хранение чувствительных данных внутри локального периметра, использование шифрования и контроля доступа, аудит изменений и возможность аудита. В гибридной архитектуре можно держать критические данные локально, а аналитические задачи перенести в облако с надлежащими механизмами защиты.
Какие шаги следует предпринять, если начинаем пилот в рознице?
Определите KPI проекта (точность прогноза, скорость реакции, издержки), выберите ограниченный набор SKU и регионов, создайте минимальный пайплайн (данные → признаки → модель → сервис), настройте мониторинг, проведите A/B-тестирование и по итогам приняйте решение о масштабировании.
Какие перспективы инноваций стоит учитывать на горизонте 3-5 лет?
Расширение edge-инфраструктуры для поддержки реального времени в точке продажи; дальнейшее развитие data governance и автоматизированного управления данными; усиление observability и AI-соблюдения; рост использования гибридных и многооблачных стратегий, снижение задержек и повышение прозрачности затрат.
Если ваша компания планирует внедрение машинного обучения или масштабирование AI-решений, ключевым фактором успеха становится правильная архитектура платформы данных и MLOps-инфраструктуры.
Узнайте, как реализовать искусственный интеллект для бизнеса от стратегии до внедрения: от оценки готовности компании и выбора архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы.


