

Введение: мониторинг ML-моделей в продакшене и контроль качества прогнозов
Краткое введение
Данные и модели — это живые системы внутри организации. Мониторинг ML-моделей в продакшене и контроль качества прогнозов становятся критическими для устойчивости бизнес-процессов. Без надежного наблюдения за точностью, стабильностью и соответствием бизнес-целей прогнозы могут приводить к неверным решениям, штрафам за несоответствие регуляторным требованиям и снижению доверия к аналитике. Эта глава закладывает базу для понимания теории, методологий и архитектурных решений в рамках курса: мониторинг ML-моделей в продакшене контроль качества прогнозов, data drift, model drift и бизнес-метрик.
Введение
Цель темы — системно объединить теоретические принципы мониторинга моделей и практические механизмы контроля качества на уровне продакшена. В реальных условиях данные и окружение постоянно меняются: распределения входных признаков дрейфуют, поведение модели может изменяться после обновлений, а бизнес-метрики требуют синхронизации с целями компании. Эффективный мониторинг должен охватывать три взаимосвязанных слоя: данные (data drift и concept drift), модель (model drift и деградация точности) и бизнес-метрики (показатели, напрямую влияющие на бизнес-результаты).
Теоретические основы и терминология
- Мониторинг ML-моделей в продакшене и контроль качества прогнозов — комплекс действий по отслеживанию качества прогнозов, устойчивости к дрейфу и соответствия бизнес-целям.
- Data drift (дрейф данных) — изменение распределения входных данных по сравнению с эталонным периодом.
- Model drift (дрейф модели) — изменение поведения модели вследствие обновления данных, изменения окружения или концептуальных сдвигов в целевой переменной.
- Concept drift — дрейф концепций: целевая зависимость может меняться со временем.
- Бизнес-метрики — показатели, напрямую связанных с целями бизнеса: точность прогнозов, ROC-AUC, калибровка вероятностей, выручка, маржа, коэффициенты конверсий и т.д.
- Calibration и reliability — калибровка вероятностей и надежность прогнозов в разных сегментах.
- SLO/SLI/OKR для моделей — согласование целевых уровней обслуживания, метрик и целей по результатам бизнеса.
- Observability для ML — набор данных, метрик и журналов, позволяющих понять поведение модели в продакшене.
Методологии и подходы
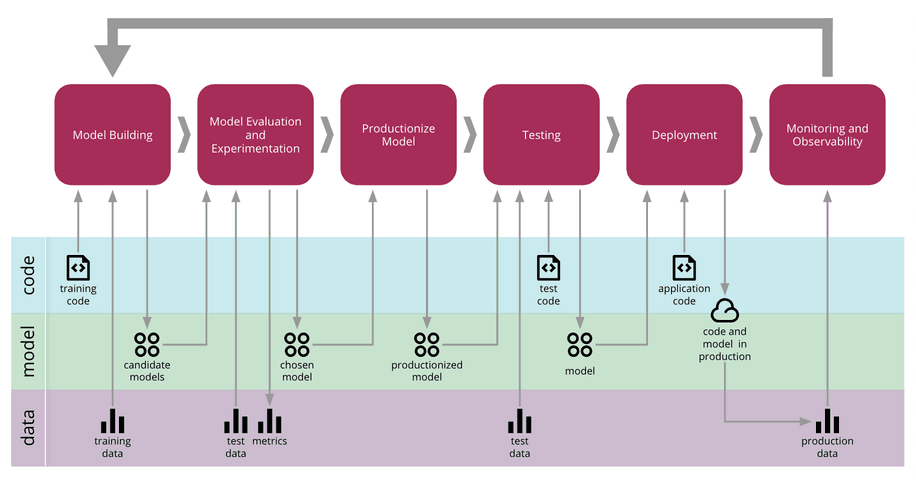
- MLOps и индустриальная практика: цикл жизненного цикла модели (разработка, валидация, развёртывание, мониторинг, обновление) как единое целое.
- Непрерывный мониторинг и пороги тревог: установка пороговых значений для ключевых метрик, автоматические уведомления и эскалация.
- Дрейф-детекция: статистические тесты и алгоритмы для выявления изменений в распределениях данных и в предсказаниях модели.
- Управление рисками: регуляторные требования, безопасность данных и прозрачность моделей через реестр моделей и документацию изменений.
- Архитектура отслеживания: разделение обязанностей между сбором данных, хранением метрик, регистром моделей и сервисами алертинга.
- Гибкость и адаптивность: поддержка разных ML-стэков, включая он-прем, гибридные и облачные среды.
Архитектура и технологическая реализация
- Компоновка слоев мониторинга:
- Источники данных: события сервиса, логи запросов, данные в потоках (Kafka/Kinesis) и хранилища признаков.
- Платформа мониторинга: сбор метрик, треккинг данных и версий моделей.
- Регистры и пайплайны: модельные реестры, версии датасетов и функций обработки признаков.
- Система алертинга: пороги, автоматизированные инциденты и дэшборды.
- Инструменты визуализации: графики трендов, калибровочные кривые и сравнительные дашборды.
- Технологическое наполнение:
- Метрики качества и наблюдаемости: точность, MAE/MSE, ROC-AUC, калибровка, PSI, KS-test, Wasserstein distance.
- Drift-детекция: ADWIN, Drift Detection Method (DDM), PSIn, Evidently AI, open-source решения для мониторинга.
- Трассировка и регистрирование: MLflow, Kubeflow, DVC, Feast (feature store) для сохранения зависимостей и версий.
- Контейнеризация и оркестрация: Docker, Kubernetes, Seldon Core/KServe для развёртывания моделей и мониторинга.
- Инструменты для бизнес-метрик: Prometheus + Grafana, OpenTelemetry, интеграции с BI-системами.
- Пример архитектуры:
- Источник данных -> Feature store -> Модель -> Сервис прогнозов
- Мониторинг данных: расчёт PSI/KS между текущими признаками и эталоном
- Мониторинг моделей: наблюдение за ошибками, дистрибутивами ошибок и скорректированными метриками
- Мониторинг бизнес-метрик: конверсия, маржа, удержание клиента
- Алёрты: при пороговом отклонении — уведомление в Slack/Teams, создание инцидента в ITSM
Организационные и процессные аспекты
- Роли и ответственности:
- Data Scientist: выбор метрик, валидация дрейфа, настройка порогов.
- Data Engineer: обеспечение качества данных, сбор метрик, поддержка пайплайнов.
- ML Engineer/Platform Team: развёртывание и эксплуатация мониторинга, настройка реестров, алертинг.
- Бизнес-аналитик/Продуктовый владелец: перевод бизнес-метрик в требования к мониторингу, согласование SLA.
- IT-операции: управление инцидентами, регуляторная и безопасность.
- Процессы:
- Инцидент-менеджмент для модульных сбоев и дрейфа.
- Change management: влияние обновлений модели на бизнес-метрики и регуляторные требования.
- Регистрация моделей и ревизия: сохранение версий, объяснимость изменений.
- Регулярные аудиты мониторинга и отчётность перед руководством.
- Governance и комплаенс:
- Политики хранения данных и моделей, аудит доступа, прозрачность алгоритмов.
- Подход к объяснимости для регуляторных требований и аудитов.
Практические примеры и кейсы (open-source и российские решения)
-
Open-source кейсы:
-
Мониторинг данных и дрейфа с помощью Evidently AI: анализ PSI, KS-тесты, drift по признакам и целевой переменной; визуализация трендов и автоматизация отчётов.
-
Архитектура на Prometheus + Grafana: сбор метрик качества и дрейфа, создание дэшбордов по стабильности модели и бизнес-метрикам; оповещения через Alertmanager.
-
Непрерывный мониторинг через MLflow + Feast: хранение версий моделей и признаков, трекинг зависимостей и репликация в продакшене.
-
Seldon Core и Kubeflow: мониторинг в эпоху сервисной оркестрации, детектирование деградации через сервисные метрики и калбэк-визуализации.
-
Пример кода для мониторинга drift с помощью PSI и KS-тестов (Python/scipy):
from scipy.stats import ks_2samp
import numpy as np

def ks_drift_statistic(sample_a, sample_b):
    stat, pvalue = ks_2samp(sample_a, sample_b)
    return stat, pvalue

# Пример использования
baseline = np.random.normal(loc=0.0, scale=1.0, size=10000)
current = np.random.normal(loc=0.1, scale=1.0, size=10000)
stat, p = ks_drift_statistic(baseline, current)
print(f"KS_stat={stat:.4f}, pvalue={p:.4e}")
-
-
Российские решения и подходы:
- Применение отечественных инструментов в банковском секторе: локальная интеграция мониторинга с регуляторными требованиями, использование отечественных контейнерных решений и систем регистрации моделей.
- Кейсы крупных компаний, внедряющих внутренние платформы мониторинга с поддержкой российских облачных и локальных инфраструктур: хранение данных на локальных кластерах, контроль доступа и журналы аудита.
- Каталоги и реестры моделей, соответствующие требованиям локального рынка, с акцентом на прозрачность версий и возможность аудита изменений.
- Примеры готовых паттернов интеграции:
- Инструменты для сбора метрик: Prometheus, OpenTelemetry.
- Контроль и регистрация моделей: локальные реестры моделей и конфигураций, интеграции с CI/CD.
- Мониторинг бизнес-метрик: интеграции с BI и дата-автоматизацией.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Дрейф данных:
- PSI: Population Stability Index — измеряет различие распределений признаков между эталоном и текущим периодом.
- KS-test: Kolmogorov–Smirnov тест — сравнение эмпирических распределений.
- Wasserstein distance: необходимость сравнивать распределения по “модулям” различий.
- Дрейф концепций и деградация модели:
- ADWIN, DDM — адаптивное обнаружение смены в потоках данных.
- Мониторинг ошибок и ошибок по классам, ROC-AUC и калибровка по сегментам.
- Мониторинг качества модели:
- Временная стабильность: отслеживание трендов ошибок (MAE, RMSE) и изменяемость точности по времени.
- Калибровка: reliability diagrams, Brier score, calibration curves.
- Метрики бизнес-метрик: конверсия, удержание, значение LTV, маржинальность, влияние на выручку.
- Архитектура развёртывания:
- Контейнеризация и оркестрация: Kubernetes, Seldon Core/KServe.
- Feature store: Feast для управления признаками и версиями датасетов.
- Регистры моделей: MLflow, DVC или локальные реестры с интеграцией в CI/CD.
- Пайплайны: Kubeflow Pipelines, Dagster для оркестрации ETL и обучения.
- Протоколы интеграции:
- REST/GRPC API для прогнозов и мониторинга.
- OpenTelemetry для трассировки метрик и событий.
- Протоколы уведомления: Slack/Teams/Email через Alertmanager и интеграции с ITSM.
Риски, ограничения и типовые ошибки
- Неправильная интерпретация дрейфа: сигнал может быть ложным из-за сезонности или изменения в объёме данных.
- Утечки данных и ложные корреляции: важно избегать попадания целевой переменной в признаки при расчётах данных.
- Неполнота данных: пропущенные значения и задержки в потоках данных и их влияние на дрейф и качество.
- Недостаточная калибровка: прогноз может быть точным в среднем, но плохо откалиброванным в отдельных сегментах.
- Сложности в регуляторной среде: требования к хранению данных, аудит и прозрачность моделей.
- Зависимость от инфраструктуры: риск избыточной сложности и задержек в продакшене, особенно в гибридных средах.
Перспективы развития направления
- Расширение реального времени: переход к микропакетам мониторинга и мгновенным сигналам тревоги для оперативного реагирования.
- Управление рисками через политики: автоматическое создание changelog и документирование всех изменений в моделях.
- Улучшение объяснимости и аудита: интеграция инструментов объяснимости, трассировка влияния признаков на прогнозы.
- Этикет и регуляторика: формализация процессов мониторинга для банков, телекомов и госсектора.
- Расширение экосистемы: интеграции между open-source инструментами и отечественными решениями для поддержки локальных инфраструктур и требований.
Заключение
Мониторинг ML-моделей в продакшене и контроль качества прогнозов — не просто дополнительная функция. Это фундаментальная часть надежной аналитической и ИТ-инфраструктуры, позволяющая сохранять точность, устойчивость к дрейфу и соответствие бизнес-целям. В условиях постоянных изменений данных и окружения эффективная архитектура мониторинга сочетает в себе статистическую грамотность, инженерное исполнение и управленческие процессы. Применение описанных методологий и инструментов обеспечивает прозрачность, управляемость и доверие к прогнозам, которые принимают критические решения в бизнесе.
FAQ
Что такое drift и чем он опасен для продакшна?
Drift — это изменение распределений. Data drift влияет на доступность корректности входных данных, в то время как model drift отражает изменение поведения самой модели. Оба вида дрейфа могут привести к деградации точности прогнозов и сбоим в бизнес-процессах, если их не обнаружить вовремя.
Какие метрики мониторинга наиболее важны в первую очередь?
В начале стоит выбрать: точность/MAE/MSE в зависимости от задачи, ROC-AUC для бинарной классификации, калибровку вероятностей, PSI/KS для дрейфа признаков, а также бизнес-метрики (конверсия, выручка, маржа). Важна единая связка: метрики технического качества и бизнес-метрики должны быть видны в единой панели.
Как организовать оповещения, чтобы не перегрузить команду?
Настройте уровни тревоги: критические события — мгновенно уведомлять через чат и инцидент-менеджмент; предупреждения — на дашборды и регламентированные проверки. Используйте динамические пороги, основанные на нормализации и сезонности.
Какие инструменты подходят для архитектуры мониторинга в гибридной среде?
Prometheus + Grafana для метрик, MLflow/Feast для управления версиями моделей и признаков, Kubeflow/Dast for pipelines, Seldon Core для развёртывания моделей. OpenTelemetry и REST/GRPC позволяют интегрировать сервисы и трассировку.
Как учесть регуляторные требования в мониторинге?
Введите реестры моделей и датасетов, хранение версий и изменений, журнал аудита действий и детальное документирование использования данных. Обеспечьте прозрачность алгоритмов и повторяемость выводов.
Какие кейсы можно привести в рамках российского рынка?
В банковском секторе применяют локальные инфраструктуры мониторинга с ориентацией на регулятивные требования, интеграцию с отечественными облачными и локальными сервисами, а также использование отечественных инструментов для аудита изменений и хранения моделей. Примеры включают реестры моделей, регламентированные пайплайны и интеграцию с локальными системами BI.
Что отличает drift-детекторы от классических тестов на валидацию?
Drift-детекторы фокусируются на непрерывном анализе распределений данных в продакшене и предсказаний, тогда как статические тесты валидации обычно применяются до развёртывания модели. Drift-детекторы позволяют быстро реагировать на изменения, происходящие в реальном времени или near-real-time.
Как интегрировать мониторинг в существующий пайплайн CI/CD?
Включите этапы проверки данных и тестирования моделей в процесс CI/CD: проверка согласованности наборов данных, регистр версий признаков и моделей, автоматизированные тесты на дрейф и симуляции прогнозов в тестовой среде перед выпуском в продакшн.
Какие риски существуют при внедрении мониторинга?
Перегруженность системой оповещений, ложные тревоги, неправильная интерпретация сигналов дрейфа, задержки в обработке данных, проблемы с сохранностью данных и доступностью логов. Управляемые процессы и четкие SLA снижают данные риски.
Какие перспективы на ближайшие годы?
Реализация реального времени мониторинга, углубленная интеграция с бизнес-метриками, расширение функций объяснимости и аудита, более тесная связь с регуляторикой и корпоративной стратегией в области данных и ИИ.
Эффективный мониторинг ML-моделей лишь один из элементов зрелой AI-инфраструктуры. Чтобы модели приносили устойчивую бизнес-ценность, необходим комплексный подход: стратегия внедрения, подготовка данных, архитектура платформы и интеграция AI-решений в реальные бизнес-процессы.
Узнайте, как реализовать искусственный интеллект в бизнесе от стратегии до промышленного внедрения: от оценки готовности компании и разработки AI-дорожной карты до создания AI-ассистентов, корпоративных AI-агентов и систем на базе генеративного AI, интегрированных в CRM, ERP и другие корпоративные системы.


