

Эксплуатация и поддержка ML-инициатив: операционные процессы и SLA
Краткое введение
Эта глава посвящена тому, как превратить разработку и внедрение моделей машинного обучения в устойчивые, управляемые и прозрачные бизнес-процессы. В рамках курса «Запуск ML-инициативы в компании команда, роли, KPI, типовые ошибки и критерии зрелости ML и MLOps» особое внимание уделяется операционным процессам, SLA/SLO, мониторингу, управлению рисками и взаимодействию между бизнесом и IT. Эффективная эксплуатация ML-инициатив требует объединения практик DevOps, DataOps и MLOps, внедрения регламентов по версии моделей, наблюдаемости и управления инцидентами, а также подходов к бюджету и устойчивости.
Введение
Модели машинного обучения в современных корпоративных системах редко остаются одноразовыми экспериментами. Их жизненный цикл простирается от подготовки данных до развёртывания в продакшн, мониторинга в реальном времени и периодической переобучаемости. Именно здесь формируется устойчивость ML-инициатив: способность сохранять качество предсказаний, управлять затратами, соблюдать регуляторные требования и своевременно реагировать на изменения во внешних условиях. Эксплуатация и поддержка ML-инициатив: операционные процессы и SLA становятся ядром управляемости, обеспечивая:
- воспроизводимость и трассируемость решений;
- прозрачность для стейкхолдеров;
- полный контроль над доступностью и качеством сервиса;
- эффективное взаимодействие между бизнесом, аналитиками, инженерами данных, ML-операторами и SRE.
Теоретические основы и терминология
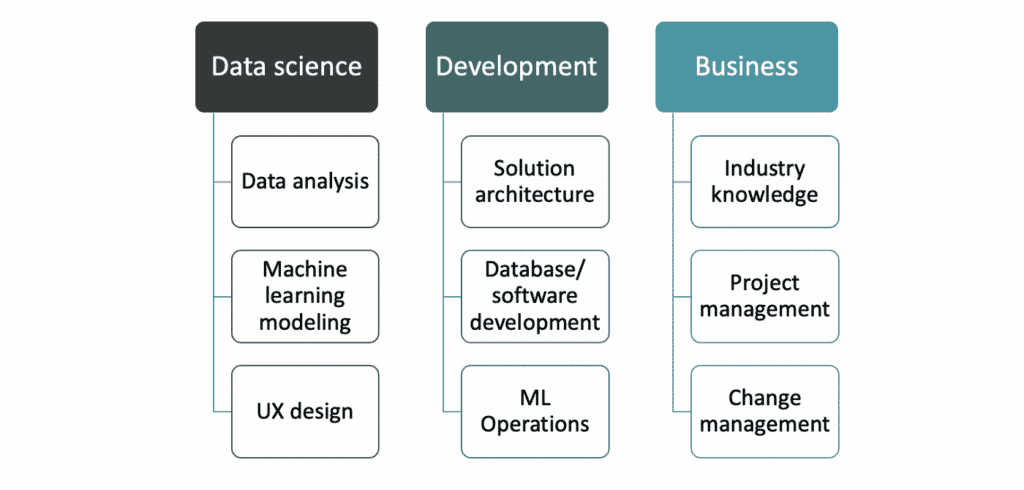
Определения и ключевые концепции:
- MLOps: практика интеграции машинного обучения в инженерные и операционные процессы через автоматизацию, мониторинг, управление жизненным циклом моделей и регламентами выпуска.
- SLA (Service Level Agreement): соглашение об уровне сервиса между поставщиком ML-решения и бизнес-пользователем, включающее требования к доступности, времени отклика, качеству предсказаний и скорости переобучения.
- SLO (Service Level Objective) и SLI (Service Level Indicator): целевые показатели сервиса и метрики, по которым оценивается выполнение SLA.
- Observability: способность системы сообщать о том, что происходит внутри, через метрики, логи и трассировки.
- Feature Store: централизованное хранилище управляемых признаков с версионированием и возможностью повторного использования.
- Model Registry: реестр версий моделей, где фиксируются версия, артефакты и стадии жизни модели (разработка, тестирование, продакшен и т.д.).
- Data Drift и Concept Drift: изменение распределения входных данных и/или самой концепции задачи, что может снизить качество модели.
- Data Governance: набор политик, процессов и ролей для обеспечения качества, конфиденциальности и соответствия данных.
Методологии и подходы
- Интеграция DevOps, DataOps и MLOps: цикл IRIS (Integrate, Reproduce, Improve, Sustain) для жизненного цикла моделей, где каждая фаза аккумулирует доказательства соответствия требованиям.
- Регламентирование жизненного цикла моделей: определение стадий (разработка, валидация, тестирование, продакшн, переобучение, архивирование) и автоматизация переходов между ними.
- Наблюдаемость как продукт: сбор и агрегация метрик с акцентом на бизнес-значимость.
- Политики обновлений и откатов: безопасные каналы выпуска, фиксация конфигураций, поддержка точек отката.
- Безопасность и соответствие: управление аутентификацией, авторизацией, секретами, шифрованием, управлением доступом к данным и моделям.
Архитектура и технологическая реализация
- Архитектурные слои:
- Источники данных: данные транзакций, логи, сенсоры и внешние источники.
- Инженерия данных и признаков: очистка, нормализация, создание признаков, хранение в Feature Store.
- Обучение и валидация: пайплайны с тестами воспроизводимости и регрессионными тестами.
- Регистрация моделей: Model Registry, версии артефактов, политики выпуска.
- Развёртывание и сервинг: инфраструктура для онлайн/оффлайн сервинга, A/B тестирования, canary-ревью.
- Наблюдаемость и управление инцидентами: метрики, логи, алерты, детекторы дрейфа.
- Политики и безопасность: секреты, доступ к данным и моделям, соответствие требованиям GDPR/локальных норм.
- Технологический стэк (пример):
- Оркестрация пайплайнов: Apache Airflow, Kedro, Prefect.
- Модели и эксперименты: MLflow, Kubeflow, Metaflow.
- Хранилище признаков и артефактов: Feast (Feature Store), MLflow Model Registry, DVC.
- Сервинг: Seldon Core, BentoML, MLServer, TensorFlow Serving.
- Мониторинг и наблюдаемость: Prometheus, Grafana, OpenTelemetry, Evidently AI (drift и качество), SLO/SError мониторы.
- Контейнеризация и облако: Kubernetes, Docker, Яндекс.Облако, AWS/GCP/Azure.
- Архитектурные паттерны:
- Многоуровневый сервинг: онлайн сервинг для задержек в диапазоне миллисекунд, офлайн для периодических обновлений модели и батч-вычислений.
- Feature-центры и повторное использование признаков: единый источник truth для разных моделей и задач.
- Разделение по доменам: Data Platform, ML Platform и бизнес-слой, чтобы снижение сложности было управляемым.
- Canary-подходы к выпуску: поэтапное развёртывание с возможностью отката.
Организационные и процессные аспекты
- Роли и ответственность:
- Data/ML Engineer: построение пайплайнов, обработка данных, валидация признаков.
- ML Ops/SRE: поддержка инфраструктуры, мониторинг, SLA, автоматизация развёртывания.
- Data Steward/Compliance Officer: управление качеством данных, соответствие регуляторным требованиям.
- Product Owner и бизнес-аналитик: формулирование KPI и бизнес-целей модели.
- Архитектор платформы: проектирование и эволюция архитектуры.
- Управление стратегией SLA/SLO:
- Определение целевых значений SLO по каждому сервису (например, latency < 150 ms для онлайн-предсказаний, доступность сервиса 99.95%).
- Привязка SLI к критериям качества модели (precision/recall, drift threshold, data freshness).
- Регулярные аудиты и пересмотр SLA в зависимости от бизнес-условий.
- Процессы эксплуатации:
- Регламентированные инцидент-менеджмент и эскалация.
- Регуляторные и контекстуальные проверки при переобучении.
- Управление конфигурациями и секретами (GitOps, Secret Management).
- Контроль затрат на инфраструктуру и обучение моделей.
- Управление качеством данных и моделей:
- Верификация данных (data quality checks) на входе в пайплайны.
- Валидация моделей по предопределённым критериям: точность, стабильность, drift.
- Версионирование данных, признаков и моделей.
Практические примеры и кейсы (open-source и российские решения)
- Open-source подходы:
- Kubeflow и MLflow: управление жизненным циклом моделей, тренировками, артефактами и пайплайнами.
- Apache Airflow / Prefect: оркестрация ETL и ML-пайплайнов.
- Feast (Feature Store) + Seldon Core: центревая платформа признаков и развёртывания моделей.
- Evidently AI: детекция дрейфа и визуализация качества моделей.
- DVC: контроль версий данных и пайплайнов, облегчение повторного использования наборов данных.
- Российские и локальные решения:
- Яндекс DataSphere: платформа для экспериментов, обучения, развёртывания и мониторинга моделей, поддерживающая русскоязычный стек и интеграцию с Яндекс.Облако.
- Яндекс.Облако MLOps: инфраструктура для обучения, сервинга и мониторинга моделей в облаке с политиками безопасности и соответствием требованиям.
- Data-аналитика и платформы на базе отечественных решений в крупных компаниях, адаптированные под регулятивные требования, гидративная модель поддержки и локальную инфраструктуру.
- Примеры сценариев:
- Сервис рекомендаций: онлайн-слой сервинга, A/B тестирование, drift-monitoring, автоматическая переобучаемость.
- Предиктивная диагностика: сбор данных о случаях отказа, мониторинг точности и latency, SLA по доступности и времени реакции.
- Детекция мошенничества: сигналы в реальном времени, контроль задержек и качество сигналов, регулятивные требования к хранению данных.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Пример пайплайна учебной/производственной модели:
- Источник данных → Data Cleaning → Feature Engineering → Feature Store → Обучение модели → Валидация → Model Registry → Продакшн сервинг → Мониторинг.
- Пример кода для YAML-конфига CI/CD пайплайна (оригинальные фрагменты, упрощённые):
- Пример 1: развертывание онлайн-сервиса с health checks (Kubernetes)
apiVersion: apps/v1 kind: Deployment metadata: name: ml-predictor spec: replicas: 2 selector: matchLabels: app: ml-predictor template: metadata: labels: app: ml-predictor spec: containers: - name: predictor image: registry.example.com/ml/predictor:1.3.0 ports:
- containerPort: 8080 readinessProbe: httpGet: path: /health/ready port: 8080 initialDelaySeconds: 15 periodSeconds: 5 livenessProbe: httpGet: path: /health/live port: 8080 initialDelaySeconds: 30 periodSeconds: 10 resources: limits: cpu: "2" memory: "4Gi" requests: cpu: "1" memory: "2Gi"
- Пример 2: конфигурация Model Registry и версионирование
model_registry: backend: mlflow tracking_uri: http://mlflow-tracking.example.com - Пример 3: правило мониторинга дрейфа
alert: name: drift_alert condition: drift_metric > 0.2 for: 10m labels: severity: critical annotations: summary: "Model drift detected" description: " Drift score exceeded threshold for feature set 'user_interaction'." - Интеграции:
- Data quality checks: Great Expectations, Deequ.
- Drift detection: Evidently AI, Alibi Detect.
- Мониторинг и алерты: Prometheus + Grafana, OpenTelemetry, Loki.
- Эталонные тесты Regresion: pytest, unittest, pytest-ml.
- Примеры регламентов и SLA в форме таблицы:
| KPI | Описание | Целевое значение (SLO) | Метрика/Источник |
| --- | --- | --- | --- |
| Availability сервиса онлайн-предсказания | Доступность сервиса 24/7 | 99.95% | Prometheus/SLA мониторинг, сервис-логи |
| Latency онлайн-инференса | Время ответа на запрос | ≤ 150 ms | APM/Prometheus, тесты нагрузочного тестирования |
| Drift и качество модели | Изменение распределения/производительности | Drift < 0.15, точность > 0.80 | Evidently AI, тесты в пайплайне |
| Время переобучения | Время от обнаружения ухудшения до выпуска новой версии | ≤ 7 дней | Model Registry, CI/CD-пайплайн |
| Стоимость сервиса | Контроль затрат на инфра и вычисления | < бюджет на период | Мониторинг затрат, калькуляторы облака |
Риски, ограничения и типовые ошибки
- Недостаточная согласованность между бизнес-целями и техническими SLA, что ведёт к перегрузке команды и необоснованным ожиданиям.
- Игнорирование дрейфа данных и концепции: модель может дезактуализироваться и давать ложные предсказания.
- Неправильная регуляторная и безопасность политика по данным: риск утечки персональных данных и штрафов.
- Недостаток прозрачности и версионирования признаков и моделей: трудности в аудите и воспроизводимости.
- Перегрев инфраструктуры и рост затрат: без дисциплины по оптимизации и автоматизации.
Перспективы развития направления
- Уровень автоматизации: переход к полностью управляемым пайплайнам с автоматическим переобучением и развертыванием через политики.
- Расширенная observability: предиктивная авто-реализация, self-healing сервисы и AIOps для ML инфраструктуры.
- Управление затратами на ML: оптимизация вычислительных ресурсов через эластичное масштабирование и зонное развёртывание.
- Гибридные и edge-решения: развёртывание на периферии с сохранением полноценной управляемости через облачную платформу.
- Регуляторные и этические требования: усиление аудита, прозрачности моделей и контроль за данными.
- Расширение экосистемы инструментов: интеграция отечественных и открытых решений, чтобы повысить локализацию и устойчивость.
Заключение
Эффективная эксплуатация и поддержка ML-инициатив требуют системного подхода к управлению жизненным циклом, соблюдению SLA/SLO, наблюдаемости и сотрудничеству между бизнесом и IT. Ваша архитектура и процессы должны быть направлены на устойчивость, предсказуемость и способность к адаптации к изменениям во внешних условиях. Внедрение практик MLOps в связке с регламентированной процедурой SLA позволяет не только сохранить качество предсказаний, но и обеспечить прозрачность и доверие к ML-решениям внутри организации.
Вопрос-Ответ (FAQ)
Что такое SLA в контексте ML-инициатив?
SLA в ML-инициативах - это договоренность об ожидаемом уровне сервиса, который включает доступность сервиса онлайн-предсказаний, задержки инференса, объём допустимого отклонения качества модели (допустимый порог дрейфа), а также требования к переобучению и обновлениям. SLA связывает бизнес-цели с операционными возможностями команды и инфраструктуры.
Какие KPI чаще всего включают в SLO для ML-сервисов?
Доступность онлайн-сервиса: процент времени, когда сервис отвечает корректно.
Latency и throughput: задержка инференса и пропускная способность.
Drift и качество: степень дрейфа признаков и метрики качества модели (precision, recall, AUC и т.д.).
Время отката и переобучения: срок реакции на ухудшение качества.
Затраты: себестоимость обслуживания модели и инфраструктуры.
Как организовать мониторинг моделей и сервинга?
Внедрите мониторинг дрейфа признаков и поведения модели через инструменты вроде Evidently AI.
Собирайте метрики латентности и точности в реальном времени.
Устанавливайте алерты по критическим порогам SLI, чтобы вовремя реагировать.
Храните логи запросов и результатов для аудита и обучения.
Какие инструменты open-source рекомендуется использовать?
Kubernetes, MLflow, Kubeflow, Apache Airflow, Feast, Seldon Core, DVC, Prometheus, Grafana, Evidently AI.
Примеры интеграций: MLflow Model Registry + Kubeflow Pipelines; Feast как хранение признаков; Seldon Core для онлайн-сервиса.
Какие российские решения полезны для MLOps?
Яндекс DataSphere: платформа для экспериментов, обучения и развёртывания моделей с учётом локального стека и регулятивных требований.
Яндекс.Облако MLOps: инфраструктура для обучения, внедрения и мониторинга моделей в контексте отечественного облака.
Внедрение локальных решений в крупных компаниях с поддержкой соответствия локальным требованиям и регуляторике.
Как организовать переобучение моделей без простоя?
Используйте Model Registry для версионирования и управления переходами между версиями.
Применяйте canary-выводы для постепенного развёртывания новой версии.
Автоматизируйте тестирование на регрессию и проверку дрейфа до выпуска новой версии.
Разделяйте данные для обучения и валидации, возвращаясь к предшествующим версиям при необходимости.
Что включить в регламент по управлению данными и безопасностью?
Политики доступа к данным, секретам и моделям; аудит активности.
Шифрование данных в покое и в движении.
Обеспечение конфиденциальности и соответствия требованиям GDPR, локальным законам и регуляторным нормам.
Процедуры защиты от утечек и инцидентов, включая план реагирования на инциденты.
Как бизнесу и IT-отделу наладить взаимодействие?
Ясная формулировка KPI и целей ML-инициатив в бизнес-терминах.
Регулярные ревью SLA: корректировка целей в зависимости от бизнес-условий.
Совместные рабочие процессы по управлению изменениями, тестированиям и аудиту.
Ведение общего реестра артефактов и конфигураций через Model Registry и Feature Store.
Какие типичные ошибки встречаются при эксплуатации ML-инициатив?
Непонимание бизнес-целей и несоответствие SLA реальности.
Недостаточная observability и отсутствие детектирования дрейфа.
Отсутствие управляемого жизненного цикла модели: отсутствие версионирования, тестирования и аудита.
Игнорирование затрат на инфраструку и ограничение по регуляторике.
Плохая координация между командами разработки, инфраструктуры и бизнеса.
Какие перспективы и тренды можно ожидать?
Расширение автоматизации переобучения и выпуска моделей.
Улучшение моделей MLOps через интеграцию AI-поддерживаемой AIOps.
Гибридные/edge-решения с сохранением управляемости в единой платформе.
Развитие регуляторной и этической инфраструктуры для ML: прозрачность и аудируемость.
Примеры и схемы дополнительно в визуальном формате можно присоединить к главе в виде диаграмм и архитектурных схем. Если требуется, могу подготовить отдельные чертежи, диаграммы потоков данных и схемы развертывания в выбранной инфраструктуре (Kubernetes, Яндекс.Облако или AWS/GCP).
Если вы планируете запуск ML-инициатив или масштабирование AI-проектов, важно выстроить не только модели, но и всю экосистему — от данных и инфраструктуры до процессов эксплуатации и управления.
Узнайте, как внедрить искусственный интеллект в бизнес от стратегии до промышленного внедрения, включая разработку AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы компании.


