

Инструменты и платформы для ML: обзор и выбор
Краткое введение
Современный цикл разработки и эксплуатации моделей машинного обучения требует единого, согласованного набора инструментов и платформ, обеспечивающих от сбора данных до мониторинга вывода в продуктивной среде. Правильный выбор инструментов влияет на скорость вывода моделей в бизнес-цели, управляемость процессов, соответствие требованиям безопасности и регуляторики, а также на способность масштабироваться в рамках зрелости ML и MLOps в организации. В этой главе мы разберём архитектуры, подходы к выбору и критерии оценки инструментов и платформ, приведём примеры реальных решений (open-source и российские продукты), а также предложим практические рекомендации по внедрению.
Введение
Инструменты и платформы для ML образуют экосистему из нескольких слоёв: от источников данных и вычислительных кластеров до сервисов выдачи предсказаний и мониторинга моделей. В условиях корпоративного масштаба важны не только функциональность и производительность отдельных компонентов, но и совместимость между ними, управляемость инфраструктуры, наличие стандартов и процедур, а также возможность прозрачного аудита данных и артефактов модели.
Теоретические основы и терминология
Ключевые понятия
- ML-платформа (ML Platform): совокупность инструментов, сервисов и инфраструктуры, облегчающих полный цикл ML-от подготовки данных до мониторинга в продуктивной среде и управляемого выпуска моделей.
- MLOps: практика интеграции методологий DevOps в lifecycle машинного обучения, включая управление версиями данных и артефактов, автоматизацию пайплайнов и мониторинг.
- Feature Store: служба хранения и управления признаками (features) для повторного использования и обеспечения консистентности данных между обучением и инференсом.
- Experiment Tracking и Model Registry: система учёта экспериментов, артефактов и версий моделей, позволяющая прослеживаемость изменений и повторяемость экспериментов.
- CI/CD для ML: автоматизированные конвейеры сборки, тестирования, обучения и развёртывания моделей.
- Serving и Monitoring: инфраструктура для развёртывания моделей в продуктивной среде и непрерывного мониторинга качества, задержек, данных и дрейфа.
Модели зрелости и типовые паттерны
- Лодка-стек (Open-Stack) паттерн: набор независимых инструментов, интегрируемых по API. Гибок,但 требует координации между командами.
- Платформенно-центричный подход: единая платформа с готовыми сервисами, минимизирующая интеграционные усилия, но риск зависимости от вендора.
- Гибридный подход: локальные решения для критических бизнес-процессов плюс облачные сервисы для масштабирования и инноваций.
- Обеспечение управляемости: наличие политики доступа, аудита, управления версиями и бизнес-правил, чтобы соответствовать требованиям регуляторов и корпоративной безопасности.
Методологии и подходы
- Выбор модели владения: построение собственного стека (custom stack) против использования готовой коммерческой или полупрозрачной платформы.
- Оценка по критериям: функциональность по жизненному циклу, масштабируемость, безопасность, соответствие регуляторике, стоимость владения и скорость/time-to-value.
- Архитектурная совместимость: совместимость с данными источниками, форматами признаков, интерфейсами препроцессинга, протоколами RPC/REST/gRPC.
- Эволюционность: возможность постепенного внедрения с фазами обучения, пилоты и масштабирования без остановки бизнес-процессов.
Архитектура и технологическая реализация
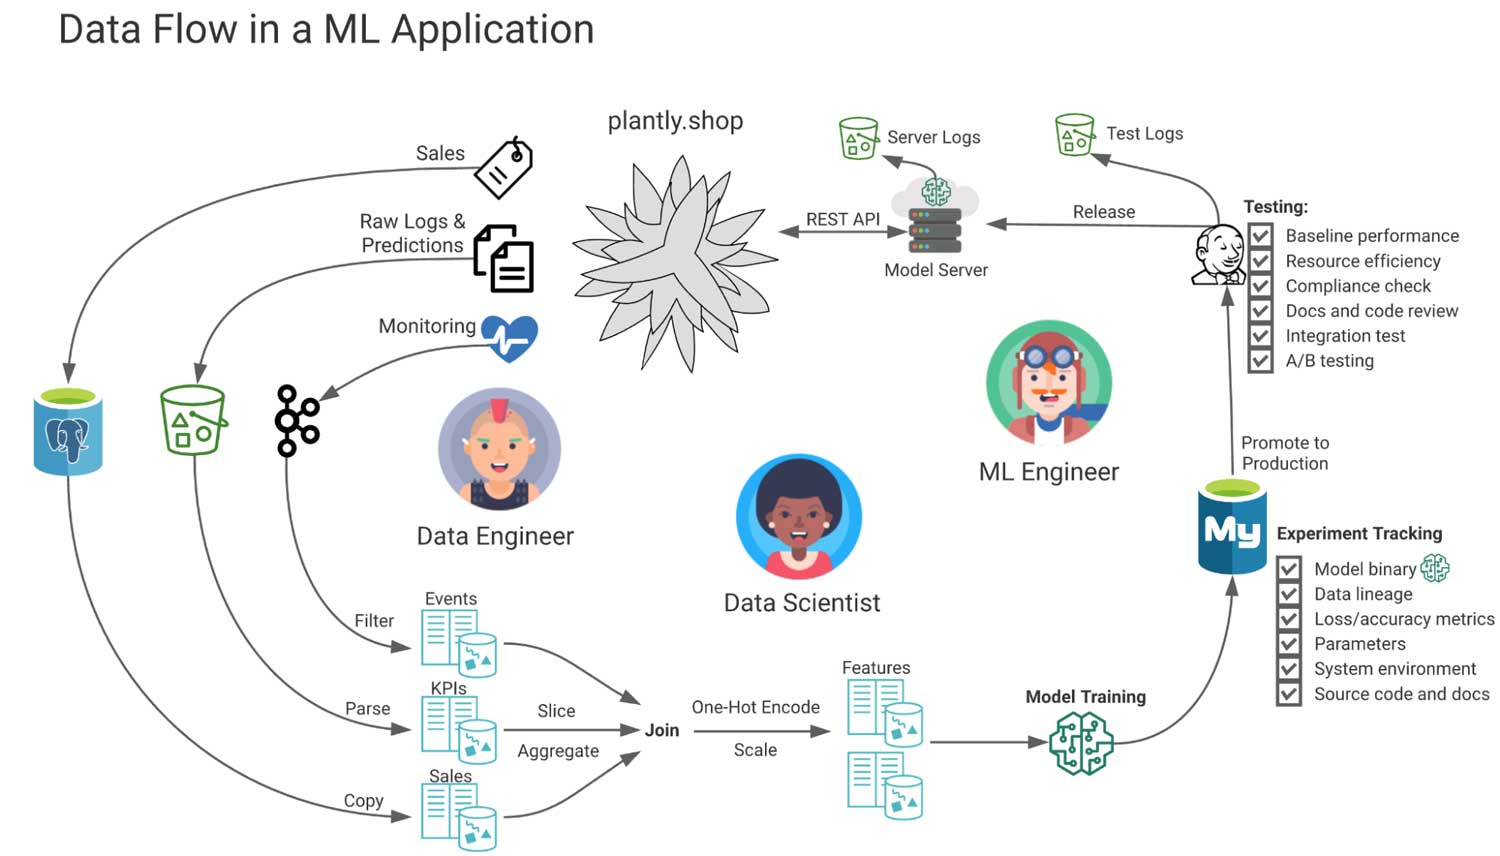
Компонентная карта ML-платформы
- Источники данных и Data Ingestion: Data Lake / Data Warehouse, потоковые источники (Kafka, Kinesis), ETL/ELT.
- Хранение данных и признаки: Data Lake / Feature Store, версии датасетов, управление зависимостями.
- Обучение и экспериментирование: фреймворки для обучения (PyTorch, TensorFlow, Scikit-Learn), оркестраторы пайплайнов (Kubeflow Pipelines, Apache Airflow, Dagster).
- Репозитории артефактов: код, данные, модели, конфигурации и гиперпараметры.
- Регистрация моделей и конвейеры развёртывания: Model Registry, Serving инфраструктура (KFServing/Seldon Core/TF Serving), каналы доставки (canary, blue/green).
- Мониторинг и управление дрейфами: мониторинг данных и концепций, сигналы качества, алерты, dashboards (Prometheus, Grafana, OpenTelemetry).
- Безопасность и соответствие: управление доступом (IAM, OAuth2, SAML), шифрование в покое и в передаче, управление данными PII, аудит.
- Инструменты разработки и collaboration: репозитории кода, инструменты для совместной работы, отслеживание задач.
Компоненты архитектуры в виде схемы (ASCII)
+--------------------+ +------------------------+ +-------------------+
| Data Ingestion | | Feature Store / Data | | Model Training / |
| --- | --- | --- | --- | --- |
+--------------------+ +------------------------+ +-------------------+
| | |
v v v
+--------------------+ +------------------------+ +-------------------+
| Data Lake / Warehouse| | Model Registry / Serving| | Monitoring / CI/CD |
+--------------------+ +------------------------+ +-------------------+
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Объединение данных и признаки: для консистентности между обучением и инференсом применяем Feature Store (например, Feast). Гарантия того, что обучающие признаки и признак-источник совпадают по времени обновления и версионированы.
- Оркестрация пайплайнов: Kubeflow Pipelines или Dagster позволяют хранить граф зависимостей, запускать обучение на кластере Kubernetes и регистрировать артефакты в Model Registry. Пример YAML-конвейера для обучения может выглядеть так (упрощённо):
name: train-ml-model
description: Обучение модели и публикация артефактов
tasks:
- name: feature-extraction
 image: registry.example/feature-extractor: latest
 commands: ["python", "extract_features.py"]
- name: train
 image: registry.example/trainer: latest
 depends_on: ["feature-extraction"]
 commands: ["python", "train.py", "--config", "config.yaml"]
- name: register
 image: registry.example/registrar: latest
 depends_on: ["train"]
 commands: ["python", "register_model.py", "--model", "model.pkl"]
- Инфраструктура развёртывания: использование Kubernetes для оркестрации и горизонтального масштабирования, контейнеризация через Docker. Для низкой задержки инференса применяются среды с автоскейлингом и edge-деплоем.
- Протоколы взаимодействия:
- REST/gRPC для микросервисов инференса.
- Kafka/Apache Pulsar для потоковых данных.
- S3/Blob-хранилища для артефактов и датасетов.
- **Управление версиями**: MLflow или MLflow-compatible Model Registry для отслеживания экспериментов и версий моделей. Важна поддержка воспроизводимости: фиксированные зависимости (pip/conda), фиксированные версии датасета.
- **Безопасность и доступ**: OAuth2/OIDC для доступа к сервисам, SAML-интеграция для единого входа, шифрование трафика и данных в покое. В регулятивных сценариях - журналирование доступа и операций (audit log) на уровне каждого артефакта.
- **Сервисы мониторинга**: Prometheus, Grafana, OpenTelemetry для трассировки; ML-метрики качества и сигналов дрейфа данных, latency/тайминги обслуживания.
Организационные и процессные аспекты
Роли и ответственности
- ML/AI Platform Engineer: ответственность за устойчивую работу платформы, инфраструктуру пайплайнов, безопасность и доступы.
- Data Engineer: подготовка, интеграция источников данных, обеспечение качества и версионирования данных.
- ML Engineer / Scientist: разработка и прототипирование моделей, участие в создании пайплайнов.
- Data Product Owner: формулирование бизнес-целей, требований к качеству моделей, приоритизация инициатив.
- DevOps/CI-CD инженер: автоматизация развёртывания, тестирования и мониторинга.
- Compliance & Security Officer: надзор за регуляторикой, безопасностью и аудитом.
KPIs и метрики зрелости
- Время до первой демонстрации (TTR): сколько дней или недель требуется от идеи до демонстрационной модели в стенде.
- Время до выпуска в прод (time-to-prod): фактическое время от начала проекта до развертывания и монитора в продуктиве.
- Степень автоматизации пайплайнов: % пайплайнов, где ручные шаги заменены автоматическими.
- Частота релизов и стабильность: число выпусков в месяц, среднее время исправления ошибок.
- Drift и качество данных: доля датасетов, подверженных дрейфу, частота обновления признаков.
- latency и throughput сервиса инференса: задержки ответа и пропускная способность, удовлетворяющие SLA.
- Надёжность и доступность: Uptime, MTTR для критических моделей.
- Соответствие регуляциям: число аудитов, количество нарушений.
Практические примеры и кейсы (open-source и российские решения)
Open-source примеры
- Стек Kubeflow + Feast + MLflow: открытая архитектура, поддерживает пайплайны, хранение признаков и отслеживание экспериментов.
- Seldon Core или KFServing для инференса: управление версиями, canary-обновлениями, масштабируемость.
- Apache Airflow или Dagster: оркестрация задач, контроль зависимостей, мониторинг статуса выполнения.
- PyTorch Lightning + Hydra для организации экспериментов и повторяемости.
- Пример архитектуры: модель обучается в Kubeflow Pipelines, признаки хранятся в Feast, артефакты регистрируются в MLflow, доставка в прод осуществляется через Seldon Core.
Российские решения и локализация
- Яндекс.Облако DataSphere (или решения Яндекс) для интеграции данных, хранения признаков и мониторинга моделей в рамках экосистемы. Локализация данных, соответствие требованиям регуляторики и поддержка госпрограмм упростят миграцию в корпоративную среду.
- СберCloud MLOps: функциональности для управления жизненным циклом моделей в публичной инфраструктуре с учётом корпоративных требований к безопасности и аудиту. Возможности по мониторингу, драйверам версий и управлению доступами соответствуют требованиям крупных предприятий.
- Локальные дистрибутивы и open-source-альтернативы с поддержкой на русском языке: интеграционные коннекторы к отечественным хранилищам данных и системам аутентификации, локализация документации и поддержки.
Технические детали реализации (программы, протоколы, интеграции)
- Примеры интеграций:
- Интеграция Feature Store с источниками данных: связь через коннекторы к Data Lake, обеспечение версий признаков и атомарности операций.
- Экспериментальная среда: фиксированные окружения, контейнеризация зависимостей, воспроизводимые наборы гиперпараметров.
- Модельный реестр: хранение метаданных, версий, зависимостей, ссылок на данные и датасеты.
- Безопасность и аудит: аудит действий пользователей, хранение артефактов и логов, контроль доступа на уровне проектов и персонажей.
- Протоколы коммуникаций: gRPC для высокопроизводительных вызовов между сервисами, REST для широкой совместимости, Message Queue для событийной передачи.
- Совместимость с регуляторикой: хранение данных в локальных регионах, ограничение ошибок и доступности, поддержка RBAC и политики по данным PII.
Риски, ограничения и типовые ошибки
- Неправильная архитектура выбора: слишком фрагментированный стек без единых стандартов может привести к сложностям поддержки.
- vendor lock-in: чрезмерная зависимость от одного вендора может ограничивать гибкость и увеличение затрат.
- Недостаточная безопасность: отсутствие комплексного аудита и отслеживания доступа к данным и моделям.
- Низкая observability: отсутствие инструментов мониторинга дрейфа, деградаций и задержек приведёт к задержкам в реагировании на проблемы.
- Сложности с регуляторикой: несоответствие требованиям локализации данных, аудита и конфиденциальности может привести к штрафам.
- Ошибки в планировании устойчивости: недооценка затрат на инфраструктуру, тестирование и обеспечение доступности сервисов.
Перспективы развития направления
- Повышение уровня автоматизации: автоматическое обновление моделей, автотестирование и auto-ML в рамках зрелой MLOps-платформы.
- Эволюция Feature Store: улучшение версионирования, больше интеграций с источниками данных, ускорение подготовки признаков.
- Модели как сервис: улучшение SLO/SEO для инференса, эмиграция к edge-инференсу там, где данные требуют локализации.
- Акцент на этике и приватности: приватность по данным, федеративное обучение, дифференцированная приватность и безопасное обучение на распределённых данных.
- Масштабирование и стоимость: оптимизация использования вычислений, гибридные решения, экономия за счёт низко-латентных сред.
Заключение
Инструменты и платформы для ML формируют основу управляемой, воспроизводимой и масштабируемой ML-инициативы в компании. Правильный выбор во многом определяет скорость вывода бизнес-ценности, устойчивость к изменениям объёма данных и требованиям регуляторики. Важнейшими критериями остаются совместимость между компонентами, управляемость и способность адаптироваться к росту организации. В следующей части мы разберём вопросы стратегического выбора и дадим методику оценки вариантов в контексте зрелости ML и MLOps.
Вопрос-Ответ (FAQ)
Какие критерии использовать при выборе ML-платформы для крупной компании?
Во-первых, полнота жизненного цикла: от данных и признаков до обучения, развёртывания и мониторинга. Во-вторых, совместимость с существующей инфраструктурой (кластеры, хранилища). В-третьих, требования к безопасности и аудиту, соответствие регуляторике. В-четвёртых, стоимость владения и скорость достижения бизнес-целей. Наконец, возможность гибко масштабироваться и адаптироваться к новым регуляторным требованиям.
Что важнее: open-source стек или готовая платформа?**
Оба подхода имеют свои плюсы. Open-source стек даёт гибкость, прозрачность и отсутствие зависимости от одного поставщика, однако требует дополнительных усилий по интеграции и поддержки. Готовая платформа сокращает время на внедрение и обеспечивает единое управление, но может приводить к vendor lock-in. Для корпоративного масштаба часто favouring гибридный подход: ядро платформы плюс модульные open-source компоненты.
Какой уровень автоматизации необходим на начальном этапе?
На старте достаточно автоматизации базовых пайплайнов, тестирования и развёртывания моделей с базовым мониторингом. Постепенно добавлять автоматическое тестирование данных, drift-детекторы, регламентированные обновления моделей, и автоподдержку жизненного цикла.
Какие типичные ошибки встречаются при внедрении MLOps-платформ?
Непонимание требований к данным и признакам, пренебрежение качеством данных, отсутствие версионирования датасетов и признаков, недостаточный мониторинг, несогласованность между обучением и инференсом, а также слабая интеграция с бизнес-процессами.
Что такое Feature Store и зачем он нужен?
Feature Store обеспечивает единое хранилище признаков с версионированием и единым способом вычисления признаков для обучения и инференса. Это повышает консистентность между обучением и продом, ускоряет повторное использование признаков и снижает риск «наделки данных» в проде.
Какое место занимает мониторинг в зрелой ML-организации?
Мониторинг - критически важный элемент. Он позволяет автоматически обнаруживать дрейф данных, деградацию моделей, задержки и проблемы инфраструктуры. Без него сложно поддерживать качество сервисов и удовлетворять SLA.
Какие российские решения стоит рассмотреть в рамках локализации?
Российские решения включают инфраструктурные и регуляторно-ориентированные инструменты, такие как Яндекс.Облако DataSphere и решения СберCloud MLOps. Они предлагают интеграцию с локальными хранилищами данных, соответствие требованиям локализации и поддерживают корпоративные политики безопасности.
Как выбрать между локальным и облачным развёртыванием?
Локальное развёртывание предпочтительно там, где требования к локализации данных, контроль над инфраструктурой и регуляторика важнее скорости выхода на рынок. Облачное развёртывание обеспечивает гибкость, масштабируемость и быструю адаптацию к динамическим нагрузкам. На практике часто используется гибридный подход: критичные данные локально, общий пайплайн - в облаке.
Какие принципы архитектуры помогают держать стек управляемым?
Принцип единых контрактов между сервисами, модульности и слабой связанности, управляемый через строгие политики доступа, единые API, версионирование артефактов и строгий процесс изменений. Важна также детальная документация и регламентированные процессы аудита.
Какие направления развития ML-платформ стоит ожидать в ближайшие годы?
Автоматизация пайплайнов и оптимизация затрат, развитие федеративного обучения и приватности, усиление edge-решений для инференса в условиях ограничений сети, расширение возможностей для регуляторного соответствия и этики, а также усиление наблюдаемости и управляемости через единый портал управления.
Примеры практических сценариев внедрения
- Сценарий 1: крупная розничная сеть
- Требование: быстрый вывод новых моделей категорий рекомендаций с минимальным временем простоя. Решение: Kubeflow Pipelines для обучения, Feast как feature store, MLflow для артефактов, Seldon Core для инференса, Prometheus/Grafana для мониторинга. Типовой пайплайн: данные → признаки → обучение → регистрация модели → можноary-развертывание → мониторинг.
- Сценарий 2: финансовый регуляторный кейс
- Требование: строгий аудит изменений и регуляторная прослеживаемость. Решение: локальный стек с интеграцией Identity/Access management, регистр моделей в безопасной Model Registry, журнал аудита, шифрование в покое и передаче. В качестве оркестратора - Dagster, который поддерживает детализированную прослеживаемость зависимостей и тестовые окружения.
Технические детали реализации (пример архитектуры)
- Архитектура в корпоративной среде может включать: локальные дата-центры для чувствительных данных, централизованный Data Lake, и облачные сервисы для масштабирования.
- Потоки:
- Извлечение признаков из источников данных.
- Вычисление признаков в Feature Store.
- Обучение и тестирование модели.
- Регистрация модели и подготовка к развёртыванию.
- Развёртывание через сервис инференса с поддержкой canary и rollback.
- Мониторинг и Drift-detection.
- Инфраструктура безопасности:
- RBAC и ABAC на уровне проектов и сервисов.
- Управляемая секретность (Vault, Kubernetes Secrets).
- Аудит и журналирование действий пользователей.
- Пример интеграции: Data Lake (S3-compatible) → Feast (Feature Store) → Kubeflow Pipelines (обучение) → MLflow (регистрация) → Seldon Core (инференс) → Prometheus/Grafana (мониторинг).
Заключение
Инструменты и платформы для ML выступают как связующее звено между инженерными командами, данными и бизнес-целью. Их правильный выбор и грамотное внедрение позволяют не только ускорить вывод моделей, но и обеспечить стабильность, безопасность и подотчётность, необходимые для зрелости ML и MLOps в рамках корпоративной стратегии.
Общее руководство по внедрению
- Определите бизнес-цели и регуляторные требования как исходную точку выбора платформы.
- Определите критичные сценарии: latency для инференса, требования к дрейфу, требования к аудитам.
- Разработайте минимально жизнеспособный стек (MVP) с фокусом на автоматизацию и повторяемость.
- Постепенно расширяйте стек, добавляя feature store, эксперимент-tracking и мониторинг.
- Включайте российских локализаций и инфраструктурные требования по мере роста зрелости.
Приложение: таблица критериев выбора инструментов
| Категория | Что учесть | Метрика/показатель |
|---|---|---|
| Функциональность | Полный цикл ML, пайплайны, признаки, инференс | Coverage: процент функций |
| Совместимость | Интеграция с текущими хранилищами, API | Количество коннекторов, совместимость форматов |
| Безопасность | IAM, аудит, шифрование, регуляторика | Наличие SSO, аудит-логов |
| Масштабируемость | Горизонтальное масштабирование, Edge-слой | Throughput, latency под нагрузкой |
| Стоимость | CAPEX/OPEX, лицензии, владение стеком | TCO за 12 мес. |
| Поддержка | Сообщество, документация, локализация | Время отклика поддержки, наличие локализации |
Пример куска кода: настройка простого пайплайна обучения в Dagster
from dagster import job, op
@op
def extract_data(context):
доступ к источнику данных
return {"features": [1, 2, 3], "target": 0}
@op
def train_model(context, data):
обучаем модель, возвращаем артефакты
model = {"weights": [0.1, 0.5, -0.2]}
return model
@op
def register_model(context, model):
регистрируем модель в Registry
context.log.info("Model registered: {}".format(model))
@job
def ml_pipeline():
data = extract_data()
model = train_model(data)
register_model(model)
Эта глава рассчитана на то, чтобы служить рабочим ориентиром для аналитиков, архитекторов и ИТ-директоров, которые стоят перед задачей выбора и внедрения инструментов ML в корпоративной среде. Она даёт как теорию, так и практику: от концепций до конкретных решений и кейсов, чтобы поддержать путь к зрелости ML и MLOps в вашей организации.
Если вы планируете запуск ML-инициатив или масштабирование AI-проектов, важно выстроить не только модели, но и всю экосистему — от данных и инфраструктуры до процессов эксплуатации и управления.
Узнайте, как внедрить искусственный интеллект в бизнес от стратегии до промышленного внедрения, включая разработку AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы компании.


