

Диагностика ошибок запуска и работы сервисов DataLens
DataLens On Premise реализует мощный набор возможностей для визуализации и анализа данных внутри корпоративной инфраструктуры. Эффективная диагностика сбоев запуска и стабильной работы сервисов требует системного подхода: от понимания архитектуры до оперативных процедур мониторинга, журналирования и восстановления. В данной главе сформулированы принципы диагностики, практики взаимодействия между компонентами и конкретные шаги по устранению распространённых ошибок в условиях локального развёртывания.
DataLens On Premise может разворачиваться в нескольких режимах: как набор микросервисов в Kubernetes или Docker-окружении, либо как монолитная/квазимикросервисная конфигурация на виртуальных машинах. Независимо от выбранного подхода, специфические для локального разворачивания зависимости
-
сеть, секреты, конфигурации и внешние источники данных
-
требуют особого внимания на этапе запуска и в процессе эксплуатации. Эталонный диагностический подход выстраивается на триаду: корректность конфигурации и секретов, устойчивость инфраструктуры и качество интеграций с источниками данных и потребителями.
-
Краткое содержание главы
-
Архитектура DataLens On Premise и ее влияние на диагностику.
-
Пошаговый процесс диагностики запуска и основных ошибок.
-
Инструменты мониторинга, журналирования и трассировки в условиях On Premise.
-
Практики восстановления, тестирования и устойчивости.
-
Организационные аспекты внедрения и сопровождения.
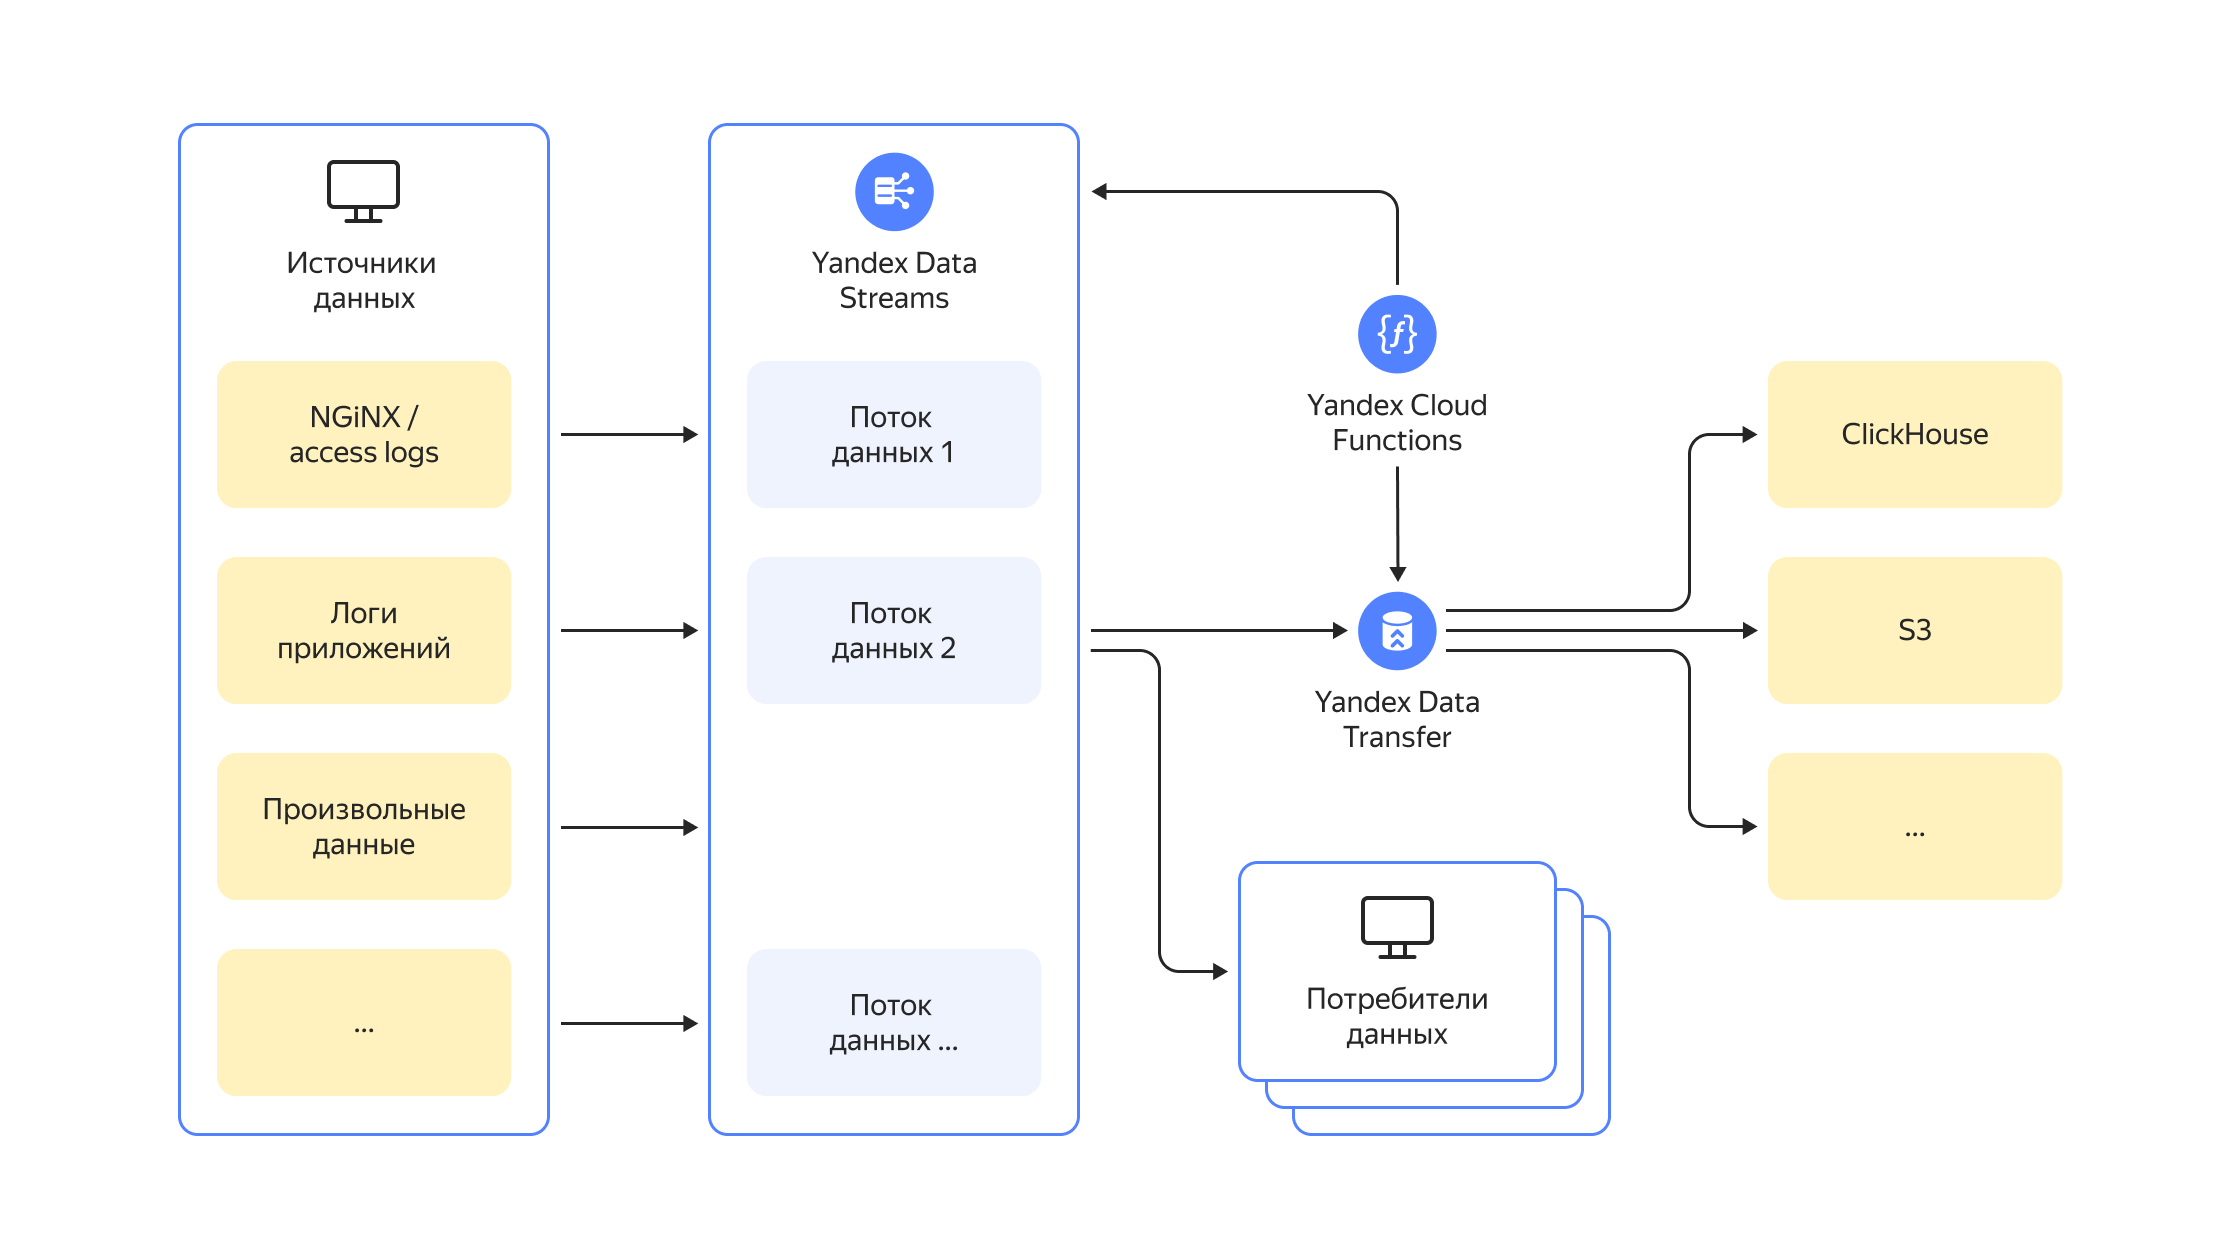
Архитектура DataLens On Premise и область диагностики
DataLens On Premise реализуется как набор взаимосвязанных компонентов, каждый из которых отвечает за отдельную функциональность: аутентификация и доступ, API-слой, фронтенд, движок визуализации, коннекторы к источникам данных, хранение метаданных и кэш. В зависимости от конфигурации архитектура может включать в себя элементы следующих уровней:
- пользовательский интерфейс и API: фронтенд-слой, узлы API, которые предоставляют визуальные дашборды, запросы к данным и управление конфигурациями;
- сервисы обработки и рендеринга: движок, который подготавливает данные к визуализации, и слой рендеринга для графических элементов;
- каталог и хранение метаданных: база данных метаданных, контроль версий и миграций схемы;
- коннекторы и источники данных: набор адаптеров к корпоративным базам данных, хранилищам данных и потоковым системам;
- инфраструктура инфраструктурных служб: аутентификация, управление секретами, кэширование и очереди заданий.
Ключевые диагностические точки включают:
- корректность конфигурационных файлов и переменных окружения;
- доступность и конфигурацию секретов (ключи доступа, TLS-сертификаты, параметры аутентификации);
- сетевые маршруты и разрешения между компонентами;
- совместимость версий между компонентами и данными миграций;
- устойчивость к сбоям зависимых сервисов (БД, очередь задач, кэш).
На практике для On Premise характерно наличие нескольких сценариев развёртывания: раздельные сервисы в Kubernetes кластере, набор контейнеров в Docker Compose или монолитная установка на виртуальной машине. В каждом случае необходимо внимательно проверить порядок запуска сервисов, т.к. некорректная последовательность инициализации может привести к зависимым ошибкам (например, сервис пытается подключиться к БД до её готовности).
Почему это важно: архитектурная прослойка определяет, какие именно индикаторы и в каком виде будут сигнализировать о сбое. В Kubernetes, например, важны readiness и liveness пробы, а в Docker Compose
- корректные зависимости и задержки между запуском служб для прогрева зависимостей. Неправильная настройка может маскировать проблемы на уровне кода или конфигураций и затруднить диагностику.
Компоненты и их роли
- API и фронтенд: обеспечивают доступ к данным и управление настройками. В случае ошибок в API часто наблюдаются задержки в ответах, ошибки аутентификации или несогласованность кэша.
- Каталог и мастер-данные: хранят схемы, версии коннекторов и параметры подключения к источникам. Ошибки миграций, проблемы с целостностью данных или неверные схемы приводят к невозможности загрузки дашбордов.
- Коннекторы к источникам: реализация адаптеров для подключений к БД, хранилищам данных и потоковым системам. Проблемы иногда возникают из-за новых версий драйверов, изменений в структурах таблиц или ограничений по соединениям.
- Аутентификация и секреты: управление ключами, сертификатами, OAuth-данными. Отсутствие секретов, истечение сертификатов или неверные настройки доступа приводят к ошибкам авторизации и прекращению обслуживания.
- Внешние зависимости: очереди сообщений и кэш-слои. Непоступающие задания, перегрузка очередей или задержки в кэшировании влияют на время отклика и стабильность.
Точки интеграции и сетевые особенности
On Premise окружение часто включает сегментированную сеть, firewall-правила и политики сетевой изоляции. В таких условиях ключевым является согласованный подход к именованию сервисов, DNS-разрешению внутри кластера и корректной маршрутизации трафика между компонентами. Проблемы могут проявляться как задержки, ошибки TLS-рукопожатия и непредсказуемые тайм-ауты. Наличие четко документированной топологии сети помогает быстро локализовать причину.
Рекомендованная практика конфигурационной верификации
- хранение конфигураций и секретов в централизованном безопасном месте (Vault, Kubernetes Secrets, аналогичные механизмы);
- внедрение проверок начальной загрузки на этапе старта: валидность переменных окружения, доступность секретов, целостность файлов конфигурации;
- использование версионирования миграций и согласованных схем данных;
- мониторинг изменений конфигураций и автоматизация отката при обнаружении несогласованности.
Диагностика ошибок запуска и основных проблем
Процесс диагностики запуска DataLens On Premise следует рассматривать как последовательность взаимосвязанных проверок, направленных на выявление первопричины и устранение риска повторного сбоя. Эффективная диагностика предполагает системный подход: сбор данных, формализацию гипотез, тестирование и документирование принятых решений.
Общий подход к диагностике строится на следующих этапах:
-
сбор контекста: какие компоненты задействованы, какая версия продукта, узлы кластера, конфигурации и секрета;
-
первичные проверки готовности: доступность сетей, состояние узлов, наличие ресурсов;
-
анализ журналов и метрик: поиск ошибок, предупреждений и закономерностей;
-
проверка взаимодействий: тестирование API, коннекторов, взаимодействие с БД;
-
тестирование восстановительных сценариев: повторная инициализация, миграции, откат к рабочей конфигурации.
Частые причины сбоев запуска:
-
неверные или устаревшие конфигурации: переменные окружения, параметры подключения, TLS-настройки;
-
недоступность зависимых сервисов: БД, очереди, внешние источники;
-
конфликты портов и адресов: дубликаты сервисов, неправильная маршрутизация;
-
неполадки с секретами: истечение сроков годности сертификатов, неправильные ключи;
-
ограничение ресурсов: нехватка CPU, памяти, дискового пространства;
-
несовместимость версий компонентов: апгрейд одного элемента без синхронного обновления других.
Типовой сценарий диагностики запуска:
- проверить доступность сети между компонентами и корректность DNS;
- проверить состояние сервисов на уровне контейнеров/подов (лог-файлы, статусы, readiness/liveness);
- проверить наличие активных секретов и корректность их значений;
- проверить журналы запуска на стадии инициализации для выявления ошибки миграций, неподдерживаемых конфигураций или ошибок подключения;
- проверить миграции базы данных и состояние схемы;
- проверить доступ к внешним данным и аутентификацию;
- повторно запустить сервис в контролируемом порядке с фиксацией изменений.
Практический пример проверки в Kubernetes (упрощённо):
- kubectl get pods -n data-lens - kubectl logs-n data-lens --tail=200 - kubectl describe pod -n data-lens - kubectl get events -n data-lens --sort-by=.lastTimestamp
## Пример последовательности проверки зависимостей
## 1) проверить состояние БД и миграции
kubectl exec -it db-pod -- psql -c "SELECT version();"
kubectl exec -it api-pod -- ls -l /opt/datalens/migrations
kubectl exec -it api-pod -- datalens-migrate status


## 2) проверить TLS-сертификаты
openssl s_client -connect datalens-api:443 -servername datalens-api
- Вне зависимости от окружения, ключевые сигналы для диагностики
- это согласованность между конфигурацией и реальным состоянием сервисов, своевременность обновлений, а также полнота логирования и телеметрии.
Диагностика на уровне конкретных компонентов
- Сервис API и фронтенд: ошибки авторизации, задержки в откликах, ошибки маршрутизации. Ожидаются корректные ответы на запросы к основным API-конечным точкам; в логах
- проблемы аутентификации или недоступности конфигураций.
- Движок визуализации и рендеринг: провалы в обработке запросов, задержки отрисовки, ошибки кэширования. Важно проверить корректность массива данных, форматирование, а также совместимость версий движка с коннекторами.
- Каталог и метаданные: миграции схем, версии полей и индексов. Часто причиной проблем становятся несогласованные миграции или повреждения структуры.
- Коннекторы и источники данных: неверные параметры подключения, ограничение доступа, изменения схемы источников. Разумна практика тестов подключения перед вводом в эксплуатацию.
- Секреты и аутентификация: истечение срока действия сертификатов, неправильные ключи, недоступность секретов. Рекомендуется автоматизировать мониторинг сроков годности сертификатов и мониторинг доступности секрета.
Практические сценарии и решения
Сценарий 1: сервис не стартует из-за отсутствия секретов
- проверяются Kubernetes Secrets или секреты в Vault, обновляются и перезапускаются сервисы; после обновления рекомендуется выполнить повторную инициализацию миграций и проверить готовность.
Сценарий 2: миграции не проходят
- следует просмотреть журнал миграций, проверить редакцию схемы БД, при необходимости выполнить откат миграций или провести повторную миграцию после исправления ошибок в конфигурации.
Сценарий 3: тайм-ауты в общении между сервисами
- анализ сетевых политик, лимитов CPU/памяти, корректности DNS и маршрутизации; при необходимости увеличить лимиты ресурсов и скорректировать файлы конфигурации.
Сценарий 4: проблемы с TLS и аутентификацией
- проверить срок действия сертификатов, соответствие имени сервиса, доверенные корневые сертификаты; обновить сертификаты и перезапустить сервисы.
Инструменты мониторинга и журналирования
Эффективная диагностика невозможна без полноценных инструментов мониторинга и журналирования. В условиях On Premise целесообразна комбинация локального сбора телеметрии и централизованных хранилищ логов, что обеспечивает корреляцию между событиями и минимизирует время на расследование.
Мониторинг метрик и трассировка:
-
Prometheus в связке с Grafana для визуализации и алертирования по ключевым метрикам: загрузка CPU, потребление памяти, задержки ответа API, время выполнения миграций, пропускная способность коннекторов.
-
OpenTelemetry для трассировки запросов между компонентами, что позволяет увидеть путь запроса и узкие места в цепочке вызовов.
Журналирование:
-
централизованное логирование с использованием стеков типа ELK/OpenSearch или альтернатив: Elasticsearch/OpenSearch для индексации, Logstash/Beats или Fluentd для агрегации, Kibana/OpenSearch Dashboards для анализа. В контексте российского рынка можно рассмотреть OpenSourceOpenSearch как локализованный инструмент, если есть требования к открытости и конфиденциальности.
-
стенд по эффектной корреляции событий: связывание логов по запросам через уникальные идентификаторы сессий, что ускоряет поиск причин сбоев.
Инструменты интеграции и управления конфигурациями:
-
Git как источник конфигураций и миграций, обеспечение traceability изменений;
-
секретирование и управление секретами (Vault, Kubernetes Secrets).
Применимые примеры решений:
Prometheus + Grafana
- широко распространённый стек для мониторинга производительности и доступности сервисов.
OpenTelemetry
- стандарт для распределённой трассировки, упрощает анализ производительности и взаимных зависимостей между компонентами.
В рамках российского рынка можно учитывать локальные решения для логирования и мониторинга, если они внедряются согласно требованиям безопасности и локализации данных; однако основную нагрузку по функциональности часто перекрывают упомянутые открытые решения.
Практические принципы использования инструментов:
-
централизованный сбор и хранение логов с нормализацией форматов;
-
согласованная схема тегирования и идентификации запросов по времени;
-
автоматизация алертирования на основе пороговых значений и корреляционных правил;
-
регулярные тесты доступности и валидирования конфигураций в тестовой среде перед развертыванием в продакшн.
Практики восстановления и тестирования после сбоев
Устойчивость DataLens On Premise требует четко прописанных процедур восстановления и регулярного тестирования. В процессе эксплуатации нацелено на минимизацию времени простоя и быструю проверку гипотез о причинах проблемы.
Подготовка и документация:
-
создание и поддержка Runbook'ов для типовых сценариев сбоев, включая последовательности действий, необходимые команды и контактные лица;
-
ведение регистров изменений и фиксаций обоснованных решений по возврату к стабильной конфигурации.
Стратегии восстановления:
-
безопасный откат к рабочей конфигурации или предыдущей версии образов с повторной миграцией;
-
использование canary/blue-green-подходов при внесении изменений в конфигурацию и миграциях;
-
резервное копирование критических данных и метаданных (для БД метаданных, конфигураций, секретов) с регулярной проверкой восстановления.
Тестирование готовности:
-
плановые тесты восстановления после сбоев, включая симуляцию потери одного из ключевых компонентов;
-
проверка целостности миграций и согласованности схемы после восстановления;
-
проверка совместимости версий после обновления и возврата к рабочим образам.
Организационные аспекты:
-
выделение цепочек ответственности между командами DevOps, системными администраторами и аналитиками;
-
внедрение политики изменения и контроля доступа к критически важным компонентам;
-
регулярные тренировки Incident Response и пост-мортем с извлечением уроков.
Внедрение DataLens On Premise: сценарии внедрения и организационные аспекты
При развёртывании DataLens On Premise важно сочетать архитектуру продукта с организационными процессами. Рассмотрим две взаимодополняющие модели внедрения: централизованное развёртывание в рамках корпоративной сети и гибридное развёртывание с выделенным окружением для разработки и тестирования.
Архитектура внедрения:
-
модулировка: разделение инфраструктурных, бизнес-логических и данных слоёв; единая политика управления секретами и доступом;
-
стандартные сценарии: создание тестовой среды, миграция данных, настройка интеграций, экспорты и резервное копирование;
-
обеспечение совместимости и обновления: согласование версий между компонентами, планирование обновлений без простоев.
Организационные процессы:
-
формирование командной структуры: DevOps, архитектор данных, администратор платформы, бизнес-аналитики;
-
управление изменениями: процессы утверждения изменений, контроль версий, регламент тестирования;
-
безопасность и комплаенс: требования к хранению секретов, шифрованию данных, аудитам и мониторингу.
Сценарии внедрения:
-
локальное развёртывание в защищённой сети силам корпоративной инфраструктуры с упором на безопасность и соответствие корпоративным политикам;
-
постепенная миграция пользователей, поэтапное включение новых источников данных, мониторинг производительности;
-
планирование резервирования и восстановления, тестирование устойчивости и минимизация простоев.
Взаимодействие с открытыми инструментами и локальными решениями:
-
открытые стеки мониторинга и логирования в связке с корпоративными требованиями;
-
интеграция с локальными системами безопасного хранения секретов и управления идентификацией.
Key takeaways
- Диагностика DataLens On Premise требует системного подхода: архитектура, конфигурации, секреты, сеть и интеграции должны рассматриваться вместе.
- Эффективная диагностика начинается с построения четкой картины зависимостей между компонентами и их версий, затем сопровождается сбором логов, метрик и трассировки.
- В условиях On Premise критично обеспечить надежное логирование и мониторинг, связать события между компонентами через уникальные идентификаторы и обеспечить централизованный доступ к данным телеметрии.
- Наличие четко задокументированных Runbook’ов, процессов изменения и планов восстановления существенно сокращает время реакции на инциденты.
- Организационные аспекты внедрения должны включать ясную рольовую структуру, контроль доступа, политики безопасности и подготовку персонала к работе с диагностическими процедурами.
- Практики восстановления, такие как blue/green и canary-развертывания, позволяют снизить риск простоев и обеспечить плавный переход к обновлениям.
- При выборе инструментов мониторинга следует учитывать требования к локализации, открытости и совместимости с существующей инфраструктурой; в типичных условиях важны Prometheus, Grafana и OpenTelemetry как базовый набор, а для логирования
- OpenSearch/ELK‑стек.
FAQ
1) Какие шаги лучше всего предпринять при возникновении ошибки запуска DataLens On Premise?
- Начать с проверки состояния каждого компонента: сетевые соединения, доступность секретов, валидность конфигураций и версий. Затем просмотреть логи стартерного цикла и проверить миграции. В случае повторяемой проблемы полезно воспроизвести сценарий в тестовой среде и применить регрессионный тест к миграциям и конфигурациям.
2) Как проверить сетевые зависимости между компонентами?
- В первую очередь проверить DNS-имена и разрешение внутри кластера. Затем протестировать доступность портов между узлами, используя команды вроде curl или nc. При работе в Kubernetes полезно смотреть поды и события кластера, чтобы увидеть задержки запуска или сетевые тайм-ауты.
3) Какие инструменты наиболее подходят для мониторинга и трассирования?
- На практике эффективен стек Prometheus
- Grafana для метрик и алертинга, OpenTelemetry для распределённой трассировки, а также ELK/OpenSearch-стек или аналог для централизованного логирования. В рамках российского контекста можно учесть локальные решения по безопасности, если они соответствуют требованиям.
4) Что делать, если миграции не проходят?
- Проверить миграционный лоg на предмет ошибок, проверить согласованность схемы БД, убедиться в применимости миграций к текущей версии. При необходимости выполнить откат миграций и повторить процесс после устранения конфликта.
5) Как минимизировать риск простоев при обновлениях?
- Применять стратегии blue/green или canary-развертываний, тестировать обновления в стенде, выполнять контрольный прогон миграций и откатывать изменения при первых признаках нестабильности.
6) Какие организационные практики помогают быстрее восстанавливать сервисы?
- Наличие Runbook’ов, регламентов по управлению изменениями, ролей и ответственностей, а также регулярные обучения по реагированию на инциденты. Важно фиксировать каждое решение и проводить пост-мортем.
7) Какие шаги для повторной валидации после устранения проблемы?
- Перезапуск компонентов по упорядоченной схеме, повторная миграция, тестирование подключений к источникам данных и фидбека пользователем, а затем проверка конечных точек API и UI на предмет корректной работы дашбордов.
8) Как обеспечить корректное управление секретами в On Premise?
- Использовать централизованное хранение секретов (например, Vault или Kubernetes Secrets), внедрить контроль доступа и автоматизированные проверки срока годности сертификатов, а также аудит доступа к секретам.
9) Что считать «готовностью» сервиса к операции?
- Наличие валидной конфигурации, доступность секретов, успешная миграция схем, корректная работа зависимых сервисов и удовлетворение основных метрик доступности и отклика.
10) Какой подход к тестированию лучше всего подходит для On Premise?
- Комбинация функционального тестирования, регрессионного тестирования миграций, нагрузочного тестирования и тестирования восстановления. В идеале
- отдельная тестовая среда, повторяемые сценарии инцидентов и автоматизированные проверки перед продакшном.
Если вы ищете инструмент для быстрой и эффективной аналитики без сложного внедрения и высоких затрат, обратите внимание на Yandex DataLens - современную платформу визуализации и анализа данных.
Сервис позволяет подключаться к различным источникам, строить дашборды и делиться аналитикой с командой — при этом он бесплатен, прост в освоении и подходит как для старта, так и для корпоративных решений. Благодаря экосистеме Yandex Cloud и возможности развертывания в закрытом контуре, DataLens становится универсальным инструментом для построения data-driven аналитики в компаниях любого масштаба.


