

DBT Data Build Tool: революционный подход к трансформации данных для современного бизнеса
Сегодня мы хотим познакомить вас с инструментом, который кардинально меняет подход к преобразованию данных — DBT Data Build Tool. За последние годы DBT стал отраслевым стандартом для организаций, которые серьезно относятся к качеству своих данных и скорости аналитики.
Современный бизнес любого масштаба хранит критически важные данные в десятках различных систем: CRM, ERP, базы данных, файловые хранилища, API. Каждая из этих систем решает свои конкретные задачи, но настоящая ценность возникает тогда, когда данные из всех источников объединяются, очищаются и превращаются в единую согласованную картину. Именно на этапе трансформации данных возникает большинство проблем — от банальных ошибок в расчетах до полной неспособности масштабировать аналитику при росте бизнеса.
DBT решает именно эти проблемы. Это не просто инструмент, а целая философия работы с данными, которая превращает хаотичные SQL-скрипты в надежный, тестируемый и документированный производственный процесс.
Прежде чем погрузиться в детали DBT, давайте рассмотрим типичные сценарии, с которыми сталкиваются компании:
- "SQL-скрипты на коленке". Аналитики пишут отдельные SQL-запросы для каждого отчета. Со временем накапливаются сотни скриптов, которые дублируют логику расчета ключевых показателей; содержат противоречивые формулы для одних и тех же метрик; не имеют документации и тестов и ломаются при малейшем изменении в источниках данных. Главный риск в данном случае - это возможные финансовые потери из-за неверных данных, принятие ошибочных управленческих решений, недели и месяцы на исправление ошибок.
- "Самодельные фреймворки". IT-отдел разрабатывает кастомные системы для ETL-процессов. Эти решения требуют постоянной доработки и поддержки, не обладают гибкостью для быстрого изменения бизнес-логики, создают зависимость от конкретных разработчиков, и часто не имеют встроенных механизмов тестирования данных. Самый главный риск в данном случае – это высокие затраты на разработку и поддержку, неспособность быстро адаптироваться к изменяющимся бизнес-требованиям, технологический долг.
DBT предлагает принципиально иной подход, основанный на лучших практиках разработки программного обеспечения, примененных к миру данных.
Фундаментальные принципы DBT
1. Модели как код
В DBT каждая таблица или представление в вашем аналитическом хранилище описывается как модель — SQL-файл с использованием шаблонизатора Jinja. Это позволяет строить сложные цепочки преобразований с явными зависимостями, автоматически переиспользовать общую логику, а также применять единые стандарты ко всем преобразованиям.
Пример простой модели, которая объединяет данные о заказах и клиентах:
-- models/marts/customer_orders.sql

{{ config(
    materialized='table',
    tags=['core', 'daily']
) }}

select
    c.customer_id,
    c.customer_name,
    c.region,
    min(o.order_date) as first_order_date,
    max(o.order_date) as last_order_date,
    count(o.order_id) as total_orders,
    sum(o.amount) as total_revenue
from {{ ref('stg_customers') }} as c
left join {{ ref('stg_orders') }} as o
    on c.customer_id = o.customer_id
group by 1, 2, 3
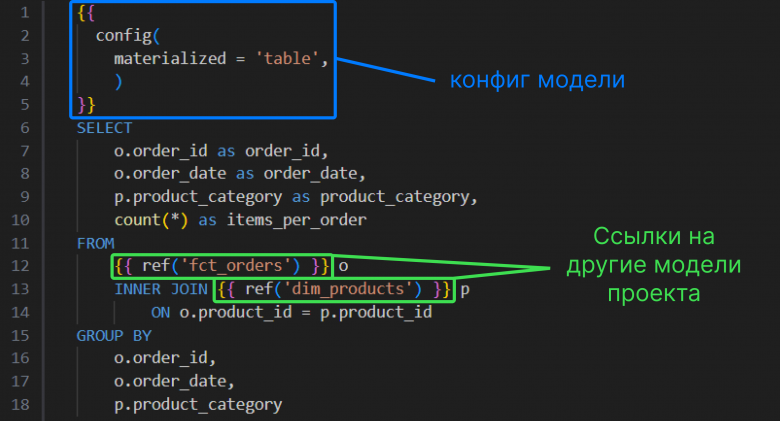
Обратите внимание на макросы {{ ref() }} — они создают явные зависимости между моделями, что позволяет DBT автоматически строить граф выполнения и понимать порядок обработки данных.
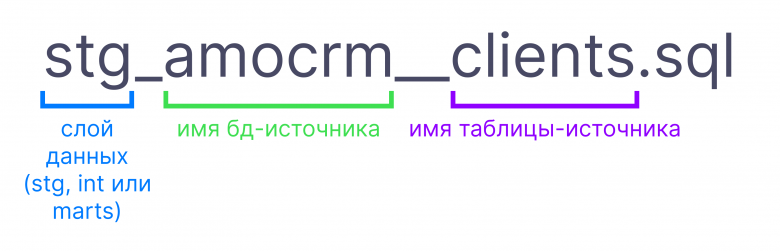
Пример наименования модели данных:
Структура шаблона:
Пример инкрементальной модели:
{{
    config(
        materialized='incremental',
        unique_key='event_id',
        on_schema_change='fail'
    )
}}
select
    event_id,
    user_id,
    event_timestamp,
    event_type
from {{ source('analytics', 'events') }}
{% if is_incremental() %}
where event_timestamp > (select max(event_timestamp) from {{ this }})
{% endif %}
Такой подход может сокращать время выполнения ежедневного обновления данных с часов до минут для таблиц в сотни миллионов записей.
2. Многоуровневая архитектура данных
DBT поощряет организацию моделей в логические слои, что соответствует лучшим практикам построения хранилищ данных:
- Staging (сырые данные). Модели, которые непосредственно отражают данные из источников, с минимальной очисткой и стандартизацией. Например, переименование колонок в единый стандарт, приведение типов данных.
- Intermediate (промежуточные преобразования). Сложные бизнес-расчеты, объединение данных из разных источников, подготовка данных для финальных витрин.
- Marts (витрины данных). Готовые для использования данные, ориентированные на конкретные бизнес-направления: маркетинг, финансы, продажи.
Такое разделение обеспечивает модульность, упрощает тестирование и делает процесс преобразования данных прозрачным и понятным.
Тестирование данных: от реактивного к проактивному подходу
Классическая проблема состоит в том, что ошибка в данных обнаруживается только тогда, когда кто-то из руководства видит неверные цифры в отчете. К этому моменту уже могут быть приняты ошибочные решения.
DBT встраивает тестирование непосредственно в процесс преобразования данных.
Это могут быть Singular – тесты - самый простой вид тестов, выполняющий запрос к таблице на поиск строк с ошибкой. Если dbt нашёл хотя бы одну неправильную строку), то он сообщит об ошибке в данных.
Пример:
selectorder_id,amount,from {{ ref('orders') }}where amount < 0
Кроме того, это могут быть Generic-тесты (готовые проверки):
version: 2models:- name: banksdescription: "Таблицалидеровбанковскогосектора"columns:- name: bank_namedescription: "Названиебанка"tests:- unique- accepted_values:values: ['Сбербанк', 'Альфа-банк', 'ВТБ', 'Т-банк', 'Газпромбанк']
Также DBT позволяет писать свои собственные generic-тесты. Если вы захотите написать свой собственный not_null тест, то для этого в папке macros нужно будет создать следующий .sql файл:
{% test my_not_null(model, column_name) %}select *from {{ ref(model) }}where {{ column_name }} is null{% endtest %}
Применим тест к модели банков:
version: 2models:- name: banksdescription: "Таблица лидеров банковского сектора"columns:- name: bank_namedescription: "Названиебанка"tests:- unique- accepted_values:values: ['Сбербанк', 'Альфа-банк', 'ВТБ', 'Т-банк', 'Газпромбанк']- my_not_null
И, наконец, это могут быть unit-тесты, которые позволяют проверить, что логика трансформации написана верно. Такие тесты добавляются в .yml файл модели с помощью следующего теста:
unit_tests:- name: test_is_valid_email_addressmodel: dim_customersgiven:- input: ref('stg_customers')rows:- {email: cool@example.com, email_top_level_domain: example.com}- {email: cool@unknown.com, email_top_level_domain: unknown.com}- {email: badgmail.com, email_top_level_domain: gmail.com}- {email: missingdot@gmailcom, email_top_level_domain: gmail.com}- input: ref('top_level_email_domains')rows:- {tld: example.com}- {tld: gmail.com}expect:rows:- {email: cool@example.com, is_valid_email_address: true}- {email: cool@unknown.com, is_valid_email_address: false}- {email: badgmail.com, is_valid_email_address: false}- {email: missingdot@gmailcom, is_valid_email_address: false}
Дополнительные возможности DBT для профессионалов
Макросы для использования логики
Макросы в DBT — это мощный инструмент для устранения дублирования кода и стандартизации расчетов.
Предположим, мы работаем с гео-данными и нам надо рассчитать расстояние от точки до точки, зная широту и долготу. Напишем следующий макрос:
{% macro haversine_distance(lat1, lon1, lat2, lon2) %}6371 * acos(cos(radians({{ lat1 }})) cos(radians({{ lat2 }}))cos(radians({{ lon2 }}) - radians({{ lon1 }})) +sin(radians({{ lat1 }})) * sin(radians({{ lat2 }}))){% endmacro %}
И добавим его в нашу модель:
selectid as location_id,{{ haversine_distance('lat1', 'lon1', 'lat2', 'lon2') }} as distance_km,...from app_data.locations
Запрос без использования макроса:
selectid as location_id,6371 * acos(cos(radians(lat1)) cos(radians(lat2))cos(radians(lon2) - radians(lon1)) +sin(radians(lat1)) * sin(radians(lat2))) as distance_km,...from app_data.locations
Самая большое преимущество макросов заключается в том, что под большое количество стандартных задач они уже написаны и собраны в группы, которые можно добавлять в проект, экономя таким образом достаточно много времени.
Чтобы добавить пакет макросов, нужно создать в корне проекта файл packages.yml и добавить в него следующую структуру:
packages:- package: dbt-labs/codegenversion: 0.13.1- package: dbt-labs/dbt_utilsversion: 1.1.1
Снимки данных (Snapshots) для отслеживания исторических изменений
DBT Snapshots реализуют методологию Slowly Changing Dimensions Type 2, позволяя отслеживать историю изменений данных.
Существует 2 стратегии определения изменений в таблице:
- Timestamp - видит изменения в оригинальной таблице на основе поля, в котором хранятся дата и время изменения строки
- Check - сравнивает содержимое оригинальной и целевой таблиц
Timestamp более предпочтительна, так как исполняется гораздо эффективнее и быстрее, но не применима к таблицам без данных о дате и времени изменения. check более медленная, применима для любых типов таблиц.
snapshots:- name: orders_snapshotrelation: source('jaffle_shop', 'orders')config:schema: snapshotsdatabase: analyticsunique_key: idstrategy: timestampupdated_at: updated_atdbt_valid_to_current: "to_date('9999-12-31')"
Seeds
Seeds — это функционал в dbt, который позволяет загружать статические справочные данные (обычно в формате CSV) непосредственно в ваше хранилище данных как обычные таблицы. Это простой способ управлять небольшими наборами данных, которые редко меняются, но необходимы для ваших преобразований.
Рассмотрим пример - файл seeds/country_codes.csv:
country_code,country_name,region
US,United States,North America
DE,Germany,Europe
JP,Japan,Asia
После выполнения dbt seed вы получите таблицу country_codes в вашей БД, которую затем можно будет использовать в моделях:
-- models/regional_sales.sql
SELECT
    s.*,
    c.region
FROM sales s
LEFT JOIN {{ ref('country_codes') }} c
    ON s.country_code = c.country_code
Adhoc запросы (Analyses)
Иногда может понадобиться сделать какой-то разовый запрос. Такие запросы называют Adhoc запросами. Для их написания в dbt существует сущность Analyses.
Analyses не меняют структуру базы данных, но при компиляции выдают готовый SQL-запрос. Они хранятся в папке /analyses и представляют из себя SQL-шаблоны идентичные шаблонам моделей.
-- analyses/running_total_by_account.sqlwith journal_entries as (select *from {{ ref('quickbooks_adjusted_journal_entries') }}), accounts as (select *from {{ ref('quickbooks_accounts_transformed') }})selecttxn_date,account_id,adjusted_amount,description,account_name,sum(adjusted_amount) over (partition by account_id order by id rows unbounded preceding)from journal_entriesorder by account_id, id
Свежесть данных (Data freshness)
В рамках стандартного ELT-процесса данные по расписанию извлекаются из систем-источников, после чего на их основе рассчитываются витрины и формируются отчёты. Представим ситуацию: технически процесс завершился успешно, однако позже пользователи отчётов сообщают о неполном или отсутствующем обновлении. Причина часто кроется в том, что исходные данные в источнике не были своевременно обновлены. Чтобы proactively выявлять такие ситуации, а не реагировать на жалобы, в инструменте DBT предусмотрен функционал Freshness, предназначенный для мониторинга актуальности данных в источниках.
Для добавления этого функционала нужно прописать в .yml файле параметры проверки свежести данных:
version: 2sources:- name: jaffle_shopdatabase: rawfreshness: # настройки свежести по умолчаниюwarn_after: {count: 12, period: hour} # предупреждение через 12 часовerror_after: {count: 24, period: hour} #ошибкачерез24часаloaded_at_field: etlloaded_at # поле, указывающее на время загрузкиtables:- name: customers # эта таблица будет использовать настройки свежести по умолчанию- name: ordersfreshness: # более строгие настройки свежести для этой таблицыwarn_after: {count: 6, period: hour}error_after: {count: 12, period: hour}# Применяем условие в запросе свежестиfilter: datediff('day', etlloaded_at, current_timestamp) < 2 # требуется, чтобы данные были загружены менее 2 дней назад- name: product_skusfreshness: # не проверять свежесть для этой таблицы
Метаданные (Metadata) и генерация документации
Метаданные представляют собой информацию о данных, которая предоставляет аналитикам и инженерам контекст, необходимый для понимания их содержания и целей применения. Инструмент DBT предлагает комплексный подход к управлению метаданными, позволяя описывать модели и источники, аннотировать атрибуты, назначать теги для группировки, а также определять пользовательские метаданные через параметр meta. Это открывает возможности для кастомизации, например, для указания ответственного владельца набора данных.
Пример .yml файла с описанием модели обогащённой метаданными:
models:- name: user_ordersdescription: "Агрегированныезаказыпользователей"tags: ["marketing", "core"]meta:owner: "marketing-team@sberbank.ru"business_owner: "Руководитель отдела маркетинга"columns:- name: user_iddescription: "УникальныйIDпользователя"- name: first_order_datedescription: "Датапервогозаказа"- name: total_ordersdescription: "Общееколичествозаказов"- name: avg_order_valuedescription: "Среднийчек(RUB)"meta:currency: "RUB"rounding: 2
На основе заданных метаданных можно сгенерировать документацию с помощью следующих команд:
-
dbt docs generateсоздаёт статический сайт документации -
dbt docs serveзапускает локальный веб-сервер и отображает полуенную документацию. По умолчанию сервер разворачивается на порту 8080, который изменить, используя флаг -- port .
Реальные бизнес-кейсы внедрения DBT
Кейс 1: Финансовый институт
До внедрения DBT 40% времени аналитика уходило на поиск и исправление ошибок в данных, отчеты для регуляторов содержали расхождения в 3-5%, а новые метрики разрабатывались 2-3 недели.
После внедрения DBT автоматические тесты выявляют 95% ошибок до попадания в отчет, достигнуто полное соответствие данных в разных отчетах, новые метрики добавляются за 1-2 дня.
Кейс 2: E-commerce компания
До внедрения DBT ежедневное обновление данных занимало 6 часов, при сбое процесс приходилось запускать с начала, маркетологи не доверяли данным о ROI кампаний.
После внедрения DBT инкрементальные обновления сократили время до 30 минут, появилась возможность перезапуска только неудавшихся частей пайплайна, а прозрачные и понятные расчеты ROI увеличили доверие к данным на 80%.
Типичные ошибки при внедрении DBT и как их избежать
Как правило, при внедрении dbt допускаются одни и те же ошибки. Представляем вашему вниманию их краткий список:
- Попытка перенести все существующие SQL-скрипты без рефакторинга. Оптимальнм решением в данном случае может стать поэтапный перенос с перепроектированием архитектуры данных;
- Игнорирование тестирования на начальных этапах. Наиболее оптимальным решением станет старт с критически важных данных и постепенное покрытие тестами всей кодобазы.
- Отсутствие обучения команды лучшим практикам работы с DBT. Решение в данном случае состоит в проведении воркшопов, создание внутренних гайдлайнов, code review.
Итак, как вы видите, DBT — это не просто инструмент, а культурный сдвиг в работе с данными. Его успешное внедрение требует старта с пилотного проекта — выберите один важный, но не критичный бизнес-процесс.
Кроме того, крайне важным аспектом успешной работы с dbt является обучение команды — инвестируйте в понимание философии DBT, а не только синтаксиса.
И не забывайте о постепенном масштабировании — от пилота к полноценной реализации.
Не позволяйте несовершенным процессам работы с данными ограничивать рост вашего бизнеса. Помните о том, что DBT — это проверенный путь к надежной, масштабируемой и доверенной аналитике.


