

Детекция изменений: источники данных и CDC
В этом разделе мы разберёмся с тем, откуда берутся данные для алгоритмов обнаружения изменений, что такое CDC (Change Data Capture) и зачем в контексте Slowly Changing Dimensions (SCD) нужны именно эти источники и механизмы. Что такое изменения в данных? Это любые обновления записей в операционных системах источников: добавления новых записей, изменение значений полей, удаление строк. Для задач бизнес-аналитики и хранилищ данных важно не просто фиксировать факт изменения, а сохранять историю изменений таким образом, чтобы аналитики могли реконструировать состояние бизнес-объекта на любой момент времени.
Ключевые понятия:
- Источник данных (data source) — операционные базы данных, файловые хранилища, потоковые сервисы, которые являются источниками изменений.
- Change Data Capture (CDC) — методика или инфраструктура, которая отслеживает и передаёт изменения из источника данных в целевые системы (потоки событий, ленточные или журнальные хранилища, Data Warehouse).
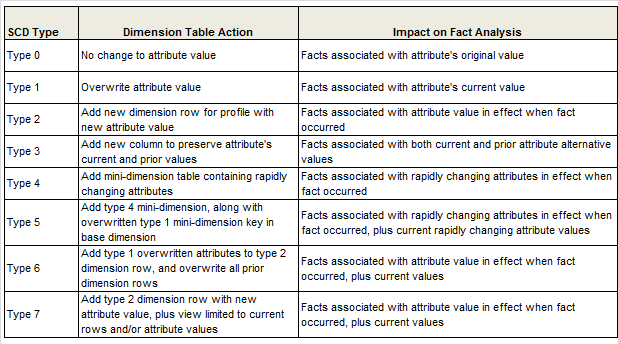
- Slowly Changing Dimensions (SCD) — концепция хранения истории измерений в хранилище данных; различают типы изменений, например Type 1 (заменение), Type 2 (версионирование), Type 3 (частично сохраняем предыдущие значения).
- Источник изменений (change source) и транспорт изменений (change transport) — механизм регистрации изменений и их доставка в целевые системы.
- Точка согласованности (consistency point) — когда данные в целевой системе соответствуют состоянию источника на заданный момент времени.
Цель этой главы — показать, как строятся источники данных для CDC, какие методы подходят для SCD и какие практические подходы применяются в реальных архитектурах, включая как открытые (open-source) решения, так и российские (локальные) инфраструктуры.
Теоретическая часть
Источники данных для CDC: что фиксируем и почему это важно
Источники данных для CDC обычно представляют собой транзакционные OLTP-системы: PostgreSQL, MySQL, SQL Server, Oracle, MongoDB и другие. Также встречаются файловые журналы изменений, очереди сообщений, логи событий из сервисов и микросервисов. Ключевые типы источников:
- Реляционные базы данных (PostgreSQL, MySQL, SQL Server, Oracle) — часто поддерживают встроенное логирование изменений: WAL (PostgreSQL), binlog (MySQL), redo/undo логи (Oracle, SQL Server транзакционные логи). Эти журналы позволяют проследить каждую операцию вставки/обновления/удаления.
- Документно-ориентированные БД (MongoDB и др.) — события изменений могут идти через oplog (MongoDB) или аналогичные журналы изменений.
- Потоки изменений в файловой системе или облачных хранилищах — например, изменения в файлах выгрузок, которые требуют детекта изменений через сравнение.
- Потоки сообщений и событий (Kafka topics, AMQP, Pulsar) — источники, которые уже сами являются потоками изменений, например в доменах, где данные уже публикуют события.
CDC против традиционного ETL
- Традиционный ETL обычно работает пакетно: периодически загружает данные за определённый интервал времени, без детального учёта каждой операции в источнике.
- CDC ориентирован на непрерывную передачу изменений: это снижает задержку (low latency) и повышает точность истории изменений.
- CDC снижает риск пропуска изменений между пакетными загрузками, но требует устойчивой архитектуры к сетевым задержкам, сортировке по времени и обработке дубликатов.
Методы реализации CDC
- Log-based CDC (основанный на чтении журналов изменений) — наиболее надёжный и масштабируемый подход: читает записи из WAL/binlog/ oplog. Требует настройки источника на возможность чтения журналов изменений и иногда дополнительной конфигурации доступа.
- Trigger-based CDC — срабатывание триггеров внутри БД для фиксации изменений в специальные таблицы аудита. Применимо, когда логирование изменений недоступно или ограничено. Минусы: накладные расходы на вставку триггеров, потенциальное влияние на производительность.
- Timestamp-based/query-based CDC — сравнение снимков для определения изменений по временным меткам. Обычно менее эффективно при больших объёмах и частых обновлениях.
- Decoding изменений и схемы эволюции — важно учитывать, как изменяются схемы источников (колонки появляются/удално исчезают), как это отражается в целевой схеме и в процессе обработки.
CDC и SCD: как это связано
- Цель SCD — сохранить историю изменений аналитических измеряемых объектов (клиентов, продуктов, контрактов и т. п.) в хранилище данных. CDC служит транспортом изменений: он улавливает факты изменений в источниках и передаёт их в конвейеры преобразований.
- Применение в SCD Type 2 требует не только фиксации того, что произошло, но и сохранения новой версии строки и пометок, когда она стала актуальной. CDC-потоки упрощают обнаружение изменений и позволяют своевременно создавать новые версии в целевой таблице.
Термины и методики, которые важно запомнить
- Hash-based change detection — вычисление контрольной суммы набора значений строки для определения изменений, полезно когда источники не поддерживают логирование на уровне отдельных столбцов и когда требуется детектировать минимальные изменения.
- Effective date (effective_from) и end date (effective_to) — временные метки версии в таблицах SCD2; позволяют восстанавливать состояние объекта на любой момент времени.
- Current flag (is_current) — флаг, показывающий, является ли версия записи актуальной.
- Soft delete — метод обработки удалённых записей, когда удаление фиксируется как версия с флагом удаления, чтобы история не потерялась.
- Idempotence — способность повторного применения той же операции не приводить к нежелательным результатам; критично для CDC, чтобы избежать дублирования в конвейере.
- Schema evolution — изменение структуры источников (добавление колонок, изменение типов) требует поддержки в CDC-конвейере и в целевых таблицах SCD.
- Idempotent upserts — механизм, который позволяет корректно применить изменения, даже если одно и то же событие приходит несколько раз.
Практические ориентиры: архитектуры CDC-SCD
- Архитектура на базе Kafka/потоков событий: источник -> CDC-коннектор (Debezium, к примеру) -> Kafka topic -> консьюмеры/ETL-инструменты (к примеру Spark, Flink) -> целевой Data Warehouse (PostgreSQL, ClickHouse, Delta Lake) с реализацией SCD-2.
- Архитектура на базе Spark/Delta Lake: CDC-события конвертируются в потоки изменений, затем применяется MERGE-операция для SCD2 в Delta Lake; поддерживается версиями через временные столбцы и псевдогенерируемые версии.
- Архитектура на базе NiFi/StreamSets: визуальные конвейеры для инжекции изменений, трансформаций и маршрутизации в целевые хранилища; полезно при ограничении в разработке кода и для быстрой настройки прототипов.
- Архитектура на базе облачных платформ: многие провайдеры предлагают готовые коннекторы CDC и интеграцию в Data Lake/ data warehouse: например, коннекторы Debezium для облачных КЕ (Kafka в кластерах Kubernetes), интеграции с облачными хранилищами и аналитическими слоями.
Практические примеры
Пример 1 — открытое решение: Debezium + Kafka + Spark/ClickHouse
Описание
- Источник: PostgreSQL с включённой логикой WAL и поддержкой логического декодирования.
- CDC-решение: Debezium PostgreSQL Connector, который читает WAL и публикует события изменений в Kafka.
- Транспорт и обработка: Kafka topics для изменений; потребители (Spark Structured Streaming или Flink) читают события и применяют бизнес-логику.
- Хранение: целевое хранилище — ClickHouse для аналитики; или Delta Lake в Spark для гибридной аналитики.
- Реализация SCD2: при каждом событии обновления создаётся новая версия строки в таблице измерения, устанавливаются поля effective_from и effective_to; через is_current определяется текущая запись версии.
Пример конфигурации коннектора Debezium (упрощённо):
connector.class=io.debezium.connector.postgresql.PostgresConnector
tasks.max=1
database.hostname=postgres-host
database.port=5432
database.user=cdc_user
database.password=*****
database.dbname=source_db
table.include.list=sales.customers
plugin.name=pgoutput
logical.decode.document.ids=true
slot.name=debezium_slot
publication.autocreate.mode=disable
include.schema.changes=false
Трансформации в конвейере
- Изменения в событиях состоят из операции (c or u or d), первичного ключа, значений всех полей.
- В конвейере мы применяем логику SCD2: если операция — UPDATE и изменились ключевые атрибуты, мы создаём новую версию записи в таблице измерения с новым version_id и updated_at; а предыдущую версию помечаем как не актуальную (исключаем через is_current=false, устанавливаем end_date, или аналогично в вашей схеме).
Пояснение по моделированию SCD2
- Таблица измерений клиента ( Customer_dim ) имеет поля: surrogate_key PK; business_key (natural key, например, customer_id); attribute_1, attribute_2; effective_from, effective_to; is_current; version.
- При вставке новой записи устанавливаем effective_from = current_timestamp, effective_to = NULL, is_current = true.
- При обновлении: 1) обновляем предыдущую запись, устанавливая effective_to = current_timestamp, is_current = false; 2) вставляем новую запись с обновлёнными значениями и тем же business_key, effective_from = current_timestamp, effective_to = NULL, is_current = true.
Пример 2 — российские контексты и решения: Яндекс DataSphere + ClickHouse
Описание
- Яндекс DataSphere — российская платформа данных для анализа и обработки данных; в рамках инфраструктуры часто используется связка Debezium/Kafka для CDC и ClickHouse как аналитического хранилища.
- Применение: сценарий аналогичен примеру 1, но с использованием российских облачных сервисов и локальных развертываний. Debezium-коннектор может быть размещён в Kubernetes в дата-центре или в облаке Яндекс.Облако, Kafka-кластер — также в облаке или локально, ClickHouse — в кластере на базе российских серверов.
Практический пример 3 — Delta Lake + Spark для SCD2
Описание
- Источник: MySQL или PostgreSQL.
- CDC: Debezium или встроенные коннекторы.
- Поток обработки: Spark Structured Streaming либо Flink, который принимает CDC-события, конвертирует их в поток изменений и применяет операции MERGE into delta_table в Delta Lake.
- Хранение: Delta Lake (победа за счёт ACID, поддержки версии файлов и time travel). SCD2 реализуется аналогично описанной схеме: добавление новой версии, актуализация предыдущей версии.
Типичная архитектура CDC-SCD
- Источник изменений: OLTP БД (PostgreSQL/MySQL/SQL Server) или облачный источник с поддержкой лога изменений.
- Коннектор CDC: Debezium, Oracle GoldenGate (продвинутый коммерческий вариант), Striim, Confluent Platform.
- Платформа интеграции/оркестрации: Apache Kafka (для потока изменений), Apache NiFi, Airflow или StreamSets для управления конвейерами и трансформациями.
- Целевое хранилище: ClickHouse, Delta Lake (Spark), PostgreSQL, Snowflake и т. п.
- Модели данных SCD: таблицы измерений с полями для версии и времени действия.
Особенности и детали реализации
- Конфигурация Debezium: необходимо указать источник (PostgreSQL или MySQL), список таблиц, репликационные слоты и публикации, формат сериализации (Avro/JSON), а также обработку схем (накладываемые изменения).
- Обеспечение идемпотентности: гарантировать, что повторная доставка одного и того же события не создаёт дубликаты; это достигается через уникальные ключи, согласованные схемы и использование Kafka with exactly-once semantics.
- Обработка изменений схемы: если в источнике происходят изменения структуры, требуется поддержка динамических схем. Debezium и современные конвейеры обычно упрощают ситуацию, но в целевом SCD-слое нужно предусмотреть колонки, их типы, и обработку эволюции схемы.
- Нормализация ключей: surrogate key для целевой таблицы SCD2 нужен для скрытия изменений бизнес-ключа и обеспечения стабильности ссылок со стороны fact и dimension-таблиц.
Безопасность и управление данными
- Уровни доступа: обеспечьте разграничение доступа к источникам, коннекторам и конвейерам.
- Шифрование и хранение секретов: используйте безопасное хранение паролей и ключей (например, Kubernetes Secrets или Vault).
- Соответствие требованиям: в рамках России учитывайте требования к локализации данных, хранения персональных данных (ПДН/ПДн), обработке конфиденциальной информации; в некоторых случаях требуется хранение данных внутри страны.
Риски и ограничения
- Задержки и пропуск изменений: хотя CDC обеспечивает низкую задержку, задержки сети, проблемные узлы и перегрузки могут привести к пропуску изменений или задержке их доставки.
- Несоответствие времени: событие может прийти с опозданием относительно времени, когда оно было создано в источнике; важно поддерживать корректное time-stamping и строгую логику MERGE.
- Эффект schema evolution: добавление колонок требует адаптации целевых таблиц и процессов обработки; несогласованность схемы может привести к падению конвейера.
- Уплотнение данных и дубликаты: при повторной отправке событий или некорректной обработке дубликаты могут появиться; необходимо реализовать дедупликацию и idempotence.
- Риски безопасности: журнал изменений может содержать чувствительную информацию; обеспечение соответствия требованиям по защите данных, а также ограничение доступа к журналам изменений — критично.
- Стоимость: инфраструктура CDC (коннекторы, Kafka, Spark/Flink, хранилище) может быть дорогой, особенно в масштабе; нужно заранее продумать кластеризацию, резервы по вычислениям и хранению.
Практические аспекты внедрения
- Поэтапная реализация: рекомендуется начать с пилота на одном источнике (например, PostgreSQL) и одном целевом хранилище (ClickHouse или Delta Lake), затем постепенно расширять на другие источники и типы изменений.
- Тестирование консистентности: настройте тесты на консистентность историй SCD2, проверьте корректность версионирования и корректность окончания версии (effective_to) для каждой строки.
- Мониторинг: используйте метрики задержки, объём CDC-сообщений, количество ошибок в коннекторе; мониторинг в реальном времени помогает быстро обнаружить проблемы в цепочке.
- Обновления и миграции: когда обновляете коннекторы или платформы, поддерживайте backward-compatible схемы и тестируйте регрессивно.
- Документация и аудит: документируйте валюту бизнес-логики, какие поля попадают в SCD2, какие исключения обрабатываются; храните аудиты по изменениям конвейера.
CDC как источник изменений — основа современных архитектур HCD/CDC для SCD в хранилищах данных. Правильный выбор источников изменений, коннекторов и целевых хранилищ позволяет строить надёжные, масштабируемые и управляемые конвейеры для хранения исторических изменений. Важно помнить о задержках, схемах эволюции, идемпотентности и правильной модели SCD2. Приведённые примеры включают открытые решения (Debezium, Kafka, Spark/Delta Lake, ClickHouse) и российские контексты (Яндекс DataSphere и российская технологическая база вокруг ClickHouse). В реальных проектах обычно выбирают гибридный подход: для критичных к latency источников — log-based CDC с минимальными задержками; для менее чувствительных к задержкам — триггерные решения или пакетная обработка, чтобы снизить стоимость и сложность.
Вопрос–Ответ (FAQ)
1) Что такое CDC и зачем он нужен в контексте SCD?
CDC — это методика захвата и передачи изменений из источника в целевую систему в режиме близком к реальному времени. В SCD она нужна для того, чтобы точно и последовательно сохранять историю изменений бизнес-объектов: новые версии записей появляются в целевой таблице, а старые версии помечаются как неактуальные. Это позволяет аналитикам восстанавливать состояние объектов на любой момент времени и проводить точный анализ изменений.
2) Какие источники изменений чаще всего используются в CDC?
Реляционные базы данных (PostgreSQL, MySQL, SQL Server, Oracle) через логи транзакций (WAL/binlog). Также используемы документоориентированные БД (MongoDB) через their oplog, файловые журналы и потоковые источники (Kafka topics, очереди сообщений). В реальных проектах часто сочетаются несколько источников.
3) Какие методы CDC существуют и чем они отличаются?
Log-based CDC — наиболее надёжный и эффективный метод, считывающий изменения из журналов транзакций (WAL, binlog). Trigger-based CDC — использует триггеры на таблицах для записи изменений; может влиять на производительность. Timestamp-based — сравнение снимков по временным меткам, менее точно для частых изменений. В общем случае log-based CDC предпочтителен.
4) Как связать CDC с SCD Type 2 в практической архитектуре?
По цепочке: источник изменений (OLTP) → CDC-коннектор (Debezium и др.) → Kafka (или иной поток) → обработчик (Spark/Flink/NiFi/StreamSets) → целевое хранилище (ClickHouse/Delta Lake). В SCD2 мы добавляем новую версию записи и помечаем предыдущую как неактуальную, используя поля effective_from, effective_to, is_current и surrogate_key.
5) Что такое SCD Type 2 и как он реализуется?
SCD Type 2 сохраняет полную историю изменений в измерениях: каждая новая версия объекта получает новую запись в размерном измерении с новым surrogate key и временными метками. Предыдущие версии не удаляются, а помечаются как устаревшие. Реализация требует корректной бизнес-логики: определение, какие изменения действительно являются изменениями, обработка нулевых значений, и правильная синхронизация времени.
6) Какие технологии часто применяются в открытом экосистеме (open-source) для CDC-SCD?
Debezium (CDC коннекторы для PostgreSQL, MySQL, MongoDB и т. д.), Apache Kafka (платформа потоков), Apache Spark / Flink (потоковая обработка), Delta Lake (управление версиями и MERGE), ClickHouse (быстрое аналитическое хранилище), Apache NiFi или StreamSets для оркестрации, Meltano для интеграции и разработки конвейеров.
7) Какие российские решения можно использовать в контексте CDC-SCD?
Российские проекты вокруг обработки больших данных часто используют ClickHouse как аналитическую БД (разработана и поддерживается российскими компаниями, ориентирована на высокую производительность аналитики). Яндекс DataSphere представляет собой российскую платформу для обработки и анализа данных; в рамках неё часто применяют CDC через Debezium/Kafka и локальные or облачные инфраструктуры. В реальных проектах также применяется инфраструктура на базе отечественных облаков и сервисов, связанных с российскими поставщиками, поддерживающими интеграцию с Debezium и Kafka.
8) Какие сложности могут возникнуть при внедрении CDC-SCD?
Задержки в цепочке, пропуски изменений из-за задержек сети; сложность поддержки схемы источника, миграций схем; риск дубликатов и нехватка идемпотентности; обеспечение безопасности и конфиденциальности журналов изменений; стоимость инфраструктуры и управление большим потоком изменений; требования к точности временных штамп и согласованию времён across distributed systems.
9) Какую роль играет время в CDC-SCD?
Время — ключевой фактор: latency (задержка), execution time of updates, время начала действия версии и её окончания. При моделировании SCD2 важно правильно поддерживать effective_from и effective_to; несогласованности времени приводят к неверной истории изменений.
10) Какие этапы тестирования стоит запланировать для CDC-SCD?
Тесты целостности истории (проверка, что каждая новая версия действительно заменяет предыдущую там, где нужно); тесты на дубликаты; тесты на обработку поздних событий и out-of-order; нагрузочные тесты на скорость обработки и устойчивость к сбоям; тесты на совместимость схем источников и целевых схем; проверка соответствия требованиям по защите данных.
Детекция изменений и CDC — ключевые концепты для современных хранилищ данных: они позволяют сохранять точную и управляемую историю изменений в бизнес-объектах и обеспечивают аналитикам возможность реконструировать прошлые состояния и тенденции. В учебном курсе по SCD Slowly Changing Dimensions важно владение двумя сторонам: (1) теория CDC, источников данных и методик детекции изменений; (2) практическая реализация через открытые решения и локальные российские контексты. Комбинация Debezium + Kafka + Spark/Delta Lake или ClickHouse даёт мощный и понятный путь от источника изменений к надёжной истории в SCD2. При этом необходимо учитывать риски, ограничения и требования к безопасности, а также планировать мониторинг и тестирование. В следующем разделе мы углубимся в технические детали реализации и конкретные шаги по настройке и развертыванию CDC-SCD конвейеров.


