

Elasticsearch
Что такое индекс?
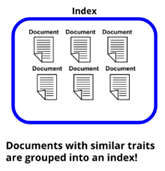
В Elasticsearch индекс - это структура, хранящая данные в формате, оптимизированном для поиска и анализа. Индексы содержат документы, которые являются основными информационными объектами в Elasticsearch. Каждый документ имеет уникальный идентификатор и содержит одно или несколько полей с данными.
Процесс индексирования в Elasticsearch начинается тогда, когда документ отправляется в поисковую систему через REST API. Когда система получает запрос, документ сохраняется в одном или нескольких шардах и индексируется для того, чтобы по нему можно было осуществлять поиск.
Индексирование включает в себя анализ документа для извлечения лексем (ключевых слов) и их хранение в структуре, оптимизированной для поиска. Токены сопоставляются с терминами, которые индексируются в инвертированном дереве терминов, указывающем на документы, содержащие каждый термин.
Пример индексирования
Допустим, мы хотим проиндексировать ряд документов, содержащих информацию о товарах в Интернет-магазине. Каждый документ содержит такую информацию, как название, описание, цена и категория товара.
Первым шагом будет создание индекса в Elasticsearch (для хранения документов, связанных с товарами). Для повышения эффективности и масштабируемости индекс разделен на несколько шардов.
Затем с помощью REST API мы отправляем каждый документ в Elasticsearch. Elasticsearch анализирует документ с целью извлечения токенов и сохраняет их в своей поисковой структуре.
Затем мы отправляем документ, содержащий информацию о голубых джинсах и проиндексированный следующими лексемами: «джинсы», „синий“, „мужчина“, „casual“, „одежда“ и т. д. Это поможет нам осуществлять поиск, используя следующие словосочетания: «мужские джинсы», „синяя одежда“ и т. д..

Как работать с индексами в Elasticsearch?
Инексы испольуются для хранения и поиска данных в Elasticsearch. У каждого индекса есть определенные настройки, например, парсинг текста, настройки хранения и настройки поиска. Для обеспечения более точного поиска к каждому индексу применяются более специализированные настройки.
Пример создания индекса в Elasticsearch:
- Зайдите в Elasticsearch и создайте индекс под названием “my_index”:
PUT /mi_indice
- Добавьте в индекс “my_index” документ с уникальным ID :
PUT /mi_indice/_doc/1
{
  "name": "Juan Perez",
  "age": 30,
  "address": "Calle 123, Ciudad de México"
}
- Найдите этот только что добавлены документ с помощью Elasticsearch API:
GET /mi_indice/_search
{
  "query": {
    "match": {
      "name": "Juan"
    }
  }
}
В данном случае мы ищем документ, содержащий “John” в поле “name” индекса “my_index”.
Таким образом, индексы в Elasticsearch – это структуры, используемые для хранения и поиска данных. Они могут быть настроены в соответствии с Вашими специфическими требованиями и вмещать миллионы документов .
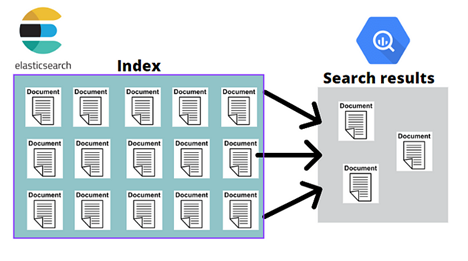
Что такое конечные точки, привязанные к индексам?
Вот некоторые наиболее распространенные конечные точки Elasticsearch, связанные с индексами, но существует и множество других. Каждая из этих конечных точек может быть настроена с помощью дополнительных параметров в соответствии с требованиями Вашего приложения.
Создание индекса
Конечная точка: PUT /<index>.
Тело запроса содержит данные документа, который будет создан или обновлен в указанном индексе. Формат тела запроса должен быть JSON и соответствовать структуре отображения, определенной для индекса.
Пример тела запроса:
{
  "title": "Example Document",
  "description": "This is an example document for Elasticsearch",
  "tags": ["example", "elasticsearch"],
  "date": "2022-03-28T10:00:00Z"
}
Удаление индекса
Конечная точка: DELETE /<index>.
Эта конечная точка не требует тела запроса, вам нужно только указать индекс для удаления. Эта конечная точка удалит индекс и все связанные с ним документы.
Получение информации об индексе
Конечная точка: GET /<index>.
Эта конечная точка не требует тела запроса и отвечает информацией, связанной с указанным индексом.
Получение статистики об индексе
Конечная точка: GET /<index>/_stats.
Конечная точка возвращает JSON-объект, содержащий подробную статистику о предоставленном индексе, включая общее количество документов, размер индекса в байтах, количество шардов и реплик, а также другие важные данные, такие как количество операций индексирования, удаления и поиска, которые были выполнены над индексом.
Пример ответа:
{
  "_shards": {
    "total": 5,
    "successful": 5,
    "failed": 0
  },
  "_all": {
    "primaries": {
      "docs": {
        "count": 10000,
        "deleted": 0
      },
      "store": {
        "size_in_bytes": 2000000
      },
      "indexing": {
        "index_total": 20000,
        "index_time_in_millis": 10000
      }
    },
    "total": {
      "docs": {
        "count": 20000,
        "deleted": 0
      },
      "store": {
        "size_in_bytes": 4000000
      },
      "indexing": {
        "index_total": 40000,
        "index_time_in_millis": 20000
      }
    }
  }
}
Поиск документов в индексе
Конечная точка: GET /<index>/_search.
Эта конечная точка не требует объекта запроса. Она используется для поиска документов в определенном индексе с помощью поискового запроса, параметры которого указываются в URL.
Возможные параметры запроса для этой конечной точки следующие:
- q: задает поисковый запрос в виде простой строки запроса. Например, q=elasticsearch будет искать документы, содержащие слово «elasticsearch» в любом поле.
- size: задает максимальное количество документов, возвращаемых в ответе.
- from: задает индекс первого документа, возвращаемого в ответе (полезно для пагинации).
- sort: Указывает поле или поля, по которым следует сортировать результаты поиска.
- _source: указывает поля, которые нужно включить или исключить из ответа.
- aggregations: позволяет выполнять агрегацию результатов поиска.
Пример ответа:
{
  "took": 15,
  "timed_out": false,
  "_shards": {
    "total": 5,
    "successful": 5,
    "skipped": 0,
    "failed": 0
  },
  "hits": {
    "total": {
      "value": 2,
      "relation": "eq"
    },
    "max_score": 1.0,
    "hits": [
      {
        "_index": "my_index",
        "_type": "_doc",
        "_id": "1",
        "_score": 1.0,
        "_source": {
          "field1": "elasticsearch",
          "field2": "kibana",
          "field3": "logstash"
        }
      },
      {
        "_index": "my_index",
        "_type": "_doc",
        "_id": "2",
        "_score": 0.5,
        "_source": {
          "field1": "elasticsearch",
          "field2": "logstash",
          "field3": "kibana"
        }
      }
    ]
  }
}
Обновление документа в индексе
Конечная точка: POST /<index>/_update/<identifier>.
Эта конечная точка используется для обновления документов в индексе путем предоставления частичного документа, который содержит поля, подлежащие обновлению.
Параметры:
- index: Имя индекса, содержащего обновляемый документ.
- identifier: Уникальный идентификатор обновляемого документа.
- wait_for_active_shards: (Необязательно) Количество активных шардов, которые должны быть доступны до завершения операции обновления.
- routing: (Необязательно) Значение маршрутизации, которое используется для направления запроса обновления на определенный шард.
Этой конечной точке нужен объект запроса с информацией о документе, которую нужно обновить, например: Изменить свойство названия.
{
  "doc": {
    "name": "New Name"
  }
}
Сколько документов может быть привязано к индексам Elasticsearch?
Количество документов, которые могут находиться в одном индексе в Elasticsearch, зависит от нескольких факторов, таких как размер документов, доступное оборудование, объем памяти и конфигурация Elasticsearch.
Теоретически Elasticsearch может обрабатывать миллиарды документов в одном индексе. Однако для удобства администрирования и повышения производительности лучше разделить индексы на более управляемые размеры.
Также важно отметить, что чем больше документов в индексе, тем больше ресурсов потребуется Elasticsearch для их индексации и поиска. Если индекс слишком велик для имеющегося оборудования, могут возникнуть проблемы с производительностью.
В общем, лучше разбить индексы на управляемые размеры и настроить конфигурацию Elasticsearch для оптимизации производительности и масштабируемости в соответствии с требованиями Вашего приложения.
Что такое процесс переиндексации и как он проходит?
Когда вы выполняете переиндексацию в Elasticsearch, Вы копируете данные из существующего индекса в новый. Переиндексация выполняется по разным причинам, например для оптимизации производительности, изменения структуры индекса, внесения изменений в конфигурацию и т. д.
При переиндексации документы из старого индекса копируются в новый. В некоторых случаях это может занять много времени и потребовать значительных ресурсов, особенно для больших наборов данных. Однако после завершения процесса переиндексации у Вас будет новый индекс, отражающий все необходимые изменения.
Среди распространенных причин переиндексации в Elasticsearch можно назвать следующие:
- Изменение структуры индекса: Можно переиндексировать индекс для того, чтобы изменить сопоставление полей или добавить новые поля в существующий индекс.
- Оптимизация производительности: Переиндексация позволяет повысить производительность поиска и индексирования за счет удаления ненужных документов или устаревших индексов.
- Обновление версии Elasticsearch: Переиндексация может потребоваться при обновлении Elasticsearch до более поздней версии.
- Объединение индексов - несколько индексов могут быть объединены в один, что в разы упрощает администрирование и повышает производительность запросов.
Выполнив переиндексацию в Elasticsearch, Вы можете обновить и оптимизировать данные в индексе, чтобы повысить производительность и адаптировать его к требованиям конкретного приложения. Однако важно тщательно спланировать и протестировать процесс переиндексации в тестовой среде, прежде чем запускать его в производство.
Процесс переиндексации
Переиндексация в Elasticsearch - это процесс создания нового индекса и копирование данных из существующего индекса в новый индекс с возможными изменениями в его структуре. Это делается, в частности, для реорганизации данных, изменения структуры индекса и оптимизации производительности.
Процесс переиндексации выполняется в несколько этапов:
- Создание нового индекса: Создается новый индекс с требуемой структурой.
- Настройка источника данных: Настраивается источник данных, которым может быть существующий индекс или запрос, возвращающий документы.
- Конфигурация процесса переиндексации: Настраивается процесс переиндексации, который включает в себя источник данных и новый индекс.
- Выполнение процесса переиндексации: Запускается процесс переиндексации. Elasticsearch считывает документы из источника данных и записывает их в новый индекс.
- Проверка процесса переиндексации: Проверяется, что все документы были переиндексированы правильно.
Важно отметить, что процесс переиндексации может быть дорогостоящим с точки зрения ресурсов и времени, особенно для больших массивов данных. Поэтому рекомендуется тщательно спланировать и протестировать процесс в тестовой среде, прежде чем выполнять переиндексацию в производстве.
Существует конечная точка, которая помогает нам выполнить этот процесс, и я собираюсь показать Вам, как она используется:
Конечная точка: POST /_reindex
Тело запроса:
Чтобы переиндексировать индекс, вам нужно предоставить тело запроса, в котором указываются исходный и конечный индексы, а также любые другие параметры, которые Вы хотите использовать. Тело запроса может быть довольно сложным, но вот простой пример, который переиндексирует все документы из индекса под названием «my_index» в новый индекс «my_index_v2»:
{
  "source": {
    "index": "my_index"
  },
  "dest": {
    "index": "my_index_v2"
  }

}
Дополнительные параметры
- wait_for_completion: Если установлено значение false,значение запроса вернется немедленно, процесс переиндексации продолжится в фоновом режиме. В противном случае запрос будет блокироваться до завершения переиндексации.
- refresh: Если установлено значение true, индекс назначения будет обновляться после индексации каждой партии документов. Это может быть полезно, если Вы хотите выполнять поиск по новому индексу, пока он переиндексируется.
- requests_per_second: Максимальное количество запросов в секунду, отправляемых в Elasticsearch во время переиндексации. Это можно использовать для ограничения влияния процесса переиндексации на кластер Elasticsearch.
Пример ответа:
{
  "task": {
    "node": "ABC123",
    "id": 12345,
    "type": "transport",
    "action": "indices:data/write/reindex",
    "start_time_in_millis": 1621234567890,
    "running_time_in_nanos": 1234567890,
    "cancellable": true
  }
}
Изменяются ли результаты поиска с конечной точкой _search после переиндексации?
Если ответить коротко, то да.
При выполнении переиндексации в Elasticsearch возможно изменение результатов поиска при использовании конечной точки _search.
Это связано с тем, что процесс переиндексации включает в себя создание нового индекса и копирование документов из исходного индекса в новый с возможными изменениями в процессе. Поэтому, если в структуру данных были внесены изменения, например, удалены или добавлены новые поля, или были внесены изменения в существующие данные, результаты поиска могут измениться после переиндексации.
Также важно отметить, что процесс переиндексации может занять время, зависящее от размера индекса и конфигурации Elasticsearch. В процессе переиндексации некоторые документы могут быть недоступны для поиска до завершения всех этапов процесса.
Поэтому после переиндексации рекомендуется провести всестороннее тестирование для того, чтобы убедиться, что результаты поиска последовательны и полностью соответствуют ожиданиям приложения.
Проблемы, связанные с переиндексацией
После переиндексации в Elasticsearch в новом индексе могут возникнуть ошибки поиска. Вот некоторые рекомендации по устранению подобных проблем:
- Убедитесь, что документы были проиндексированы правильно: Некоторые документы могли быть неправильно проиндексированы. Убедитесь, что документы проиндексированы правильно и доступны для поиска.
- Убедитесь, что поля проиндексированы правильно: Если в процессе переиндексации Вы добавили новые поля, убедитесь в том, что они были проиндексированы правильно и доступны для поиска.
- Проверьте синтаксис поискового запроса: Если в процессе переиндексации была изменена структура данных, возможно, потребуется скорректировать синтаксис поисковых запросов для того, чтобы они соответствовали новой структуре данных.
- Проверьте настройки анализа: Если в процессе переиндексации Вы добавили новые текстовые поля, Вам может потребоваться изменить настройки анализа, чтобы они соответствовали новым текстовым полям. Настройки анализа влияют на то, как Elasticsearch индексирует и ищет текст в индексе.
- Выполняйте поисковые запросы на нескольких узлах: Если Вы используете кластер Elasticsearch, в процессе переиндексации могут возникнуть несоответствия данных между узлами. Запустите поисковые запросы на нескольких узлах, чтобы убедиться в согласованности результатов по всему кластеру.
- Проверьте журналы Elasticsearch: Если после выполнения описанных выше действий у Вас все еще возникают проблемы с поиском, проверьте журналы Elasticsearch для того, чтобы получить подробную информацию о любых проблемах с индексом или поиском. Журналы Elasticsearch могут предоставить ценную информацию для устранения проблем с поиском после переиндексации.
Что такое псевдонимы?
Псевдоним - это способ ссылки на один или несколько индексов с помощью одного имени. Он полезен в ситуациях, когда Вам нужно получить доступ к нескольким индексам одновременно, поскольку позволяет ссылаться на них более простым и упорядоченным способом. Псевдонимы также можно использовать для переименования существующего индекса, переиндексации индекса и изменения количества шардов и/или реплик, не затрагивая приложения, использующие этот индекс.
Использование индексов и псевдонимов в Elasticsearch необходимо для эффективной организации данных и доступа к ним. Индексы являются основной единицей хранения данных, а псевдонимы позволяют ссылаться на один или несколько индексов с одним именем и выполнять над ними совместные действия.
Какие конечные точки связаны с псевдонимами?
Создать псевдоним для индекса: PUT /<index>/_aliases/<alias>
Получить информацию о псевдониме: GET /_aliases/<alias>
Пролистать список псевдонимов: GET /_alias
Создать или заменить сразу несколько псевдонимов: POST /_aliases
Удалить псевдоним: DELETE /<index>/_alias/<alias>
Заключение
Как я уже неоднократно упоминал, эта статья не является подробным руководством по работе с Elasticsearch, но она обязательно разрешит некоторые Ваши сомнения, которые могут возникнуть в процессе изучения этой новой интересной технологии.


