

Использование функционала MS SQL в качестве источника данных для увеличения скорости работы
Apache Superset
При работе с большими данными необходимо особое внимание уделять оптимизации запросов. В этом отношении комбинация решений MS SQL и Apache Superset является очень гибким с точки зрения распределения нагрузок вычислений.
В этой статье мы:
- Рассмотрим несколько примеров для построения виртуальных запросов: прямой запрос, использование функций и хранимых процедур;
- Приведем сравнение скорости работы для трех вариантов запросов.

В качестве примера будем использовать таблицу фактов размером 37 896 435 строк.
Задача: необходимо построить ТОП 10 по сумме продаж для категорий товаров, по выбранному году и месяцу в фильтре.
1. Прямой запрос к БД из SuperSet
Запрос для такого чарта будет иметь структуру, с использованием шаблонов jinja
Создадим дашборд для указанного функционала:
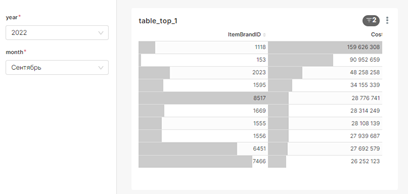
Запрос для чарта:
select top 10 [ItemBrandID]
,sum(CostNet) as Cost
from [dbo].[t_fact_Sales_by_month]
where [YearID] in ({{ filter_values('year', )[0] }})
and [MonthName] IN ('{{ filter_values('month', )[0] }}')
group by [ItemBrandID]
order by sum(CostNet) desc
2 Запрос функции
Обернем запрос из п.1 в функцию, параметры фильтров будем использовать как входные:
create function [dbo].[f_top_10]
(
@YearID int,
@MonthName nvarchar(4000) = ''
)
return table
as
return (
select top 10 [ItemBrandID] ,
sum(CostNet) as Cost
from [dbo].[t_fact_Sales_by_month]
where [YearID] in (@YearID)
and [MonthName] IN (@MonthName)
group by [ItemBrandID]
order by sum(CostNet) desc
)
Запрос для датасета:
select [ItemBrandID]
,[Cost]
from [dbo].[f_top_10]
(
{{ filter_values('year', )[0] }}
,'{{ filter_values('month', )[0] }}'
)
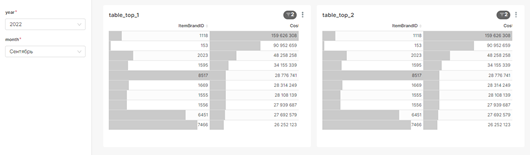
Получаем вторую таблицу с аналогичными данными
3. Запрос процедуры
Для виртуального запроса в SuperSet обязательно знать какой набор колонок будет на его выходе, поэтому использовать хранимую процедуру напрямую не представляется возможным. В данном случае нужно прибегнуть к конструкции openquery.
Обернем наш запрос в хранимую процедуру:
create procedure [dbo].[p_top_10]
@YearID INT,
@MonthName nvarchar(4000) = ''
as
begin
select top 10 [ItemBrandID] ,
sum(CostNet) as Cost
from [dbo].[t_fact_Sales_by_month]
where [YearID] in (@YearID)
and [MonthName] IN (@MonthName)
group by [ItemBrandID]
order by sum(CostNet) desc
end
Запрос для датасета:
select
[ItemBrandID]
,[Cost]
from openquery([<LinkServerName>],
'exec [<DataBaseName>].[dbo].[p_top_10]
@YearID = {{ filter_values('year', )[0] }}
,@MonthName = ''{{ filter_values('month', )[0] }}''
with result sets
((
[ItemBrandID] nvarchar(128)
,[Cost] money
))
'
)
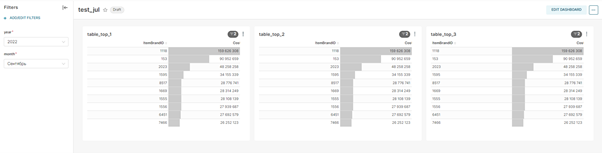
Получаем третью таблицу с аналогичными данными:
4. Сравним скорость работы для трех вариантов запросов.
Чтобы сравнить скорость работы, будем использовать одинаковые входные данные для запроса, а измерение проводить в SQLlab:
Входные параметры будут: год – 2022 и месяц – Август
Объем данных для тестирования – 37 896 435 строк
|
Простой запрос |
Функция |
Процедура |
|
|---|---|---|---|
|
Время работы, сек |
1,2 |
0,7 |
0,67 |
Видно, что скорость выполнения обычного запроса в 1,5 раза меньше скорости с использованием функции или хранимой процедуры.
По времени выполнения выигрывает хранимая процедура, ее преимущество по сравнению с функцией в данном случае невелико, но при наращивании сложности вычислений разрыв существенно увеличится.
Источник: Блог bilab


