

Качество данных: политики, профили, мониторинг и автоматизация
Качество данных — один из краеугольных камней любой системы управления данными. Без представления о том, что «правда» означает в рамках бизнес-процессов, какие данные соответствуют требованиям, какая доля данных годна к принятию решений, — любые попытки построить DWH, Lakehouse или Data Platform превращаются в риск-подвеску: сложно прогнозируемые результаты, сомнения у бизнес-пользователя и дополнительные расходы на исправление последствий. Эта глава посвящена тому, как формализовать и поддерживать качество данных через политики, профили данных, мониторинг и автоматизацию в контексте Data Governance, накладывающегося на архитектуру хранения и обработки.
Мы рассмотрим как теоретические основы, так и практические примеры, включая open-source решения (Great Expectations, Deequ, Apache Griffin и пр.), а также примеры российских реалий внедрения, где локализация процессов, требования по локализации данных и регуляторные условия влияют на выбор инструментов и подходов. В конце главы — FAQ с развернутыми ответами на наиболее частые вопросы.
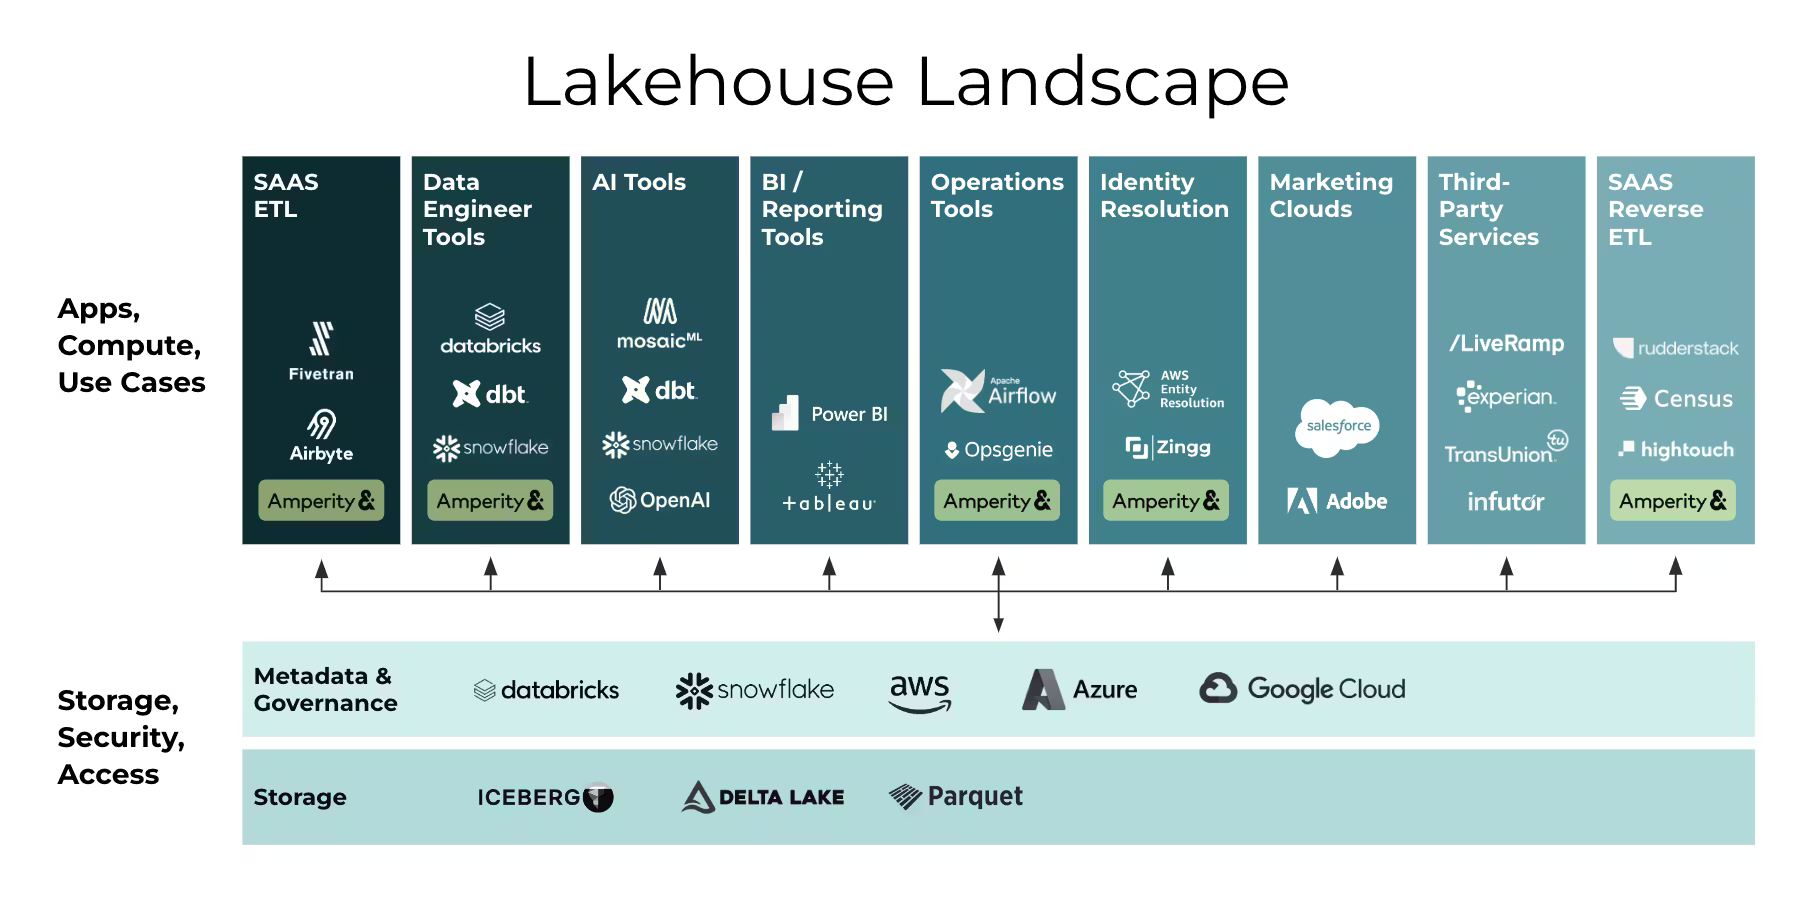
Определения и ключевые термины
- Качество данных (Data Quality, DQ): совокупность характеристик данных, которые позволяют им точно, полно, своевременно и последовательно отражать бизнес-реальность и поддерживать предположения аналитических и операционных процессов.
- Политика качества данных (Data Quality Policy): формализованный набор правил, норм и обязательств, который устанавливает требования к качеству данных, ответственности, процессы проверки и санкции за несоответствия.
- Профиль данных (Data Profile): набор характеристик набора данных или столбца, описывающий его структуру, распределение значений, полноту, уникальность, частоту появления значений и другие статистические свойства.
- Контракты данных (Data Contracts): соглашения между командами поставщиков и потребителей данных о минимальном уровне качества, доступности, частоте обновления и форматах передачи данных.
- Метрики качества данных (Data Quality Metrics/KPIs): количественные показатели качества, например полнота (completeness), точность (accuracy), непротиворечивость (consistency), актуальность (timeliness), уникальность (uniqueness), валидность (validity) и т.д.
- Мониторинг качества данных: систематический сбор, агрегация и визуализация метрик качества, сигнализация на отклонения и дрейф.
- Data Steward, Data Owner, Data Custodian: роли, отвечающие за качество данных: владелец бизнес-области, ответственное лицо за данные, технические администраторы и средства контроля.
- Дрейф данных (Data Drift): изменение распределения данных или структуры по сравнению с историческими базами, что может снизить качество и качество моделей.
Политики качества данных: зачем и как строить
Политики являются фундаментом для управляемости данных. Они устанавливают:
- что считается «годным» набором данных для конкретной бизнес-области;
- какие действия предпринимаются при несоответствиях;
- какие процедуры аудита и отчетности необходимы;
- каковы роли и ответственность участников.
Методы внедрения политик:
- документирование требований к качеству на уровне бизнес-терминов (например, «корректные клиенты», «заполненный email» и пр.);
- привязка политик к данным через контракты и схемы данных;
- автоматическое тестирование качества как часть CI/CD процессов обработки данных;
- регулярный аудит и обновление политик по мере изменений бизнес-требований.
Профили данных: диагностируем здоровье набора
Data Profile — это «здоровье» набора данных в цифрах. Профили помогают:
- быстро определить аномалии в данных;
- понять, какие капиталы данных нуждаются в обработке;
- формировать контракты данных и SLA по качеству.
Типы профилей:
- профиль таблицы: статистика по каждому столбцу (тип данных, пропуски, уникальные значения, min/max, частоты значений);
- профиль домена: распределение значений в домене (например, коды клиентов, регион), обнаружение некорректных значений;
- профиль потока: характеристики данных за период обновления (периодичность, задержки, пропуски);
- профиль качества: набор показателей по готовности к анализу и загрузке.

Метрики качества данных (DQ Metrics)
Ключевые метрики:
- полнота (completeness): доля заполненных значений в столбцах;
- точность (accuracy): соответствие значения истинному источнику;
- непротиворечивость (consistency): отсутствие противоречий между связанными наборами;
- своевременность (timeliness): задержка обновления или стимость даты;
- уникальность (uniqueness): доля уникальных значений ключевых столбцов;
- валидность (validity): соблюдение форматов и ограничений;
- валидность бизнес-ограничений (business rule validity): соответствие бизнес-правилам;
- доступность (availability): доступность данных в нужное время.
Метрики могут быть как целостными, так и «на уровне контракта» между поставщиком и потребителем данных. Важна связь между метриками и бизнес-целями.
Мониторинг качества данных
Мониторинг — это непрерывный процесс наблюдения за метриками качества и сигнальная система, которая оповещает об отклонениях. Основные элементы:
- сбор данных о качестве из всех точек обработки (ETL/ELT, BI-пайплайны, lakehouse);
- дашборды и отчеты для бизнес- и технических стейкхолдеров;
- алерты (пороги, пороговые значения, сигналы тревоги);
- управление инцидентами и «кейсами» по качеству;
- регуляторная и аудиторская документация.
Автоматизация и оркестрация
Автоматизация тестирования качества данных должна быть встроена в жизненный цикл данных: от разработки до продакшена. Элементы:
- тесты качества как код: определение набора тестов на уровне таблиц/профилей через инструменты тестирования;
- CI/CD для пайплайнов обработки данных: автоматический прогон тестов при каждом развёртывании;
- оркестрация процессов: запуск тестов в рамках Airflow, Prefect, Dagster;
- автоматическое исправление: корректировка данных или перенастройка пайплайнов в случае дрейфа;
- контрактное тестирование: проверка соблюдения Data Contracts между поставщиками и потребителями.
Практические примеры
Пример 1. Политика качества в DWH-проекте
Цель: обеспечить единые правила на уровне бизнес-областей, чтобы данные в корпоративном DWH соответствовали ожиданиям аналитиков и регуляторных требований.
Действия:
- создание Data Quality Policy для ключевых доменов (клиенты, заказы, продажи);
- определение SLA по качеству для каждого домена;
- внедрение контрактивного тестирования на этапе загрузки данных;
- формирование журнала инцидентов качества и отчетности.
Реализация:
- дорожная карта документов: политики -> контракты -> тесты качества;
- интеграция с Open-Source стеком: Great Expectations (проверки в пайплайнах) + Airflow (оркестрация) + dbt (пост-проверочные тесты);
- мониторинг — Grafana/OpenSearch dashboards.
Пример теста (Python) для проверки заполненности критичных столбцов в Great Expectations:
# файл expectations/customer_expectations.yaml
expectation_suite_name: customer_suite
expectations:
  - expectation_type: expect_column_values_to_not_be_null
    kwargs:
      column: customer_id
  - expectation_type: expect_column_values_to_be_unique
    kwargs:
      column: customer_id
  - expectation_type: expect_column_values_to_be_in_type
    kwargs:
      column: signup_date
      expected_type: "datetime"
Интеграция:
- Airflow DAG запускает пайплайн, после загрузки данных в таблицу customers выполняет grok-тесты Great Expectations и публикует итог в дашборд.
Пример 2. Профили данных в Lakehouse
Задача: поддерживать качество на уровне кросс-объектов, когда данные хранятся в Lakehouse (например, Databricks Delta, Apache Iceberg).
Действия:
- регулярное профилирование: вычисление статистик по каждому столбцу, поиск пропусков и выбросов;
- автоматическое создание/обновление Data Profiles в каталоге данных (Data Catalog);
- использование профилей для автоматического формирования Data Contracts и сигналов качества для новых наборов данных.
Пример: профилирование и создание метаданных через pandas-profiling и интеграцию в Data Catalog.
- Инструменты: pandas-profiling (ydata-profiling), Apache Atlas/Amundsen для каталога, интеграция через REST API.
Пример 3. Мониторинг качества, алерты и автоматизация
Задача: обеспечить видимость качества в реальном времени и автоматическую реакцию на дрейф.
Архитектура:
- источники данных в DWH/Lakehouse;
- модуль тестирования качества (Great Expectations / Deequ);
- база результатов и журнал изменений;
- дашборд и алерты;
- автоматическое реагирование: переразгрузка, перерасчёт, уведомления.
Пример реализации на стеке open-source:
- Great Expectations для тестирования;
- Apache Airflow для оркестрации;
- dbt для трансформаций и тестов;
- OpenSearch/Elasticsearch + Grafana для хранилища и визуализации тестовых результатов.
Пример кода: YAML конфигурации для тестов и пример DAG в Airflow.
DAG (Python, упрощённо):
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime
import great_expectations as ge

def run_quality_checks(**kwargs):
    context = ge.data_context.DataContext("/path/to/expectations")
    # запустим suite для набора данных customers
    suite = context.get_expectation_suite("customer_suite")
    results = context.run_validate_operator(dataset="path/to/customers.csv", expectation_suite=suite)
    # обработка результатов: отправка алертов/логирования
    if results['success'] is False:
        raise ValueError("Quality checks failed for customers")

with DAG(dag_id="dq_quality_checks", start_date=datetime(2024,1,1), schedule_interval="@daily") as dag:
    t1 = PythonOperator(
        task_id="run_quality_checks",
        python_callable=run_quality_checks,
        provide_context=True
    )
Пример 4. Российские реалии: локализация и регуляторные требования
В РФ внедрение управления качеством данных часто сопровождается требованиями по локализации данных, аудиторским следом и соответствием регуляторным актам (прежде всего в банковском, телеком и госкомпаниях). Практические подходы:
- локальное хранение журналов аудита и результатов тестов внутри юридически ответственных инфраструмент;
- использование открытых инструментов с локализацией конфигураций, поддержкой кириллицы и локализации форматов данных;
- формирование Data Contracts, учитывающих требования по срокам обновления и доступности данных;
- интеграция с российскими системами мониторинга и интеграторами, которые обеспечивают поддержку конкретных регуляторных требований.
Расширенный практический кейс:
- сбор данных из локальных источников (SQL Server в локальном дата‑центре, Oracle) в Data Lake;
- профилирование и тестирование на уровне столбцов и таблиц;
- хранение логов и результатов тестов в отечественных хранилищах и репозиториях;
- создание SLA по качеству и регуляторные отчеты.
Техническая часть примеров выше позволяет адаптироваться к локальным требованиям и бизнес‑контрактам без потери возможности использовать современные инструменты анализа данных.
Инструменты и стек: обзор
Open-source решения:
- Great Expectations: тестирование качества данных, профилирование, валидация; хорошо интегрируется с Airflow/dbt и Lakehouse.
- Deequ (Scala/Java): инфраструктурный инструмент для тестирования качества на уровне дата‑потоков и ETL/ELT.
- Apache Griffin: платформа качества данных, ориентированная на данные в больших объемах.
- ydata-profiling (бывш. pandas-profiling): генерация профилей для наборов данных в Python.
- Apache Atlas/Amundsen: каталогизация метаданных, включая профили и качество.
- dbt: управляемые тесты качества на уровне моделей.
- Apache Airflow / Dagster / Prefect: оркестрация тестов качества и пайплайнов.
Российские решения и локализация:
- использование отечественных серверов, локального хранения логов и аудита;
- интеграция с локальными системами мониторинга и бизнес-процессами через адаптированные коннекторы;
- локализация интерфейсов, форматов и формулировок бизнес‑правил на русском языке;
- поддержка регуляторных требований и локальных стандартов в рамках крупных корпоративных проектов.
Практические примеры кода и конфигураций
Пример 1: Great Expectations — базовый набор ожиданий
Конфигурация Suite в YAML (пример для таблицы customers):
# expectations/customer_suite.json
expectation_suite_name: customer_suite
expectations:
  - expectation_type: expect_column_values_to_not_be_null
    kwargs:
      column: customer_id
  - expectation_type: expect_column_values_to_be_unique
    kwargs:
      column: customer_id
  - expectation_type: expect_column_values_to_be_in_type
    kwargs:
      column: signup_date
      type_: "datetime64[ns]"
  - expectation_type: expect_column_values_to_be_in_set
    kwargs:
      column: region
      value_set: ["Москва", "Санкт-Петербург", "Новосибирск", "Екатеринбург"]
Python-код для запуска тестов:
from great_expectations.dataset import PandasDataset
import great_expectations as ge
import pandas as pd

# загрузка данных
df = pd.read_csv("path/to/customers.csv")
data = ge.from_pandas(df)
# выбор набора тестов
suite = "customer_suite"

# выполненение тестов
results = data.validate(expectation_suite=suite)
print(results)
Пример 2: Deequ — базовый тест на Java/Scala
import com.amazon.deequ.SparkAmplitude
import org.apache.spark.sql.SparkSession
import com.amazon.deequ.checks.Check
import com.amazon.deequ.verification.VerificationResult

object CustomerQualityCheck {
  def main(args:Array[String]): Unit = {
    val spark = SparkSession.builder()
      .appName("CustomerQualityCheck")
      .getOrCreate()

    val df = spark.read.option("header", "true").csv("s3://data-lake/customers.csv")

    val check = Check(checkLevel = Check.CheckLevel.ERROR, "Customer data quality")
      .isComplete("customer_id")
      .isUnique("customer_id")
      .isNonNegative("age")
      .hasSize(lambda = 0.0) // пример пустого правила

    val result: VerificationResult = com.amazon.deequ.Verifications.verify(df, check)
    println(result)
  }
}
Пример 3: DAG‑пример для Airflow (интеграция с Great Expectations)
from airflow import DAG
from airflow.operators.bash import BashOperator
from datetime import datetime

with DAG(dag_id="dq_pipeline", start_date=datetime(2024,1,1), schedule_interval="@daily") as dag:
    run_ge = BashOperator(
        task_id="run_ge_tests",
        bash_command="python3 /path/to/run_ge.py"
    )
    notify = BashOperator(
        task_id="notify_results",
        bash_command="python3 /path/to/notify.py --level critical"
    )
    run_ge >> notify
Пример 4: Проверка в SQL (легковесный уровень валидности)
Чтобы быстро проверить базовые правила, можно использовать SQL Check constraints или триггеры (на уровне базы).
- Пример SQL на PostgreSQL:
ALTER TABLE customers
ADD CONSTRAINT ck_customer_id_not_null CHECK (customer_id IS NOT NULL);

ALTER TABLE customers
ADD CONSTRAINT uq_customer_id UNIQUE (customer_id);

ALTER TABLE orders
ADD CONSTRAINT fk_customer_id FOREIGN KEY (customer_id) REFERENCES customers(customer_id);
Пример 5: Мониторинг и визуализация
- Использование OpenSearch + Grafana для отображения метрик качества;
- Логи из тестов сохраняются в OpenSearch и визуализируются в Grafana;
- Настройка алертов по порогам (например, если доля пропусков > 5%).
Риски и ограничения внедрения
- Недостаточное вовлечение бизнеса: политики качества должны отражать реальные бизнес‑потребности; без вовлечения стейкхолдеров легко получить бюрократические чек-листы без ценности.
- Неполнота охвата: автоматизированные тесты не охватывают все сценарии; некоторые бизнес‑правила требуют ручной интерпретации.
- Дрейф данных и сложность поддержки: дрейф может привести к частым ложным срабатываниям; поддержка профилей и контрактов требует регулярного обновления.
- Стоимость и сложность внедрения: внедрение политики качества и контрактов требует времени на настройку, обучение сотрудников и интеграцию в существующую инфраструктуру.
- Производительность: тестирование качества может замедлять пайплайны; баланс между частотой проверки и временем выполнения необходим.
- Регуляторные и локальные требования: особенно в России и на сегментах госорганизаций — требования локализации, аудита и хранения данных; важно обеспечить соответствие регламентам.
- Ограничения инструментов: open-source решения дают гибкость, но требуют квалификации и поддержки; коммерческие решения могут предоставить более сильную поддержку, но требуют бюджета.
- Условия данных: чувствительная информация, данные PII/PHI требуют дополнительной защиты и контроля доступа; политика качества должна учитывать приватность и безопасность.
Выводы
- Качество данных — это не одноразовая задача, а постоянный процесс, который требует формализации через политики, профили и контракты, а также непрерывного мониторинга и автоматизации.
- Эффективная инфраструктура качества данных строится на связке: политики и контракты, данные профилей и метрики, автоматическое тестирование и мониторинг, интегрированные в процесс разработки и эксплуатации.
- В условиях DWH, Lakehouse и Data Platform DG накладывается на архитектуру хранения и обработки, требуя тесного взаимодействия между бизнес-слоями, данными и операционной командой.
- Практическая реализация опирается на open-source инструменты и, там, где нужно — региональные решения и локализации, адаптированные под регуляторные требования и локальные условия.
- Внедрение требует планирования, обучения, управляемой эволюции архитектуры и постоянной адаптации к дрейфу данных и изменениям бизнес‑правил.
FAQ (Вопрос–Ответ)
1) Что такое политика качества данных и зачем она нужна?
- Политика качества данных — это официальный набор правил и требований, который задаёт ожидаемые уровни качества для различных доменов/данных и определяет ответственность, процессы аудита, реакции на нарушения и механизм документирования. Она задаёт основу для контрактов данных и согласования между поставщиками и потребителями данных.
2) Что такое профиль данных и как он помогает управлять качеством?
- Профиль данных — это диагностический набор характеристик набора данных или столбца: пропуски, распределение значений, уникальность, форматы и т.д. Профили помогают быстро обнаруживать проблемы, строить контракты данных и принимать решения об устранении дефектов, а также служат источником метрик качества.
3) Какие метрики качества наиболее важны для DWH и Lakehouse?
- Основные: полнота, точность, непротиворечивость, своевременность, уникальность, валидность. В зависимости от домена могут дополняться бизнес-правилами и регуляторными требованиями.
4) Какие инструменты подойдут для старта внедрения качества данных?
- Open-source: Great Expectations, Deequ, Apache Griffin, ydata-profiling, dbt тесты, Apache Atlas/Amundsen для каталога.
- Оркестрация: Apache Airflow, Dagster, Prefect.
- Визуализация: Grafana, OpenSearch/Elasticsearch.
- Для российской локализации: сочетание локальных конфигураций и интеграции с отечественной инфраструктурой, сохранение логов и результатов в локальных системах аудита и мониторинга.
5) Как избежать «перегиба» тестированием качества?
- Ставить реалистичные пороги, избегать избыточных тестов;
- Использовать контракты данных и бизнес‑правилами вместо попыток «вынести» каждый технологический нюанс;
- Регулярно обновлять тесты и профили в ответ на дрейф данных и изменения бизнес‑процессов.
6) Как связать качество данных и регуляторные требования в РФ?
- Встроить локализацию данных и аудитов, обеспечить хранение результатов тестов внутри отечественных инфраструктур;
- Формировать Data Contracts, учитывающие требования по доступности, срокам обновления и безопасности;
- Поддерживать журнал аудита и регуляторную отчетность через интегрированные решения.
7) Как измерять эффективность внедрения управления качеством данных?
- Метрики можно привязать к бизнес‑целям: уменьшение количества ошибок в аналитике, повышение точности моделей, снижение времени исправления дефектов, соблюдение SLA по качеству данных.
8) Что делать при дрейфе данных?
- Обнаружить дрейф через профили и метрики, уведомить владельцев домена, скорректировать правила/контракты и, при необходимости, переработать пайплайн;
- Временная мера: настроить пороги и автоматические уведомления; постоянная мера: обновить тесты и бизнес‑правила.
9) Нужно ли использовать оба Open-Source и российские решения?
- Часто да: open-source обеспечивает гибкость, а локализация и требования регуляторов — локальные решения, профессиональная поддержка и интеграции. В сочетании они дают устойчивые и масштабируемые решения.
10) Как начать внедрение управления качеством данных в реальном проекте?
- Начните с политик качества и контрактах данных для критических доменов;
- Введите профили данных и начальные метрики;
- Разверните тесты качества в рамках CI/CD пайплайнов;
- Постройте мониторинг и алерты, создайте дашборды;
- Постепенно расширяйте охват и автоматизацию, включая российские требования и локализацию.


