

Качество данных: стандарты, мониторинг и улучшение
Качество данных — фундамент успешной реализации Data Governance (DG) и встроения DG в operating model организации. Без достоверных, последовательных и своевременных данных даже самые продвинутые бизнес-процессы, правила и органы управления будут работать с ошибками и рисками. Эта глава предназначена для нового сотрудника или студента, кто только вступает в практику DG: как распознавать качество данных, какие стандарты и методологии применяются, какие инструменты помогут автоматизировать проверки, как внедрять контроль качества на уровне процессов и продуктов, и какие риски возникают при попытке поднять качество данных в крупных организациях.
Мы рассмотрим теоретические основы качества данных, связку DG-операционных моделей, доменную модель и RACI, рассмотрим жизненный цикл качества данных, перечислим практические инструменты (open-source и отечественные решения), дадим пошаговые примеры и технические детали, а также обсудим риски и ограничения внедрения. В конце — подробный FAQ, охватывающий наиболее частые вопросы, которые возникают у команд DG и стейкхолдеров.
Что такое качество данных и почему это важно
Качество данных — это степень пригодности данных для достижения конкретных целей бизнеса. Это не только точность и полнота значений, но и согласованность между разными системами, своевременность обновлений, корректность форматов, защитa и соответствие требованиям регуляторов. В контексте DG качество данных становится критерием принятия решений, анализа, операционной эффективности и соблюдения нормативов.
Основные характеристики качества данных (критерии качества, или dimensions):
- Точность (Accuracy) — данные соответствуют реальному состоянию объектов.
- Полнота (Completeness) — данные содержат все необходимые значения.
- Согласованность (Consistency) — данные не противоречат друг другу в разных системах.
- Своевременность (Timeliness) — данные обновляются с требуемой периодичностью.
- Валидность (Validity) — данные соответствуют формальным ограничениям (типы, диапазоны, форматы).
- Цялостность/Целостность связей (Integrity) — сохранение связей между записями и сущностями.
- Уникальность (Uniqueness) — отсутствие дубликатов и повторов там, где они недопустимы.
Эти измерения должны быть конкретизированы под домены данных вашей организации: клиенты, продажи, финансы, операции, риски и т.д. Важно, чтобы набор метрик качества был согласован со стейкхолдерами и отражал бизнес-цели.
Связь качества данных с operating model DG и доменной моделью
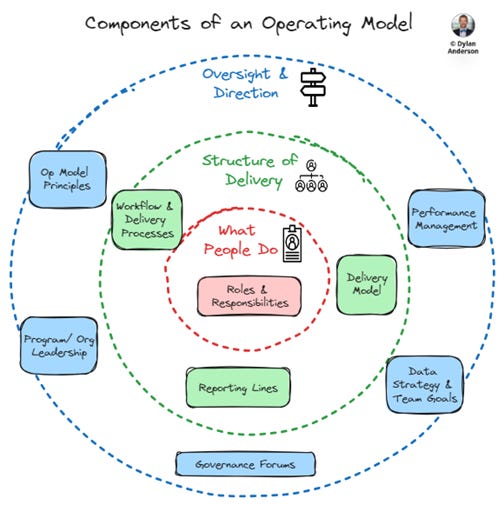
- Operating model DG задаёт, как данные управляются в организации: политики качества, роли и ответственности, процессы профилирования, проверки и исправления, а также способы мониторинга.
- Доменная модель описывает ключевые сущности (например, Клиент, Сделка, Бонды, Продукт) и их атрибуты, связи и бизнес-правила. Качество данных должно соответствовать требованиям доменной модели: например, атрибуты в сущности Клиент должны иметь корректные форматы (тип, длина), а связи между Клиентом и Сделкой — поддерживать целостность.
- RACI и governance-роли (Data Owner, Data Steward, Data Custodian, Data Architect) определяют, кто отвечает, кто информирован, кто консультируется и кто несёт ответственность за качество на каждом этапе жизненного цикла данных.
- Встраивание в бизнес-процессы требует, чтобы проверки качества появлялись на входах к критическим бизнес-процессам: загрузка данных, обработка, экспорт и другое. Это достигается через quality gates (пороги качества), которые должны быть понятны бизнесу и затем автоматизированы.

Стандарты и методологии
- ISO/IEC 8000 серия: управляет качеством данных как продуктом и процессом.
- ISO/IEC 25012 (Data quality model) и ISO/IEC 25024 (Measurement of data quality) — определяют модель качества и как измерять качество данных.
- DCAM (Data Management Capability Assessment Model) — ориентирован на зрелость управления данными и интеграцию процессов качества в организации.
- DAMA-DMBOK (Data Management Body of Knowledge) — охватывает менеджмент данных, включая качество данных и управление данными.
- TDQM (Total Data Quality Management) — системная концепция, объединяющая данные, людей и процессы вокруг качества данных.
- Принципы «Quality by Design» и «Quality Gates»: качество данных закладывается в проект и в пайплайны, а не исправляется после внедрения.
Таблица: краткое сопоставление стандартов
| Стандарт | Область | Что обеспечивает |
|---|---|---|
| ISO 8000 | Управление качеством данных | Определяет требования качества, управления данными как продуктами |
| ISO 25012 | Модель качества данных | Определяет восемь аспектов качества данных (точность, полнота и т. д.) |
| ISO 25024 | Метрика качества данных | Подробно описывает методы измерения качества |
| DCAM | Управление данными | Оценка зрелости и интеграции процессов данных в бизнес |
| DAMA-DMBOK | Борьба за данные | Гибкая рамка по управлению данными, включая качество и lineage |
| TDQM | Управление качеством | Интеграция измерений качества, аудит и улучшение |
Метрики и подходы к измерению
Качественные метрики часто связаны с бизнес-целями: например, скорость обработки, корректность в регуляторных отчетах, удовлетворенность пользователей данными.
Количественные метрики могут включать:
- Доля полноты (Completeness rate)
- Доля точности (Accuracy rate)
- Доля согласованности между системами
- Время задержки (Latency) обновления
- Количество дубликатов в ключевых атрибутах
- Доля валидных значений по заданным ограничениям
Важно иметь шкалу (например, 0-100) и задавать пороговые значения для Gate-Check. Часто применяют подход "DQ score" — суммарная оценка по ключевым доменам.
Жизненный цикл качества данных
- Определение критических доменов и атрибутов (которые имеют бизнес-значение).
- Профилинг данных (data profiling) — сбор статистики об атрибутах, форматы, частоты, доверительные интервалы.
- Определение правил качества и валидаторов (валидаторы форматов, ограничений, зависимостей).
- Выполнение очистки и обогащения (cleaning and enrichment).
- Встроенные Gates и проверки на этапах загрузки, трансформации и выгрузки.
- Мониторинг качества в реальном времени и периодическая переоценка метрик.
- Аудит и регуляторные требования — сохранение следов изменений, версионирование правил.
- Улучшение процессов на основе результатов мониторинга и обратной связи.
Роли и управление качеством
- Data Owner — владелец данных: отвечает за цель, качество и доступность домена.
- Data Steward — стейкхолдер качества: ведёт профиль данных, правила и мониторинг.
- Data Custodian — хранитель данных: обеспечивает техническую реализацию контроля качества.
- Data Architect — архитектор данных: проектирует схему качества, lineage и интеграцию метрик в архитектуру.
- Команды DevOps/DS/BI — поддерживают непрерывность процессов, тестирование и внедрениеGate.
Практические примеры
Пример 1: Контроль качества для домена Клиент (Customer)
Цель: обеспечить корректность базовых атрибутов клиента: customer_id, email, phone, birth_date, status, region.
Шаги:
- Определение критических атрибутов и порогов качества.
- Профилинг: собрать статистику по всем атрибутам за прошлые кварталы.
-
Определение правил качества:
- customer_id: уникальность, не-null
- email: валидный формат
- birth_date: не в будущем, в разумном диапазоне
- region: связка с справочником
- Внедрение в пайплайн: добавление Great Expectations suite и интеграция с Airflow.
- Мониторинг: дашборд в Grafana по DQ-метрикам (полнота, точность, уникальность).
- Рефакторинг и улучшения: если доля ошибок выше порога, блокировать загрузку и уведомить Data Steward.
Пояснение: в реальных условиях бизнес-правила часто зависят от контекста (потребность в конкретных атрибутах для маркетинга, риск-менеджмента и т. д.). Потому в начале проекта лучше выбрать ограниченное число атрибутов и доменов, которые обеспечивают быструю окупаемость.
Пример 2: Архитектура качества в российской реализации (оценка на стековом уровне)
Контекст: крупная финансовая компания строит dg-операционную модель на локальном стеке с частичной миграцией в частный облачный кластер. Архитектура качества данных включает:
- Локальный Data Lake на PostgreSQL/микросервисах + обработка через Spark в кластере.
- Инструменты профилирования и валидации: использование открытых инструментов с адаптацией под RU-персональные данные.
- Мониторинг и визуализация: Grafana + Prometheus; дашборды по основным доменам.
- Контроль: quality gates на ingest и transform этапах.
- Документация: каталог данных (Data Catalog) и lineage.
Как это реализуется на практике:
- Используется open-source пакет Great Expectations для набора ожиданий (expectations) на каждый атрибут в критических таблицах.
- В качестве упрощенного каталога — Light-ограниченная реализация Data Catalog на базе метаданных PostgreSQL + Apache Atlas (open-source).
- Валидация данных на этапе ETL: пайплайны Airflow/ Dagster запускают валидации; при нарушениях — конвейер останавливается, а стейкхолдеры получают уведомления.
- Резервное хранение правил в коде (Git) и версия правок.
- Для российских реалий: адаптация пайплайнов под локальные требования локализации и хранения персональных данных, встраивание проверки защиты данных на уровне доступа (RBAC) и аудита.
Ключевые методические вопросы:
- Что считать «валидным» форматом даты в RU-контексте? Как учитывать временные зоны?
- Как обеспечить корректность связи между доменами (например, Клиент и Сделка) через линейку качества и внешние справочники?
Пример 3: Пример кейса с открытым ПО и отечественным адаптированным стеком
- Open-source инструменты: Great Expectations, Apache Atlas, Deequ (Spark-based), OpenRefine.
- Российские адаптации: набор скриптов и конфигураций для интеграции с локальной инфраструктурой (1С, PostgreSQL, сегментация по RBAC, локализация сообщений об ошибках).
-
Что именно делаем:
- профилируем данные в домене Финансы (дорогие транзакции, ставки, курсы валют);
- пишем набор ожиданий для критичных таблиц;
- разворачиваем мониторинг на Grafana: DQ_Score, процент валидных записей, количество ошибок в сутки, типы ошибок;
- используем внутренние уведомления на корпоративном мессенджере.
Эти примеры подчеркивают, что качество данных — это не «разовая задача», а постоянный процесс, тесно связанный с бизнес-целями и операционной эффективностью.
Практические примеры (практические шаги и детали)
Ниже приведены конкретные подходы и примеры, которые можно применить в типичной организации.
Профилинг данных (Data Profiling)
- Цель: понять текущее состояние данных, выявить проблемы и построить план улучшений.
- Инструменты: Open-source профайлеры, например, pandas профилирование (pandas_profiling), Apache Griffin, Great Expectations profiling.
-
Пример SQL-запроса профиля в базе: подсчитать долю NULLов и статистики по уникальности в столбце.
- SELECT COUNT(*) AS total, AVG(CASE WHEN email IS NULL THEN 1 ELSE 0 END) AS null_email_ratio FROM customers;
- Результаты: выведите таблицу с долей пропусков, уникальностью и распределением значений по типу.
Правила качества и валидаторы
- Правила форматов: e-mail, даты, коды регионов, форматы телефонов.
- Правила логики: связи между ключами, обязательные поля, уникальность.
- Во встроенном пайплайне: определяемся в Great Expectations или Deequ.
-
Пример кода для Great Expectations (YAML конфигурация):
- Определение набора ожиданий (expectations) для таблицы customers.
# great_expectations/expectations/customer_table_expectations.json
{
  "expect_table_to_have_columns": ["customer_id","email","phone","birth_date","region","status"],
  "expect_column_values_to_not_be_null": {
    "column": "customer_id"
  },
  "expect_column_values_to_be_unique": {
    "column": "customer_id"
  },
  "expect_column_values_to_match_like_regex": {
    "column": "email",
    "regex_match": "^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\\.[a-zA-Z0-9-.]+$"
  },
  "expect_column_values_to_be_in_type_list": {
    "column": "birth_date",
    "type_list": ["datetime64[ns]", "string"]
  }
}
# Пример запуска проверки Great Expectations
from great_expectations.dataset import PandasDataset
import pandas as pd

# загрузка данных
df = pd.read_csv("data/customers.csv")

# оборачиваем в GE формат
class CustomerTable(PandasDataset):
    pass

dataset = CustomerTable(df)
result = dataset.validate(expectation_suite="customer_table_expectations.json", result_format="JSON")

print(result)
Мониторинг качества
- Архитектура: источники данных → обработка → валидации → мониторинг → алерты.
- Инструменты: Prometheus + Grafana для метрик качества; можно сделать DQ_Score как вычисляемую метрику и хранить в Prometheus.
-
Пример SQL-метрики:
- доля пропусков в атрибуте: SELECT 100.0 * SUM(CASE WHEN email IS NULL THEN 1 ELSE 0 END) / COUNT(*) AS email_null_pct FROM customers;
- Визуализация: Grafana dashboard с графиками по полноте, точности, уникальности, задержке.
Data lineage и каталог
- Важно хранить родословную данных: какие источники, какие преобразования, какие цели.
- Открытые решения: Apache Atlas для метаданных и lineage.
- Российские адаптации: локальные каталоги и интеграция со справочниками, адаптированными под регуляторные требования.
Интеграция в CI/CD и бизнес-процессы
- Встраивайте проверки качества в пайплайны ETL/ELT.
- Gate на входе к критическим данным — если качество ниже порога, пайплайн останавливается и уведомляется Data Steward.
- Примеры инструментов: Airflow, Dagster, Prefect для оркестрации; Great Expectations для проверки; Git для версионирования правил.
Инструменты и решения (open-source)
- Great Expectations: открытое решение для валидации данных, профилирования и тестирования качества данных.
- Apache Atlas: управление метаданными и lineage, интеграция в архитектуру DG.
- Deequ (Apache/Scala): модуль для проверки качества данных на Spark.
- OpenRefine: очистка и нормализация данных, особенно для подготовки внешних источников.
- dbt: тесты качества данных на уровне моделей данных, интеграция с CI/CD.
- Apache Griffin: платформа для качественных проверок в больших данных.
- Grafana/Prometheus: мониторинг CQ-метрик и дашборды.
Российские решения и подходы
- Яндекс DataSphere и смежные сервисы: локальная платформа для анализа данных, включая режимы профилирования, проверки и каталоги; интеграция с локальными БД и соблюдение локализации.
- Локальные SI-партнёры и корпоративные стек-решения: на базе 1С, PostgreSQL и корпоративных хранилищ, с адаптированными инструментами проверки качества и руководствами по RACI в рамках DG.
- Практика: часто отечественные проекты используют открытое ПО в связке с локальными инфраструктурами, с упором на безопасность, контроль доступа и аудит, соответствие требованиям локального законодательства и регуляторам.
Важно: выбор конкретного российского продукта сильно зависит от отрасли, регуляторной среды и существующей ИТ-инфраструктуры. В рамках DG рекомендуется сочетать открытые инструменты с локальными адаптациями и политиками, чтобы обеспечить соответствие локальным требованиям.
Пример набора кода и настроек для практики
Пример конфигурации SQL-запроса для проверки качества на уровне базы данных (псевдокод):
-
Проверка наличия пропусков в основных полях клиентов:
- SELECT COUNT(*) FROM customers WHERE customer_id IS NULL OR email IS NULL;
-
Проверка дубликатов по ключу customer_id:
- SELECT customer_id, COUNT(*) FROM customers GROUP BY customer_id HAVING COUNT(*) > 1;
Пример SQL-подсчета уникальности и валидности в пределах диапазона дат:
-- Возьмем диапазон дат и проверим возраст клиентов
SELECT
  COUNT(*) AS total_clients,
  SUM(CASE WHEN birth_date IS NULL THEN 1 ELSE 0 END) AS missing_birth_dates,
  SUM(CASE WHEN birth_date > CURRENT_DATE THEN 1 ELSE 0 END) AS future_birth_dates
FROM customers
WHERE region IS NOT NULL;
Пример конфигурации DAGa Airflow для вызова проверки:
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime
import great_expectations as ge

def run_quality_checks():
    # загрузить набор ожиданий
    suite_path = "/path/to/customer_table_expectations.json"
    # подключение к источнику данных
    # выполнить набор ожиданий и сохранить результаты
    # (здесь упрощено для демонстрации)
    print("Running quality checks...")

with DAG('dq_checks', start_date=datetime(2024,1,1), schedule_interval='@daily') as dag:
    t1 = PythonOperator(
        task_id='check_customer_quality',
        python_callable=run_quality_checks
    )
Пример использования Deequ (Scala) для проверки качества в Spark:
import com.amazon.deequ.VerificationResult
import com.amazon.deequ.VerificationSuite
import com.amazon.deequ.checks.Check
import org.apache.spark.sql.SparkSession

val spark = SparkSession.builder().appName("DQCheck").getOrCreate()
val df = spark.read.parquet("hdfs://path/to/customers")

val verificationResult = VerificationSuite()
  .onData(df)
  .addCheck(Check(Check.DefaultCheckName)
    .isComplete("customer_id")
    .isUnique("customer_id")
    .isComplete("email")
    .isPattern("email", "^[A-Za-z0-9+_.-]+@(.+)$") // упрощённая валидация email
  )
  .run()

val success = verificationResult.status == com.amazon.deequ.index.CheckStatus.Success
Пример простого профилирования на Python (pandas) для набора атрибутов:
import pandas as pd

df = pd.read_csv("data/customers.csv")

profile = {
    "total_rows": len(df),
    "columns": {}
}
for col in df.columns:
    series = df[col]
    profile["columns"][col] = {
        "non_null_pct": 100.0 * series.notnull().mean(),
        "distinct_pct": 100.0 * series.nunique() / len(series),
        "dtype": str(series.dtype)
    }

print(profile)
Пример таблицы с метриками качества (для дашборда)
| Метрика | Определение | Формула | Целевая величина |
|---|---|---|---|
| Completeness | Доля не-null значений | non_null_count / total_count | >= 98% |
| Validity | Доля значений в рамках форматов | валидные значения / total | >= 95% |
| Uniqueness | Доля уникальных записей | unique_count / total | >= 99% |
| Freshness | Время последнего обновления | (CURRENT_DATE - max(update_ts)) | <= 1 день |
Риски и ограничения
- Риск «перегрузки» проверки: слишком частые или слишком сложные проверки могут замедлять пайплайны. Решение: применяйте качества gates на ключевых точках и постепенно наращивайте охват.
- Риск ложных срабатываний: неверно подобранные пороги могут приводить к «шуму» и усталости команд. Решение: начать с бизнес-значимых доменов и настраивать пороги совместно с Data Steward.
- Риск масштабирования: при большом объёме данных профилировние и проверки может потребовать большой вычислительной мощности. Решение: выборочные валидации, параллелизация, выбор важных атрибутов.
- Риск соответствия требованиям локализации: хранение персональных данных, соблюдение локальных законов и регламентов. Решение: локальные стеки, контроль доступа, аудит, шифрование и консистентность данных в разных регионах.
- Риск «качество как проект» против «качество как процесс»: недостаточное вовлечение бизнеса и стейкхолдеров может привести к отсутствию поддержки и бюджета. Решение: внедрять governance-процессы, согласовывать метрики с бизнесом, строить KPI.
Ограничения:
- Не все атрибуты можно измерять одинаково: иногда качество зависит от контекста и целей. Необходимо определить «критические пары» и «критические домены».
- Источник данных может менять правила, что приводит к дрейфу качества — нужен процесс обновления метрик и ожиданий.
- Встроенные Gate требуют согласования с бизнес-пользователями и владельцами доменов, чтобы не блокировать полезную деятельность.
Выводы
- Качество данных — это не просто набор статистик, а управляемый процесс, встроенный в operating model DG и доменную модель.
- Стандарты ISO (8000, 25012/25024) и рамки DG (DCAM, DAMA-DMBOK) дают основу для формализации процессов и ролей.
- Эффективная система качества требует сочетания профилирования, валидации, мониторинга и управления целями.
- Открытые инструменты (Great Expectations, Deequ, Atlas и т. д.) в комбинации с отечественными адаптациями позволяют построить надёжную инфраструктуру качества данных в самых разных средах.
- Важность: начать с критичных доменов, быстро получить ROI через качественные «gate»-пороги, затем расширять охват и автоматизировать процесс.
Вопрос–Ответ (FAQ)
1) Что такое «качество данных» и зачем оно DG-оперативке?
- Ответ: Качество данных — это пригодность данных для бизнес-целей. Оно влияет на точность аналитики, качество решений и соблюдение регуляторных требований. В DG это управляемый процесс: от профилирования и валидаций к мониторингу и улучшению. Без контроля за качеством данные не станут надёжной основой для решений и процессов в компании.
2) Какие стандартные рамки лучше всего использовать?
- Ответ: Рекомендуется сочетать ISO 8000 (управление качеством как продуктом) и ISO 25012/25024 (модель и измерение качества). DCAM и DAMA-DMBOK помогают выстроить зрелость процессов и управление данными. В практике часто применяют «Quality by Design» и Gates на входах к данным.
3) Какие инструменты стоит выбрать в начале проекта?
- Ответ: В начале проекта можно опираться на открытые инструменты: Great Expectations для валидаторов и профилирования, Apache Atlas для lineage, Deequ для больших данных на Spark, dbt для тестирования моделей. В зависимости от регуляторной среды и инфраструктуры можно добавлять отечественные адаптации и каталоги данных.
4) Как определить, какие атрибуты и домены включить в DQ-метрики?
- Ответ: Начинайте с критичных доменов и бизнес-процессов: клиенты, транзакции, финансы, риски. Определите атрибуты, которые прямо влияют на решения и соблюдение регуляторных требований. Сформулируйте бизнес-правила и ожидаемые форматы; затем добавляйте атрибуты постепенно на основе ROI и рисков.
5) Как связать QA с бизнес-процессами и RACI?
- Ответ: Включите правила качества в процессы DG и бизнес-цепочки. Назначьте Data Owner, Data Steward и Data Custodian для каждого домена. Определите ответственность за правилa и мониторинг, добавьте в RACI соответствующие роли и обеспечьте уведомления в случае нарушений.
6) Какие риски сопровождают внедрение качества данных?
- Ответ: Риски включают перегрузку пайплайнов, ложные срабатывания порогов, недостаток вовлечённости бизнеса, сложности масштабирования, требования конфиденциальности и локализации. Решения — начать с малого, внедрять Gate-проверки, строить устойчивый мониторинг и вовлекать бизнес.
7) Как измерить эффект внедрения качества данных?
- Ответ: Используйте DQ-score, срезы по доменам, KPI бизнес-процессов (например, доля ошибок в регуляторных отчетах, время реакции на инциденты), показатели latency обновлений и долю пропусков. Сравнивайте показатели до и после внедрения, отслеживайте ROI.
8) Какие примеры практических кейсов можно привести?
- Ответ: Кейс с доменом Клиент: от профилирования и определения правил до автоматического мониторинга и Gate-аварий. Кейс банковской/финансовой компании: интеграция локального стека с открытыми инструментами (Great Expectations, Atlas) и адаптация под регуляторные требования, локальные решения и аудит. Кейсы демонстрируют, как архитектура качества поддерживает DG и бизнес-цели.
9) Какое место занимает мониторинг в системе качества?
- Ответ: Мониторинг — это непрерывный процесс, обеспечивающий устойчивость качества. Он позволяет отслеживать дрейф в данных, выявлять аномалии и реагировать на изменения. Мониторинг должен быть встроен в инфраструктуру (метрики, дашборды, алерты) и адаптироваться к новым доменам и требованиям.
10) Что важнее на первых шагах: профилинг, валидаторы или мониторинг?
- Ответ: Начните с профилирования и валидаторов в критических доменах, чтобы быстро получить видимость и валидацию качества. Затем добавляйте мониторинг и алерты для устойчивого контроля и расширяйте область покрытия качества постепенно.


