

Качество метаданных: контроль качества, валидации, списки проверок
Качество метаданных — это главный фактор доверия к данным и эффективной эксплуатации data-каталога. В контексте OpenMetadata качество охватывает полноту и точность описаний, корректность схем, полноту и устойчивость линков и lineage, своевременность обновления справочников и согласованность между различными источниками информации. Непрерывное обеспечение качества метаданных требует не только анализа текущего состояния, но и автоматических механизмов проверки, интеграции с процессами инжекции данных и оперативной реакции на выявленные проблемы. Именно на этих принципах строится архитектура контроля качества, набор валидаторов и практические списки проверок, которые позволяют команде целенаправленно повышать доверие к данным и ускорять цикл эксплуатации data-каталога.
Эта глава фокусируется на техническом аспекте качества метаданных в OpenMetadata: как моделируется качество на уровне архитектуры, какие валидаторы и правила применяются для разных типов объектов, как строится пайплайн контроля качества и какие сценарии внедрения позволяют получить устойчивые результаты в реальных условиях.
Краткое содержание главы
- Архитектура контроля качества метаданных в OpenMetadata и взаимодействие компонентов.
- Типы проверок: полнота, точность, согласованность, своевременность и качество схем.
- Пайплайны валидации и механизмы реакций на нарушения качества.
- Реализация валидаторов и примеры конфигураций правил.
- Практические сценарии внедрения и готовые списки проверок для ролей data-engineer, data-steward и data-owner.
- Мониторинг, эскалация и непрерывное улучшение процессов качества.
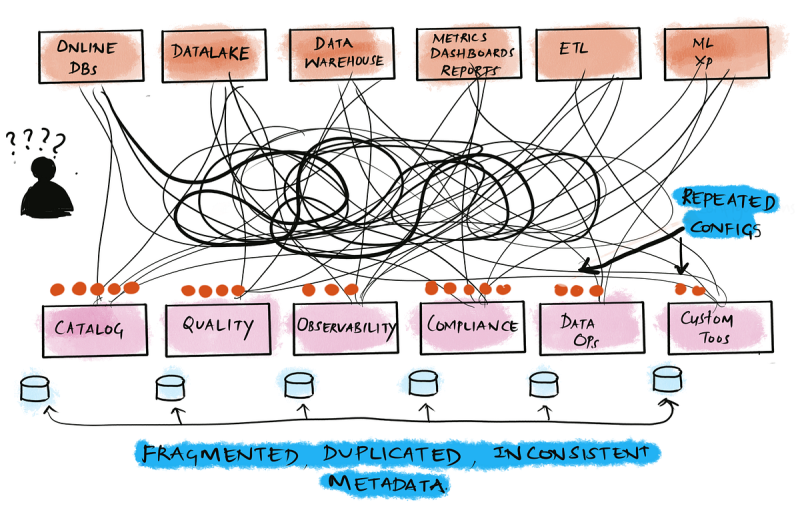
Архитектура контроля качества метаданных в OpenMetadata
Контроль качества в рамках OpenMetadata опирается на разделение ответственностей между слоями: источники метаданных, движок проверки, хранилище и потребители через API и UI. Основные компоненты включают:
- Модуль правил качества (Quality Rules Engine) — хранит и исполняет набор правил, применяемых к сущностям каталога: таблицам, колонкам, источникам, lineage и т. п. Правила задают условие валидации, ожидаемую семантику и пороговую степень критичности.
- Валидатор и оркестратор проверок — координирует выполнение правил по расписанию или по событию инжекции данных. Он обеспечивает повторяемость результатов и атомарность обработки для конкретной сущности.
- Платформа данных (Metadata Store) — репозиторий, где сохраняются исходные данные, их версии и результаты проверок. Версионирование позволяет отследить эволюцию качества и откатиться к предыдущим состояниям.
- Интеграционный слой и коннекторы — интегрируют источники метаданных (базы данных, хранилища данных, инструменты ETL/ELT, реестры схем) с пайплайном качества. Через коннекторы обеспечиваются сбор и нормализация метаданных, а также возможность запуска валидаторов на момент инфлюения и повторной проверки.
- Коммуникационная шина и API — события о нарушениях качества публикуются через шину событий; пользовательские приложения получают доступ к результатам в режиме реального времени. Важна поддержка REST/gRPC API для интеграций в CI/CD и системы мониторинга.
- Модель качества — набор профилей и правил, которые применяются к различным доменам (таблицы, источники, lineage). Модель должна учитывать специфику организации, регламентов и отраслевых требований.
Описание архитектуры предполагает несколько паттернов внедрения: централизованный валидатор, распределённые валидаторы на отдельных кластерах данных и гибридный подход, где критичные проверки исполняются на месте (nearline) для минимизации задержек, а детальные проверки — асинхронно в рамках общего пайплайна. Применение таких паттернов требует согласования между командами эксплуатации данных, управления данными и DevOps, чтобы обеспечить единый цикл владения качеством и совместную эволюцию правил.
{
  "name": "missing_description",
  "entity": "table",
  "field": "description",
  "required": true,
  "severity": "critical",
  "scope": ["source_system_A", "source_system_B"],
  "remediation": {
    "type": "update",
    "owner": "data-steward",
    "deadline_days": 7
  }
}
Правила реализации должны быть хорошо документированы и поддерживать согласование между командами: определение сущности, поля, допустимых значений и форматов. В архитектурном плане важна обратная совместимость: новые правила должны проходить тестирование без влияния на существующие проверки и не приводить к ложным алертам в продуктивной среде.
Типы проверок метаданных
Ключевые направления качества метаданных можно разделить на несколько категорий, каждая из которых требует своей стратегии валидирования и мониторинга. Ниже приведены наиболее критичные для данных каталогов аспекты и примеры подходов.
Полнота и описательность (completeness and descriptiveness)
- Проверки наличия описаний, аннотаций, владельцев, тегов, источников и бизнес-омниксов для объектов.
- Правило: полное описание и владелец в каждом объекте типа таблица/пользовательская сущность.
Точность и согласованность (accuracy and consistency)
- Сверка типов данных, соответствия схем, согласование между схемой источника и метаданными в каталоге.
- Правило: тип данных колонки совпадает с описанием в источнике схемы.
Актуальность и своевременность (freshness and currency)
- Контроль за временем последнего обновления метаданных, соответствие статуса объекта текущей реальности бизнес-процесса.
- Правило: возраст описания не более заданного порога, линейность обновления между источниками.
Линейность и зависимые связи (lineage quality)
- Верификация корректности связей между таблицами, источниками и процессами трансформации.
- Правило: наличие связей и отсутствие циклических зависимостей там, где они недопустимы.
Качество схем и контрактов (schema quality)
- Проверка соответствия схемы данным бизнес-инвариантам, константное использование имен полей, стандартов именования.
- Правило: наличие обязательных полей и единообразие именования в рамках домена.
Качество тегирования и контекст (tagging and context)
- Проверка классификационных тегов, соответствие политики управления данными, наличие бизнес-терминов.
- Правило: тегирование по канонам организации, обновление тегов при изменении бизнес-онтологии.
Таблица ниже иллюстрирует пример набора базовых правил и их характеристик.
| Правило | Объект | Ожидаемое значение | Оценка критичности |
|---|---|---|---|
| missing_description | table | description заполнено | critical |
| type_consistency | column | типы данных совпадают с источником | high |
| lineage_complete | dataset | все узлы lineage присутствуют | medium |
| schema_stability | table | схема не меняется без уведомления | low |
| owner_assignment | dataset | назначен владелец | critical |
Эта таблица показывает, как проектировать набор правил: их следует категоризировать по объектам, определить ожидаемые состояния и привести шкалу приоритетов, чтобы акценты можно было расставлять в зависимости от контекста и регуляторных требований.
Пайплайн контроля качества
Эффективный пайплайн контроля качества должен быть предсказуемым, масштабируемым и устойчивым к сбоям. Типовая архитектура включает следующие этапы:
- Ингестия и нормализация метаданных — сбор и приведение данных к общей схеме. На вход поступают схемы, бизнес-термины и атрибуты объектов, которые затем приводятся к единым стандартам в OpenMetadata.
- Валидация на входе и на обновлениях — выполнение правил качества при каждом инфлюении, а также при повторной синхронизации объектов. Валидация может быть детерминированной и возвращать конкретные issue-объекты.
- Ремедиация и эскалация — автоматические корректировки там, где это возможно (например, заполнение пропусков по шаблонам), или уведомление стейкхолдеров; постановка сроков на устранение и назначение ответственных.
- Публикация результатов и мониторинг — отражение статуса качества в пользовательском интерфейсе и API, линии отчётности и уведомления в системы мониторинга.
- Повторная валидация и регрессионный контроль — проверка после изменений, чтобы подтвердить закрытие нарушений и отсутствие повторных ошибок.
- Обратная связь и улучшение правил — анализ причин нарушений, обновление набора правил и методик.
Согласованность между командой эксплуатации, командой по управлению данными и разработчиками валидаторов обеспечивает устойчивое развитие набора правил и снижает риск сбоев на проде. Важной практикой является внедрение тестовых наборов данных и сценарием регрессионного тестирования качества, чтобы новые правила не ломали существующий функционал.
Реализация валидаторов и примеры
Реализация валидаторов требует ясной декларации правил и эффективной архитектуры их выполнения. Ниже приведён концептуальный подход к реализации валидатора качества без привязки к конкретному стэку инструментов, чтобы сохранить универсальность.
Определение схемы правил
- Правила описываются в формате, который легко сериализуется и версионируется. Каждое правило содержит: идентификатор, целевой объект, условие валидации, пороги критичности и план ремедиации.
Выполнение правил
- Валидаторы запускаются параллельно по независимым сегментам каталога и собирают результаты в единый отчёт. Важна идемпотентность и детальная трассировка: для каждого нарушения фиксируются контекст, ссылка на объект и источник изменения.
Обработка нарушений
- При нарушении правило помечает объект как «needs_review» или «non_compliant», форумируется задача для стейкхолдера и формулируется план ремедиации с ответственным и сроками.
# Пример концептуального псевдокода валидатора
for obj in catalog.get_all_objects():
  if obj.type == "table" and not obj.description:
    report_violation(obj, "missing_description", severity="critical")
  if obj.field_types["amount"] != obj.source_schema_types["amount"]:
    report_violation(obj, "type_mismatch", severity="high")
Варианты хранения и отображения
- Результаты валидаторов сохраняются в Metadata Store, связываются с конкретной сущностью и версией, позволяют отслеживать эволюцию качества и возвращаться к состоянию в любой момент времени.
Примеры конфигураций правил
- Для единообразия рекомендуется хранить конфигурации в централизованном репозитории и продублировать их в окружениях разработки, тестирования и продакшена.
rules:
  - name: missing_description
    entity: table
    field: description
    required: true
    severity: critical
  - name: type_consistency
    entity: column
    compare_with: source_schema
    severity: high
Такой подход позволяет централизовать требования к качеству, обеспечивать прозрачность для стейкхолдеров и облегчает автоматизацию процессов аудита.
Сценарии внедрения и списки проверок
Ниже приводятся практические сценарии внедрения контроля качества метаданных и готовые списки проверок для ключевых ролей. Они рассчитаны на гибкую адаптацию под размеры организации и текущий уровень зрелости процесса управления данными.
Сценарий 1: Стартовый аудит качества
- Провести инвентаризацию всех объектов: таблицы, источники, lineage.
- Зафиксировать текущее состояние полноты описаний и владельцев.
- Определить первичные критичные правила и запустить первую волну валидаторов.
- Назначить ответственных и сроки для устранения выявленных нарушений.
Сценарий 2: Внедрение обязательной описательности
- Включить правила на уровне политики: все новые объекты должны иметь описание, владельца и бизнес-метрики.
- Обеспечить автоматическую проверку на инференцию новых объектов в пайплайне CI/CD.
- Организовать регулярный бэклог задач для исправления пропусков.
Сценарий 3: Контроль согласованности схем
- Реализовать правила проверки соответствия типов и схем между источниками и каталогом.
- Ввести процесс эскалации при несоответствиях и внедрить рекомендации по исправлению.
Сценарий 4: Мониторинг качества и эскалации
- Настроить панели мониторинга и алертинг по критическим нарушениям.
- Определить SLA на реакции на нарушения и процесс их устранения.
- Внедрить регулярные раунды аудита и ретроспективы по качеству.
Сценарий 5: Роли и ответственности
- Data Engineer: поддерживает инфраструктуру валидаторов, обеспечивает доступ к источникам.
- Data Steward: проверяет замечания и принимает remedial actions.
- Data Owner: отвечает за соответствие бизнес-объекта моделям и политике.
- Platform Engineer: поддерживает пайплайн и интеграцию валидаторов в CI/CD.
Сценарий 6: Интеграции и инструменты
- Интеграция валидаторов в существующий процесс обработки данных и инструментальные цепочки: Airflow, CI/CD, мониторинг.
- Рассмотрение примеров интеграции с открытыми решениями: Amundsen, DataHub, OpenMetadata как основная платформа.
Сценарий 7: Внедрение на крайних этапах эксплуатации
- Оценка влияния нарушений на бизнес-процессы и адаптация приоритетов.
- Обеспечение устойчивости к изменению состава данных и источников.
Эти сценарии позволяют структурировать путь внедрения качества метаданных и обеспечить последовательную реализацию without пропусков. В процессе внедрения целесообразно документировать все правила, их обоснование и связь с бизнес-терминами, чтобы обеспечить долговременную ценность для организации.
Key takeaways
- Качество метаданных требует целостной архитектуры, где правила, валидаторы и хранилище обеспечивают прозрачность и воспроизводимость.
- Разделение ролей и четко прописанные правила помогут быстро выявлять и исправлять нарушения качества на разных стадиях жизненного цикла данных.
- Эффективный пайплайн контроля качества должен поддерживать и синхронизировать: ингестрию, валидацию, ремедиацию, публикацию результатов и мониторинг.
- Набор проверок должен быть адаптирован под доменную область и регуляторные требования, с приоритетами на критичные нарушения.
- Внедрение валидаторов в CI/CD и систем мониторинга позволяет автоматизировать процесс контроля и снизить риск промахов, связанных с качеством метаданных.
- Применение примеров правил и конфигураций в репозитории обеспечивает управляемость, версионирование и возможность повторных аудитов качества.
- Выбор конкретных инструментов и подходов должен опираться на контекст организации: открытые решения вроде OpenMetadata и Amundsen могут дополнять друг друга.
FAQ
1) Что такое качество метаданных в контексте OpenMetadata и почему его важно?
Качество метаданных — это степень полноты, точности и согласованности описаний и связей внутри katalogа. В OpenMetadata это означает, что объекты, их свойства, владение, связь с источниками и lineage точно отражают реальность, что критично для корректной идентификации данных, доверия пользователей и соблюдения регуляторных требований. Хорошее качество метаданных облегчает поиск, ускоряет аудит и снижает риск ошибок в аналитике.
2) Какие основные типы проверок включаются в стандартный набор качества?
Чаще всего включаются проверки полноты (наличие описаний, владельцев и источников), согласованности типов и схем, актуальности данных, полноты lineage и целостности связей, а также соответствия бизнес-терминов. В зависимости от контекста добавляются проверки на соответствие нормам именования, секьюрности и тегирования. Важна балансировка между критическими и менее критичными проверками с учётом бизнес-рисков.
3) Как организовать архитектуру валидаторов в OpenMetadata?
Необходимо выделить: (1) модуль правил качества, (2) валидатор/оркестратор, (3) Metadata Store для сохранения результатов и версий, (4) коннекторы для источников и пайплайнов, (5) API и UI для доступа пользователей. Архитектура должна поддерживать как централизованный подход, так и распределённые проверки, обеспечивая идемпотентность и детальное логирование нарушений.
4) Какую роль играет модель качества и профили в OpenMetadata?
Модель качества задаёт набор профилей и правил, применимых к различным доменам. Она позволяет адаптировать требования к конкретной доменной области, обеспечивая единообразие и управляемость. Профили помогают различать критичность и частоту выполнения валидаторов в зависимости от типа объектов.
5) Каковы принципы формирования и поддержки правил качества?
Правила должны быть документированы и версионированы, иметь явную мотивацию и пороги критичности, а также планы ремедиации. Рекомендуется начинать с базового набора критичных правил и постепенно расширять их, тестируя на тестовых данных перед продакшен-выпуском. Важно поддерживать обратную совместимость и прозрачность результатов аудита.
6) Какие подходы к ремедиации и эскалации наиболее эффективны?
Эффективна комбинация автоматических исправлений там, где возможно (например, заполнение пропусков по шаблонам) и отправка задач на ручную доработку для сложных случаев. Эскалация должна быть строгой: четкие сроки, ответственность и уведомления. Важна интеграция с системами задач и уведомлений для оперативной реакции.
7) Как интегрировать контроль качества в CI/CD и ежедневные операции?
Включение валидаторов в пайплайны CI/CD позволяет обнаруживать нарушения на ранних стадиях. Регулярная регрессия и тестирование правил — в виде тест-кейсов и тестовых наборов данных — обеспечивает устойчивость. В ежедневной эксплуатации полезно иметь дашборды и алертинг, чтобы команды могли реагировать на нарушения в реальном времени.
8) Какие примеры инструментов можно использовать совместно с OpenMetadata?
OpenMetadata часто используется вместе с Amundsen и DataHub как альтернативные решения для анализа метаданных и обнаружения. В рамках экосистемы полезны коннекторы к источникам данных, такие как базы данных и хранилища, и инструменты оркестрации (Airflow, Dagster). Важно выбирать инструменты, которые хорошо интегрируются с существующими процессами и политиками управления данными.
9) Как обеспечить прозрачность и управляемость правил качества для бизнес-пользователей?
Необходимо обеспечить простой интерфейс для просмотра статусов проверок, доступ к объяснениям нарушений и шагам ремедиации. Документация должна объяснять, почему правило критично, какие данные оно охватывает и как устранить нарушение. Визуальные дашборды и отчёты помогают бизнес-пользователям понимать влияние управления качеством на аналитику.
10) Какие риски существуют при внедрении контроля качества и как их минимизировать?
Риски включают ложные алерты, перегрузку команд уведомлениями и задержки при обновлениях данных. Чтобы минимизировать их, необходимо постепенное внедрение, качественно сформулированные правила, настройка порогов и приоритетов, а также механизмы тестирования в безопасном окружении перед продакшен-использованием. Регулярные аудиты и обратная связь позволяют адаптировать подход к реальности бизнеса.


