

Как строить эффективные ML-системы: укрощаем хаос данных и выводим ваши проекты на новый уровень (часть 2)
Добро пожаловать в мир машинного обучения, где успех проекта определяется не сложностью алгоритмов, а качеством и продуманностью работы с данными. Наша компания, как ведущий эксперт в области внедрения искусственного интеллекта, представляет вашему вниманию детальный обзор ключевых аспектов создания промышленных ML-решений. В этой статье мы углубимся во вторую критически важную тему: управление данными.
Если в первой части мы обсуждали стратегическое планирование и оценку жизненного цикла ML-проекта, то здесь мы сосредоточимся на том, что является настоящей кровью любой интеллектуальной системы — на данных. Мы подробно разберем современный тренд Data-centric AI, организацию пайплайнов, тонкости работы с обучающими выборками, процесс разметки и перспективы использования синтетических данных.
Data-centric ИИ: почему будущее за качеством данных, а не за сложными алгоритмами
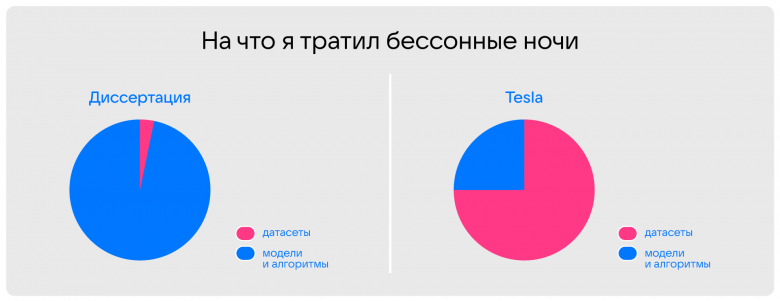
Современное сообщество специалистов по машинному обучению переживает фундаментальный сдвиг парадигмы. Если раньше главным фокусом была разработка и тонкая настройка моделей (Model-centric подход), то сегодня все ведущие эксперты сходятся во мнении: наибольший прирост точности и надежности дают не алгоритмы, а высочайшее качество данных. Этот подход получил название Data-centric ИИ.
Представьте, что вы учите ребенка различать животных. Если вы покажете ему сотни четких, хорошо подписанных фотографий кошек и собак, он быстро научится. Если же вы дадите ему размытые, противоречивые или неправильно подписанные изображения, процесс обучения затянется, а результат будет плачевным. Ровно так же работают и ML-модели.
Один из наших клиентов в сфере финтеха пытался внедрить модель для обнаружения мошеннических операций. Изначальная точность модели составляла 85%, что было недостаточно для запуска в продакшен. Команда потратила два месяца на эксперименты с архитектурами нейросетей и подбор гиперпараметров, добившись улучшения лишь на 3%. Тогда мы провели аудит их данных. Оказалось, что в dataset было значительное количество ошибочных меток: легальные транзакции от определенных категорий были помечены как мошеннические из-за ошибки в ETL-процессе. После того как мы помогли им очистить и переразметить данные, точность модели на тех же алгоритмах взлетела до 96%. Это наглядный пример того, как Data-centric подход спас проект.
Эндрю Ын, основатель DeepLearning.AI, прямо заявляет, что компаниям необходимо делать ставку на разработку системных и надежных методов повышения качества данных, а не на код. А бывший руководитель AI-подразделения Tesla Андрей Карпати также подтверждает, что львиная доля его работы была посвящена именно данным, а не моделям.
Пайплайны данных: превращаем raw data в структурированный поток знаний
Данные в исходном виде — это хаос. Логи серверов, транзакции из банковских систем, пользовательский контент, телеметрия с устройств — все это поступает в разных форматах, объемах и с разным уровнем качества. Задача data-инженера — построить надежный конвейер, который превратит этот хаос в упорядоченный, очищенный и готовый к анализу поток.
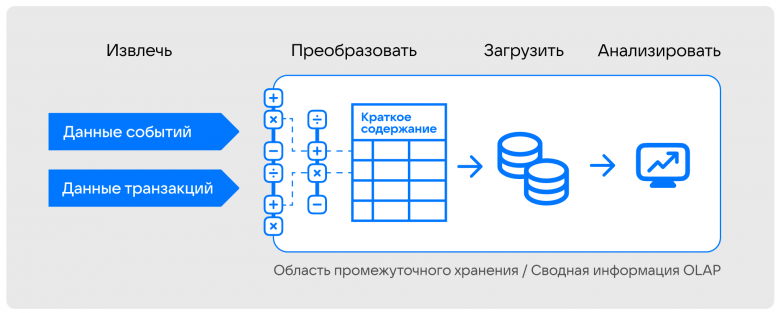
Стандартным и наиболее эффективным подходом является организация ETL-пайплайна (Extract, Transform, Load):
Extract (Извлечение) – на данном этапе мы определяем, какие данные и из каких источников нам нужны. Это могут быть базы данных, API-интерфейсы, файловые хранилища, потоковые платформы типа Kafka.
Далее следует этап под названием Transform (Преобразование). Это ядро процесса. Здесь данные очищаются от дубликатов и ошибок, форматируются, обогащаются, агрегируются и преобразуются в единый стандарт. Например, приведение дат из разных временных зон к единому формату UTC.
И, наконец, Load (Загрузка). Очищенные данные помещаются в целевое хранилище — Data Warehouse (например, ClickHouse, BigQuery) или Data Lake (например, на базе S3 или HDFS), где они становятся доступными для анализа и обучения моделей.
Ключевой совет от наших инженеров заключается в то, что мы настоятельно советуем автоматизировать каждый шаг. Пайплайн должен запускаться по расписанию или событию без ручного вмешательства. Это не только экономит ресурсы, но и минимизирует человеческий фактор, который является частой причиной ошибок.
Однажды мы столкнулись с ситуацией, когда в компании не был автоматизирован процесс обновления справочников в ETL-скрипте. Из-за этого новые товары в каталоге интернет-магазина не поступали в модель рекомендаций. В течение месяца рекомендательная система работала неэффективно, предлагая пользователям устаревшие или отсутствующие товары, что привело к прямому падению конверсии и выручки. Решение заключалось не в изменении алгоритма, а в исправлении пайплайна данных.
Правильно настроенные data-пайплайны приносят пользу бизнесу даже без сложных ML-моделей, обеспечивая чистоту данных для отчетности, базовой аналитики и метрик.
Обучающие данные: фундамент, на котором строится интеллект вашей модели
Качество обучающих данных напрямую диктует, насколько адекватно и эффективно будет работать ваша ML-модель в реальном мире. Модель — это не волшебный черный ящик; она учится исключительно на тех примерах, которые вы ей предоставили, и наивно полагает, что эти данные абсолютно верно отражают реальность.
Давайте рассмотрим ключевые риски и ошибки на этапе формирования обучающих данных:
- Во-первых, это неполнота данных. Модель, обученная различать только кошек и собак, никогда не распознает хомяка или попугая. Если в вашем датасете отсутствуют целые классы или сегменты данных, которые встретятся в продакшене, модель будет давать ошибочные предсказания. Рассмотрим пример: банк запускает скоринг заявок на кредит только на данных по клиентам из столицы. При расширении на регионы модель начинает ошибаться, так как экономическое поведение и профили клиентов могут кардинально отличаться.
- Во-вторых, это ошибочные метки. Систематические ошибки в разметке наносят катастрофический ущерб. Если на всех изображениях породы "чихуахуа" по ошибке стоит метка "кошка", модель надежно выучит этот ложный паттерн и в продакшене будет классифицировать всех чихуахуа как кошек. Выловить такую ошибку на этапе тестирования модели бывает очень сложно.
- В-третьих, это смещения или так называемые Bias. Данные часто отражают существующие в мире предубеждения. Например, если исторические данные по найму показывают, что на высокие позиции чаще назначали мужчин, модель, обученная на этих данных для резюме, будет неосознанно дискриминировать женщин, усугубляя существующее неравенство. Выявление и устранение такого bias — критически важная этическая и техническая задача.
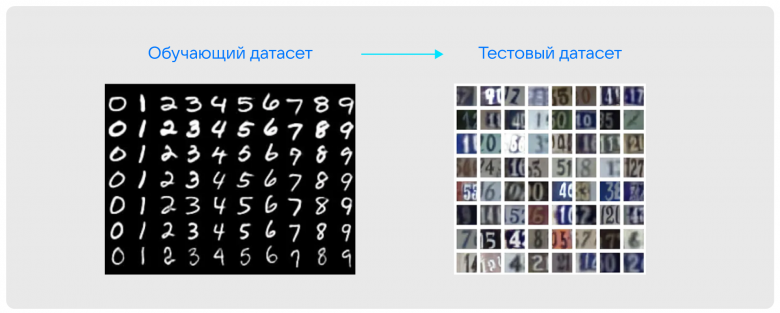
- Еще один важный риск – это несоответствие распределений. Обучающие данные должны максимально точно имитировать данные, с которыми модель столкнется в реальности. Например, модель для беспилотного автомобиля, обученная исключительно на данных, собранных солнечным днем в Калифорнии, будет беспомощна в условиях снегопада в Москве. Или модель для анализа тональности твитов будет плохо работать с длинными формами текстов, например, с отзывами на сайтах.
Наши рекомендации по формированию качественного датасета следующие.
- Всегда начинайте с бизнес-задачи. Четко сформулируйте, что вы хотите предсказать и на основе каких данных. Не подгоняйте данные под модульный алгоритм, а выбирайте алгоритм под вашу задачу;
- Помните, что маленький и чистый датасет лучше большого и грязного. Для 80% проектов основная проблема — это стоимость и время качественной разметки. Гораздо эффективнее иметь 10 тысяч идеально размеченных примеров, чем 100 тысяч с шумом и ошибками. Это особенно важно для оценочного набора (test set).
- Собирайте данные итеративно. Не пытайтесь собрать идеальный датасет с первого раза. Соберите небольшую партию, разметьте, обучите модель, проанализируйте ее ошибки. Это укажет вам, данные какого типа и качества нужно собрать на следующей итерации. Это цикличный и непрерывный процесс.
Разметка данных: дорогостоящий и критичный проект внутри проекта
Большинство промышленных моделей сегодня — это модели с учителем, требующие размеченных данных. Даже для моделей без учителя размеченные данные нужны для оценки качества модели.
Существуют два типа меток:
- Органические (Organic) - это метки, которые появляются сами со временем. Например, вы предсказываете, купит ли пользователь товар. Через некоторое время вы узнаете, купил он его или нет. Такие метки дешевы и достоверны, но их получение требует времени.
- Ручные (Manual) - это метки, созданные человеком-аннотатором. Они требуются для задач классификации изображений, семантической сегментации, распознавания речи, разметки текстовых сущностей. Это дорого, медленно, но часто наиболее качественно.
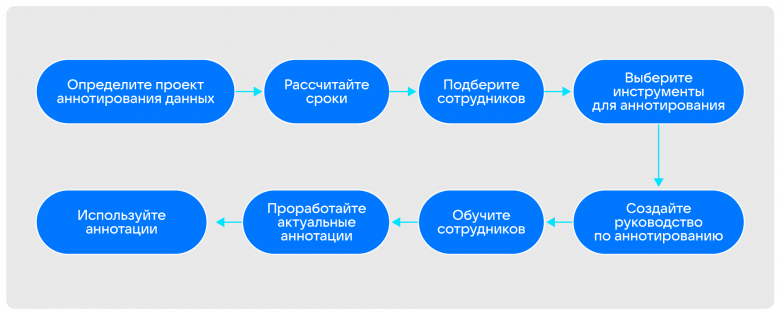
Ни в коем случае не следует относиться к разметке как к второстепенной задаче. На самом деле, это отдельный полноценный проект со своими сроками, бюджетом, командой и метриками качества.
Что касается того, кто именно будет размечать, то здесь есть три пути, каждый со своими особенностями и рисками.
Во-первых, это краудсорсинг (например, Amazon Mechanical Turk). Данный способ подходит только для предельно простых задач (например, "есть ли на фото кошка?"). Риск - крайне низкое качество и высокая вариативность из-за отсутствия контроля и квалификации исполнителей.
Примечание:
Amazon Mechanical Turk (MTurk) — это краудсорсинговая онлайн-платформа, которая позволяет businesses (заказчикам, или "Requesters") передавать небольшие задачи большому сообществу удаленных работников (исполнителей, или "Workers"/"Turkers"), которые выполняют эти задачи за вознаграждение.
Название отсылает к механическому турку — шахматному автомату XVIII века, в котором был спрятан человек, создававший иллюзию игры машины. По аналогии, MTurk использует человеческий интеллект для выполнения задач, которые крайне сложно или невозможно автоматизировать с помощью искусственного интеллекта.
Ключевая концепция: MTurk базируется на идее HIT (Human Intelligence Task) — это единица работы, которую должен выполнить человек. Например, определить объекты на изображении, транскрибировать аудиозапись, сравнить два продукта, ответить на опрос.
Преимущества и сильные стороны MTurk:
- Масштаб и скорость: Вы можете получить разметку для десятков тысяч единиц данных за очень короткое время (часы или дни) благодаря огромной армии исполнителей по всему миру, работающих 24/7.
- Низкая стоимость: Плата за одну микрозадачу очень мала (центы). Это кажется значительно дешевле, чем нанимать штатных сотрудников или дорогих подрядчиков.
- Гибкость: легко менять задания, увеличивать или уменьшать объемы работы в зависимости от потребностей проекта.
- Доступ к человеческому интеллекту: решение задач, неподвластных AI: субъективная оценка (красота, уместность), понимание контекста, сарказма, многозначности в языке.
В целом, Amazon Mechanical Turk — это мощный инструмент в арсенале дата-сайентиста, но он требует глубокого понимания его механизмов и строгой дисциплины в проектировании заданий и контроле качества. Это "острый брусок", который можно использовать для быстрой и дешевой заточки простых задач, но для тонкой работы с дорогим "лезвием" вашего ML-проекта often требуются более специализированные и контролируемые решения.
Во-вторых, это аутсорсинг специализированным провайдерам. Оптимальный вариант для стартапов и среднего бизнеса. Риск в данном случае – это необходимость тщательного выбора подрядчика и налаживания процессов контроля качества их работы.
И, наконец, в-третьих, это внутренняя команда аннотаторов. Путь крупных компаний (например, в Tesla работает команда из 1000 аннотаторов). Плюсы: полный контроль и высочайшее качество. Минусы: огромные операционные затраты и сложность управления.
Обеспечить высокое качество разметки можно также различными способами.
В первую очередь очень полезно создавать детальные руководства (guidelines). Это живой документ с примерами того, как размечать, а как — нет. Все неоднозначные кейсы нужно обсуждать и вносить в гайдлайны. Это главный инструмент обеспечения консистентности между разными аннотаторами.
Кроме того, тщательно выбирайте инструмент. Скорость и точность разметки напрямую зависят от инструмента. Современные платформы (например, Supervisely, Labelbox, V7 Darwin) имеют встроенный AI, который помогает аннотаторам (например, предлагает автоматическую сегментацию объекта по одному клику), что ускоряет работу в разы.
Примечание:
Supervisely, Labelbox и V7 Darwin - это профессиональные инструменты, которые выходят далеко за рамки простого интерфейса для разметки, предлагая полноценные платформы для управления всем циклом данных в ML.
Supervisely — это не просто инструмент для разметки, а целая платформа-экосистема для разработки проектов компьютерного зрения. Её часто называют «IDE для Computer Vision».
Labelbox — это одна из самых популярных и зрелых SaaS-платформ для управления данными машинного обучения. Она позиционируется как центральный хаб для всего жизненного цикла данных — от сырых данных до обученных моделей.
V7 Darwin — это платформа, которая с самого начала была заточена под максимальную автоматизацию процесса аннотации с помощью искусственного интеллекта. Их девиз — «убрать рутину из процесса разметки».
Сравнительная таблица
|
Характеристика |
Supervisely |
Labelbox |
V7 Darwin |
|---|---|---|---|
|
Основной фокус |
Компьютерное зрение (CV), экосистема с IDE |
Универсальная платформа для всех типов данных |
Автоматизация и AI-first подход, компьютерное зрение |
|
Ключевая фича |
Мощная IDE для обработки данных, нейросети внутри |
Управление проектами и качеством (Consensus) |
Встроенный AI-ассистент (Auto-Annotate), пайплайны |
|
Типы данных |
Изображения, видео, 3D-точки, DICOM |
Изображения, видео, текст, геоданные, PDF |
Изображения, видео, DICOM, микроскопия |
|
Модели внутри |
Есть (Train & Label) |
Нет (но есть инт. с ML-фреймворками) |
Да (Auto-Annotate, Training) |
|
Архитектура |
Open-Core (Community Edition + Enterprise) |
SaaS / Enterprise |
SaaS |
|
Интеграции |
Python API, CVAT, облачные хранилища |
Python API, облачные хранилища, популярные фреймворки |
Python API, облачные хранилища |
|
Целевая аудитория |
Исследователи, команды CV, нуждающиеся в гибкости |
Крупные предприятия, нуждающиеся в стабильности и управлении |
Команды, фокусирующиеся на автоматизации и скорости |
|
Ценообразование |
Бесплатная версия, платная по подписке |
Посекундная оплата за работу аннотаторов + подписка |
Посекундная оплата за Auto-Annotate + подписка |
Выбирайте Supervisely, если вам нужна максимальная гибкость и контроль как над данными, так и над моделями, особенно для нестандартных задач CV. Идеален для hands-on исследователей.
Выбирайте Labelbox, если вам нужна надежная, корпоративная платформа для управления крупными проектами с безупречными процессами контроля качества и работы с разными типами данных.
Выбирайте V7 Darwin, если ваша главная цель — скорость и автоматизация, и вы готовы доверить первоначальную разметку AI, оставив людям роль валидаторов и редакторов.
Все три платформы предлагают бесплатные триальные периоды или тарифные планы, поэтому лучший способ выбрать — это загрузить sample ваших данных и протестировать, какая из них лучше всего подходит под ваши конкретные задачи и workflow.
Вернемся к обсуждении ML-моделей…
Заранее просчитайте бюджет и сроки. Разметка — это дорого. Используйте простые формулы для оценки:
*Общее время (часы) = (время на 1 пример × количество примеров) + время на обучение и контроль качества.*
*Общее время (дни) = Общее время (часы) / количество аннотаторов / 8 часов в день.*
Стоимость = Общее время (часы) × почасовая ставка аннотатора.
Пример:
Разметка 100 000 изображений, где на одно изображение уходит 1 минута, займет у одного аннотатора 1666 часов (почти 209 рабочих дней). Это показывает, почему параллелизация и автоматизация так важны.
Обязательно внедряйте контроль качества! Человек ошибается всегда. Внедряйте многоуровневую проверку: случайная выборочная проверка менеджером, кросс-проверка разными аннотаторами, использование автоматических инструментов для статистического выявления противоречий в размеченных данных (например, Cleanlab).
Синтетические данные: мощный инструмент для преодоления ограничений реального мира
Проблемы с разметкой, конфиденциальность данных (например, в медицине или финтехе) и дисбаланс классов (когда объектов одного класса в тысячи раз больше, чем другого) — все это приводит к росту популярности синтетических данных.
Синтетические данные — это искусственно сгенерированные данные, которые имитируют реальные. Для их создания используются игровые движки (для генерации фотореалистичных изображений и видео с безупречно точными метками (например, для автономного вождения), а также GAN (Generative Adversarial Networks) и Diffusion Models (для создания изображений, текста, табличных данных).
Основные преимущества синтетических жанных: бесконечный объем (можно быстро сгенерировать необходимое количество примеров редкого класса), безупречная разметка (метки создаются автоматически и без ошибок) и конфиденциальность (нет риска утечки реальных пользовательских данных).
Основной риск в данном случае можно описать следующим образом: "пропасть между реальностью и симуляцией". Если синтетические данные недостаточно реалистичны, модель переобучится на их артефакты и будет плохо работать на реальных данных. Решение: часто синтетические данные используются для предварительного обучения модели с последующим дополнительным обучением на небольшом наборе реальных данных.
Пример:
Наша компания помогала разработать систему обнаружения дефектов на конвейере. Реальных бракованных образцов было очень мало (сильный дисбаланс классов). Мы сгенерировали тысячи синтетических изображений дефектов на 3D-моделях деталей, используя различные текстуры, освещение и углы съемки. Это позволило нам предобучить модель и достичь высокой точности детекции, которую затем удалось улучшить на небольшой партии реальных данных.
Данные — это ваш главный актив
Создание качественных ML-систем — это не магия и не только наука о алгоритмах. Это в первую очередь инженерия, дисциплина и скрупулезная работа с данными. Data-centric подход — это не просто тренд, это новая реальность, в которой побеждают те, кто умеет управлять данными как стратегическим активом.
- Сдвиньте фокус с моделей на сами данные. Чаще всего лучший прирост точности дает улучшение качества данных, а не смена алгоритма.
- Обязательно инвестируйте в построение надежных data-пайплайнов. Помните, что автоматизация ETL — это основа, которая окупится многократно.
- Относитесь к обучающим данным как к фундаменту. Они должны быть релевантными, полными, несмещенными и качественно размеченными.
- Управляйте разметкой как отдельным проектом. Планируйте бюджет, сроки, выбирайте правильных исполнителей и инструменты, внедряйте строгий контроль качества.
- Рассматривайте синтетические данные как мощный инструмент для решения проблем дисбаланса, конфиденциальности и стоимости разметки.


