

Стратегия успеха ML-проектов: от бизнес-идеи до промышленного внедрения. Практическое руководство по созданию качественных ML-систем (часть 1)
Внедрение машинного обучения — это не научный эксперимент, а сложный инженерный проект, успех которого измеряется не точностью модели на тестовом датасете, а ее реальной ценностью для бизнеса: увеличением выручки, снижением затрат или повышением лояльности клиентов. По нашим оценкам, до 85% ML-проектов никогда не доходят до продакшена, а те, что доходят, часто не приносят ожидаемой ROI. Основная причина — отсутствие системного подхода на самом раннем, стратегическом этапе.
Наша компания, обладая многолетним опытом реализации промышленных ML-решений, готова поделиться отработанной методологией. Это руководство поможет вам избежать типичных ошибок и выстроить процесс, который гарантированно приведет к созданию качественных, надежных и ценных ML-систем.
Почему план важнее алгоритма? Разрушаем иллюзии
Выпускники вузов и курсов часто приходят в индустрию с убеждением, что работа Data Scientist — это исключительно тонкая настройка гиперпараметров и соревнование на Kaggle. Реальность сурова и прозаична:
В процессе учебы Вам дают чистый, готовый датасет (например, Iris или Titanic). Ваша цель — добиться максимального Accuracy или F1-Score.
В продакшене Ваша цель — решить бизнес-задачу. Данных нет, их нужно собрать, очистить и разметить. Модель должна не просто предсказывать, а делать это 24/7, под нагрузкой, соответствуя требованиям к задержке (latency), интерпретируемости и стоимости эксплуатации.
Таким образом, ML-проект — это, в первую очередь, инженерный проект со своей спецификой. И как любой сложный проект, он требует тщательного планирования, проработки требований и управления рисками.
Итеративный жизненный цикл ML-проекта: добро пожаловать в реальный мир
Классическое представление о жизненном цикле выглядит линейно и достаточно просто:
- Постановка задачи
- Сбор и подготовка данных
- Обучение модели
- Оценка
- Деплой
- Мониторинг
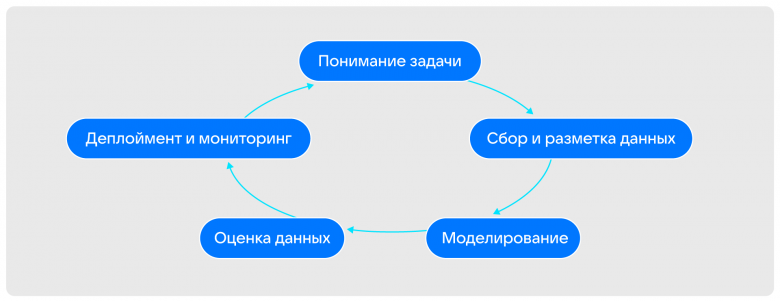
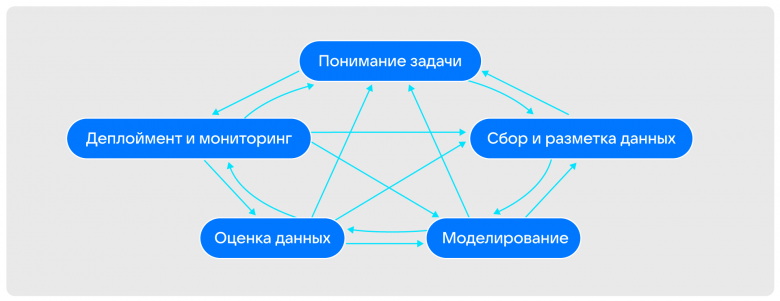
На практике этот процесс никогда не бывает линейным. Это — спираль постоянных итераций и откатов.
в реальности переходы между этапами, указанными выше, не такие плавные. Как правило, на каждом этапе что-то идет не так, и это отбрасывает вас назад , если не в самое начало. Добро пожаловать в реальный мир =)
У специалистов с опытом в разработкевозникнет вопрос: «В чем разница между ML-проектами и разработкой традиционного ПО? Где тесты, сборки и релизы?» ML-проект— это подкласс проекта по разработке ПО. Все передовые методы разработки ПО прекрасно подходят и для ML-проектов. В связи с этим позвольте представить реалистичный жизненный цикл проекта по разработке ПО с компонентом ML:
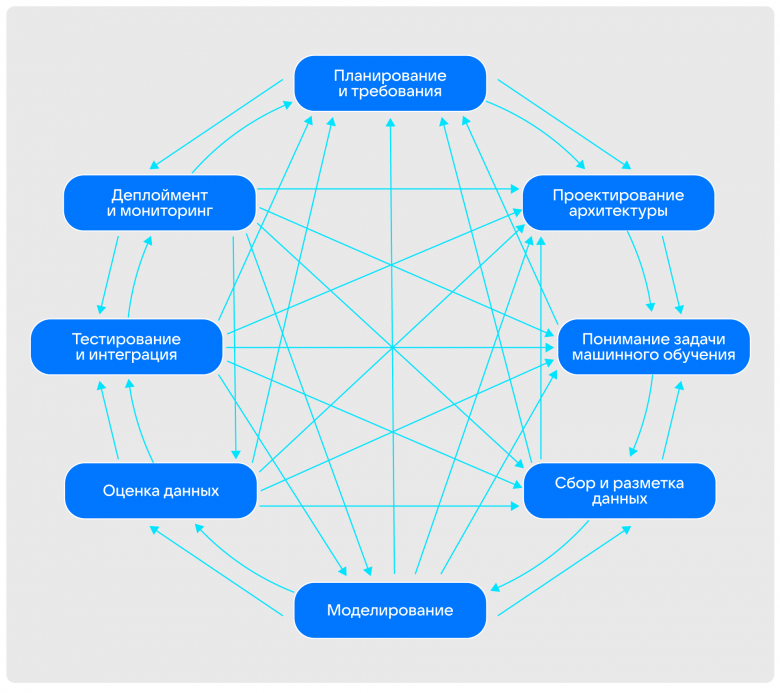
Типичный сценарий, с которым мы сталкиваемся у клиентов:
На этапе мониторинга выясняется, что модель делает дискриминационные предсказания для определенной группы пользователей (bias). → Откат к этапу 1 (пересмотр задачи и сбор более репрезентативных данных).
После деплоя выясняется, что время отклика модели в 10 раз превышает допустимое для пользовательского приложения. → Откат к этапу 3 (выбор более простой и быстрой модели или оптимизация кода).
A/B-тест показывает, что новая модель не дает статистически значимого улучшения ключевых метрик. → Откат к этапу 1 (полный пересмотр гипотезы или закрытие проекта).
Огромный риск в данном случае - непонимание итеративной природы процесса ведет к нереалистичным срокам, завышенным ожиданиям и, в конечном итоге, к признанию проекта провальным.
Мы внедряем гибкую, итеративную методологию, где каждая итерация (спринт) нацелена на получение конкретного измеримого результата и проверку гипотез, что позволяет быстро валидировать идеи и минимизировать потери.
Прежде чем написать первую строчку кода
Прежде чем инвестировать месяцы работы команды и десятки тысяч долларов в разметку данных, необходимо выполнить четыре критически важных действия.
1. Оценка бизнес-ценности: «Зачем мы это делаем?»
Любой ML-проект должен начинаться с вопроса: «Какую конкретную бизнес-проблему мы решаем и как будем измерять успех?».
Ошибкой в данном случае является старт проекта с формулировки «Хочу применить нейросеть для рекомендаций» или «Надо сделать ИИ для чат-бота». Это тупиковый путь.
Правильный подход - «Мы хотим на 15% увеличить средний чек за счет системы персональных рекомендаций на сайте» или «Нам нужно на 30% сократить нагрузку на колл-центр, автоматизировав ответы на частые вопросы через чат-бот».
Пример:
Для клиента из ритейла мы оценивали проект по прогнозированию спроса. Ценность была посчитана не в точности модели (MAPE), а в деньгах:
Снижение ошибки прогноза на 1% → Снижение логистических издержек на X рублей в месяц → Сокращение уровня out-of-stock на Y% → Увеличение выручки на Z рублей.
Именно эти цифры мы презентовали стейкхолдерам для получения финансирования.
2. Сбор требований: «Что мы строим?»
На этом этапе мы задаем детальные вопросы, чтобы сформировать техническое задание и понять ограничения.
- Какой объем данных доступен? Какого они качества? Кто и как будет их размечать? Каковы затраты на разметку?
- Где будет работать модель: в облаке или on-premise? Какие требования к задержке (latency)? 100 мс или 100 нс? Какие требования к доступности (SLA)? 99.9% или 99.999%?
- Как обеспечивается конфиденциальность данных? Нужно ли объяснять предсказания модели (Explainable AI) для соблюдения регуляторных норм (например, GDPR)?
- Как модель будет интегрирована в существующие бизнес-процессы и IT-ландшафт?
Пропустить этот этап — значит столкнуться с ситуацией, когда идеально точная модель не может быть запущена в прод, потому что она нарушает внутренние политики безопасности или ее предсказания невозможно интегрировать в CRM-систему.
К сожалению, слишком много современных компаний допускают одну и ту же ошибку - они хотят ИИ, но наборы данных у них слишком маленькие и неочищенные.
3. Трезвая оценка: «А нужно ли тут вообще ML?»
Машинное обучение — не панацея. Часто задача эффективнее решается более простыми методами.
Пример №1:
Классификация запросов в техническую поддержку. Прежде чем строить сложную NLP-модель, попробуйте использовать keyword matching или алгоритм на основе правил (rule-based system). Это даст быстрый результат с минимальными затратами.
Пример №2:
Обнаружение мошеннических операций. Анализ аномалий (anomaly detection) на основе статистических пороговых значений часто оказывается более надежным и интерпретируемым решением, чем «черный ящик» градиентного бустинга.
Мы проводим воркшопы с заказчиком, где вместе анализируем задачу и принимаем взвешенное решение о целесообразности использования ML, всегда начиная с поиска простейшего работоспособного решения.
4. Data-First Approach: «Данные — это новая нефть, но ее еще нужно добыть и очистить»
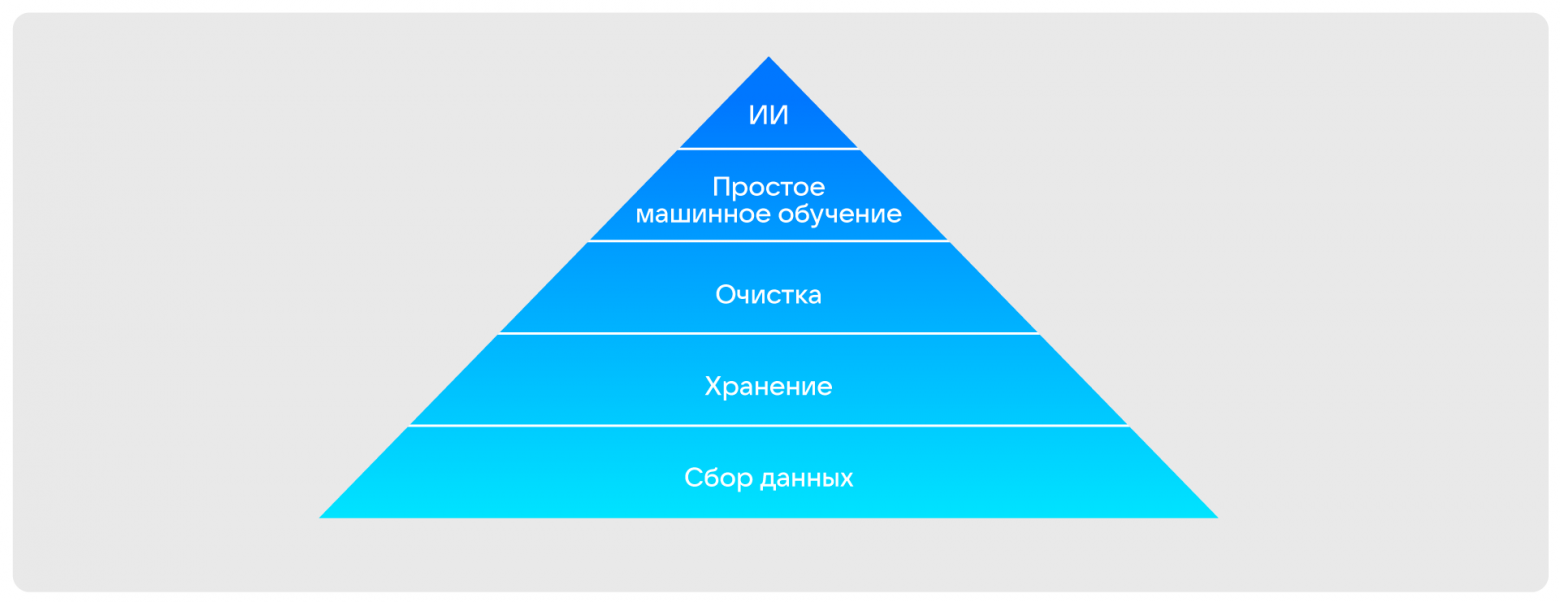
Самый частый провал проектов — не отсутствие талантливых дата-сайентистов, а отсутствие качественных данных. Мы руководствуемся Пирамидой Потребностей AI, предложенной Моникой Рогати:
- Основание (Foundation): сбор, хранение и обработка данных. Без надежной инфраструктуры данных строить нечего.
- Середина (Intermediate): анализ и преобразование данных, их разметка и мониторинг качества.
- Вершина (Top): непосредственно машинное обучение и AI.
Главной ошибкой в данном случае будет попытка построить дворец ML на шатком фундаменте из разрозненных Excel-табличек и битых CSV-файлов.
Прежде чем приступать к моделированию, мы проводим полный аудит данных клиента: оцениваем их объем, качество, согласованность и доступность. Часто первый проект — это не создание модели, а помощь клиенту в настройке ETL-пайплайнов и хранилища данных.
Итеративная разработка — Start Small, Fail Fast
Даже если ваша амбициозная цель — сервис для миллионов пользователей, начинать нужно с малого. Мы используем два ключевых концепта:
1. Proof of Concept (PoC) — Доказательство принципиальной возможности
Его цель заключается в том, чтобы ответить на вопрос «Можно ли вообще решить эту задачу с помощью ML на имеющихся данных?».
Обычно мы делаем это быстро и «грязно». Данные извлекаются вручную, модели тренируются в Jupyter Notebook на небольшой выборке. Проверяются 2-3 базовых алгоритма.
Что нужно делать - писать красивый код, настраивать CI/CD, думая о масштабировании.
В результате мы должны получить четкое понимание того, есть ли в данных сигнал для обучения. Оценка порядка точности и ключевых проблем.
2. Minimum Viable Product (MVP) — Минимально жизнеспособный продукт
Цель состоит в том, чтобы проверить, приносит ли модель ожидаемую бизнес-ценность в реальных условиях.
Как правило, мы разворачиваем простейшую рабочую версию модели для небольшой группы реальных пользователей (например, 5% трафика сайта).
А стоит реализовывать все возможные фичи и оптимизации.
В результате мы должны получить данные A/B-теста, показывающие, улучшает ли модель ключевые бизнес-метрики.
Главный принцип: Fail Fast.
Если на этапе PoC стало ясно, что данные непригодны или точность принципиально не дотягивает до нужной, — проект смело закрывается, а сэкономленные ресурсы перенаправляются на более перспективные идеи. Цена ошибки на этом этапе минимальна.
Дизайн-документ — Ваш главный план сражения
Дизайн-документ (Design Doc) — это центральный артефакт в нашем процессе планирования. Это не формальность, а практический инструмент, который экономит недели работы и сотни тысяч рублей.
Он запускает глубокий мыслительный процесс. Пока вы описываете архитектуру системы на бумаге, вы заранее обнаруживаете «узкие места», технические противоречия и риски. Вы прорабатываете сценарии отказа, мониторинга и масштабирования до написания кода.
Кроме того, он синхронизирует команду. Единый документ, доступный всем: дата-сайентистам, ML-инженерам, разработчикам бэкенда, менеджерам продуктов. Все понимают общую картину, свои задачи и точки интеграции. Это сводит к нулю риск создания разрозненных компонентов, которые невозможно собрать воедино.
Что входит в дизайн-документ для ML-системы (на основе шаблона Eugene Yan)?
- Цель и метрики успеха: Какие бизнес- и ML-метрики мы отслеживаем?
- Данные: Какие данные нам нужны? Где они хранятся? Какой требуется объем разметки?
- Модель: Какие подходы будем пробовать? Как будем валидировать?
- Инфраструктура: Схема обучения и инференса. Требования к CPU/GPU, памяти, сети.
- Мониторинг: Что будем мониторить (точность, дрейф данных, задержки)?
- Безопасность и compliance: Как обеспечивается конфиденциальность?
- Команда и сроки: Роли, ответственность и план по этапам.
Пропуск создания дизайн-документа приводит к хаотичной разработке, когда каждый участник команды понимает конечную цель по-своему. Результат — бесконечные переделки, конфликты интеграции и сорванные сроки.
Итак, cоздание качественных ML-систем — это марафон, а не спринт. Прочное основание, заложенное на этапе планирования, определяет, сможете ли вы финишировать с результатом, который принесет реальную ценность бизнесу.
В целом, наши основные рекомендации можно представить следующим образом:
- Начинайте с бизнес-цели, а не с технологии.
- Собирайте требования со всех стейкхолдеров, включая юристов и DevOps.
- Трезво оцените, нельзя ли решить задачу проще, без ML.
- Проведите аудит данных — это основа всего.
- Двигайтесь итеративно: PoC → MVP → Постепенное масштабирование.
- Создавайте дизайн-документ до написания кода. Это ваш главный план.
Не позволяйте вашим ML-проектам стать частью печальной статистики провалов. Начните с правильного плана.


