

Капстоун-проект: практическая реализация и оценка
Капстоун-проект — это кульминационный, демонстрационный этап обучения, на котором студенты переводят теорию в практику. В рамках курса «AI Maturity и риск-менеджмент: этика, explainable AI, регуляторные требования и управление моделями» capstone имеет особую ценность: он проверяет, насколько полно и качественно вы можете интегрировать принципы зрелости ИИ, этические нормы, требования регуляторов и управляемость моделей в реальном проекте. В этой главе мы разрабатываем план реализации такого проекта, обсуждаем методологию, набор инструментов (от открытых до российских решений), а также критерии оценки и пути минимизации рисков.
Цели главы:
- дать системную схему реализации капстоун-проекта: от постановки задачи до аудита модели и её интеграции в бизнес-процессы;
- описать теоретические основы зрелости AI, риск-менеджмента и этики, а также практику объяснимости;
- представить реальные примеры и технические детали внедрения, включая open-source и российские решения;
- разобрать риски и ограничения, зависимые от данных, регуляций и технологий;
- предложить набор практических шагов, чек-листы и примеры кода;
- подготовить FAQ для закрепления материала.
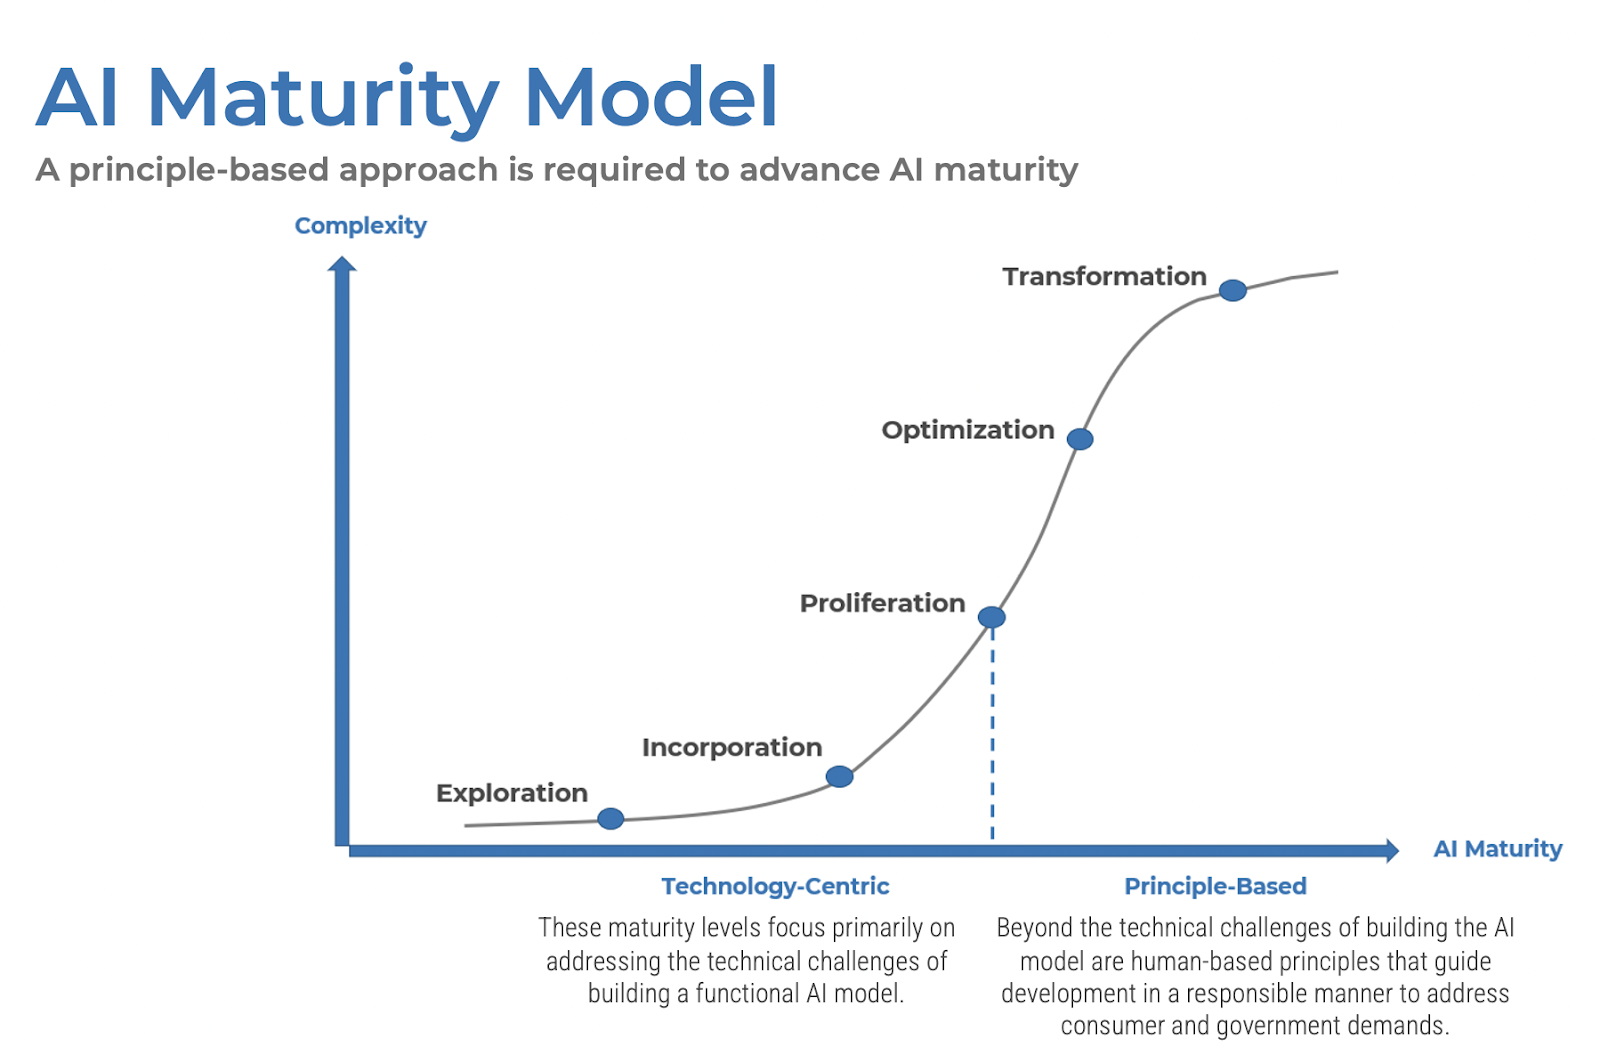
AI maturity и риск-менеджмент этика
AI maturity (зрелость ИИ) описывает, на каком уровне организация использует ИИ-технологии: от экспериментальных прототипов до управляемых, регламентированных и масштабируемых решений. Типичная модель зрелости включает уровни:
- Начальные эксперименты: единичные модели, слабая регуляция.
- Контролируемые: ограниченная политикой проверка, мониторинг ошибок.
- Управляемые: регламентированные процессы разработки, код-ревью, верификация данных.
- Расширенные: масштабируемые пайплайны, управление риск-рисками.
- Зрелые: централизованная модельная архитектура, постоянный аудит, прозрачность и регуляторные соблюдения.
Риск-менеджмент в контексте ИИ состоит из комплексного учёта рисков: модельный риск (risk of incorrect predictions и неправильной калибровки), риск данных (неполные/предвзятые данные), риск приватности и безопасности (утечка данных, атаки на модель), риск операционной деятельности (сбои пайплайнов, зависимость от внешних сервисов), риск соответствия требованиям (регуляторы, контракты, стандартные операционные процедуры). Эти риски тесно связаны: нарушение этических норм может усилить регуляторные риски и ухудшить доверие клиентов.
Этика ИИ включает принципы справедливости, подотчетности, прозрачности и ответственности. В контексте капстоун-проекта этика проявляется в:
- корректной работе с персональными данными (правила обработки, минимизация данных, приватность);
- контроле за предвзятостью (проверка по демографическим группам, устранение дискриминации);
- объяснимости (когда и для кого модель должна объясняться и какие форматы объяснений приемлемы);
- ответственности (кто несёт ответственность за решения модели и как уладить спорные случаи).
Explainable AI (XAI)
Explainable AI — набор подходов, техник и инструментов, которые позволяют людям понять решения ИИ. Различают две группы: ante-hoc (встроенная объяснимость в модель) и post-hoc (объяснение уже обученной модели).
- Ante-hoc: выбор моделей, которые проще объяснить (например, линейные модели, дерево решений) или использование интерпретируемых параметров в сложных моделях.
- Post-hoc: значения SHAP, LIME, Counterfactual explanations, правила на основе доменных знаний.
Метрики объяснимости могут включать:
- Faithfulness (правдивость объяснения к фактическим вклада условия);
- Stability (устойчивость объяснений к небольшим изменениям входа);
- Understandability (понятность объяснения для конечного пользователя);
- Actionability (насколько объяснение позволяет принять управленческое решение).
Инструменты и техники:
- SHAP (SHapley Additive exPlanations) — локальные и глобальные объяснения;
- LIME — локальные аппроксимации сложной модели;
- Counterfactuals — оформление альтернативных сценариев;
- Прозрачные правила и decision sets;
- Встроенная в CatBoost explainability — CatBoost предоставляет встроенные инструменты объяснимости;
- DeepPavlov и другие русскоязычные библиотеки для NLP с поддержкой объяснений.
Регуляторные требования и управление моделями
Регуляторное поле ИИ быстро меняется. В рамках Евросоюза усиливается регуляторный подход к оценке риск-уровня (EU AI Act). В российской практике аккультура регуляций включает защиту персональных данных (152-ФЗ), требования к обработке данных в рамках банковских и финансовых регуляторов, а также внутренние регламенты компаний по управлению моделями и мониторингу.
Ключевые моменты управления моделями:
- регистр моделей (Model Registry): хранение версии, контекст разработки, окружение;
- контроль версий данных: датасеты, версия данные и их качество;
- мониторинг в проде: дрифт признаков и целевой переменной, деградация качества;
- аудит и прозрачность: хранение логов, объяснения, метрики риска;
- регуляторная посадка: политика обработок, конфиденциальности, уведомления клиентов;
- процессы вывода и отзывов: процедура запрета или замены моделей.
Таблица ниже иллюстрирует соответствие инструментов задачам MLOps и регуляторной готовности.
Практические примеры
Пример 1: Кредитный скоринг в банке (capstone-проект)
Цель: создать и внедрить модуль скоринга рисков клиентов с учетом explainability и регуляторной совместимости.
Этапы:
- Постановка задачи: определить целевую переменную (например, дефолт в течение 12 месяцев), набор признаков и требования регуляторов к банку.
- Сбор и подготовка данных: синтетические данные, имитация реальных признаков, обеспечение приватности.
- Выбор модели и объяснимость: CatBoost или LightGBM (быстрые и поддерживают объяснения). Добавляем SHAP-объяснения для глобального понимания вклада признаков.
- Оценка риска: оценка устойчивости к дрифтам, проверка fairness-метрик (например, disparate impact).
- Управление данными и регуляторная документация: данные с согласиями, политика минимизации данных, аудит данных.
- Мониторинг и эксплуатация: настройка пайплайна, мониторинг drift и доступ к объяснениям для аудиторов.
- Внедрение: связь с MLOps-процессами (Model Registry, CI/CD, мониторинг).
Практические сведения:
- Инструменты: CatBoost (для табличных данных), SHAP для объяснений, MLflow для трекинга экспериментов.
- Пример кода (упрощённый) ниже демонстрирует настройку модели CatBoost и вывод объяснений SHAP.
Пример кода: CatBoost и SHAP (упрощённый)
# Установка зависимостей:
# pip install catboost shap pandas scikit-learn

import pandas as pd
import numpy as np
from catboost import CatBoostClassifier
import shap
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score

# Гипотетический набор данных
np.random.seed(0)
n = 1000
X = pd.DataFrame({
    'age': np.random.randint(18, 70, size=n),
    'income': np.random.normal(50000, 15000, size=n),
    'employment_years': np.random.randint(0, 30, size=n),
    'credit_history_length': np.random.randint(0, 20, size=n),
    'num_prev_defaults': np.random.randint(0, 5, size=n)
})
y = (X['income'] > 45000).astype(int)  # упрощенная целевая переменная

X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)

model = CatBoostClassifier(iterations=300, depth=6, learning_rate=0.1, verbose=False, eval_metric='AUC')
model.fit(X_train, y_train)

# Оценка
y_pred_proba = model.predict_proba(X_val)[:, 1]
auc = roc_auc_score(y_val, y_pred_proba)
print("AUC:", auc)

# Объяснения SHAP
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_val)
shap.summary_plot(shap_values, X_val)  # график вклада признаков
Важно помнить: SHAP на CatBoost может потребовать дополнительных настроек для корректной визуализации, но базовый подход работает. В реальном проекте важно хранить объяснения в Model Registry и связывать их с конкретной версией модели.
Пример 2: NLP-подсистема поддержки клиентов с DeepPavlov
Цель: построить систему поддержки на русском языке с объясняемостью ответов и учет регуляторных требований к обработке данных.
Этапы:
- Постановка задачи: создать NLP-пайплайн для чат-бота и классификации запросов клиентов.
- Подготовка данных: сбор и аннотирование диалогов на русском, приватность и удаление чувствительной информации.
- Модель и объяснимость: можно использовать DeepPavlov для NLU и диалогов, добавив инструменты объяснимости для ключевых решений (например, какие признаки использованы для классификации).
- Риски и аудит: аудит данных и решений, ретроспективная проверка на справедливость и корректность ответов.
- Регуляторная документация: политика обработки данных, уведомления клиентов, контроль доступа.
- Мониторинг и эксплуатация: ведение журнала вопросов и ответов, отслеживание ошибок.
Пояснение: DeepPavlov — это российская открытая библиотека для NLP, хорошо подходит для задач чат-ботов, классификации и дискуссионной аналитики. В рамках capstone-проекта можно интегрировать с внешним инструментарием объяснимости и регуляторной документацией.
Практические советы по реализации
- Начинайте с цели и регуляторных требований. Чётко сформулируйте, какие вопросы решает модель и какие ограничения регуляторов применяются к вашему контексту.
- Сопоставляйте модели с требованиями XAI: чем выше риск, тем более объяснимой должна быть модель или добавляйте post-hoc объяснения.
- Введите модель-реестр и контроль версий данных. Это критично для аудита и регуляторных проверок.
- Настройте регуляторные политики: согласие на обработку данных, уведомления клиентов, права на удаление и корректировку данных.
- Реализуйте мониторинг drift и стабильности. Нужны сигналы для отката к более безопасной версии.
- Включайте этические проверки на каждом этапе: тесты на демографическую дискриминацию, на случай ошибок и безопасности.
- Используйте российские библиотеки и инструменты для усиления доверия: CatBoost для табличных данных, DeepPavlov для NLP, а также связанные инструменты MLOps и объяснимости.
Архитектура пайплайна
- Источник данных: данные клиентов, транзакций, логи и т.д.
- Очистка и подготовка: удаление чувствительной информации, нормализация, работа с пропусками.
- Фичеринг: создание признаков, параметризация, управление категориальными признаками.
- Обучение модели: выбор модели, настройка гиперпараметров, кросс-валидация.
- Валидация: метрики точности/показателей риска, explainability.
- Регуляторная документация: хранение решений, политик, журналов.
- Мониторинг и эксплуатация: мониторинг drift, деградации, логирование предсказаний.
- Governance: реестр версий, политики доступа, аудит.
Мониторинг данных и модели
- Data drift: изменение распределения признаков между обучающими данными и продакшен-данными.
- Concept drift: изменение взаимосвязи между признаками и целевой переменной.
- Метрики риска: AUC, precision@k, recall, F1, calibration curve.
- Метрики объяснимости: Faithfulness, Stability, Understandability.
Элементы безопасности и приватности
- Приватность: минимизация данных, псевдонимизация, шифрование в работе.
- Differential Privacy: добавление шума к статистике.
- Безопасность: контроль доступа к данным и моделям, аудит изменений.
- Этика и соответствие: соответствие требованиям GDPR/152-ФЗ, уведомления клиентам.
Пример кода: расчёт SHAP для дерева решений
import numpy as np
import pandas as pd
from catboost import CatBoostClassifier
import shap

# Предположим, у вас уже есть обученная CatBoost модель и данные X_val
# explainer для дерева решений CatBoost
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_val)

# Визуализация вкладов признаков
shap.summary_plot(shap_values, X_val)
Пример кода: запись параметров и метрик в MLflow
import mlflow
from sklearn.metrics import roc_auc_score
import numpy as np

with mlflow.start_run():
    mlflow.log_param("model", "CatBoostClassifier")
    mlflow.log_param("iterations", 300)
    mlflow.log_param("depth", 6)
    mlflow.log_metric("AUC", auc_score)

    # Сохранение артефактов
    model.save_model("model.bin")
    mlflow.log_artifact("model.bin")
Таблица: сравнение инструментов для MLOps и XAI
| Инструмент | Назначение | Преимущества | Российские решения | Примечания |
|---|---|---|---|---|
| CatBoost | Моделирование на табличных данных (для бизнес-аналитики) | Хорошая производительность на катег. признаках, встроенная объяснимость | Да (разработчик — российская компания Яндекс/область разработчиками) | Отлично работает с предвзятостью и регуляторной документацией. |
| DeepPavlov | NLP/чат-боты | Русскоязычные модели, готовые компоненты | Да | Подходит для диалогов, классификации текстов. |
| MLflow | MLOps и трекинг экспериментов | Легко интегрировать в пайплайн, версия моделей | Нет (мировые проекты) | Хорош для регуляторной документации и аудита. |
| Kubeflow | MLOps | Поддержка сложных пайплайнов, оркестрация | Нет (мировые проекты) | Удобен для крупных производств. |
| SHAP / LIME | Объяснимость | Ясные локальные объяснения | Нет (мировые проекты) | Полезны для аудита и объяснений аудиторам. |
| DeepPavlov + SHAP | XAI для NLP | Комбинированный подход | Да (Russian project) | Поддержка русского языка. |
| Feast (Feature Store) | Управление признаками | Управление признаками и версиями | Нет (мировые проекты) | Полезен для больших пайплайнов. |
Риски и ограничения
- Данные и предвзятость: данные могут содержать исторические предвзятости, которые приводят к дискриминационным моделям. Необходмо проводить аудит по группам, а также использовать техники исправления bias и fairness.
- Drift и деградация: распределения данных меняются со временем; без мониторинга модель начинает показывать ухудшение качества.
- Приватность и регуляция: обработка персональных данных требует соблюдения законов и политики доступа. Неправильная обработка может привести к штрафам и утрате доверия.
- Объяснимость и доверие: объяснения могут быть недостоверными или непрактичными для бизнеса. Важно сочетать объяснения с реальными сценариями.
- Риск эксплуатации: даже объяснимые модели могут быть подвержены манипуляциям или атакам на входные данные.
- Ограничения технологий: определённые задачи требуют сложной архитектуры и вычислительных ресурсов; некоторые российские инструменты ограничены экосистемой.
- Стоимость и окупаемость: поддержание MLOps-пайплайнов требует ресурсов; важно оценивать ROI и стратегию внедрения.
- Регуляторная неопределенность: требования к ИИ и управлению моделями быстро меняются; нужно держать регуляторные политики актуальными.
Капстоун-проект в рамках темы AI Maturity, риск-менеджмента, этики и регуляторных требований — это синтез теории и практики. Он требует системной подготовки: понимания зрелости организации, этических норм, подходов к объяснимости и регуляторному ландшафту. Практические решения должны сочетать открытое ПО и российские инструменты, чтобы обеспечить устойчивость, прозрачность и доверие к моделям. Важно строить пайплайны с учётом требований к управлению данными, объяснениям и аудиту, чтобы успешно пройти путь от прототипа к безопасной и регуляторно совместимой модели в проде.
FAQ (Вопрос–Ответ)
Q1. Что такое капстоун-проект в контексте курса AI Maturity и риск-менеджмента?
- A: Это итоговый проект, который демонстрирует практическую реализацию концепций зрелости ИИ, этики и риска, объяснимости, регуляторных требований и управления моделями. В рамках него вы формулируете постановку задачи, выбираете инструменты, строите пайплайн, оцениваете риски, документируете процессы и проводите аудиты. Он подтверждает, что вы можете переходить от теории к реальному внедрению.
Q2. Какие ключевые принципы этики нужно учитывать при реализации капстоун-проекта?
- A: Справедливость (ненасильственный и недискриминационный подход к данным и решениям), подотчетность (кто отвечает за решения и как аудитируются результаты), прозрачность (объяснимость и доступ к ключевым метрикам и объяснениям), приватность (минимизация обработки данных и защиту персональных данных). Эти принципы помогают снижать регуляторные риски и повышать доверие.
Q3. Какие инструменты для объяснимости являются наиболее практичными?
- A: SHAP и LIME — два самых распространённых подхода для пост-гок объяснения. SHAP даёт вклад каждого признака в конкретное предсказание, а также позволяет посмотреть глобальные паттерны. Counterfactual explanations — сравнение с близкими минимальными изменениями входа для достижения другого решения. В случае CatBoost есть встроенные возможности объяснимости, что упрощает интеграцию.
Q4. Какие российские решения можно использовать наряду с open-source инструментами?
- A: CatBoost — разработанный в России и поддерживающий хорошие показатели на табличных данных, а также интегрируемый с объяснениями. DeepPavlov — российская открытая ML/NLP-библиотека для задач классификации, диалогов и NLP-пайплайнов. Эти инструменты можно комбинировать с общими MLOps-практиками (MLflow, Kubeflow) для полного цикла.
Q5. Какие риски чаще всего возникают на этапах подготовки данных?
- A: Неполнота и искажения данных, утраты приватности, неверная маркировка, несоответствие законам о персональных данных и регуляторным требованиям. Эти риски ведут к некорректным решениям и требуют аудита данных, политики доступа, а также минимизации использования личной информации.
Q6. Как устроен контроль версий и аудит в рамках капстоун-проекта?
- A: Включает Model Registry (регистрация версий моделей и их контекста), хранение версий данных и признаков, логи изменений кода, тестовые стенды и документацию. В аудитах особенно важны метрики риска, объяснения и вероятность событий, которые можно проверить в регуляторной документации.
Q7. Какие шаги помогут снизить риск дрифта и деградации модели?
- A: Включите мониторинг drift по признакам и целевой переменной, настройте автоматические алерты на изменения метрик, регулярно переобучайте модель на актуальных данных, внедрите версионность признаков и регистр изменений. Также полезна проверка совместимости входных данных с фейловыми тестами.
Q8. Какие регуляторные требования стоит учитывать на старте проекта?
- A: Защита персональных данных (правила обработки, согласие на обработку, право на удаление), аудит данных и моделей, демонстрация прозрачности и объяснимости, документирование моделей, процедур по управлению инцидентами и ответами аудиторов. В зависимости от отрасли могут добавляться отраслевые требования банковского надзора, страхования, здравоохранения и т.д.
Q9. Что важнее на стадии реализации: точность модели или explainability?
- A: Это зависит от контекста. В областях с высоким риском и регуляторной нагрузкой объяснимость часто критична и может быть приоритетом над максимальной точностью. В любом случае следует балансировать: прийти к удовлетворительной точности и обеспечивать понятные объяснения, чтобы аудиторы и бизнес могли понимать решения.
Q10. Какой подход к выбору инструментов для капстоун-проекта лучше всего подходит новичкам?
- A: Начинайте с простого стека: CatBoost для базовых табличных задач, SHAP для объяснимости, MLflow для трекинга экспериментов и простейший пайплайн MLOps. Добавляйте DeepPavlov для NLP-задач, если есть текстовые данные. В дальнейшем можно расширять стек за счёт Kubeflow, Feast и других инструментов — в зависимости от масштаба проекта и регуляторных требований.
Если вы рассматриваете внедрение AI в своей компании, мы поможем оценить перспективные сценарии, подготовить архитектуру решения и рассчитать экономический эффект. Работаем с корпоративными системами и закрытыми контурами. Свяжитесь с нами, чтобы обсудить ваш кейс.


