

Агрегации и вычисления: Roll-Up, Drill-Down, агрегационные ошибки
Понимание Roll-Up и Drill-Down - базовый навык анализа данных в хранилищах. Но за простыми операциями группировки скрывается сопряжённая сеть архитектурных решений, правил расчета метрик и множества типичных ошибок, связанных с грануляцией измерений, фильтрацией и согласованием соседних уровней агрегации. Глава концентрирует внимание на деградации DWH именно на уровне агрегаций и вычислений: какие архитектурные решения обеспечивают корректные Roll-Up и Drill-Down, какие ошибки чаще всего приводят к «разгерметизации» интерпретаций, и как строить процессы контроля качества агрегатов.
Начальные концепции задают рамку для практических решений: как правильно выбрать грануляцию фактов, какие меры считать additive, semi-additive или non-additive, и как проектировать агрегаты так, чтобы они служили бизнес-задачам без потери точности. В конце главы представлены методические подходы к валидации агрегатов, набор практических паттернов и примеры реализации на типовых СУБД и аналитических движках.
- Концепции Roll-Up и Drill-Down в контексте архитектуры DWH и их влияние на точность измерений.
- Типы агрегируемых метрик, их корректная агрегация и ошибки, которые возникают при их использовании.
- Методики проектирования агрегатов, протоколы интеграции и подходы к тестированию и мониторингу.
- Практические примеры реализации и детализация по SQL-операторам, материализованным видам и оценке эффективности.
Теоретические основы агрегаций: грануляция измерений и архитектура Roll-Up
Грануляция измерений определяется через зерно фактов и иерархии измерений в измерительном пространстве. Гранулярность задаёт предел для Roll-Up: если базовый факт зафиксирован на уровне дня и региона, Roll-Up без потери смысла обычно движется к более высоким уровням времени (месяц, квартал) и к консолидированным географическим уровням (регион, страна). В рамках архитектуры это накладывает несколько ключевых требований:
- Ясное определение базового зерна фактов (grain): что считается единицей измерения и какие атрибуты в этой единице являются величинами для агрегаций.
- Наличие унифицированных размерностей (dimensions) и их иерархий: например, time -> month -> quarter, geography -> region -> country. Эти иерархии важны для корректного Roll-Up/Drill-Down и предотвращения двукратного подсчета.
- Разграничение типов мер: additive (например, сумма продаж), semi-additive (например, остаток на складе на конец периода) и non-additive (напр., средний рейтинг, который не может быть суммирован напрямую).
- Правила фильтрации при агрегациях: фильтры BI-инструментов и контекст запросов должны корректно распространяться на все уровни агрегации, иначе Roll-Up может считаться противоречивым с исходными деталями.
С точки зрения реализации Roll-Up, основным инструментом выступают операторы группировки в SQL: ROLLUP, CUBE и GROUPING SETS. Рассмотрим на примерах:
-- Roll-Up: по регионам и дням
SELECT region, DATE_TRUNC('day', sale_date) AS day, SUM(amount) AS total_amount
## FROM fact_sales
GROUP BY ROLLUP(region, DATE_TRUNC('day', sale_date));
-- Группа по группам и дрейфу в датах и регионах (GROUPING SETS)
SELECT region, DATE_TRUNC('month', sale_date) AS month, SUM(amount) AS total_amount
FROM fact_sales
## GROUP BY GROUPING SETS (
(region, DATE_TRUNC('month', sale_date)),
(region),
(DATE_TRUNC('month', sale_date)),
()
);-- Куб (CUBE) для полного обзора по всем сочетаниям уровней
SELECT region, DATE_TRUNC('month', sale_date) AS month, SUM(amount) AS total_amount
## FROM fact_sales
GROUP BY CUBE(region, DATE_TRUNC('month', sale_date));Эти конструкции позволяют получить как детализированные значения на низших уровнях, так и итоговые сводки на верхних, но требуют внимательного обращения с группировочными функциями и атрибутами GROUPING/ GROUPING_ID, чтобы правильно различать уровни и вникать в смысл результатов (например, где видны «итоги по региону» без привязки к конкретному месяцу).
Дальше следует подчеркнуть: Roll-Up и Drill-Down не меняют зерно источника данных, они лишь изменяют поверхность агрегации. Ключ к корректной агрегации - согласованность между базовыми фактами и агрегированными представлениями, а также своевременная поддержка превалирующих уровней и целевых мер.
Разновидности агрегаций и их влияние на точность
Метрики, которые попадают под агрегацию, классифицируются по способности сохранять точность при переходах между уровнями:
- Additive measures. Простые суммы и количества, которые сохраняют корректность в любом Roll-Up. Пример: общая выручка, количество продаж.
- Semi-additive measures. Значения, которые можно суммировать по большинству измерений, но не всегда в рамках временной оси. Пример: запасы на конец периода. Их нельзя агрегировать как обычную сумму по времени без дополнительных правил (например, вычислять начальные и конечные запасы и разницу).
- Non-additive measures. Метрики, которые нельзя агрегировать посредством простой суммы. Пример: средний рейтинг, показатель конверсии в процентах без оснований на весах; требуется другая схема агрегации.
Выбор типа меры критически влияет на точность Roll-Up. В архитектуре DWH это диктует, какие агрегаты следует материализовать и как их поддерживать. Применение неверного типа меры может привести к иллюзиям «пересекающихся» итогов, двойному учету или потере информации.
Влияние на точность особенно заметно при:
- Непоследовательной консолидированной фильтрации: если агрегат учитывает фильтры по-одному, а основная выборка - по-другому, итог может не совпасть с суммой детализированных строк.
- Неправильном учете временных иерархий: Roll-Up по месяцу без учёта даты окончания месяца может добавить или исключить значения, нарушив последовательность временных рядов.
- Неправильной работе с измерениями, которые изменяют гранулярность: например, изменение страны в dimension без надлежащего «versioning» ведет к несовпадению между агрегатом и исходной детализацией.
Практическим подходом здесь является явное обслуживание мер: определить добавляемость в контексте каждого уровня и хранить для каждой меры не только агрегатную сумму, но и метаданные о допустимости агрегации и о фильтрах, применяемых к различным уровням. Это позволяет заранее исключать некорректные сценарии Drill-Down и Roll-Up.
Ошибки моделирования и вычислений: Roll-Up и Drill-Down
Перечень типичных ошибок в Roll-Up/Drill-Down, которые приводят к деградации точности и смысла аналитики:
- Неправильный грануляционный слой (grain mismatch). Если база имеет зерно «день и регион», а агрегаты формируются для «недели и страна», возникают несоответствия между деталями и сводками. Решение - фиксировать канонический зерно и ограничивать добавочные агрегаты соответствующими правилами.
- Неправильная фильтрация и фильтры-растяжки. Фильтры BI-инструментов должны распространяться на все уровни агрегации, иначе Roll-Up может отражать не тот контекст, который требуется бизнес-аналитикам. Необходимо обеспечить единый контекст фильтрации по всей иерархии.
- Ошибки при работе с временными измерениями. Временные зоны, переходы на летнее/зимнее время, а также некорректная агрегация по периодам могут привести к разночтениям между датами в детализации и суммами в сводках. Решение - унифицировать временной базис и хранить временные константы в отдельной измеряемой таблице.
- Дублирование и двойной счет. Если Roll-Up предпринимается без учёта того, какие строки уже включены в детальную выборку, итог может быть «задвоен» за счет перекрывающихся группировок. Требуется явная маркировка агрегирований и проверка на уникальность.
- Неправильное обращение с semi-additive и non-additive мер. Для запасов на склад и подобных показателей требуется особый подход: использование Last Value, Last Non-Null, или хранение двух- или многомерных статистик для корректного Drill-Down.
- Неполная поддержка Slowly Changing Dimensions (SCD). При изменении значений dimension (например, регион переименован, код изменён) без версии, Roll-Up может объединять разные сущности под одной метрикой, что разрушает контекст и точность. Решение - использовать версионирование измерений и сохранять историю изменений.
- Неверное обращение с NULL-значениями. NULL может сигнализировать «нет данных» или «незначим»; одинаковые подходы к обработке NULL в разных уровнях агрегации приводят к неверным итогам. Нужно определить единые политики обработки NULL.
- Игнорирование кросс-грани и контекстов. В реальных сценариях агрегаты вычисляются с учётом разных контекстов: региональные или товарные группы могут иметь разные наборы строк, и Drill-Down должен продолжать поддерживать контекст. Позиции с пустыми контекстами должны помечаться как отдельные итоговые строки.
- Неподдерживаемые агрегаты для drill-down переходов. При переходах к более детализированным уровням может потребоваться пересчитать агрегаты с использованием базовой детализации, а не просто разворачивать существующую сумму. Это требует наличия базовых таблиц и логики перевычисления.
- Неактуальные или устаревшие агрегаты. Аггрегаты должны обновляться по расписанию и при изменении данных. Неподдерживаемые MV или кэш-образы приводят к расхождениям и неверной аналитике.
Для снижения риска важно внедрить практики верификации: reconciliation тесты между базами и агрегатами, тесты на целостность рядов, тесты на корректность агрегации сумм и средних, а также процессы мониторинга задержек обновления агрегатов.
Практические методики: проектирование агрегатов, схемы и протоколы интеграции
Разработка агрегатов начинается с бизнес-целей: какие аналитики чаще всего строятся из Roll-Up и Drill-Down, какие уровни иерархии необходимы бизнесу для принятия решений. Основные методики:
- Определение ядраgranularity. Зафиксируйте канонический зерно фактов: что именно считается единицей измерения, какие атрибуты обязательны для расчета и какие измерения являются измеряемыми метриками. Это позволит не уходить в произвольные уровни.
- Выбор набора агрегатов. Решение о необходимости агрегатных таблиц следует принимать на основе анализа использования: какие уровни чаще всего запрашиваются, какие CPU-ресурсы они требуют и какие задержки допускаются BI-пайплайном.
- Определение мер и правил агрегации. Разделение additive/semi-additive/non-additive, согласование методов агрегирования, сценариев Drill-Down и Roll-Up. Разработка стандартов именования для агрегатов и их версий.
- Архитектура агрегатов. Рекомендовано сочетать «основное»: базовая таблица фактов с детальной информацией, и «прикладные»: агрегаты на соседних уровнях. В качестве источников можно рассмотреть материализованные представления (MV), специализированные агрегаты в СУБД или движки OLAP.
- Протоколы интеграции и управления изменениями. Важна согласованность между источниками фактов и агрегатов, сопровождение изменений схемы и миграций, а также обработка изменений walk-forward в синхронизации агрегатов.
- Валидация и качество данных. Планирование и выполнение reconciliation-тестов на регулярной основе, а также мониторинг задержек обновления агрегатов и их корреляции с основными источниками.
- Обеспечение наблюдаемости. Включение параметров мониторинга в логи выполнения ETL: время обновления, количество обновлённых строк, коэффициенты точности между базовыми данными и агрегатами.
- Интеграция с BI и консистентность контекстов. Политика по унимизации контекстов: какие фильтры применяются, как агрегаты совместимы с различными BI-инструментами и как обрабатываются пустые значения.
Пример типовой архитектуры:
- Базовые факты: фактSales (дата, регион, товар, количество, сумма).
- Измеряемые размерности: timeDim (day, month, quarter), regionDim, productDim.
- Агрегаты: mv_sales_day_region (день, регион, сумма), mv_sales_month_region (месяц, регион, сумма), mv_sales_day_product (день, продукт, сумма) и т. д.
- INTEGRATION: ETL-пайплайны заполняют MV из факт-таблицы в режиме incremental, применяя фильтры и поддерживая согласованность с временными измерениями.
- Технологии: PostgreSQL с поддержкой GROUPING SETS; для больших нагрузок - платформа ClickHouse или Apache Druid, где Roll-Up и агрегации часто реализуются через MV и упорядоченные таблицы на диск.
Практические правила внедрения:
- Начинайте с минимального набора агрегатов, затем расширяйте в зависимости от реального спроса аналитики.
- Поддерживайте двустороннюю прослеживаемость между базовой факт-таблицей и агрегатами: сопоставляйте поля, трактуйте значения и проверяйте согласованность.
- Используйте функции GROUPING() и GROUPING_ID() для интерпретации строк-«итогов» и корректного отображения контекста.
- Применяйте хранение версии измерений для SCD и корректной агрегации по временным этапам.
Реализация: архитектурные решения и кодовые примеры
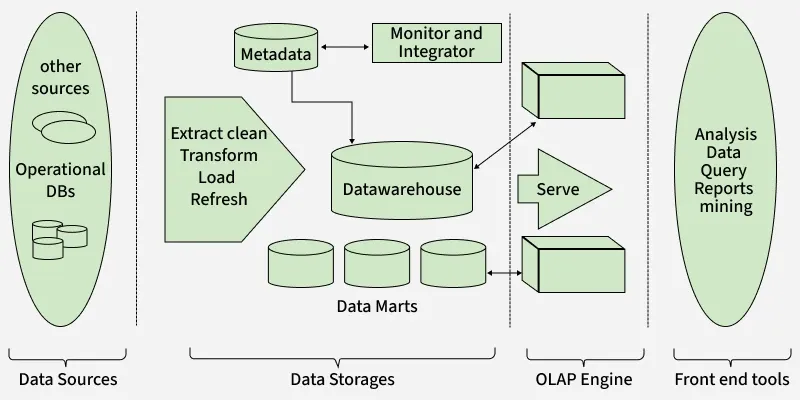
В реализации чаще всего встречаются два подхода: (1) матризованные представления непосредственно в СУБД, (2) использование современных OLAP-движков, ориентированных на агрегации и Roll-Up/D Drill-Down. Ниже приведены типовые примеры реализаций и соответствующие архитектурные решения.
- Архитектура на основе базового факта и MV. Базовый факт хранится в нормализованной форме, агрегаты - в материализованных представлениях, обновляемых по расписанию или по инкременту. Это обеспечивает быстрые сводки и уменьшает нагрузку на основную таблицу фактов.
- Архитектура с использованием движков OLAP или колонного хранения. Часто применяется в современных BI-платформах, где Roll-Up и Drill-Down поддерживаются «из коробки» и оптимизированы под временные ряды и агрегации. В таких системах агрегаты могут быть реализованы как pre-aggregates, достигая сниженной латентности запросов.
Пример SQL-реализации агрегаций на PostgreSQL ( Roll-Up и GROUPING SETS ):
-- Материализованный агрегат для дня и региона
CREATE MATERIALIZED VIEW mv_sales_day_region AS
SELECT
  DATE_TRUNC('day', sale_date) AS day,
  region,
  SUM(amount) AS total_amount,
  SUM(quantity) AS total_qty
## FROM fact_sales
GROUP BY DATE_TRUNC('day', sale_date), region;
-- Итоги по дням и регионам и сами по себе SELECT day, region, total_amount, total_qty FROM mv_sales_day_region ORDER BY day, region;
-- Расширенный Roll-Up/Drill-Down через GROUPING SETS
SELECT region, DATE_TRUNC('month', sale_date) AS month, SUM(amount) AS total_amount
FROM fact_sales
## GROUP BY GROUPING SETS (
  (region, DATE_TRUNC('month', sale_date)),
  (region),
  (DATE_TRUNC('month', sale_date)),
  ()
);
-- Пример использования GROUPING() для различения итогов
SELECT
region,
DATE_TRUNC('month', sale_date) AS month,
SUM(amount) AS total_amount,
## GROUPING(region) AS g_region,
GROUPING(DATE_TRUNC('month', sale_date)) AS g_month
FROM fact_sales
## GROUP BY GROUPING SETS (
(region, DATE_TRUNC('month', sale_date)),
(region),
(DATE_TRUNC('month', sale_date)),
()
);Практикуму стоит обратить внимание на возможности конкретной СУБД: PostgreSQL и Oracle поддерживают GROUPING SETS/CUBE/ROLLUP; в больших кластерах эффективнее применить специализированные движки вроде ClickHouse, Druid или Apache Pinot, где агрегации выполняются ближе к данным и обеспечивают высокую производительность по времени отклика.
Переход к реальной реализации требует также контроля над висящими зависимостями и управлением обновления агрегатов. В частности, нужно продумать регламент обновления MV: инкрементальные обновления, параллельные задачи и мониторинг завершения. Важно, чтобы новые данные в базовых таблицах автоматически отражались в агрегатах в рамках допустимой задержки обновления. Это уменьшает риск рассогласований между текущими данными и сводками.
Валидация и контроль качества агрегаций
Этап верификации агрегатов крайне важен для сохранения доверия к аналитике. Основные направления:
- Реконциляция агрегатов с базовой детализацией. Регулярно выполнять сравнение агрегатов с соответствующими итогами из базовой факт-таблицы. Используйте запросы типа EXCEPT или MINUS, чтобы выявлять расхождения.
- Проверка целостности и полноты. Сравнивайте число строк и общие суммы между базовой и агрегированной таблицей за заданный период.
- Тестирование на фильтры и контекст. Проверяйте, что Roll-Up и Drill-Down корректно отражают фильтры, применяемые BI-инструментами, не ломая контекст.
- Мониторинг латентности обновления. Отслеживайте время обновления MV и задержку между появлением нового факта и его отражением в агрегатах.
- Проверка точности для временных зерен. Убедитесь, что переходы между уровнями времени (день-месяц-год) корректны и не приводят к «срыву» итогов.
Примеры SQL-запросов для валидации:
-- Сравнение базовых и агрегированных сумм по день-регион
SELECT day, region, SUM(amount) AS base_total
FROM fact_sales
GROUP BY day, region
ORDER BY day, region;
-- Суммарная проверка на агрегаты
SELECT day, region, total_amount
FROM mv_sales_day_region
ORDER BY day, region;
-- Разница между базой и агрегатом
SELECT b.day, b.region, b_base.base_total, a.total_amount
## FROM (
  SELECT DATE_TRUNC('day', sale_date) AS day, region, SUM(amount) AS base_total
  FROM fact_sales
  GROUP BY day, region
) AS b_base
FULL OUTER JOIN mv_sales_day_region AS a
ON b_base.day = a.day AND b_base.region = a.region
WHERE b_base.base_total  a.total_amount OR a.total_amount IS NULL;
Ключ к устойчивости архитектуры - автоматизация регламентов тестирования и регламент обновления агрегатов. В целях контроля стоит внедрять регламент «перед релизом» и «регулярная проверка» на ежедневной/ночной пакетной обработке.
Key takeaways
- Roll-Up и Drill-Down представляют собой архитектурные приемы, а не самостоятельные данные; они требуют фиксированного зерна фактов и согласованных иерархий измерений.
- Тип агрегации меры определяет корректность её сводок. Additive-мера обычно безопасна для агрегирования; semi-additive и non-additive требуют дополнительных правил и структур.
- Типичные ошибки в Roll-Up/Drill-Down включают несогласованность грануляции, неверную фильтрацию, ошибки в обработке времени и некорректное обращение с NULL и изменяемыми измерениями. Эти ошибки приводят к ложной интерпретации бизнес-данных.
- Эффективная архитектура агрегатов требует сочетания базового факта и MV/агрегатов на соседних уровнях, управления версионностью измерений и четких протоколов обновления.
- Валидация агрегатов - обязательный элемент: reconciliation-тесты, контроль целостности и мониторинг задержек обновления.
- Тангенты реализации зависят от контекста: SQL-решения на уровне СУБД, использование MV, и применение движков OLAP/колонного хранения для больших объемов и высоких требования к быстродействию.
- Правильное проектирование и верификация агрегатов позволяют сохранить точность измерений в рамках Roll-Up и Drill-Down, минимизируя деградацию DWH.
FAQ
- Что такое Roll-Up и Drill-Down и как они отличаются по смыслу?
- Roll-Up - процесс перехода от детализированных измерений к более грубым уровням иерархии (например, день → месяц). Drill-Down - обратный процесс, переход к более детализированным уровням (месяц → день). Оба процесса важны для многоуровневой аналитики, однако требуют корректного поведения по времени и контексту.
- Какие типы агрегируемых мер встречаются чаще всего?
- Additive: выручка, количество продаж. Semi-additive: запас на конец периода. Non-additive: средний рейтинг, конверсия без веса. Каждая категория требует своей стратегии агрегации и проверки точности.
- Какие ошибки агрегации наиболее разрушительны для точности?
- Неправильный грануляционный слой, неверная фильтрация, некорректная агрегация по времени, дублирование строк, неправильное обращение с semi-additive и non-additive мерами, несоблюдение SCD и некорректная обработка NULL.
- Как выбрать набор агрегатов для конкретной доменной области?
- Начните с канонического зерна и основных бизнес-вопросов. Определите наиболее востребованные уровни агрегации, оцените влияние на производительность и точность, затем реализуйте минимальный набор MV и расширяйте его по мере возникновения спроса.
- Как отличить истинную точность агрегатов от ложных итогов?
- Проводите регулярную reconciliation-проверку между базовой факт-таблицей и агрегатами, смотрите на расхождения в суммах и строках, учитывайте контекст фильтров и временные рамки.
- Как обеспечить корректность Drill-Down при изменении размерностей?
- Используйте версионирование измерений (SCD), сохраняя историю изменений, и избегайте «склеивания» разных версий в одну точку сводки. Контекстный фильтр должен сохранять последовательность переходов на более детальные уровни.
- Какие технологии помогают в реализации Roll-Up и Drill-Down?
- Реляционные СУБД с поддержкой GROUPING SETS (PostgreSQL, Oracle), MV в СУБД, и специализированные колоночные движки/OLAP-решения (например, ClickHouse, Apache Druid). В рамках российского рынка можно обратить внимание на решения с открытым кодом и локальными сервисами, поддерживающими интеграцию с BI-платформами.
- Какую роль играет валидация агрегатов в процессе трансформации данных?
- Валидация - критичный элемент, который обеспечивает доверие к аналитике. Без регулярной проверки агрегаты могут постепенно расходиться с реальными значениями, что приводит к неправильным бизнес-решениям.
- Что учитывать при миграции к новой архитектуре агрегатов?
- Необходимо планировать миграцию с минимальным временем простоя, учитывать совместимость схем и совместное использование существующих ML/BI пайплайнов, а также предусмотреть откат и тестовую среду.
- Как оперативно реагировать на деградацию точности агрегатов?
- Нормативная процедура: зафиксируйте симптомы, выполните reconciliation, определите причину (плотность данных, изменение зерна, обновление MV), исправьте конфигурацию Aggregation Layer и повторно запустите тесты на соответствие. После подтверждения в продакшене можно отключить устаревшие агрегаты и включить обновления.


