

Платформы и инструменты: выбор технологий под гранулярность
Гранулярность фактов - краеугольный параметр аналитической архитектуры. Неправильный выбор технологий под задачу доносить факты нужной детализации приводит к усложнению моделей, усложнению поддержки данных и, как следствие, к искажению бизнес-решений. В этой главе приводится системный подход к выбору платформ и инструментов, который позволяет сохранить бизнес-смысл данных, обеспечить необходимую гибкость и при этом удержать эксплуатационные риски в пределах управляемых границ.
Гранулярность нельзя рассматривать как чисто технический параметр. Она диктует требования к схеме данных, к времени и порядку упорядочивания событий, к способам агрегации и к механизмам обеспечения согласованности. Правильно спроектированная платформа позволяет «взращивать» факты различной детализации: от детализированных репрезентаций событий до агрегированных измерений, необходимых для оперативной аналитики. При этом важны и принципы проектирования: модульность архитектуры, контрактность между компонентами, предсказуемость поведения систем в условиях роста объема данных и изменений бизнес-процессов.
Ниже предложена структурированная дорога от концепций к реализации, с акцентом на архитектурные решения, схемы данных, протоколы интеграции и практики управления изменениями. В качестве основного набора технологических кирпичиков используются проверенные решения на стеке больших данных: потоковая обработка, хранение версионируемых таблиц и гарантии целостности данных. Примеры материалов сосредоточены на открытом и широко применяемом ПО, с ограниченным набором российских или open-source альтернатив для иллюстрации реальных сценариев.
- кратко о структуре главы:
- как понять, какие факты и на каком уровне детализации нужны бизнесу;
- какие архитектурные паттерны поддерживают разные режимы гранулярности;
- какие технологии следует рассмотреть для ingestion, хранения, вычислений и метаданных;
- как организовать миграцию и эволюцию схем без разрушения аналитики;
- как оценивать надежность, безопасность и управляемость платформы.
Краткое содержание главы
- Определение гранулярности фактов и связь с бизнес-потребностями, time semantics и согласованностью данных.
- Архитектурные паттерны и их влияние на производительность, масштабируемость и управляемость.
- Выбор технологий под гранулярность: протоколы схем, потоковая инфраструктура, таблицы и хранение.
- Практики интеграции, миграции и эволюции схем без потери совместимости.
- Управление рисками, качеством данных и операционной эффективностью платформы.
Концептуальная база: гранулярность, время и бизнес-смысл
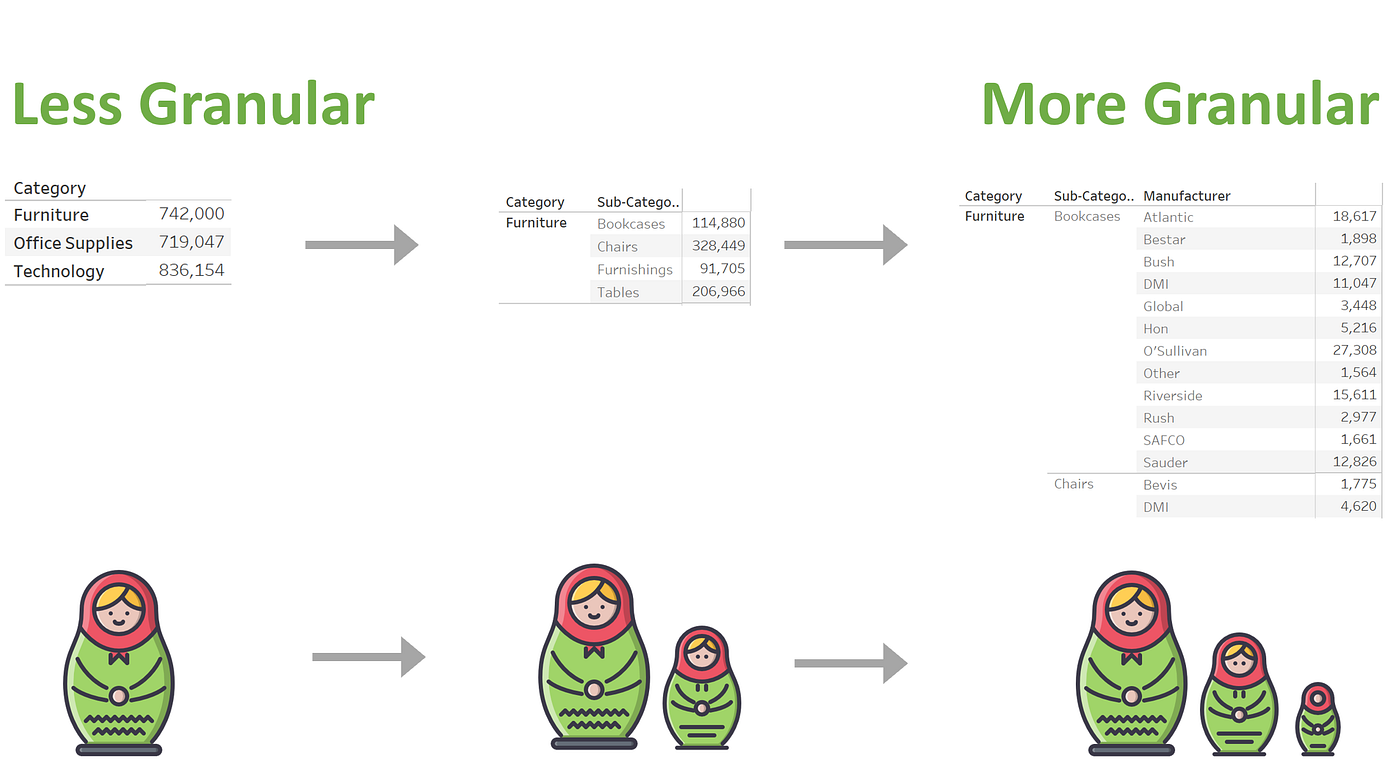
Гранулярность фактов задаёт, на каком уровне детализации сохраняются данные и как они используются downstream. В рамках бизнес-аналитики это означает различение между событиями на уровне отдельных транзакций, минутными/часовыми агрегациями и более крупными измерениями. Выбор уровня детализации должен опираться на задачи бизнеса: какие вопросы должны быть разрезаны именно на этом уровне, какие отклонения и аномалии должны быть видны, и каким образом данные будут использоваться в отчетности и моделировании.
-
Временная гранулярность и семантика времени. Важна не только частота обновлений, но и логика времени: event time, processing time, ingestion time. Event time отражает момент наступления события в реальном мире и критичен для анализа последовательностей и задержек. Processing time упрощает расчеты в реальном времени, но может вводить искажения при задержках. Ingestion time фиксирует момент попадания данных в систему. Разные сценарии требуют разных подходов: для кросс-системной аналитики предпочтительно event time, для мониторинга в реальном времени - processing time.
-
Факты и измерения. В бизнес-метриках важно различать факты, которые являются конкретными значениями измерений на уровне событий, и измерения-агрегаты, которые нужны для быстрого просмотра картины состояния. Модель данных должна поддерживать как детальную логику (детальные факты), так и управляемые агрегаты (курируемые наборы фактов). Это обеспечивает возможность повторной детализации без перерасчета всей истории и снижает риск потери альтернативных линий анализа.
-
Контракты и эволюция схем. Любая платформа под гранулярность должна поддерживать договоры между производителями данных и потребителями: форматы, совместимость, версионирование. Использование схем и механизмов совместимости позволяет эволюционировать структуру данных, не ломая существующие потребления. В спортивной форме это означает прозрачную схему API и версионирование контрактов, чтобы downstream-процессы могли стабильно продолжать работу во время миграций.
-
Роль хранилищ и форматов. Для детальных фактов и частых агрегаций применяются колоночные форматы (Parquet, ORC) в сочетании с версиями таблиц и метаданными уровня Iceberg/Hudi. Это обеспечивает эффективное чтение и масштабируемость, а также возможность времени путешествий по истории данных. Подобный подход позволяет строить материализованные представления и эффективные кэш-слои без дублирования данных.
-
Примерные принципы проектирования. Начните с бизнес-задания - какой вопрос должен быть ответить на уровне гранулярности. Определите набор ключевых аспектов: событие или серия событий, уникальные идентификаторы, временная метка, величины измерений, требования к задержкам и точности. Затем спроектируйте схему и архитектурную карту, которая позволяет в дальнейшем расширять гранулярность без кардинальных переработок.
Временная семантика и согласованность
-
Согласованность на уровне фактов должна соответствовать потребностям аналитики. Для оперативной аналитики часто достаточно «персистентной» версии данных с поддержкой идемпотентности и(level) Exactly-Once semantics в конвейерах. Для истории и ретроспективных исследований следует сохранить полную неизменяемость фактов до момента, когда бизнес решит переупорядочить агрегаты.
-
Гранулярность не должна диктовать хаос. Разделение по доменным областям и ясная политика по обработке времени позволяют снизить сложности при масштабировании. Принципы такие же, как и в любой архитектуре данных: четкие границы ответственности, минимальные зависимости и прозрачная эволюция.
Архитектурные паттерны под гранулярность
Архитектура определяется тем, какие вопросы должен решать сервис и какие требования к задержке, согласованности и масштабу она удовлетворяет. Ниже рассмотрены ключевые паттерны, применимые к задачам гранулярности фактов.
-
Единый потоковой конвейер (unified streaming). В основе лежит единый источник правды для событий, непрерывный поток данных и целостная обработка с минимальной задержкой. Такой подход хорошо подходит для детальных фактов и быстрых агрегатов, когда требуется единая модель данных и единая спецификация времени. Он упрощает архитектуру за счёт единого механизма ingestion и единого слоя вычислений.
-
Lambda и альтернатива ей (постановочная и редакционная). Традиционная двойная архитектура разделяет потоковую обработку и пакетную обработку: слой реального времени для детальной информации и слой батч-агрегатов для устойчивой аналитики. Хотя такая архитектура часто обеспечивает гибкость, она приводит к дублированию логики и сложной синхронизации. В современных реализациях целевой фокус смещается в пользу унифицированного подхода, где один конвейер поддерживает и детальные, и агрегированные запросы через продуманные окна и материализованные представления.
-
Паттерн «управляемого времени» и таблиц Iceberg. Таблицы, поддерживающие версионирование и временные путешествия, позволяют сохранять детализированные факты и быстро восстанавливать любые исторические состояния. В таких случаях архитектура построена вокруг связанных слоев: ingestion → storage → compute → query. Важно обеспечить стратегию partitioning и prune-поиск по времени и granularity, чтобы не перегружать кластер.
-
Выбор между схованием времени на уровне события и вычислительными окнами. В_STREAM-ориентированных схемах часто применяют временные окна (tumbling, sliding) для расчета агрегатов, что обеспечивает точные и повторяемые результаты. Эффективная реализация требует корректной обработки задержек и задержек в источниках, а также уверенности в точной идентификации событий.
-
Кросс-системная интеграция и контрактность. Независимо от выбранной модели, реализация должна поддерживать строгие контракты между источниками данных и потребителями. Это включает в себя совместимость форматов, единство идентификаторов, единый подход к обработке ошибок и дедупликации. Контракты позволяют добавлять новые источники без разрушения существующей аналитики.
Инструменты и протоколы: выбор технологий под гранулярность
Для технического профиля и целей этой главы ключевые технологические блоки включают потоковую инфраструктуру, хранение и управление схемами, а также средства управления метаданными. В рамках открытого стека основными паттернами являются потоковая обработка и версионированные таблицы.
-
Потоковая инфраструктура и протоколы обмена данными. В качестве основы часто выбирают удобную для высокой скорости и надёжности связку: брокер сообщений и обработчик потоков. Например, Apache Kafka обеспечивает устойчивую доставку, упорядочение и возможность transactional writes, что критично для поддержания Exactly-Once semantics на уровне фактов. Протоколы сериализации, такие как Avro или Protobuf, вместе с схемо‑регистром позволяют эволюцию контрактов без разрушения downstream-потребителей. В рамках данного раздела акцент делается на совместимость и контрактность: как новые поля добавлять безопасно и как сохранять обратную совместимость.
-
Хранилища и структура таблиц. Версионируемые таблицы на основе Iceberg позволяют строить детальные факты и агрегаты в одном репозитории, поддерживая временные путешествия, актуальные и исторические снимки. Это критично для сохранения целостности данных при изменениях бизнес-логики и границ гранулярности. Iceberg обеспечивает эффективную фильтрацию по времени и гранулярности через её схему и метаданные, что упрощает задачи анализа и бизнес‑отчетности. В качестве альтернатив можно рассмотреть Hudi или Delta Lake, однако для целей данной главы фокус остается на Iceberg как базовом примере.
-
Оркестрация и метаданные. Для сложных конвейеров требуется управление зависимостями и качеством данных на уровне контрактов. Инструменты оркестрации (например, Airflow, Dagster) помогают координировать задачи по ingestion, трансформации и публикации агрегатов. Уровень метаданных, в свою очередь, обеспечивает поиск, lineage и контроль качества. В этом контексте разумно держать в фокусе сочетание схемы и метаданных: схемы, версии, зависимости потребителей и политика эволюции.
-
Пример технологического набора. В рамках одного типового технического стека подглад (гранулярность) часто применяют:
- Kafka как backbone для событий;
- Avro как формат сериализации с схемо‑регистром для поддержки эволюции;
- Iceberg как таблицу для хранения детальных фактов и агрегатов;
- Star-или тандемные слои вычислений на базе Spark/Flink для обработки и формирования материализованных представлений;
- Ядро OLAP-службы (например, Trino/Presto) для интерактивной аналитики над Iceberg.
-
Пример конфигурации и контрактов. Ниже приводится небольшой пример контракта и DDL для Iceberg‑таблицы. Он иллюстрирует идею версионируемых схем и поддержки гранулярности без разрушения downstream-потребителей.
-- Контракт: базовый факт
{
  "title": "EventFact",
  "type": "object",
  "properties": {
    "event_id": {"type": "string"},
    "event_time": {"type": "string", "format": "date-time"},
    "granularity": {"type": "string", "enum": ["event", "minute", "hour", "day"]},
    "subject_id": {"type": "string"},
    "metric": {"type": "string"},
    "value": {"type": "number"}
  },
  "required": ["event_id","event_time","granularity","subject_id","metric","value"]
}
-- DDL Iceberg-представления (пример) CREATE TABLE facts.det_fact ( event_time TIMESTAMP(3), granularity STRING, subject_id STRING, metric STRING, value BIGINT ) ## USING ICEBERG PARTITIONED BY (granularity, CAST(event_time AS DATE)) COMMENT 'Детальные факты с поддержкой аналогичных агрегатов'
-
Взаимосвязь паттернов и бизнес-задач. Выбор технологий под гранулярность должен учитывать не только текущую потребность, но и перспективы эволюции: возможно, в будущем потребуется добавление новых грануляций или качественная переработка архетипов данных. В этом смысле Iceberg и Kafka создают гибкую базу для адаптации, а схема и контрактность - инструменты для контроля этой эволюции.
Интеграция и миграции под гранулярность
Миграции схем и эволюция грануляций требуют дисциплины. Основной подход - минимизация риска через поэтапную реализацию, тестирование и обратную совместимость.
-
Data contracts и версионирование. Имеет смысл внедрить версионирование схем на уровне схемо‑регистратора и поддерживать параллельную работу нескольких версий контрактов. Так downstream‑потребители могут обновляться постепенно, без остановки конвейеров.
-
Эволюция схем и обратная совместимость. При добавлении новых полей в контракте следует использовать безопасные схемы (например, полю можно дать дефолтное значение, старые потребители игнорируют новые поля). Удаление полей должно происходить после уведомления потребителей и фиксации календарной граничной даты.
-
Тестирование и валидация. Включайте тесты на совместимость между версиями контрактов, тестируйте схему на миграционные сценарии, создавайте тестовые окружения, симулирующие реальный поток событий. Валидации должны включать дедупликацию, корректность временных окон и точность агрегаций.
-
Миграции на Iceberg. В Iceberg миграции чаще всего касаются изменений схем и метаданных таблиц. При необходимости добавляйте новые колонки, не ломая существующие запросы, и используйте схемы миграций в виде версии таблиц. Разделение на детальные и агрегированные слои упрощает управляемость изменений.
-
Примеры практических миграционных сценариев. Один из частых сценариев - внедрение новой грануляции параллельно с существующей. Это достигается путем создания новых таблиц под новую грануляцию, одновременного источника данных, и постепенным перенаправлением downstream-потребителей через обновления конвейеров и обновления контрактов. Такой подход позволяет минимизировать риск потери данных и задержек.
Риски, безопасность и эксплуатация
Гранулярность и связанная инфраструктура создают набор рисков, которые необходимо мониторить системно.
-
Риск задержек и деградации производительности. Высокая детализация требует больших объемов данных и более частых вычислений. Для снижения нагрузки применяют стратегическое разнесение конвейера, кэширование, а также эффективное использование окон и материализованных представлений.
-
Риск неконсистентности и дубликатов. При CDC, параллельной записи и асинхронной обработке возрастает вероятность дубликатов и несогласованности. Важно проектировать idempotent‑порождающие паттерны, детектировать дубликаты на уровне конвейера и реализовывать механизм мягкого устранения конфликтов.
-
Безопасность и доступ. Гранулярный уровень данных часто подразумевает чувствительную информацию. Вводятся строгие политики доступа (ABAC/RBAC), шифрование на уровне хранения, аудит доступа и управляемые ключи. Механизмы контроля доступа должны быть встроены в каждый слой: ingestion, storage, вычисления и запросы.
-
Управляемость и операционные издержки. Включайте в архитектуру мониторинг задержек на каждом этапе, показатели качества данных (DQ metrics), lineage и агрегацию метаданных. Наличие четких SLA по latency и точности критично для бизнес‑ориентированной аналитики.
-
Масштабирование и эволюция. По мере роста данных способность сервиса адаптироваться к новым грануляциям становится ключевой. Архитектура должна поддерживать горизонтальное масштабирование и минимальные перерывы в работе во время миграций.
Key takeaways
- Гранулярность фактов должна определяться бизнес-целями и временной семантикой; архитектура строится вокруг этой логики.
- Унифицированный потоковый конвейер с контрактами между источниками и потребителями облегчает масштабирование и эволюцию.
- Iceberg обеспечивает версионируемые таблицы и эффективное управление данными под разную гранулярность.
- Контракты, версия схем и тестирование совместимости критичны для безопасной миграции и эволюции данных.
- Принципы Exactly-Once и дедупликации в конвейерах снижают риск ошибок и обеспечивают доверие к аналитике.
- Выбор технологий должен учитывать баланс между гибкостью, производительностью и эксплуатационными издержками.
- Архитектура должна поддерживать не только детальные факты, но и устойчивые агрегаты без двойной работы и дублирования логики.
FAQ
- Что такое гранулярность фактов и зачем она нужна в аналитике?
Гранулярность фактов - это уровень детализации данных, на котором фиксируются события и измерения. Она определяет, какие вопросы можно эффективно отвечать: от детальных реконструкций действий пользователя до высокоуровневых показателей. Неправильная гранулярность ведет к избыточному объему данных, сложной поддержке и трудностям в получении точных бизнес‑ответов. Правильный выбор требует балансирования между требованиями скорости, точности, объема хранения и удобством анализа.
- Какие архитектурные паттерны наиболее эффективны при работе с высокой гранулярностью?
Наиболее эффективны унифицированные потоковые конвейеры, где один источник данных обслуживает детальные факты и агрегаты через концепции окон и материалов. Lambda‑архитектура устаревает в пользу унифицированной реализации, которая объединяет обработку в один конвейер и использует временные окна и материализованные представления. Для сохранения истории применяют версионируемые таблицы, такие как Iceberg, что упрощает управление временем и грануляциями без разрушения текущих потребителей.
- Какие технологии стоит включить в стек под гранулярность и почему?
Ключевые компоненты: (1) потоковая платформа и протокол сериализации - Kafka с Avro/Protobuf и схемо‑регистром для контрактной эволюции; (2) хранилище с поддержкой версионирования - Iceberg для детальных фактов и агрегатов; (3) вычислительные движки - Flink или Spark для реального времени и батч‑обработки; (4) OLAP‑слой для интерактивной аналитики - можно рассмотреть Trino/Presto или аналог. Такой набор обеспечивает эволюцию потребностей, поддерживает целостность данных и обеспечивает гибкость в отношении грануляций.
- Как обеспечить эволюцию схем без разрушения потребителей?
Используйте контрактность схем и версионирование. Позвольте downstream-потребителям выбирать между версиями схем и внедрять новые поля постепенно. Применяйте дефолтные значения для новых полей, поддерживайте обратную совместимость и планируйте миграцию через параллельную работу новых и старых версий. Регулярно выполняйте тесты совместимости и мониторинг линейности изменений.
- Какие механизмы обеспечивают точность и целостность данных в потоках?
Ключевые техники - дедупликация на уровне конвейера, транзакционные записи Kafka, обработка ошибок и повторные попытки. Exactly-Once semantics достигаются за счёт координации между источниками, брокером и конвейером обработки. В Flink и Kafka можно реализовать безопасные транзакции и структурированную обработку событий, что минимизирует дублирование и рассогласование.
- Какие риски связаны с грануляцией и как их минимизировать?
Риски включают задержку, деградацию производительности при росте объема, несогласованность схем и потерю исторических данных при неправильной миграции. Минимизировать можно через прогнозирование нагрузки, планирование миграций на этапе низкой активности, четкое разделение ответственности и наличие rollback‑планов. Важно постоянно отслеживать качество данных, полноту покрытий и lineage.
- Как начать внедрять архитектуру под гранулярность в существующей организации?
Начните с бизнес‑постановки: какие вопросы требуют детальности, какие агрегаты достаточно видеть через определенный срок. Затем выберите базовый технологический набор (Kafka + Iceberg) и реализуйте минимальный конвейер для детальных фактов с версионируемыми схемами. Постепенно добавляйте новые грануляции через новые таблицы и обновления контрактов, параллельно обучая команду управлению данными и мониторингу.
- Какие метрики стоит использовать для оценки платформы под гранулярность?
Список ключевых метрик: задержка до ответа по детальным фактам, задержка в обновлениях агрегатов, процент точных агрегаций, доля дубликатов, время миграций схем, стабильность lineage и покрытие требований по SLA. Важно внедритьDQ‑метрики и мониторинг изменений схем, чтобы быстро выявлять несоответствия и дефекты.
- Как согласовать требования бизнеса и технические ограничения?
Развивайте процесс совместного определения метрик гранулярности: бизнес‑пользователи формируют question lists, техноры - constraints и возможности стека. Вопросы о задержках, необходимости обратной совместимости и скорости обновления должны быть заранее зафиксированы в архитектурном плане. Регулярные обзоры архитектуры и демо‑показы бизнес‑пользователям помогают держать баланс между возможностями и потребностями.
- Какие шаги предпринять для миграции в рамках реального проекта?
Определите базовую гранулярность и сформируйте контракт на детализацию; 2) Разработайте Iceberg‑таблицу и конвейер ingestion; 3) Введите версионирование схем и проведите тестирование совместимости; 4) Постепенно внедряйте новую грануляцию через параллельные конвейеры; 5) Сведите к минимуму периоды простоя, планируйте rollback‑меры; 6) Мониторьте метрики и корректируйте стратегию по мере накопления опыта.**


