

Обеспечение отказоустойчивости и аварийного восстановления: репликация и failover
В условиях больших объемов данных и высоких требований к задержкам аналитики обеспечение отказоустойчивости становится критическим элементом архитектуры кластера Doris. Эффективная репликация и управляемый failover позволяют поддерживать доступностьOLAP-платформы, минимизировать потери данных и сокращать время простоя даже при сбоях узлов, сетевых сегментах или программного обеспечения. В данной главе рассмотрены архитектурные принципы репликации в Doris, механизмы аварийного восстановления и практики эксплуатации, которые позволяют инженерам по данным планировать, внедрять и тестировать устойчивые к сбоям решения.
Ключевая цель главы - перейти от общих концепций к реализации в рамках типовых сценариев эксплуатации Doris: как распределяются реплики планшетов, какие сигналы мониторинга отражают состояние кластера, какие процессы разворачиваются при сбоях, и какие практики похода к DR (disaster recovery) обеспечивают минимальные времена простоя и безопасную миграцию активных рабочих нагрузок.
- кратко охватываются архитектурные аспекты репликации и failover;
- описываются механизмы поддержания консистентности и восстановления данных;
- приводятся практики мониторинга, тестирования и эксплуатации;
- предложены сценарии внедрения и рекомендации по уменьшению риска потери данных и задержек.
Краткое содержание главы
- Архитектура репликации в Apache Doris: роли реплик, размещение данных, консистентность и координация.
- Обеспечение отказоустойчивости FE и BE: механизмы HA, мониторинг статусов и процедуры переключения.
- Модели консистентности и обмен данными: синхронная и асинхронная репликация, правила подтверждения записей.
- Восстановление после сбоев и поддержание требуемого уровня репликации: обнаружение, ребалансировка и догонка lag.
- Мониторинг и диагностика: метрики, dashboards, предупреждения и ежедневные операции.
- Практики эксплуатации и тестирования DR: резервирование, планирование, регулярные тестирования аварийных сценариев.
- Индустриальные кейсы и интеграции: роль ZooKeeper и вариантов развёртывания HA в рамках архитектуры Doris.
Архитектура репликации в Apache Doris
Репликация в Doris организована на уровне Tablet - логических единиц данных, принадлежащих конкретной таблице, распределяемых по множеству Backend-узлов кластера. Каждый планшет имеет несколько реплик, размещённых на различных узлах и, по возможности, в разных стойках (rack awareness) для минимизации воздействия одиночной точки отказа. Репликация обеспечивает две ключевые цели: сохранение доступности данных при сбоях и увеличение пропускной способности чтения за счёт параллельного считывания с нескольких реплик.
Факт размещения реплик конфигурируется на уровне таблицы или партиции и определяет требуемый уровень отказоустойчивости. В практике эксплуатации это означает баланс между требованиями к коррекции ошибок, задержками и затратами на хранение. Репликационная логика в Doris опирается на координацию между Frontend-узлами и Backend-узлами: FE выполняет роль коордантора запросов и хранит метаданные о схеме, размещении планшетов и состоянии реплик, тогда как BE отвечает за фактическую хранение данных и обработку запросов на чтение и запись.
Важно понимать, что репликация не сводится к простому дублированию файлов: Doris поддерживает контроль целостности версий и согласование изменений между репликами. В процессе записи координационный механизм выбирает набор реплик, которые участвуют во временнОй период синхронной фиксации, и ожидает подтверждений, прежде чем считаем запись успешно завершённой. Это обеспечивает более высокую устойчивость к сбоям, чем чисто асинхронные подходы, и снижает риск расхождений между репликами.
С точки зрения инфраструктуры ключевые элементы архитектуры репликации включают:
- распределение планшетов по BE-узлам с учётом отказоустойчивости и баланса нагрузки;
- механизм координации, отвечающий за выбор реплик для записи и согласование изменений;
- процессы репликации, которые автоматически догоняют lag между репликами и поддерживают требуемый уровень репликации;
- мониторинг состояния реплик и автоматическое реагирование на недоступность реплик или узлов.
Поскольку Doris широко применяется в аналитических нагрузках, характеристики репликации должны отражать требования к задержкам, параллелизму и возможности быстрого восстановления. Это подразумевает продуманное размещение реплик в кластере, стратегию ведения журнала изменений и эффективную работу механизмов догоняния данных.
Механизмы обеспечения отказоустойчивости FE и BE
Высокая доступность кластера требует комплексного подхода к фронтенд-серверной части (FE) и бекенд-серверам (BE).
-
Frontend (FE)
FE обеспечивает управление схемами, метаданными и маршрутизацию запросов. В рамках отказоустойчивости FE может быть реализована архитектура HA с использованием активного и резервного экземпляров (active/standby). Основные принципы включают:- многократное дублирование FE-узлов и автоматическое переключение в случае сбоя;
- хранение критичных метаданных в централизованном хранилище, например, через решение на базе ZooKeeper, что позволяет восстанавливать состояние кластера после потери одного FE;
- детектирование неполадок и протоколы обновления конфигураций без потери доступности. Важной задачей является обеспечение согласованности конфигураций между активным и резервным FE и корректная миграция ролей.
-
Backend (BE)
BE отвечает за хранение данных и выполнение вычислительных операций над ними. Отказоустойчивость BE достигается за счет:- репликации планшетов на нескольких BE-узлах, чтобы при выходе одного узла из строя данные оставались доступными на других местах;
- механизмов «догоняемости» (catch-up) и«догоняющей репликации» (backfill) для восполнения lag и доведения новой реплики до состояния конкурирующих;
- автоматизированной переконфигурации после сбоев, которая переназначает роли и перераспределяет планшеты, чтобы сохранить требуемый уровень репликации;
- мониторинга состояния дисков, памяти, нагрузки на processo и сетевых параметров, чтобы предотвратить проблемы на ранних стадиях.
Эти механизмы взаимодополняют друг друга и позволяют автоматически восстанавливать функционирование кластера после сбоев оборудования или сетевых проблем без вмешательства оператора. В практике Hoodie/HA для FE обычно реализуются механизмы быстрого переключения и синхронизации конфигураций, тогда как BE полагается на внутреннюю репликацию и перераспределение планшетов по мере необходимости.
Модели консистентности и порядок обновления
Работа с репликациями подразумевает выбор модели консистентности и механизмов синхронизации. В Doris принципы обычно ориентируются на обеспечение корректного чтения и минимизацию задержек обновлений, с учётом специфики аналитических нагрузок.
-
Консистентность чтения. В типичных сценариях Doris стремится к читаемость актуальных данных и использованию доступной реплики для запроса. Это обеспечивает низкую задержку чтения, особенно при большом объеме параллельных запросов. В то же время разреженная синхронность может приводить к появлению «устаревших» результатов на репликах, если запрос выполнен до завершения синхронной фиксации изменений на всех необходимых репликах. В реальных условиях это компенсируется стратегией выбора реплик и журналированием изменений.
-
Консистентность записей. Для забезпечения целостности данных Doris применяет принцип схожий с консенсусом на уровне планшетов: запись считается успешно зафиксированной после достижения согласованности между несколькими репликами. В зависимости от конфигурации таблицы и класса нагрузки может применяться различная схему подтверждений, чтобы балансировать между SLA по задержке и уровнем защиты от потери данных. Для аналитических сценариев характерна возможность «мягкого» задерживания обновлений для достижения устойчивой записи лога изменений и стабильной репликации без заметного ухудшения задержек чтения.
-
Варианты репликации. Репликация может быть настроена как статически заданная (фиксированное количество реплик на планшет) или динамически адаптируемая в случае перераспределения нагрузки или восстановления после сбоя. В большинстве сценариев оптимальная конфигурация подбирается исходя из требований к отказоустойчивости и доступности, а также географического размещения узлов.
-
Координация и согласование. В Doris координация между репликами обычно осуществляется через FE, который получает состояние узлов и решает, какие реплики должны участвовать в обновлениях. Важно обеспечить минимальные задержки между координационным планированием и физическим размещением реплик, чтобы не возникало узких мест в обработке запросов.
Эти принципы важны для проектирования устойчивых решений, поскольку они прямо влияют на задержки, пропускную способность и вероятность потери данных. Правильная настройка консистентности требует согласования между архитекторами данных и администраторами кластера, чтобы обеспечить баланс между SLA и рисками.
Восстановление после сбоев и поддержание уровня репликации
Сбои в кластере Doris могут происходить по множеству причин: аппаратная поломка, перегрев, перегрузка дисков, сетевые разрывы, сбой программного обеспечения. Эффективное восстановление включает несколько последовательных этапов.
-
Обнаружение и детекция. Важна ранняя идентификация проблемы: FE и BE регулярно обмениваются статусами, и при отсутствии ответов либо при аномально низких показателях (например, задержки репликации, неразрешенные блокировки) система помечает узлы как «недоступные» и инициирует перераспределение нагрузки.
-
Преобразование кластера. При выявлении недоступности узла, система автоматически перераспределяет планшеты на доступные BE-узлы, чтобы сохранить необходимый уровень репликации. В случае недостачи реплик система подбирает новые узлы для догонкой реплик, чтобы восстановить требуемое количество копий.
-
Backfill и догонка. Новый узел получает данные, которые он должен содержать, и начинает догонять состояние реплик. Этот процесс может временно увеличить сетевую нагрузку, и для минимизации влияния на рабочие нагрузки применяется регулируемая скорость догоняющей репликации.
-
Ребалансировка. После восстановления устраняются перегрузки и перекладываются планшеты для достижения равномерного распределения и устойчивости к повторным сбоям. В идеальном случае перераспределение должно быть незаметно для пользователей и не влиять на текущие запросы.
-
Защита от повторных сбоев. При повторных сбоях система должна быстро адаптироваться, восстанавливая состояние реплик и минимизируя простой. В реальных условиях это требует хорошо настроенного мониторинга, журналирования изменений и тестирования сценариев аварийного восстановления.
Ключевые принципы восстановления - минимизация временных задержек простоя, сохранение целостности данных и оперативное возвращение к нормальной работе кластера. Эффективное восстановление требует предсказуемых политик перераспределения реплик и мониторинга состояния реплик в режиме реального времени.
Мониторинг, инструменты и сигналы тревоги
Мониторинг репликации и отказоустойчивости включает сбор метрик на всех уровнях стеки Doris: FE, BE, сеть, дисковое пространство, задержки репликации, статус реплик и трафик. Эффективная мониторинговая инфраструктура позволяет оперативно выявлять проблемы и принимать решения об устранении причин.
-
Метрики репликации. Необходимо отслеживать количество реплик на планшете, долю «недостающих» реплик, лаг между ведущими и отстающими репликами, скорость догонки и время ожидания в очередях обновления. Наличие большого количества «under-replicated» планшетов служит ранним сигналом к вмешательству.
-
Здоровье узлов. Включает мониторинг статусов FE и BE, загрузку CPU, потребление памяти, IOPS, использование дискового пространства и сетевой латентности. В случае перегрузок или перегрева системы существуют механизмы динамического отклонения нагрузки и перераспределения планшетов.
-
Журналы событий. Важно сохранять запись о переключениях ролей, перераспределении планшетов, смене лидеров и причинах сбоев. Эти данные необходимы для аудита операций и для последующей диагностики.
-
Интеграции с инструментами. Практически стандартной является интеграция с Prometheus и Grafana для визуализации и alerting. В крупных кластерах применяются цепочки уведомлений через PagerDuty или Opsgenie для оперативного реагирования на критические инциденты. В контексте HA Doris может использоваться также централизованное хранилище конфигураций и событий, работающее на базе ZooKeeper или решений с подобной функциональностью.
-
Географическая устойчивость. Мониторинг должен учитывать географическое распределение узлов, чтобы обнаруживать региональные проблемы и инициировать DR-операции, когда это требуется. В таком случае мониторинг становится не только техническим инструментом, но и драйвером бизнес-контрольных решений.
Эффективные практики мониторинга требуют стандартных конфигураций и автоматизированной реакции на сигналы тревоги. Это позволяет минимизировать человеческий фактор и сокращает время реакции на инциденты.
Практики эксплуатации и тестирования DR
DR-готовность требует систематического подхода, включающего планирование, регулярное тестирование и документированные процедуры. В рамках Doris, на практике следует рассмотреть следующие аспекты:
-
Резервирование и географическое разделение. Желательно иметь резервы реплик в разных дата-центрах или регионах. Это обеспечивает защиту от единого местоположения и позволяет продолжать работу после регионального сбоя.
-
Роль ZooKeeper и инфраструктура HA. Для координации и согласованности критичных компонентов применяются решения наподобие ZooKeeper, которые обеспечивают устойчивость к сбоям конфигураций. Это требует правильной настройки топологий, сессий и времени ожидания сбоев.
-
Планирование тестирования DR. Регулярно проводятся тесты аварийного переключения, чтобы проверить политику переключения FE, а также перераспределение планшетов и догонку реплик. Такой тест позволяет выявлять узкие места и улучшать сценарии восстановления.
-
Планирование резервного копирования. В контексте Doris важна не только репликация, но и план резервного копирования критических данных и архитектурных конфигураций. Резервное копирование должно охватывать как данные, так и метаданные, гарантируя возможность полной реставрации кластера в случае катастрофы.
-
Управление изменениями. Внедрение новых конфигураций и обновлений должно сопровождаться тестированием на стендах DR, чтобы минимизировать риск нестабильности в продакшене. Регламент изменения должен предусматривать автоматизированные процедуры валидации.
-
Оценка рисков и KPI. Эффективность DR оценивается через целевые показатели доступности (SLA) и среднее время для восстановления (RTO) и утраты данных (RPO). Установка конкретных KPI позволяет точно измерять прогресс и корректировать стратегию.
Эти практики в сочетании с корректной архитектурой обеспечивают устойчивость к сбоям и снижают влияние инцидентов на бизнес-процессы. Важно подходить к DR как к встроенной части жизненного цикла кластера Doris, а не как к отдельной инициативе.
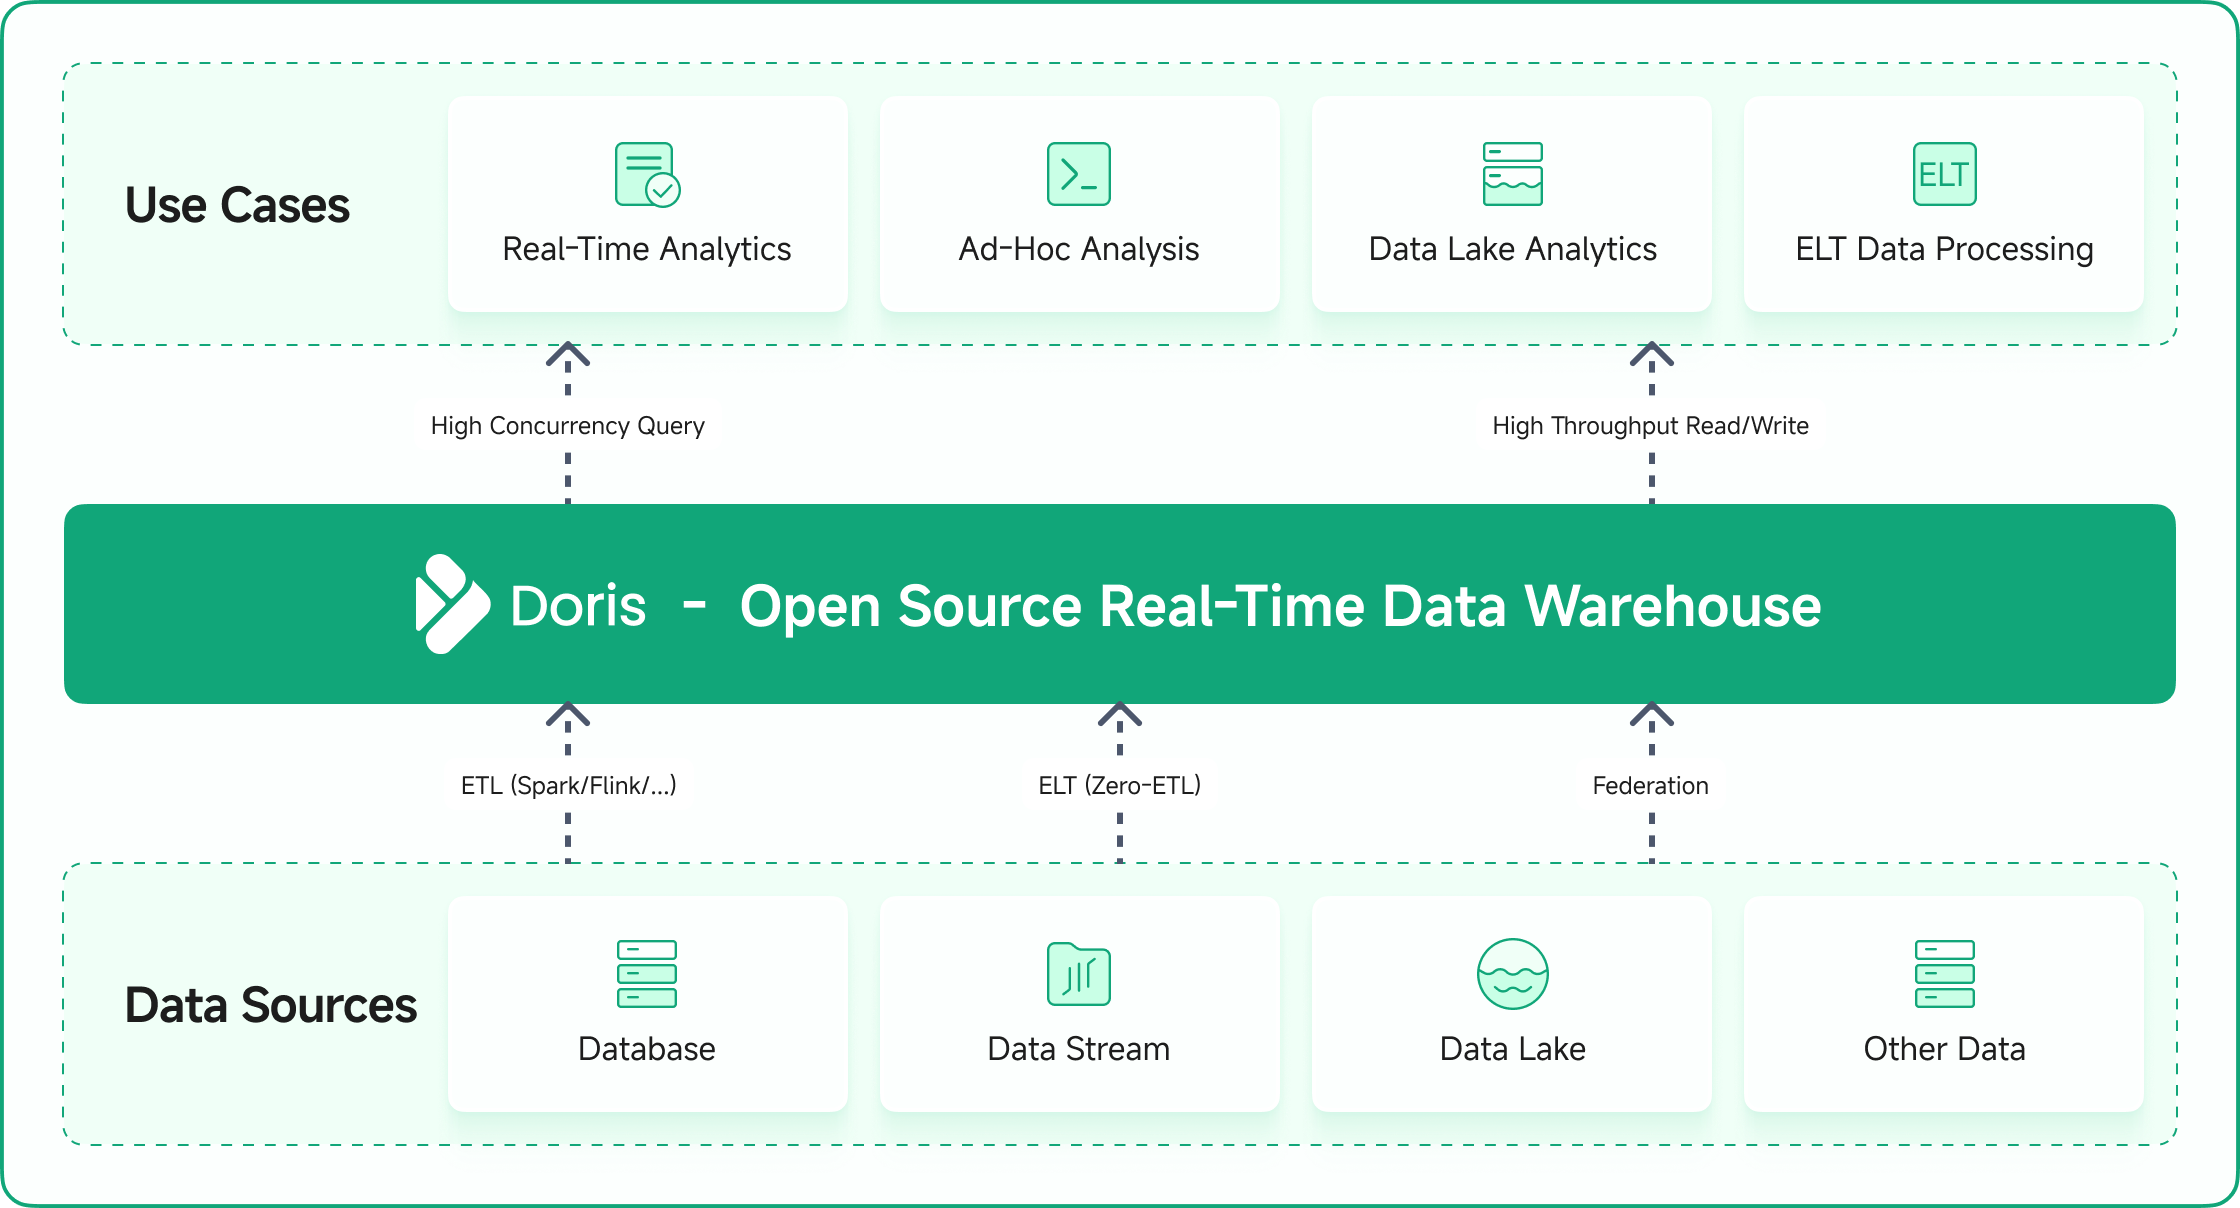
Интеграции и реализационные аспекты
Для реализации устойчивых к сбоям решений в Doris следует учитывать взаимосвязь между компонентами и инфраструктурой. В реальных проектах применяются сочетания стандартных инструментов и возможностей самой платформы.
-
Инфраструктура и интеграции. В большинстве сценариев кластеры Doris разворачиваются на привычной инфраструктуре - на физических серверах, виртуализованных средах или в Kubernetes. В рамках HA наиболее часто упоминаются:
- разделяемые хранилища для устойчивости к сбоям;
- репликация и распределение планшетов между географически распределенными узлами;
- использования ZooKeeper для координации и согласования между FE и BE.
-
Взаимодействие с открытыми инструментами. Для мониторинга и управления применяются известные инструменты - Prometheus, Grafana, Alertmanager. Это обеспечивает прозрачность состояния кластера и ускоряет реагирование на инциденты. В рамках архитектуры Doris это помогает поддерживать согласованность в условиях высокой динамики рабочих нагрузок.
-
Варианты развёртывания. Doris может поддерживать различные варианты - от обычной серверной инфраструктуры до контейнеризированных развертываний в Kubernetes. В последнем случае обеспечивается более простой горизонтальный масштаб и динамическая перераспределяемость под нагрузку. В любом случае ключевые принципы HA работают независимо от выбранной платформы.
-
Минимизация сложностей. Архитектура репликации и управление failover должны оживлять бизнес-процессы, а не создавать дополнительные сложности. Применение согласованных практик по настройке репликации, мониторингу и DR позволяет инфраструктуре работать прозрачно для аналитиков и операторов.
Эти аспекты подчеркивают важность системного подхода к реализации отказоустойчивости и аварийного восстановления в рамках Apache Doris и позволяют реализовать эффективные, управляемые и предсказуемые процессы обеспечения доступности и целостности данных.
Кейсы и практики внедрения
-
Географически распределённая репликация. В кейсах с распределёнными данными часто целесообразно размещать реплики планшетов в разных регионах или кластерах. Это позволяет выдержать локальные перебои, но требует дополнительных сетевых затрат и сложной политике согласования версий.
-
Автоматическое переключение FE. Включение режима активного резерва FE позволяет обеспечить минимальное время простоя, но требует согласованности конфигураций между активным и резервным FE и корректного перехода прав владения метаданными.
-
Мониторинг и предупреждения. Настройка предупреждений по задержкам репликации, состоянию реплик и дискового пространства позволяет своевременно выявлять проблемы и предотвращать ухудшение SLA. Важно иметь хорошо продуманные правила эскалации и план реагирования.
-
DR-тестирование как регулярная процедура. Регулярные тесты аварийного переключения и восстановления позволяют отработать сценарии реагирования, проверить работу под нагрузкой и снизить риск ошибок в реальном инциденте.
-
Практика управления изменениями. Внедрение новых политик репликации или обновлений кластера должно сопровождаться валидацией на стенде DR и минимизацией рисков для продакшен-окружения.
Эти кейсы иллюстрируют, как принципы репликации и failover могут применяться на практике в рамках Apache Doris, чтобы обеспечить требуемую устойчивость к сбоям и минимизацию времени простоя.
Key takeaways
- Репликация планшетов в Doris обеспечивает устойчивость к сбоям и масштабируемость чтения за счёт параллельного доступа к нескольким репликам.
- Архитектура HA требует совместной работы FE и BE: FE - координация и метаданные, BE - хранение данных и обработка запросов.
- Система поддерживает различные модели консистентности и подходы к подтверждению записей, балансируя между задержками и защитой данных.
- Восстановление после сбоев включает обнаружение, перераспределение реплик, догонку и ребалансировку, с акцентом на минимизацию простоя.
- Мониторинг репликации и здоровья узлов является критически важной частью эксплуатации: он позволяет оперативно реагировать на инциденты и планировать DR-операции.
- DR-практики должны быть встроены в жизненный цикл кластера и включать регулярное тестирование, резервное копирование и планирование географической устойчивости.
- Интеграции с ZooKeeper и инструментами мониторинга (Prometheus, Grafana) упрощают управление HA и мониторинг кластера Doris.
FAQ
- Что такое репликация в Doris и зачем она нужна?
- Репликация в Doris - это создание нескольких копий каждого планшета на разных BE-узлах для обеспечения доступности и устойчивости к сбоям. Она позволяет продолжать обработку запросов и уменьшает риск потери данных при поломке узла, а также повышает пропускную способность чтения за счет параллельного доступа к нескольким репликам.
- Как Doris обеспечивает отказоустойчивость FE и BE?
- FE обеспечивает HA через дублирование и автоматическое переключение между активным и резервным экземплярами с использованием централизованного координационного механизма. BE обеспечивает HA через репликацию планшетов на нескольких узлах, автоматическую догонку реплик и перераспределение планшетов при сбоях. В обоих случаях важны мониторинг, согласованные политики и корректная настройка инфраструктуры.
- Какие модели консистентности применяются в Doris в контексте репликации?
- Doris реализует баланс между задержкой и целостностью данных. Записи требуют подтверждения на нескольких репликах, чтобы считаться завершёнными, а чтение может осуществляться с доступной реплики. В реальных условиях выбираются параметры, соответствующие SLA и особенности рабочих нагрузок, чтобы минимизировать задержку и сохранить целостность данных.
- Какие сигналы тревоги сигнализируют о проблемах с репликацией?
- Проблемы проявляются как увеличение lag между репликами, недостающие реплики (under-replicated), перегрузки узлов, задержки сети и увеличение времени догонки. Эти сигналы требуют немедленного вмешательства для перераспределения реплик и переразмещения нагрузки, чтобы сохранить требуемый уровень репликации.
- Каковы практики DR для Doris?
- Практики DR включают географическую разделённость реплик, регулярные DR-тесты, резервы и бэкапы конфигураций и метаданных, а также автоматизированную переразподелку планшетов в случае сбоев. Важно иметь план изменения и регламент переключения FE, а также периодически проверять восстановление данных.
- Какую роль играет ZooKeeper в HA Doris?
- ZooKeeper может выступать как координационный механизм для управления конфигурациями, обнаружения и согласования ролей между FE-узлами. Он помогает обеспечить стабильность конфигураций и корректное переключение ролей в случае сбоев. Это один из компонентов, часто используемых в инфраструктуре HA.
- Какие инструменты мониторинга рекомендуется использовать?
- Рекомендуются Prometheus для сбора метрик, Grafana для визуализации и Alertmanager для уведомлений. Они позволяют строить dashboards, отслеживать lag репликаций, статус узлов, использование ресурсов и своевременно реагировать на инциденты.
- Как планировать размер репликации и размещение реплик?
- Размер репликации определяется требованиями к доступности и географическому распределению, а также бюджетом на хранение и сеть. Рекомендуется избегать размещения всех реплик в одном дата-центре и учитывать распределение по racks или AZ, чтобы снизить риск одновременного отказа нескольких узлов.
- Что делать при обнаружении слабой догонки реплик?
- Необходимо инициировать перераспределение планшетов на менее нагруженные узлы, проверить сетевые каналы и чистоту дискового пространства. Возможно потребуется увеличение пропускной способности сети или переработка стратегии размещения реплик, чтобы ускорить догонку.
- Какие критерии success для DR-плана Doris?
- Доступность кластера поддерживается на согласованном уровне SLA; RTO и RPO удовлетворяют бизнес-требованиям; процесс DR выполняется без существенных ошибок в ходе тестов; данные не теряются в критичных сценариях и возможность быстрого возобновления работы достигается за минимальные временные рамки через заранее подготовленные процедуры и инструменты автоматизации.
Глава охватывает принципы репликации и failover в Doris с акцентом на архитектуру, процессы восстановления и оперативные практики. В сочетании с реальными кейсами и интеграциями с существующими инструментами мониторинга и координации это обеспечивает прочную базу для разработки устойчивых к сбоям OLAP-аналитических платформ на основе Doris.


