

Резервное копирование и восстановление: Snapshot и DR-процедуры
Современные кластеры Hadoop предъявляют требования не только к хранению больших объемов данных и высокой доступности, но и к минимизации потерь при сбоях и к быстрой реконструкции работоспособности после аварий. В рамках данной главы рассматриваются принципы резервного копирования и восстановления через механизм Snapshot, а также практические DR-процедуры для HDFS и взаимодействия с YARN. Особое внимание уделяется архитектуре копирования состояний файловой системы, алгоритмам контроля целостности, интеграции с инструментами управления кластером и операционным runbook'ам для регулярного тестирования.
Вводные примечания диктуют необходимость не только сохранить данные, но и обеспечить воспроизводимость состояния пространства имён и его согласованность с активными задачами YARN. Snapshot в HDFS реализует "копирование по записи" (copy-on-write) и позволяет сохранять точки восстановления без дублирования физически хранящихся блоков, что существенно снижает стоимость резервного копирования и ускоряет процедуры восстановления. В разделе DR-процедур рассматриваются сценарии переноса снимков на DR-кластер, тестирование восстановления и организационные аспекты, включая регламентные проверки и автоматизацию.
-
Ключевые концепции: Snapshot в HDFS, интеграция Snapshot с DR-процедурами, хранение и управление снимками, проверка целостности, тестирование процессов восстановления, мониторинг и управление риск-историями.
-
Практическая составляющая: набор команд для создания и удаления снимков, инструменты для сравнения различий между снимками, подходы к копированию снимков на DR-кластер и восстановление на нем, а также рекомендации по настройке и безопасной эксплуатации.
-
Выход на операционный уровень: как строить runbooks, как проводить регулярные DR-тестирования и какие показатели мониторить для поддержания приемлемого RPO/RTO.
-
Архитектурная карта: как Snapshot влияет на namespace и блоки, как организована репликация и какие участки кластера подвержены рискам при авариях.
-
Обоснование выбора подхода: Snapshot** - минимальная инвазивность для активного кластера, простота интеграции с существующими инструментами Hadoop, гибкость при тестировании и восстановлении, совместимость с HA-настрйками NameNode и с процедурами кросс-кластерной репликации.
Краткое содержание главы
- Обзор архитектуры Snapshot в HDFS, принципы копирования по записям и управление снимками.
- DR-подходы: репликация снимков между кластерами, процедуры восстановления и их верификация.
- Операционные аспекты: политика хранения снимков, тестирование DR-процедур, безопасность и соответствие требованиям.
- Практические сценарии внедрения: пошаговые примеры развертывания, мониторинга и восстановления, примеры runbook'ов.
Архитектура и принципы Snapshot в HDFS
HDFS Snapshot представляет собой точку во времени состояния пространства имён без копирования данных по блокам каждый раз. В процессе создания снимка система фиксирует текущую структуру файлов и директорий, а последующие изменения в файловой системе происходят только в отличие от уже зафиксированной точки. Это позволяет хранить множество точек восстановления, не дублируя данные, и возвращаться к необходимому состоянию за считанные секунды.
Механизм Copy-on-Write и хранение снимков
Снимки реализованы как копирование по записи: после созданияSnapshot новые операции записи в директории происходят уже без воздействия на содержимое снимаемой точки. Файловые блоки, которые остаются неизменными между снимками, разделяются между точками восстановления и не дублируются, что существенно снижает требования к объему хранения. В рамках архитектуры HDFS Snapshot данные хранятся в пространстве имён NameNode, а сами данные блоков продолжают обслуживаться DataNodes, что обеспечивает целостность и согласованность между снимком и текущим состоянием.
Ключевые моменты:
- Snapshot создаётся на уровне директории, а не всей файловой системы целиком, что позволяет выбирать целевые области для резервирования.
- Изменения в файлах после создания снимка фиксируются как новые копии, а существующие данные остаются доступными через снимок.
- Snapshots совместимы с механизмом NameNode HA и поддерживают географическую репликацию через DR-стратегии.
Хранение снимков и управление версиями
Хранение снимаемых состояний осуществляет целостную связь между namespace и блоками. Для администратора важно понимать, как управлять количеством снимков и их жизненным циклом. Рекомендовано внедрять политики retention, ограничивающие число активных снимков в рамках конкретной директории, и периодически удалять устаревшие копии через команды управления снимками.
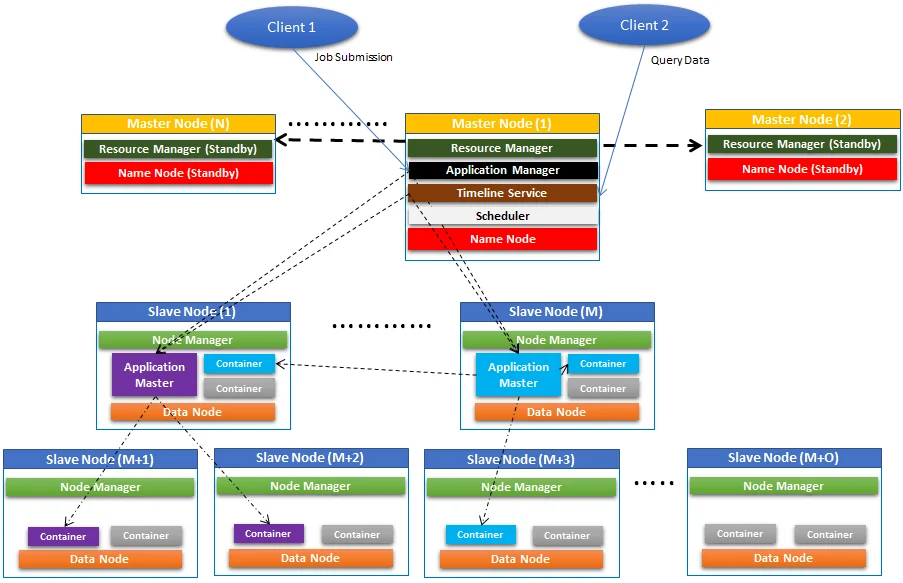
Из практических инструментов можно использовать:
-
создание снимка: команда на доступной ноде HDFS;
-
просмотр и анализ различий между снимками: инструмент для diff-репортов;
-
восстановление отдельных файлов и директорий из снимка в живое пространство.
# Включение возможности создавания снимков на директории
hdfs dfs -allowSnapshot /data
# Создание снимка с именем prod-20260311
hdfs dfs -createSnapshot /data prod-20260311
# Получение отчета о различиях между двумя снимками
hdfs dfsadmin -getSnapshotDiffReport /data prod-20260311 prod-20260312
# Восстановление файла или каталога из снимка в живую директорию
hdfs dfs -cp /data/.snapshot/prod-20260311/path/to/file /data/path/to/file
Инструменты и интеграции
Для централизованной эксплуатации снимков в рамках корпоративного Hadoop-окружения применяются средства управления конфигурацией и мониторинга кластера, такие как Apache Ambari или коммерческие решения вроде Cloudera Manager. Они позволяют централизованно управлять включением Snapshot, мониторингом использования пространства и интегрировать DR-процедуры в регламенты операционной деятельности. В рамках open-source практик часто используются встроенные возможности Hadoop, а также инструменты для мониторинга, такие как Prometheus c экспортёрами для Hadoop, для отслеживания показателей использования снимков и нагрузки на NameNode.
-
Архитектурно Snapshot тесно связан с механизмами NameNode HA и журналами имени (ediни) в QJM. В сочетании с кросс-кластерной репликацией Snapshot обеспечивает устойчивость к сбоям на уровне namespace и позволяет быстро вернуть кластер к работоспособному состоянию.
-
Важно: Snapshot не является заменой полного резервного копирования. Он дополняет стратегии DR и имеет разумную стоимость хранения за счёт копирования по записи ссылок на блоки. Для обеспечения более полной защиты рекомендуются периоды копирования важных директорий в DR-кластер и регулярные проверки целостности данных.
DR-подходы и стратегия восстановления
DR-подходы опираются на параллельное существование активного кластера и кластера-резервной копии. Snapshot служит связующим элементом между ними: он позволяет закрепить состояние пространства имён и, при необходимости, быстро воспроизвести его в DR-кластере.
DR-архитектура: hot-standby vs warm-standby
- Hot-standby предполагает активное наличие DR-кластера, синхронизируемого с основным, чтобы исключить существенную задержку восстановления. В рамках Snapshot это достигается периодическим копированием снимков на DR-кластер и минимизацией задержек в актуализации namespace.
- Warm-standby предполагает периодический переход к DR-режиму в случае аварии. Snapshot здесь выполняется на регулярной основе, а DR-кластер поддерживается в готовности к быстрому включению после аварии.
Общие принципы:
- планирование RPO (цель по времени потери данных) и RTO (время до восстановления) для каждого набора данных;
- определение критичных директорий и политики retention для Snapshot;
- определение частоты создания снимков в зависимости от скорости изменений в данных.
Репликация снимков на DR-кластер
Репликация снимаемых состояний может осуществляться несколькими путями. Один из распространённых подходов - перенос снимков на DR-кластер через DistCp или копирование через директории снимков в формате, поддерживаемом HDFS.
# Пример упрощенной копии снимка на DR-кластер через cp
## Предполагается наличие каталога /data/.snapshot/prod-20260311 на source
## и аналогичного каталога на DR
hdfs dfs -cp /data/.snapshot/prod-20260311/ /dr-data/.snapshot/prod-20260311/
# Пример использования DistCp с традиционной передачей снимков на DR-кластер
## В этом формате указаны источники и назначения как URIs
distcp -update -delete -m 8 \
  -fromSnapshot prod-20260311 \
  hdfs://source-cluster:8020/data/.snapshot /hdfs://dr-cluster:8020/data/.snapshot
- Важно: перед запуском DistCp решить вопросы согласованности времени, сетевой задержки и совместимости версий Hadoop между кластерами. DistCp должен подключаться к обоим кластерам с одинаковыми версиями схемы namespace и совместимыми блоками. Кроме того, для повышения надёжности полезно тестировать перенос на DR в условиях имитации сбоев.
Восстановление на DR-кластере
В сценарии аварий DR-кластер должен стать доступной копией основного кластера или продолжать работу по критичным данным. Основные шаги восстановления:
-
Проверить доступность DR-кластера и корректность конфигурации NameNode и DataNodes.
-
Восстановить пространство имён через снимок:
- убедиться, что нужный снимок присутствует на DR-кластере;
- создать соответствующую директорию, если она была удалена во время аварии.
# Восстановление каталога из снимка на DR
hdfs dfs -cp /data/.snapshot/prod-20260311/path /data/path
- Восстановить функциональные сервисы YARN и связанный кэш состояния:
- перезапуск RM (ResourceManager) в DR-кластере;
- проверить состояние очередей и запущенных задач, обновить конфигурации по умолчанию, если DR-кластер имеет изменённую топологию.
- Верифицировать целостность и согласованность:
-
выполнить проверки файловой системы (fsck) на DR-кластере;
-
сравнить контрольные суммы файлов и количество блоков с эталонной точкой.
 # Пример проверки целостности файлов на DR
hdfs fsck /data -files -blocks -locations
Организационные и операционные аспекты
DR-процедуры требуют документированных runbook'ов, чётких ролей, регламентов по тестированию и по проведению DR-сценариев. Включаются следующие элементы:
-
Регламент тестирования DR: частота, сценарии, роли, ожидания результата.
-
Мониторинг и алерты: SLA по времени фиксации сбоев, задержка копирования снимков.
-
Безопасность: контроль доступа к снимкам и к кластерам, использование Kerberos, шифрование в пути передачи.
-
Совместимость и аудит: сохранение журналов операций, проверка соответствия требованиям регуляторов, хранение истории изменений.
Для практической эксплуатации применяются такие инструменты, как Apache Ambari для управления конфигурациями и мониторинга, а также решения, обеспечивающие мониторинг состояния NameNode, DataNodes и задач YARN. В контексте открытых решений часто встречаются Ambari, а в корпоративной среде - Cloudera Manager, которые облегчают внедрение DR-цепочек и автоматизацию операций.
Практические сценарии внедрения
- Сценарий 1: Условное включение Snapshot для критических директорий (например, /data и /user). Вводится политика retention, создаются регулярные снимки, на DR-кластер копируются основные точки восстановления.
- Сценарий 2: DR-тест на ежеквартальной основе с имитацией потери активного кластера и развёртыванием DR-подмножества на второй кластер.
- Сценарий 3: Восстановление из снимка после случайной порчи директории: восстановление файлов в новую директорию и последующая валидация целостности.
Организация мониторинга и контроля производительности
Snapshot и DR-процедуры влияют на производительность кластера через частоту создания снимков и затраты на хранение снимков. Рекомендации по мониторингу:
- частота создания снимков и их влияние на NameNode;
- объем занимаемого пространства под снимки и динамика ростов;
- скорость репликации снимков на DR-кластер и задержки между кластерами;
- валидность снимков и процент ошибок при копировании.
Для поддержки операционной эффективности полезно внедрять автоматическую очистку устаревших снимков, основанную на политики retention, и регулярно проводить DR-тестирования, зафиксировав результаты в отчетах. В рамках мониторинга можно использовать Prometheus-метрики и соответствующие экспортеры для Hadoop, чтобы видеть загрузку NameNode, состояние DataNodes, а также показатели времени выполнения операций Snapshot и DR-перемещений.
Безопасность и соответствие требованиям
- Snapshot хранит данные в read-only форме и требует соответствующих прав доступа. Необходимо обеспечить ограничение прав на создание, просмотр и удаление снимков.
- При передаче снимков на DR-кластер обеспечить шифрование данных в канале и аутентификацию между кластерами.
- В рамках политики соответствия данных необходимо сохранять журналы операций и регламентировать хранение снимков с учетом требований к длительности хранения.
Key takeaways
- Snapshot в HDFS обеспечивает точку восстановления без копирования больших объемов данных, используя концепцию copy-on-write.
- DR-процедуры на основе снимков позволяют быстро воссоздать состояние пространства имён на DR-кластере и минимизировать потерю данных.
- Эффективная архитектура DR требует сочетания снимков, передачи снимков на DR-кластер (DistCp или копирование) и тестирования восстановления.
- Включение Snapshot должно сопровождаться политиками retention, мониторингом использования пространства и регулярными DR-тестированиями.
- Интеграция с инструментами управления конфигурациями и мониторинга упрощает эксплуатацию и улучшает видимость операций Snapshot и DR.
- Безопасность и соответствие требованиям остаются критическими: управление доступом к снимкам, шифрование и аудит операций.
- Практические сценарии и runbook'и должны быть внедрены для повторяемости и минимизации времени простоя.
FAQ
- Что такое Snapshot в HDFS и почему он полезен?
- Snapshot - это точка во времени состояния пространства имён, сохраняемая без копирования данных по блокам. Он позволяет быстро вернуться к конкретному состоянию файловой системы и служит основой для DR-процедур, поскольку снимает копирование больших объемов данных и сохраняет ссылки на блоки, что снижает требования к хранению и ускоряет восстановление.
- Чем Snapshot отличается от обычного резервного копирования?
- Snapshot работает на уровне namespace и использует копирование по записи, не дублируя данные. Это отличается от полного резервного копирования, которое копирует файлы целиком, иногда занимая значительный объем хранения и времени на создание. Snapshot обеспечивает быструю доступность к точке восстановления и экономию ресурсов.
- Какие команды используют для работы со снимками?
- Включение Snapshot на директории: hdfs dfs -allowSnapshot /data
- Создание снимка: hdfs dfs -createSnapshot /data prod-20260311
- Получение отчета о различиях между снимками: hdfs dfsadmin -getSnapshotDiffReport /data prod-20260311 prod-20260312
- Восстановление из снимка: hdfs dfs -cp /data/.snapshot/prod-20260311/path /data/path
- Как реализуется DR-перенос снимков между кластерами?
- Один из вариантов - перенос снимков на DR-кластер через DistCp, который может копировать снимки между кластерами: distcp -update -delete -m 8 -fromSnapshot prod-20260311 hdfs://source-cluster:8020/data/.snapshot /hdfs://dr-cluster:8020/data/.snapshot. Альтернативно можно выполнить копирование конкретной директории снимка на DR через обычное cp внутри HDFS: hdfs dfs -cp /data/.snapshot/prod-20260311/path /dr-data/.snapshot/prod-20260311/path.
- Какие проблемы могут возникать при DR и как их избежать?
- Проблемы синхронности между кластерами, несовместимость версий Hadoop, конфигурационных параметров и задержки копирования. Чтобы снизить риски, применяют совместимость версий, тестируют DR-процедуры в тестовом окружении, используют автоматизацию и регламенты выпуска изменений, и контролируют сетевые задержки между кластерами.
- Как подтвердить целостность данных после восстановления?
- Выполнение fsck на DR-кластере, сравнение контрольных сумм и количества блоков между исходной точкой и DR, анализ журналов операций, проверка доступности критичных файлов и корректности метаданных.
- Какие ограничения и риски Snapshot в HDFS?
- Snapshot не заменяет полноценные копии данных на случай длительного хранения, может потребовать времени на удаление устаревших снимков и потребует мониторинга пространства. При большом количестве снимков возможна экспоненциальная трата метаданных, и требуется план управления retention.
- Какие инструменты можно использовать для управления DR-процедурами?
- Apache Ambari или Cloudera Manager для координации конфигураций и мониторинга, Prometheus и Grafana для визуализации метрик Snapshot и DR, а также собственные скрипты runbook’ов для автоматизации тестирования и восстановления.
- Какие параметры безопасности важно учитывать?
- Контроль доступа к директориям и снимкам, строгие правила Kerberos-аутентификации, шифрование данных в канале передачи, аудит операций Snapshot и копирования снимков.
- Какой подход к тестированию DR-процедур наиболее эффективен?
- Рекомендовано проводить регулярные DR-тесты с фиксированными критериями успеха, включать сценарии доступности основного кластера и переключения на DR, а также проверять целостность данных после восстановления и их доступность для критических приложений YARN.


