

Оптимизация выполнения запросов: планировщик, исполнение и режимы
Doris - распределённая аналитическая база данных, ориентированная на real-time анализ больших объёмов данных. Эффективная оптимизация выполнения запросов здесь строится на тесной связке между планированием (как превратить SQL-запрос в эффективный путь к результату) и исполнением (как реализовать этот путь в распределённой системе с учётом памяти, сети и параллелизма). В данной главе раскрываются принципы работы планировщика Doris, конвейер исполнения и набор режимов, через которые проходят запросы в типичных сценариях OLAP и real-time аналитики. Фокус сделан на архитектурных и алгоритмических аспектах, при этом приводятся практические ориентиры по настройке и мониторингу.
Doris реализует характерную для современных MPP-систем схему FE (Frontend) - управление метаданными и планированием, и BE (Backend) - хранение данных, выполнение планов и обработка запросов в параллельном режиме. Запрос сначала попадает к планировщику FE, который формирует логический и физический план, затем план разбивается на фрагменты исполнения и распределяется по BE-узлам. Исполнение построенных планов ведётся через конвейер операторов: сканирование данных, фильтрация и проекция, агрегации, соединения и финальный сортировкой/TopN. Векторизированный исполнитель Doris обеспечивает высокий пропускной rate за счёт обработки данных в столбцах и использования современных кэш- и памяти-стратегий, а также механизмов обмена данными между узлами. Режимы исполнения и планирования позволяют адаптироваться к разным нагрузкам: от обычной аналитики до пиковых сценариев real-time ingestion и сложных аналитических запросов.
- Архитектура и роль планировщика
- Этапы планирования и принципы оптимизации
- Исполнение и конвейерная обработка
- Режимы выполнения и адаптивные возможности
- Практические рекомендации по настройке и мониторингу
Архитектура планирования и выполнения в Doris
Doris оперирует двумя основными слоями: FE отвечает за анализ и оптимизацию запросов, BE - за физическое исполнение и работу с данными. Это разделение позволяет независимо масштабировать планирование и исполнение, снижая задержки на этапе планирования и обеспечивая устойчивость к нагрузкам во время выполнения.
FE сначала парсит SQL, проверяет синтаксис и сопоставляет запросы с метаданными схемы и статистикой. Затем выполняется анализ и преобразование выражений: упрощение констант, развёртывание предикатов, пушдаун фильтров до источников данных, проекции столбцов и проверка совместимости типов. После этого начинается генерирование логического плана - абстрактного представления операции над набором данных без привязки к конкретной физической реализации. На этапе оптимизации применяются правила трансформаций и, по возможности, статистически обоснованный выбор физического плана: какие соединения использовать (hash join, sort-merge join, Broadcast join и т. п.), как распределить данные между узлами, какие индексы или материальные представления можно применить.
На выходе формируется набор план-фрагментов (PlanFragments), каждый из которых может быть выполнен на BE-узле и обрабатваться параллельно. План-фрагменты соединяются через узлы обмена (exchange), которые перераспределяют данные между участниками запроса по стратегиям распределения: шардирование, Broadcast или частичную агрегацию на ранних стадиях. Это обеспечивает масштабируемость и предсказуемую латентность в распределённой среде. Векторизованный исполнитель BE обходит данные колонками и последовательно применяет операторы конвейера: сканирование, фильтрацию, проекцию, агрегацию, сортировку и т. д. С целью снижения сетевого трафика применяются ранние фильтры и агрегации, а также механизм эффективного распределения памяти и кэширования.
- FE отвечает за анализ, оптимизацию и создание PlanFragments.
- BE выполняет план-фрагменты на локальном наборе данных с использованием конвейера операторов.
- Data Exchange обеспечивает распределение данных между узлами и сопряжение результатов.
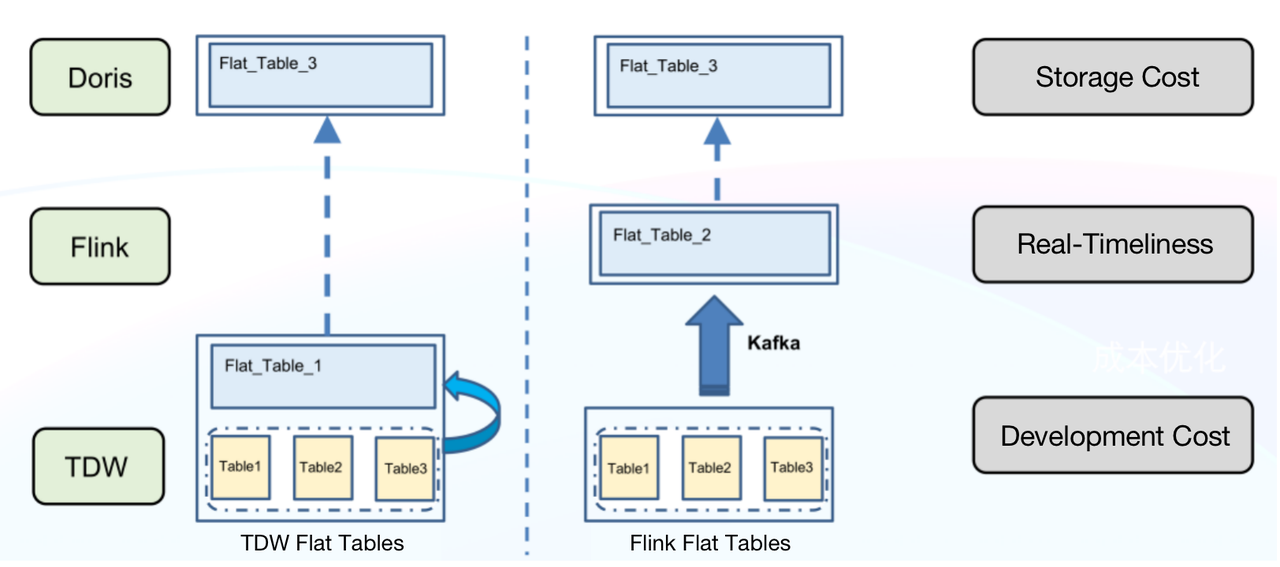
Планировщик запросов
Планировщик Doris строится по принципам многоступенчатой оптимизации, где каждый шаг приводит к снижению объёма работ на этапе исполнения, не забывая о требованиях к точности результата и ресурсам. Основу составляет двухуровневый подход: логический план, затем физический план с выбором конкретных операторов и стратегий исполнения.
Этапы планирования включают:
- Разбор и валидацию запроса: синтаксис, семантика, привязка к схемам и типам данных.
- Статистическая оценка: сбор и использование статистики по таблицам и столбцам (кардинальность, распределение значений, наличие пропусков). Эти данные существенно влияют на выбор физических операторов и порядок выполнения.
- Преобразование выражений: константное развёртывание, упрощение условий и преобразованиеPredicates для эффективного пушдауна к источникам данных.
- Применение правил трансформаций: нормализация выражений, устранение избыточных вычислений, оптимизация последовательностей операций.
- Выбор физического плана: на этом этапе планировщик оценивает альтернативы исполнения для каждого фрагмента и выбирает наиболее выгодную стратегию по своей cost-модели. Включаются решения по выбору алгоритма join (hash, merge, nested loop), способу агрегации, распараллеливанию и распределению данных.
- Адаптивность и динамическая оптимизация: в современных реализациях возможно использование ограниченных форм адаптивного планирования, когда часть плана корректируется во время выполнения на основе известных статистик реальных данных.
Ключевые принципы включают:
- Predicate pushdown: фильтры, применяемые как можно раньше, на уровне источников данных, чтобы минимизировать объём обрабатываемых данных.
- Projection pushdown: выбор точных столбцов, необходимых на следующем шаге, ещё на стадии сквозной обработки.
- Join order и reordering: особенно критично для больших наборов данных. Применение cost-based подхода помогает поменять порядок соединений для минимизации вычислительной и памяти нагрузок.
- Runtime фильтры (Bloom filters) и ранняя агрегация: позволяют отсеять данные на ранних стадиях и освободить ресурсы для более дорогих операций.
- Профилирование памяти и ресурсоёмких операций: планировщик учитывает лимиты памяти, лимиты параллелизма и распределение нагрузки по узлам.
Применение статистики и гипотез позволяет планировщику Doris делать обоснованный выбор между кросс-пузырями исполнения и более экономичными подходами. В случае отсутствия достоверной статистики план может прибегнуть к более консервативным стратегиям, что может увеличить латентность, но обеспечит корректный результат. Важной особенностью является поддержка hints и настройка на уровне сессии, которые позволяют влиять на выбор физических операторов в сложных кейсах или в условиях неопределённости статистики.
- Основной механизм: логический план → оптимизированный логический план → физический план (план-фрагменты) → распределение по BE-узлам.
Исполнение: конвейер и векторизация
Исполнитель Doris реализован как конвейер операторов, организованный под векторизованный режим обработки. Это позволяет обрабатывать данные целыми столбцами и использовать современные CPU-архитектуры для ускорения вычислений. Основные строительные блоки исполнения включают:
- Векторизированные операторы: сканирование, фильтрация, проекция, агрегация, сортировка и соединения. Каждый оператор отвечает за свой фрагмент обработки данных и работает над блоками столбцов, что минимизирует кеш-промахи и улучшает локальность памяти.
- Обмен данными между узлами: план-фрагменты, исполняемые на разных BE-узлах, объединяются через Data Exchange (межпроцессные каналы передачи), поддерживающие распределение данных по ключу, по рандому или Broadcast. Эти механизмы обеспечивают эффективную параллелизацию и минимизируют задержку за счёт локального и частично локального обмена.
- Механизмы памяти и кэширования: Doris применяет кэш данных, буферы для промежуточных результатов и эффективное управление памятью для избежания перегрузки и частых spills. При нехватке памяти активируются политики spill to disk и возврата к внешнему хранению без потери корректности.
- Оптимизация исполнения: ранняя агрегация и фильтры, агрегации по группам и TopN выполняются как можно раньше, чтобы уменьшить размер промежуточных данных. В некоторых сценариях применяются техники кодогенерации выражений для ускорения вычислений и снижения накладных расходов на интерпретацию выражений.
- Распараллеливание: уровень параллелизма регулируется не только на уровне план-фрагментов, но и внутри операторов и потоков. Современные реализации поддерживают динамическое масштабирование параллелизма в зависимости от текущей загрузки системы и характерного профиля запроса.
Исполнитель ориентирован на устойчивость и предсказуемость: даже при больших объёмах данных поддерживается стабильная производительность за счёт конвейерной обработки и контроля за потреблением памяти. Векторизация и эффективная система обмена данными позволяют Doris демонстрировать низкую латентность на запросах с агрегациями, фильтрациями и сложными соединениями, характерными для real-time аналитики.
- Векторизация операторов повышает пропускную способность.
- Обмен данными между узлами уменьшает сетевые затраты за счёт ранней агрегации и pushdown.
- Управление памятью и spill-ориентированное выполнение обеспечивает устойчивость под пиковыми нагрузками.
Режимы выполнения: адаптивность и управляемость
Режимы выполнения в Doris отражают компромиссы между латентностью, пропускной способностью и расходом ресурсов. В ходе реального цикла запроса система может переключаться между различными режимами на разных стадиях плана или в зависимости от контекста задачи. Ниже представлены ключевые режимы и подходы.
- Режимы исполнения с учётом памяти: при дефиците памяти включаются политики spill to disk, что позволяет продолжать выполнение без аварийного завершения, хотя и с некоторой потерей скорости. В задачах с большим количеством агрегаций или группировок это критично для поддержания устойчивой задержки.
- Режимы конвейера vs блоковой обработки: базовый режим является конвейерным, где каждый оператор подхватывает данные как они доступны. В отдельных сценариях может применяться частично блоковый режим для стадий, где требуется сбор промежуточных результатов до последующего шага.
- Адаптивная оптимизация во время выполнения: при отсутствии точной статистики на старте запрос может корректировать план на лету, используя знакомые паттерны данных и текущую нагрузку. Это позволяет снизить влияние неопределённости на латентность выполнения.
- Runtime-фильтры и ранняя агрегация: данные фильтруются ещё на ранних этапах исполнения, при необходимости обновляются фильтры во время выполнения (если архитектура это поддерживает) для более точной prune-логики в последующих шагах.
- Режимы конфигурации параллелизма и распределения: администраторы могут настраивать уровень параллелизма, лимиты памяти, политики планирования и уровни агрегации, чтобы адаптировать Doris под конкретные требования и инфраструктуру.
- Контроль над кодогенерацией: возможность включать/выключать кодогенерацию выражений, что особенно полезно при переносе на нестандартные или экспериментальные схемы данных, а также для отладки и обеспечения совместимости.
- Режимы мониторинга и диагностики: сбор и анализ профилей выполнения с фокусом на латентность по стадиям, узлам и операциям. Это позволяет локализовать узкие места и корректировать планирование на уровне конфигурации.
Эти режимы позволяют менеджерам и разработчикам гибко подстраивать Doris под требования real-time аналитики и сценариев интенсивной загрузки данных. В практике следует:
-
Начинать с консервативного набора ограничений памяти и низкого уровня параллелизма, постепенно наращивая их по мере наблюдения за поведением запросов.
-
Использовать режимы мониторинга, чтобы быстро выявлять узкие места: операции сканирования, этапы соединений, перераспределение данных и эффективность ранних фильтров.
-
Применять адаптивное выполнение для сложных и неопределённых наборов данных, чтобы минимизировать латентность и обеспечить стабильность сервиса.
-
Роль режимов: адаптивность, устойчивость к нагрузке и управляемость производительностью.
Интеграции и операционные аспекты
Оптимизация выполнения запросов тесно взаимосвязана с интеграцией Doris в инфраструктуру и процессами эксплуатации. Важны вопросы метаданных, мониторинга, настройки и устойчивости к сбоям. Практические направления включают:
- Интеграцию статистики и каталогов: доступ к актуальным статистическим данным по таблицам и секциям данных поддерживает точность оценок плана и выбор эффективных стратегий выполнения. Регулярное обновление статистики особенно важно для нагрузок с частыми обновлениями и изменениями данных.
- Мониторинг и диагностика: сбор метрик по времени выполнения, подсчёт толерантности к задержке, анализ узких мест и профилирование. Использование инструментов мониторинга помогает операторам быстро идентифицировать проблемы и корректировать конфигурацию.
- Интеграция с источниками данных: оптимизация пушдауна фильтров и проекции до источников данных (то есть на уровне чтения из Parquet, ORC, или внутреннего формата Doris) снижает объём переработки данных и ускоряет запуск запросов.
- Управление ресурсами: контроль параллелизма, лимитов памяти, настройка распределения нагрузки между узлами и использование ресурс-групп. Эти настройки обеспечивают предсказуемую производительность для разных клиентов и заданий.
- Совместимость и расширяемость: поддержка гибких схем и коллабораций, возможность использования внешних таблиц, миграция между версиями и интеграция с инструментами BI.
Практическая рекомендация: начинать с базовой конфигурации, ориентированной на устойчивую работу и предсказуемую латентность, затем постепенно вводить адаптивные режимы и расширение параллелизма по мере роста объёмов данных и числа одновремённых запросов. Важно помнить о балансе между латентностью отдельных запросов и общей пропускной способностью кластера.
Key takeaways
- Планировщик Doris выполняет последовательность преобразований: логический план, оптимизация и выбор физического плана, разбивка на план-фрагменты и распределение их по BE-узлам.
- Исполнитель реализован через векторизованный конвейер операторов и эффективный обмен данными между узлами, что обеспечивает высокую пропускную способность и низкую латентность.
- Адаптивность исполнения и режимы конфигурации позволяют Doris сохранять устойчивость в условиях переменной нагрузки и данных, поддерживая real-time аналитическую нагрузку.
- Предикатный пушдаун, ранняя агрегация, runtime-фильтры и эффективное управление памятью существенно снижают объём обрабатываемых данных и ускоряют запросы.
- Эффективная интеграция с источниками данных, статистика и мониторинг играют критическую роль в точности планирования и устойчивости исполнения.
- Роль режимов конфигурации в управлении параллелизмом, памятью и кодогенерацией позволяет адаптировать Doris под конкретные сценарии и инфраструктуру.
- Контроль над ресурсами, профилирование и пошаговая оптимизация позволяют минимизировать регрессии производительности в сложных запросах.
FAQ
- Какие основные этапы проходит запрос в Doris от прихода до результата?
- Запрос попадает к Frontend, который выполняет анализ, валидацию и планирование. Планировщик строит логический план, затем выбирает физический план и формирует план-фрагменты. Эти фрагменты распределяются по Backend-узлам и исполняются в виде конвейера операторов на каждом узле. Результаты собираются и возвращаются клиенту. В процессе применяются пушдаун-предикаты, ранняя агрегация и фильтры, чтобы минимизировать обработку лишних данных.
- Какие типы соединений (joins) поддерживает Doris и как выбирается стратегия исполнения?
- Doris поддерживает несколько стратегий соединения, включая hash join и sort-merge join, а также варианты Broadcast join для небольших таблиц. Выбор стратегии определяется планировщиком на основе статистики по данным, размерности входов и текущей загрузки системы. В случае нехватки статистики планировщик может прибегнуть к более консервативным стратегиям, чтобы сохранить корректность и стабильность выполнения.
- Что такое план-фрагменты и как они работают в распределённой архитектуре Doris?
- План-фрагменты - это часть физического плана, которую можно выполнить независимо на конкретном BE-узле. Они формируют параллельную структуру запроса в кластере и обмениваются данными через механизм Data Exchange. Такое разделение позволяет эффективнее распределять нагрузку и параллелизировать обработку, минимизируя задержки на сетевых операциях.
- Как Doris использует предикатный пушдаун и раннюю агрегацию для ускорения запросов?
- Предикатный пушдаун перемещает фильтры к уровням источников данных, тем самым отбрасывая ненужные данные до начала сложной обработки. Ранняя агрегация уменьшает объём промежуточных результатов, особенно в сценариях группировок и агрегаций над большими наборами данных. Эти техники существенно снижают требования к памяти и сетевому трафику.
- Какие режимы адаптивности есть в Doris и когда их применять?
- В Doris присутствуют адаптивные режимы, которые позволяют корректировать план выполнения на лету на основе текущей статистики и условий нагрузки. Это полезно в сценариях переменной загрузки, смены паттернов данных и при отсутствии точной статистики на старте запроса. Адаптивность помогает сохранить баланс между латентностью и пропускной способностью.
- Как настройка памяти и spill-to-disk влияет на выполнение запросов?
- Ограничения по памяти и политики spill позволяют поддерживать выполнение запросов даже при пиковых нагрузках и больших промежуточных данных. Однако spill может увеличить латентность. Оптимальная конфигурация требует баланса между размером рабочих наборов, частотой spills и доступной физической памятью на узлах.
- Какие метрики и методы мониторинга наиболее полезны для оптимизации запросов?
- Полезны метрики времени выполнения по стадиям (сканирование, фильтрация, Join, агрегация, сортировка), распределение нагрузки между узлами, частота применения ранних фильтров, размер промежуточных данных и проценты использования памяти. Анализ профилей выполнения помогает выявлять узкие места и корректировать планирование или конфигурацию.
- Как кодогенерация вписывается в исполнение и когда её целесообразно отключать?
- Кодогенерация выражений может значительно ускорить вычисления в случаях, когда выражения повторяются или требуют сложных вычислений внутри операторов. Она может быть отключена в случаях, когда платформа не поддерживает нужный набор инструкций, или когда требуется детальная отладка. Решение зависит от конкретной версии и конфигурации Doris.
- Какие сценарии внедрения требуют особого внимания к режимам выполнения?
- Сценарии с высоким числом одновремённых пользователей, пиковыми периодами загрузки и требованиями real-time аналитики требуют хорошего баланса между параллелизмом, памятью и задержками. В таких случаях полезны адаптивные режимы, ранние фильтры и эффективная конфигурация обмена данными между узлами.
- Какие примеры интеграции с внешними источниками данных стоит учитывать при оптимизации?
- В интеграции с Parquet/ORC-хранилищами и потоками данных следует схеме организации доступа, обеспечения статистики и пушдауна фильтров. В идеале применяются стратегии пушдауна, чтение только необходимых столбцов и использование статистики таблиц. Однако специфика интеграции зависит от конкретной реализации источника и версии Doris.
Эта глава охватывает ключевые аспекты оптимизации выполнения запросов в Doris, показывая, как архитектура планирования и исполнения формирует эффективность в real-time аналитике. Опираясь на принципы ветвления плана, конвейерного исполнения и адаптивных режимов, организации способны достигать высокой производительности при сохранении точности и управляемости в условиях переменной нагрузки и динамичных данных.


