

Apache Kafka: потоковая интеграция данных для аналитических платформ - Контекст отраслевых применений: финансы, телеком, розничная торговля, здравоохранение
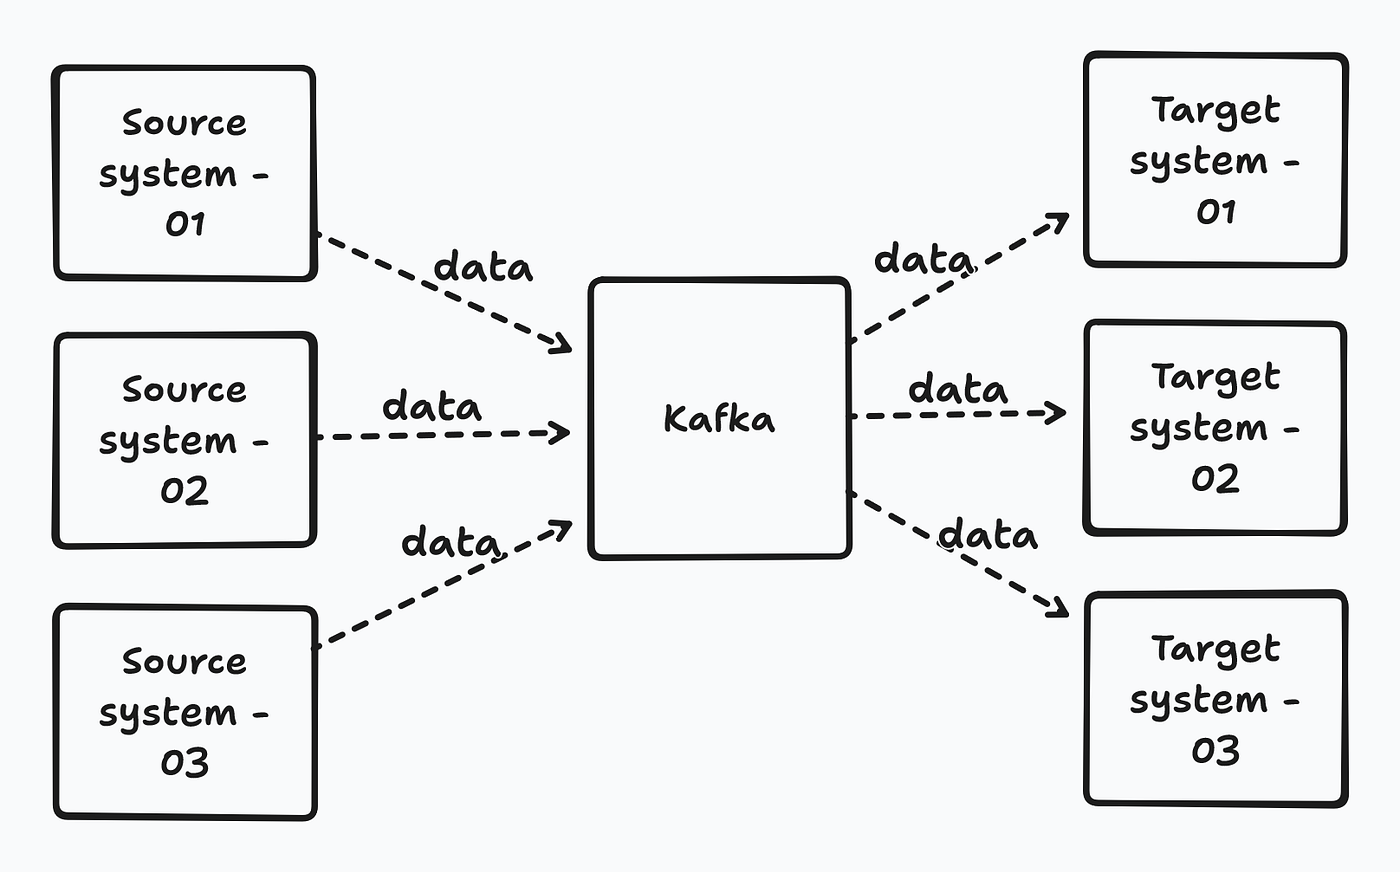
Постоянная экспонента объёмов данных и скорости их появления диктуют требования к архитектурам аналитических платформ. Apache Kafka выступает как единая транспортная и интеграционная шина, обеспечивающая устойчивость к пиковым нагрузкам, повторяемость потоков и тесную интеграцию между системами. В данной главе рассматриваются ключевые отраслевые контексты применения Kafka: финансы, телеком, розничная торговля и здравоохранение. Рассматриваются архитектурные паттерны, доменные модели данных, протоколы безопасности и типичные сценарии внедрения, включая выбор технологических компонентов, схем данных и практики обеспечения согласованности и соответствия требованиям регуляторов.
Исследование отраслевых контекстов позволяет перейти от общих принципов к конкретным архитектурным решениям и практикам реализации. В каждом разделе будет рассмотрано, как организации с разными требованиями к задержке, надёжности и безопасности конструируют конвейеры данных, как выбирают между Kafka Streams, Kafka Connect, KSQL/ksqlDB и источниками данных, какие подходы применяют к данным с учётом требований регуляторов и отраслевых стандартов, и какие примерные шаблоны интеграции применяются на практике.
Краткое содержание главы
- Архитектурные паттерны потоковой интеграции в финансовом секторе и их влияние на качество данных и соответствие требованиям.
- Доменные модели и схемы сообщений, обеспечение идентифицируемости транзакций и устойчивости к дубликатам.
- Интеграции, безопасность и соответствие: протоколы, криптография, управление доступом, аудит и регуляторные требования.
- Конкретные отраслевые сценарии внедрения и типовые паттерны реализации: CDC, коннекторы, аналитические пайплайны и контроль качества.
Финансы
Финансовый сектор предъявляет жесткие требования к задержке обработки, точности учёта и неизменности аудита. В рамках потоковой интеграции через Kafka формируются конвейеры, которые обеспечивают непрерывный обмен событиями между банками, торговыми системами, риск-менеджментом и ответственными службами. Архитектура часто строится на сочетании микросервисной связности через события и агрегирования в реальном времени, с поддержкой репликации потоков и транзакционных границ между системами.
Архитектурные принципы
- Эвристика событийно-ориентированной архитектуры. События финансовых операций, ставок и уведомлений публикуются в темах, разделённых по домену: транзакции, аудит, риск, клиентские уведомления.
- Гарантии целостности и Exactly-Once семантики. Важна координация транзакций между отправителями и потребителями через транзакционные продюсеры, а также возможность атомарной записи в несколько тем.
- CDC как источник изменений в банковских системах. Для миграции и синхронизации источников данных часто применяют Debezium в связке с Kafka Connect, чтобы ловить изменения в базах данных без задержки.
Доменные модели данных и схемы
- Сообщения имеют структуру, фиксируемую с помощью схематических форматов, например Avro или JSON Schema, где критически важны идентификаторы: transaction_id, account_id, customer_id, timestamp, amount, currency, transaction_type, статус.
- Нормализация ключей. Часто ключом становится composite field, например account_id#transaction_id или transaction_id как уникальный идентификатор, чтобы обеспечить корректное партиционирование и упорядочивание во времени.
- Верификация данных. Вводятся схемы в Schema Registry, чтобы предотвратить несовместимость изменений в структурах и обеспечить безопасность совместной эксплуатации разных версий потребителей.
{
  "type": "record",
  "name": "FinancialTransaction",
  "fields": [
    {"name": "transaction_id", "type": "string"},
    {"name": "account_id", "type": "string"},
    {"name": "customer_id", "type": "string"},
    {"name": "amount", "type": "double"},
    {"name": "currency", "type": "string"},
    {"name": "transaction_type", "type": "string"},
    {"name": "ts", "type": {"type": "long", "logicalType": "timestamp-millis"}}
  ]
}
Безопасность и соответствие требованиям
- Протоколы и шифрование. Используются TLS/SSL для защиты данных в пути, а также SASL/SCRAM или OAUTHBEARER для аутентификации и авторизации компонентов.
- Контроль доступа и аудит. Встроенное в тему разграничение доступа по ролям, аудит событий и журналирование операций - критически важно для регуляторных требований.
- Именно-один и транзакционность. Поддержка транзакций на уровне продюсера и целостности графа обработки событий; удержание точек смещения и возможность отката через commit/abortTransaction.
Интеграционные сценарии и паттерны
- CDC из банковских систем. Debezium и Kafka Connect используются для непрерывной синхронизации изменений из СУБД (PostgreSQL, Oracle, SQL Server) в темах Kafka, что упрощает построение единого источника истинных данных для аналитики и управления рисками.
- Консолидированные потоки операций. Транзакционные события публикуются в тему finance.transactions; страхование, аудит и регуляторная отчетность подписываются на смежные темы, например finance.audit или finance.risk.
- Аналитика в реальном времени. Kafka Streams и ksqlDB применяются для расчёта важных показателей, таких как мгновенная финансовая устойчивость, суммарные объёмы по счетам и обнаружение аномалий, с передачей результатов в системы BI/EDW.
// Пример конфигурации транзакционного продюсера Java ## Properties props = new Properties(); props.put("bootstrap.servers", "broker1:9092,broker2:9092"); props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("enable.idempotence", "true"); props.put("transactional.id", "txn-fin-processor-01"); // security props.put("security.protocol", "SASL_SSL"); props.put("sasl.mechanism", "SASL_SSL"); Producerproducer = new KafkaProducer(props); producer.initTransactions(); producer.beginTransaction(); producer.send(new ProducerRecord("finance.transactions", key, value)); producer.send(new ProducerRecord("finance.audit", auditKey, auditValue)); producer.commitTransaction(); Интеграции и инфраструктура
- Kafka Connect для источников и приемников. Коннекторы Debezium, коннекторы S3/warehouse для выгрузки архивов и аудита, коннекторы консолидирования данных в EDW и в Data Lake.
- Аналитика и мониторинг потоков. Важна интеграция с системами мониторинга (Prometheus, Grafana) и трассировка задержек в конвейери, а также использование компенсационных механизмов на стороне потребителей.
- Архитектура данных и хранение. В целях аудита и ретенции применяются стратегии с лог-ретеншн и лог-джерри, а также продуманные правила переработки и очистки старых записей.
Телеком
Телекоммуникационная отрасль характеризуется огромной величиной событий, высокой частотой и необходимостью немедленного реагирования на инциденты: аналитика телеметрии, обработка CDR, мониторинг сетей и пользовательских сервисов. Kafka выступает как единая платформа интеграции телеком-ивентов, позволяя масштаировать обработку и поддерживать согласованность между фронтендом, сетевой инфраструктурой и бэкендом.
Архитектурные принципы
- Распределённая обработка телеметрии и CDR. События публикуются в темы по типу события (call_event, data_usage, network_alert), затем потребляются несколькими консьюмерами для разных целей: биллинг, мониторинг, аналитика.
- Фан-оптика к подпискам и ретрансляциям. Один источник данных может быть подписан несколькими потребителями, которые выполняют разную логику обработки - от агрегаций до детектирования аномалий.
- Географическая сегментация и балансировка. Партиционирование по региону или по идентификатору сессии позволяет локализовать обработку и снизить задержку.
Доменные модели данных и схемы
- CDR и телеметрия. Основные поля: call_id, caller_id, callee_id, start_ts, duration_sec, bytes_transferred, location, tariff_plan. В данных часто используются декодированные схемы с дополнительными полями для сетевых характеристик.
- Стратегии деградации данных. В случае коротких задержек или перегрузки система может выводить упрощённые показатели, сохраняя ключевые поля для аудита и ретроспективного анализа.
{
  "type": "record",
  "name": "CallDetailRecord",
  "fields": [
    {"name": "call_id", "type": "string"},
    {"name": "caller_id", "type": "string"},
    {"name": "callee_id", "type": "string"},
    {"name": "start_ts", "type": {"type": "long", "logicalType": "timestamp-millis"}},
    {"name": "duration_sec", "type": "int"},
    {"name": "bytes_transferred", "type": "long"},
    {"name": "region", "type": "string"},
    {"name": "tariff_plan", "type": "string"}
  ]
}
Безопасность и соответствие требованиям
- Защита данных в пути и на хранении. Протоколы TLS и поддержка аутентификации через SASL/PLAIN или OAuth2 обеспечивают защиту на уровне канала и доступа к данным.
- Управление доступом и аудит. Назначение ролей на уровне тем и отдельных операций, журналирование доступа и изменений параметров конвейера.
- Согласованность и отказоустойчивость. Репликация и устойчивость к потере узлов, мониторинг задержек и использование транзакций для обеспечения целостности операций с учётом времени жизни данных.
Интеграционные сценарии и паттерны
- Мониторинг сетевых сервисов на реальном времени. Пайплайны распределяются: сбор телеметрии, агрегация по региону, отправка аномалий в систему_alerts и подсистема биллинга.
- Реализация детектирования мошенничества. Аналитические компоненты работают с потоками событий, чтобы выявлять подозрительную активность по признакам, таким как необычные последовательности вызовов и резкие изменения в трафике.
- Интеграция с данными централизованных биллинговых систем и дата-центров. Коннекторы к хранилищам и аналитическим платформам позволяют строить единый источник правды по всем пользователям.
Розничная торговля
Розничная торговля оперирует событиями в реальном времени: продажи, инвентарь, акции и персонализация. Kafka позволяет строить конвейеры данных, связывающие точки кассы, онлайн-магазин и складской учет, обеспечивая единое и согласованное представление об исполнении заказов и запасах.
Архитектурные принципы
- Потоки по жизненному циклу товара. Появляется набор тем:-инвентory, orders, pricing, promotions, events. Это позволяет независимым сервисам быстро реагировать на каждое событие.
- Интеграция с системами управления запасами. Потоки событий позволяют поддерживать актуальность складских остатков, предлагать персонализированные акции и корректировать ценообразование в реальном времени.
- Аналитика потребительского поведения. Потоки кликов и транзакций приводят к немедленной персонализации и таргетированной рекламе, а также к прогностической аналитике спроса.
Доменные модели данных и схемы
- Инвентарь и продажи. Поля: product_id, sku, location_id, stock_level, price, sale_flag, timestamp. События продажи и пополнения запасов записываются в отдельные темы.
- Персонализация и клики. Потребительские клики и транзакции объединяются по user_id и session_id для формирования сегментов и рекомендаций.
- Агломеративная очистка и консолидация. Используются паттерны агрегации по времени (WINDOWS) и доп. шаги нормализации цены и валидности данных.
{
  "type": "record",
  "name": "InventoryUpdate",
  "fields": [
    {"name": "product_id", "type": "string"},
    {"name": "location_id", "type": "string"},
    {"name": "stock_level", "type": "int"},
    {"name": "ts", "type": {"type": "long", "logicalType": "timestamp-millis"}}
  ]
}
Безопасность и соответствие требованиям
- Защита клиентских данных и PCI-DSS. Обеспечивается минимизация и маскирование чувствительных данных, а также ограничение доступа к платежной информации на основании ролей.
- Логирование и аудит. Ведение аудита транзакций по заказам, возвратам и складам, а также мониторинг доступа к данным, чтобы удовлетворять требованиям внутренних регуляторных команд и внешних аудитов.
Интеграции и инфраструктура
- Интеграция POS-терминалов и онлайн-магазина. Потоки событий связывают операции в магазинах, онлайн-клиентский сегмент и систему управления запасами.
- Хранение и аналитика. Коннекторы к хранилищам данных центрального офиса, data lake и BI-платформам, для ретроспективной аналитики и отчетности по продажам, запасам и эффективности акций.
- Управление качеством данных. Нормализация цен, валютные конверсии, согласование идентификаторов продуктов между каналами.
Здравоохранение
Здравоохранение требует особого подхода к конфиденциальности, совместимости с медицинскими стандартами и аудируемости. Потоки данных позволяют междисциплинарной команде врачей, лабораторий, страховых компаний и регуляторов работать на единой платформе, обеспечивая своевременный доступ к жизненно важной информации и контроль версий данных.
Архитектурные принципы
- Информационные потоки пациентов. События охватывают регистрации, лабораторные анализы, измерения vitals, обмен между системами EHR и инфраструктурой ради медицинских данных.
- Регуляторная совместимость и аудируемость. Встраиваются механизмы аудита доступа и изменений, чтобы соответствовать нормам конфиденциальности и медицинской этики.
- Data lineage и управление версиями. Трассируемость источников и изменений поддерживает юридическую и клиническую обоснованность данных.
Доменные модели и схемы
- PHI и анонимизация. Стратегии минимизации персональных данных, псевдонимизации и маскирования, чтобы минимизировать риск нарушения конфиденциальности.
- События медицинских измерений. Поля включают patient_id, event_type (вкладка, измерение), value, unit, timestamp, источники данных.
{
  "type": "record",
  "name": "VitalSignEvent",
  "fields": [
    {"name": "patient_id", "type": "string"},
    {"name": "vital", "type": "string"},
    {"name": "value", "type": "double"},
    {"name": "unit", "type": "string"},
    {"name": "ts", "type": {"type": "long", "logicalType": "timestamp-millis"}},
    {"name": "source", "type": "string"}
  ]
}
Безопасность и соответствие требованиям
- PHI и контроль доступа. Принципы наименьших привилегий, аудит доступа к данным, сегментация по ролям медицинского персонала и учреждений.
- Регуляторная совместимость. Соответствие требованиям здравоохранения (мультирегиональные политики хранения, доступ к данным, согласие пациента, ретенции).
Интеграционные сценарии и паттерны
- Интеграция EHR/EMR и лабораторных систем. Реализация единого канала сообщений для клинических данных, обеспечивающего целостность и последовательность событий.
- Фоновая аналитика и клинические решения. Потоки данных используются для реального времени, чтобы поддерживать мониторинг пациентов, сигнализацию об изменениях состояния и принятие решений врачами.
- Обеспечение аудита и трассируемости. Важна возможность воспроизведения цепочек событий и предоставления регуляторному надзору детализированных журналов.
Key takeaways
- Kafka выступает критическим инструментом для построения единых, устойчивых и масштабируемых потоковых пайплайнов в разных отраслях, с учётом отраслевых требований к задержкам, надёжности и безопасности.
- Архитектура должна поддерживать Exactly-Once семантику, транзакции и CDC-источники, чтобы обеспечить согласованность данных между системами в реальном времени.
- Доменные модели и схемы данных требуют строгой версионности и совместимости через Schema Registry, чтобы управлять эволюцией сообщений без потери совместимости потребителей.
- В интеграциях важны коннекторы (Kafka Connect, Debezium) и средства обработки (Kafka Streams, ksqlDB), а также продуманная стратегия хранения, ретенции и аудита.
- В вопросах безопасности необходимо сочетать криптографию, контроль доступа и аудит, а также учитывать требования отраслевых регуляторов (регистрация источников данных, журналирование, уничтожение данных по срокам).
- Реализационные паттерны включают CDC для синхронизации источников, обработку потока в реальном времени, агрегации на уровне окон и маршрутизацию событий к различным потребителям и системам.
- Важно сочетать практики проектирования пайплайнов с организационными изменениями: совместная ответственность между командами DevOps, инженерами данных, аналитиками и бизнес-стейкхолдерами, чтобы обеспечить управляемый подход к росту объемов данных и сложности архитектуры.
FAQ
- Что такое Exactly-Once семантика и зачем она нужна в финансовых пайплайнах?
Exactly-Once (X/1) обеспечивает, что каждое событие обрабатывается ровно один раз, даже в случае повторных попыток и сбоев. В финансах это критично: дублирующиеся транзакции могут привести к ошибкам в учёте, аудите и регуляторной отчетности. Реализация достигается через транзакционные продюсеры, Idempotent Producers и координацию между отделами с использованием TransactionalId, а также строгий контроль смещений и консистентности потребителей.
- Какие паттерны выбирают для CDC в банковских системах?
Чаще всего применяют Debezium через Kafka Connect для извлечения изменений из реляционных баз данных в поток Kafka. Этот подход позволяет быстро синхронизировать состояние систем и поддерживать единый источник правды. Важно настроить корректную обработку конфликтов и управлять задержками, а также обеспечить согласование схем через Schema Registry.
- Какой выбор архитектурных компонентов минимизирует задержку при большом количестве событий?
Универсальный подход - разделить каналы по тематике (transactions, risk, audits) и использовать горизонтальное масштабирование консьюмеров, параллельные окна для агрегаций и кэширование на уровне потребителей. В критичных случаях применяется Kafka Streams или ksqlDB для быстрого вычисления агрегатов в потоке, без обращения к внешним базам.
- Какие меры безопасности актуальны для отраслевых пайплайнов?
Применяются TLS/SSL на транспорте, аутентификация через SASL/OAUTH2, разграничение доступа по ролям на уровне тем, аудит операций и журналирование, защита PHI и PII, а также регуляторные требования к ретенции и уничтожению данных. Все изменения схемы проходят через централизованный процесс управления версиями схем.
- Какую роль играет Schema Registry в отраслевых пайплайнах?
Schema Registry обеспечивает совместимость версий сообщений и упрощает интеграцию между продюсерами и консьюмерами. В финансовом секторе это критично, чтобы новые версии схем не ломали существующих потребителей. Он также поддерживает концепцию эволюции схем и управление совместимостью backward/forward.
- Какие паттерны используются для минимизации задержек между торговыми системами?
Паттерн консолидации в реальном времени: прямой публикующий/потребляющий обмен между сервисами, минимальные преобразования сообщений и быстрое принятие решений через реального времени обработку. Дополнительно применяют оконные агрегации и лимитирование задержек с использованием резидентного кэширования и предикативной маршрутизации.
- Какие типичные ошибки в проектировании отраслевых пайплайнов следует избегать?
Игнорирование регуляторных требований к аудиту, несоответствие схем данным, слишком агрессивная ретенция без плана уничтожения, игнорирование целей задержки, недооценка мониторинга и наблюдаемости, отсутствие стратегии тестирования изменений в схемах и конвейерах.
- Как выбрать между Kafka Streams и Kafka Connect в конкретной отрасли?
Kafka Connect эффективен для интеграции внешних источников и приемников данных (CDC, базы данных, хранилища). Kafka Streams удобен для реализации преобразований, агрегаций и бизнес-логики непосредственно в потоках. В зависимости от требований к нити обработки и скорости изменений можно сочетать оба подхода: Connect для источников, Streams/ksqlDB для обработки.
- Какие практики мониторинга и управления качеством данных эффективны в больших пайплайнах?
Используются метрики задержки, объёмов, ошибок, потребительских ливалей и ретенции. Валидационные шаги и строгие проверки схем, контроль уникальности транзакций, а также автоматизированные тесты и canary-обновления схем и конвейеров помогают поддерживать качество данных.
- Какие отраслевые примеры внедрений иллюстрируют подходы к архитектуре?
Примеры включают: (1) банковский риск и платежи с транзакционными конвейерами, (2) телекоммационные системы с обработкой CDR и аналитикой в реальном времени, (3) розничные сети с объединением онлайн и офлайн продаж и управления запасами, (4) здравоохранение с обменом клиническими данными и аудитом. В каждом случае применяются архитектурные принципы, позволяющие объединить данные из разнородных систем, обеспечить безопасность и соответствие требованиям, а также поддержать оперативную аналитику и регуляторные отчеты.
Эта глава подчеркивает, что архитектура Kafka для отраслевых пайплайнов - не только про технологию. Это про баланс между задержками, гарантиями доставки и требованиями к безопасности, регуляторным нормам и бизнес-целям. Реалистичная реализация требует не только выбора инструментов, но и налаживания процессов совместной разработки, организации изменений, мониторинга и управления затратами на инфраструктуру.


