

Реализация пайплайнов: lifecycle, версионирование, тестирование, релизы
В контексте аналитических хранилищ на базе Apache Spark создание пайплайнов - это не просто последовательность преобразований данных, а управляемый процесс с детерминированной логикой, обеспечивающей повторяемость, соответствие требованиям качества и возможность отката к предыдущим версиям. Эффективная реализация пайплайнов требует интеграции архитектурных паттернов, механизмов версионирования, подходов к тестированию и зрелых релизных практик. В этой главе рассматриваются принципы проектирования и операционного управления пайплайнами Spark для аналитических хранилищ, включая роль Delta Lake как слоя хранения с поддержкой ACID и эволюции схем, а также выбор инструментов оркестрации, мониторинга и обеспечения соответствия.
Глубина обсуждения ориентирована на техническую аудиторию: как строятся конвейеры, какие протоколы и контракты данных применяются, как достигается повторяемость и как автоматизируются релизы. Рассматриваются архитектурные решения, алгоритмические подходы к обработке потоковых и пакетных данных, стратеги интеграции с каталогами данных и инструментами контроля качества. В конце главы представлены практические чек-листы, примеры реализации и рекомендации по внедрению в рамках корпоративной среды.
- Архитектура и жизненный цикл пайплайна Spark для аналитических хранилищ
- Версионирование данных и кода
- Тестирование пайплайнов: методики, инфраструктура и чек-листы
- Релизы пайплайнов: стратегии, CI/CD, мониторинг и операционная устойчивость
Архитектура пайплайна Spark для аналитических хранилищ
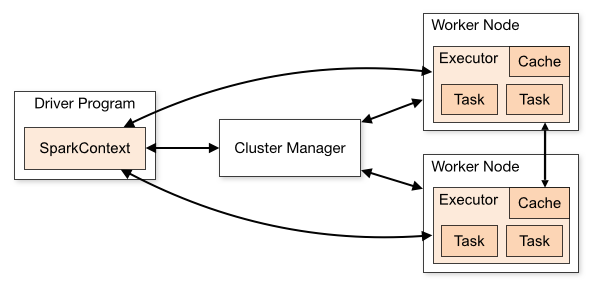
Порождает необходимость создания устойчивой архитектуры, объединяющей источники данных, этапы обработки и хранилище, обеспечивающие консистентность и доступность для аналитики. Основной подход - конвейер, который объединяет ingestion, обработку и запись в ленточно-структурированную или таблицу-ориентированную систему хранения с поддержкой версий. В контексте Spark это часто включает:
- Ингестирование данных через коннекторы к источникам (Kafka, файловые системы, облачные хранилища, JDBC-источники) с поддержкой backpressure и повторного выполнения.
- Платформу обработки - Spark Structured Streaming или пакетные задачи, осуществляющие трансформации, агрегации и финальные стадии подготовки данных для аналитики.
- Хранилище данных - слой на основе Delta Lake или аналогичного формата, обеспечивающего ACID-транзакции, схему эволюцию и временную навигацию по данным.
- Каталог и управление метаданными - Hive Metastore, AWS Glue или аналогичный реестр метаданных, обеспечивающий единое именование, совместную схему и линейность данных.
- Мониторинг и наблюдаемость - журнал транзакций Delta Lake, Spark UI, метрики выполнения и алертинг в рамках оркестратора.
- Контракты данных и качество - интеграция с инструментами валидации данных на стороне пайплайна (data contracts), например Great Expectations или Deequ.
Ниже приведена наглядная структура основных этапов пайплайна и их ключевые требования.
| Этап пайплайна | Ключевые требования |
|---|---|
| Ингестирование | Надежные коннекторы, устойчивость к сбоям, обратная совместимость форматов, упорядочивание по времени события |
| Преобразование | Idempotentность операций, корректная обработка окон, обработка ошибок без потери данных, повторное выполнение без нежелательных эффектов |
| Хранение | ACID-семантика, поддержка версий и эволюции схем, эффективная компрессия и индексирование, частые изменения данных без блокировок |
| Метаданные | Линейность источников, отслеживание происхождения данных, управление версиями схем и артефактов (код/конфиги) |
| Мониторинг и качество | Наблюдаемость конвейера, контрольные точки качества, алерты и реакции на деградацию |
Архитектурные решения должны обеспечивать адаптивность к изменению объема данных, поддерживать параллелизм выполнения и минимизировать дублирование вычислений. В качестве примера практики рассмотрим сценарий, где данные поступают в Delta Lake через потоковый источник, после чего применяются трансформации и записываются в укрупненное хранилище с версионной историей. В таком случае важно обеспечить детерминированную логику слияния (MERGE) и корректную обработку обновлений и удалений, поскольку к аналитическим потребностям часто требуется точное соответствие историческим состояниям.
from delta.tables import DeltaTable

## Пример upsert-логики для Delta Lake
delta_table = DeltaTable.forPath(spark, "/data/warehouse/sales")

source_df = spark.read.parquet("/tmp/ingest/sales_updates")
delta_table.alias("t").merge(
    source_df.alias("s"),
    "t.id = s.id"
).whenMatchedUpdate(set={"t.amount": "s.amount"})
 .whenNotMatchedInsert(values={"id": "s.id", "amount": "s.amount"})
 .execute()
Роль протоколов и контрактов в архитектуре - ключевой аспект: они формулируют ожидаемые свойства пайплайна, такие как последовательность обработки, требования к задержкам и критерии качества, которые должны быть соблюдены на каждом этапе. В современных реалиях полезно рассматривать пайплайны как кодовую единицу: хранение конфигураций и трансформаций в системах контроля версий, тестирование изменений и автоматическое развёртывание в средах dev/staging/prod.
Lifecycle пайплайнов: от идеи до продакшена
Жизненный цикл пайплайна начинается с концепции и дизайна и завершается устойчивым продакшеном с механизмами отката и обновления. Эффективная реализация требует строгих правил версионирования артефактов, окружений и данных, а также четких процессов изменения и утверждения.
Ключевые принципы:
- Контракты и согласованность: данные и код должны иметь версии, которые можно соотнести через все окружения.
- Idempotentность и детерминированность: повторное выполнение должно приводить к одинаковым результатам без побочных эффектов.
- Эволюция схем: поддержка изменений в структурах данных без ломки текущих рабочих процессов (через Delta Lake и схемовые эволюционные механизмы).
- Отладочная трассируемость: полноценно отслеживаются источники данных, версии таблиц и вычислительные шаги.
- Разделение среды: dev, test, staging и prod - с отдельными конфигурациями и правами доступа.
- Мониторинг качества: на входе и выходе каждого этапа - проверки качества, предупреждения и политики отката при нарушениях.
Разработка и внедрение пайплайнов часто реализуется через паттерны «конвейеры как код» и «инфраструктура как код» (IaaC). Это обеспечивает управляемость изменений, повторяемость и возможность автоматизации развёртывания.
Практический подход к реализации жизненного цикла:
- Разработка и версияция: все трансформации и конфигурации хранится в системе контроля версий. Глава рекомендует использовать ветвление по функциональности, чтобы изолировать изменения, и четкие правила мержей через ревью кода.
- Среды и конфигурации: окружения разворачиваются через шаблоны инфраструктуры (например, конфигурации кластера Spark, Delta Lake, каталога метаданных). Вплоть до параметризации путей к данным и источникам.
- Контроль качества: на стадии разработки внедряются тесты трансформаций, а на стадии интеграции - end-to-end тесты, проверяющие соответствие бизнес-правилам и качеству данных.
- Управление изменениями: любые изменения в пайплайне должны проходить через согласованный процесс утверждений, регистрируемый в журнале изменений и снабжаемый чек-листами готовности к релизу.
- Откат и устойчивость: наличие плана отката, снимков версий и возможности повторного воспроизведения состояния данных.
Диаграммы и практические принципы жизненного цикла помогают формализовать эти этапы. Примерно можно представить последовательность: идея → дизайн → реализация → тестирование → стейджинг/производство → мониторинг → обновление/откат. Важно помнить: чем более детально зафиксирована каждая стадия и чем прозрачнее механизмы проверки, тем меньше неожиданностей при переходе в продакшен.
Версионирование данных и кода
Версионирование - это фундамент устойчивого операционного режима данных: один и тот же пайплайн может обрабатывать наборы данных в разных состояниях, но без деградации качества или согласованности. В контексте Spark-пайплайнов ключевые аспекты включают:
- Версионирование кода пайплайна: хранение конфига и трансформаций в системе контроля версий, использование тегов и релизных веток, чтобы можно было воспроизвести конкретную сборку пайплайна.
- Версионирование данных: Delta Lake предоставляет версионирование таблиц и временную навигацию (time travel), что позволяет восстанавливать состояние данных на конкретный момент времени.
- Эволюция схем: поддержка изменений схем без прерывания рабочих процессов, что особенно важно для больших аналитических хранилищ, где изменения логики запроса требуют адаптации данных.
- Контракты данных: формализованные ожидания по качеству данных и структурам, которые должны соблюдаться всеми шагами конвейера. Контракты облегчают проверку и регрессию.
Практические инструменты и подходы:
- Git и ветвление по задачам: каждая функциональная правка пайплайна - отдельная ветка, которая затем проходит ревью и мерджится в основную ветку после прохождения тестов.
- Delta Lake для версий: при записи в Delta Lake используются транзакции, поддерживается версионирование таблиц и возможность вернуться к предыдущей версии через TIME TRAVEL.
- Тестирование контрактов: применение инструментов вроде Great Expectations или Deequ для проверки требований к данным и контрактов, до записи в хранилище.
- Контракты против несовместимости схем: прежде чем обновлять схему, необходимо протестировать существующие потребители и миграцию.
Пример: работа с временной навигацией Delta Lake
-- Пример версии данных с использованием Delta Lake
SELECT * FROM sales_table VERSION AS OF 25; -- просмотр состояния на конкретной версии
SELECT * FROM sales_table TIMESTAMP AS OF TIMESTAMP '2024-06-01 12:00:00';
Пример: upsert-операции в Delta Lake для поддержания консистентности при обработке обновлений
from delta.tables import DeltaTable

delta_table = DeltaTable.forPath(spark, "/data/warehouse/sales")

source_df = spark.read.parquet("/tmp/ingest/sales_updates")
delta_table.alias("t").merge(
    source_df.alias("s"),
    "t.id = s.id"
).whenMatchedUpdate(set={"t.amount": "s.amount"})
 .whenNotMatchedInsert(values={"id": "s.id", "amount": "s.amount"})
 .execute()
Понимание и планирование версионирования требует учета того, какие артефакты должны иметь версии: код пайплайна, конфигурации, скрипты миграции схем, сами данные и их структура. В условиях крупных корпораций этот набор артефактов должен быть согласован между бизнес-правилами, регуляторными требованиями и требованиями к аудиту.
Тестирование пайплайнов: подходы, инфраструктура и чек-листы
Тестирование пайплайнов Spark - ключ к гарантированной повторяемости и предсказуемости результатов. В рамках технической главы выделяются три уровня тестирования: модульное тестирование трансформаций, интеграционные тесты конвейера и тестирование данных на уровне качества.
- Модульное тестирование трансформаций: тесты, проверяющие конкретные функции и преобразования на малыми данными. Часто реализуется с использованием PyTest или аналогичных фреймворков, с локальным созданием SparkSession.
- Интеграционные тесты пайплайна: тесты, проверяющие цепочку преобразований на тестовом наборе данных, приближенным к реальному объему и структуре источников. Включают проверки чтения/записи и совместимости с внешними системами.
- Тестирование качества данных: применение контрактов данных, проверка порогов точности, полноты, валидности и согласованности. Инструменты: Great Expectations, Deequ.
- Регрессионные тесты и детерминированность: Ensuring deterministic outputs even with non-deterministic aspects работы Spark и внешних систем.
Рекомендации по инфраструктуре тестирования:
- Локальный Spark-тестовый набор и консольные проверки на уровне функций.
- Легковесные интеграционные тесты на небольшом кластере или с использованием локального режима.
- Изоляция тестовых данных: создание тестовых наборов данных в репозиториях тестов и возможность повторного использования.
- Управление зависимостями: контроль версий библиотек для соответствия тестовым условиям.
Пример теста трансформации на PySpark
import pytest
from pyspark.sql import SparkSession

def test_transform_sum(spark: SparkSession):
    input_df = spark.createDataFrame(
        [(1, 2), (3, 4)],
        ["group_id", "value"]
    )
    result = transform_dataframe(input_df)  # функция трансформации
    assert result.filter("group_id = 1").collect()[0]['value'] == 2
Чек-лист для тестирования:
- Проверка корректности входных данных (поля, типы, пропуски).
- Проверка граничных кейсов и аномалий данных.
- Проверка согласованности промежуточных результатов и целевых агрегатов.
- Валидация контрактов данных не менее чем на двух этапах конвейера.
- Регрессионные тесты для ключевых сценариев и обновлений бизнес-логики.
Совокупный подход к тестированию позволяет минимизировать риск дефектов в продакшн и обеспечивает более предсказуемую поведенческую модель пайплайна.
Релизы пайплайнов: стратегии, CI/CD, мониторинг и операционная устойчивость
Эффективная релизная практика обеспечивает безопасный переход изменений в продакшен с минимальными простоями и рисками. В этом разделе рассматриваются стратегии релизов, автоматизация развёртывания и требования к мониторингу.
Стратегии релизов:
- Blue/Green: параллельные production-окружения, переключение трафика на новую версию после проверки.
- Canary: постепенное развёртывание новой версии на ограниченной части данных или пользователей, с мониторингом и возможностью отката.
- Feature flags: включение новых возможностей через флаги, чтобы частично тестировать функциональность.
- Релиз через DAG версии: для оркестраторов (например, Apache Airflow) - управление версиями DAG, модулями и зависимостями.
CI/CD и пайплайны:
- Контролируемые сборки артефактов пайплайна и их версии: код, скрипты миграций, конфигурации, данные.
- Тестовые окружения: автоматическое развёртывание в dev/staging, выполнение тестов и валидаций перед релизом в prod.
- Инструменты для CI/CD: GitHub Actions, GitLab CI/CD или аналогичные; интеграция с системами мониторинга и уведомления.
- Поставщики конфигураций: хранение конфигураций и параметров в виде кода, поддержка параметризации для разных сред.
Мониторинг и операционная устойчивость:
- Метрики пайплайна: время выполнения, пропускная способность, доля ошибок, задержки на каждом этапе.
- Трассировка и журналирование: детальный аудит каждой транзакции, журнал изменений Delta Lake.
- Алгоритмы автоматического отката: поддержка отката к предыдущей версии данных и пилотная проверка на предмет ожидаемого поведения после отката.
- Мониторинг качества данных: интеграция с контрактами данных и автоматические уведомления при выходе за пороги.
Пример YAML-скрипта для CI/CD релиза пайплайна (часть GitHub Actions)
name: Spark Pipeline CI/CD
on:
  push:
    branches: [ main ]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - **name**: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'
      - **run**: |
          pip install pyspark pytest great_expectations
      - **run**: pytest
  deploy_canary:
    needs: test
    runs-on: ubuntu-latest
    if: github.event_name == 'push'
    steps:
      - uses: actions/checkout@v3
      - **name**: Deploy to canary cluster
        run: |
          echo "Deploying to canary environment..."
Помимо автоматизации важно обеспечить план действий в случае инцидентов: откат конфигураций, повторное создание состояния данных, возврат к предыдущей версии конвейера и четко задокументированные процедуры.
Архитектура релиза пайплайна требует также согласованности между версиями кода, миграций схем и бизнес-требований. Чек-листы готовности к релизу должны включать согласование версий артефактов, проверку требований к качеству данных, подтверждение совместимости потребителей данных и доступности мониторинга.
Key takeaways
- Эффективный пайплайн Spark для аналитического хранилища требует строгой архитектуры, поддерживающей версионирование данных и кода, а также эволюцию схем без прерывания рабочих процессов.
- Delta Lake обеспечиваетACID-согласованность, временную навигацию по данным и схемную эволюцию, что критично для повторяемости и аудита.
- Контракты данных и инструменты качества данных позволяют вовремя выявлять несоответствия и снижать риск в продакшен-среде.
- Жизненный цикл пайплайна должен строго отделять окружения, поддерживать миграции и иметь четкие процедуры отката.
- Тестирование пайплайна должно охватывать модульность, интеграции и качество данных с использованием контрактов и регрессионных сценариев.
- Релизы требуют автоматизации CI/CD, стратегий canary/blue-green и надежного мониторинга для оперативной устойчивости.
- В рамках архитектуры важно документировать набор артефактов и обеспечить их версионность, чтобы можно было воспроизводить результаты и аудит.
FAQ
- Что такое lifecycle пайплайна в контексте Spark и аналитических хранилищ?
- Lifecycle пайплайна охватывает стадии разработки, тестирования, внедрения и эксплуатации конвейера. Включает архитектурные решения, контроль версий, обеспечение качества данных, мониторинг и механизмы отката. В рамках Spark жизненный цикл требует учета особенностей обработки больших данных, поддержки как пакетной, так и потоковой обработки, а также устойчивого хранения результатов в формате, обеспечивающем версионирование и эволюцию схем.
- Как выбрать стратегию версионирования для данных и кода?
- Рекомендуется сочетать версионирование кода через систему контроля версий и версионирование данных через Delta Lake. Это позволяет не только воспроизводить конкретные сборки пайплайна, но и возвращаться к историческим состояниям данных. Контракты данных и миграции схему также должны иметь версии, чтобы согласовать изменения между стейджингом и продакшеном.
- Как обеспечить идемпотентность и повторяемость пайплайна?
- Идемпотентность достигается за счет детерминированных транзакций, например, операций MERGE в Delta Lake, и отсутствия побочных эффектов при повторном запуске. Важно фиксировать параметры входных данных и управлять уникальными ключами транзакций, чтобы повторный прогон не приводил к дублированию или несогласованности.
- Какие подходы к тестированию пайплайнов являются критическими?
- Модульное тестирование трансформаций, интеграционные тесты на репризируемых данных и тестирование качества через контрактные проверки являются ключевыми. Регрессионные тесты помогают предотвращать повторное появление ошибок после обновлений. Важно внедрить тестовую стратегию, охватывающую все слои пайплайна - от источников до потребителей.
- Какие инструменты наиболее полезны для мониторинга пайплайнов?
- Spark UI и мониторинг выполнения задач, Delta Lake транзакционный журнал, метрики оркестратора (например, Apache Airflow или Kubeflow), а также специальные дашборды по качеству данных и SLA. Нередко применяются внешние инструменты алертинга и централизованного логирования.
- Как организовать релизы пайплайнов?
- В релизной практике применяют стратегии blue/green, canary и feature flags. Важна сильная автоматизация через CI/CD: автоматическое тестирование, миграции схем и верификация качества данных. Мониторинг после релиза должен быть настроен на раннее обнаружение деградаций и быстрый откат.
- Как обеспечить эволюцию схем и совместимость потребителей?
- Эволюцию схем следует проводить через контролируемые миграции и sravnenie совместимости между версиями данных и кодовых артефактов. Delta Lake поддерживает schema evolution и безопасное добавление столбцов. Важно тестировать потребителей на новой схеме и поддерживать обратную совместимость, где это возможно.
- Где лучше применить контракты данных и как их внедрять?
- Контракты данных полезны на уровне входов и выходов трансформаций, особенно в kritических бизнес-логиках (финансовые данные, клиенты и т. п.). Их внедрение через инструменты наподобие Great Expectations или Deequ обеспечивает автоматическую проверку соблюдения требований к данным и упрощает регрессию.
- Какие интеграции особенно важны для корпоративной среды?
- Интеграции со складами и каталогами данных (Delta Lake, Hive Metastore, AWS Glue), управление конфигурациями и секретами, оркестраторами задач (Airflow, Dagster). В контексте Spark-пайплайнов стоит уделить внимание совместимости версий и доступности данных в рамках бизнес-правил и политики безопасности.
- Как начать внедрять практики lifecycle и версионирования в существующий проект?
- Начать можно с формирования базовой архитектуры пайплайна: определить источники, слой обработки и целевое хранилище. Ввести хранение конфигураций и трансформаций в систему контроля версий, настроить Delta Lake с версионированием и базовые контракты данных. Затем реализовать набор модульных тестов и интеграционных тестов, запустить canary-слой и постепенно расширять область действий до всей цепочки, сопровождая релизы непрерывной проверкой качества.


