

Кейсы внедрения Spark: финансы, розничная торговля, телеком и промышленность
Spark занимает центральное место в современных архитектурах аналитических хранилищ благодаря способности объединять пакетную и потоковую обработку, поддержке разнообразных источников данных и интеграции с концепцией lakehouse. В этой главе рассмотрены практические кейсы внедрения Spark в четырех отраслях: финансы, розничная торговля, телеком и промышленность. Для каждого кейса освещаются архитектурные решения, требования к данным, протоколы интеграции, подходы к управлению качеством данных и аспекты оптимизации производительности в контексте аналитических хранилищ. Акцент сделан на том, как организовать устойчивый, управляемый и масштабируемый пайплайн, который сохраняет консистентность данных, поддерживает требования к безопасности и обеспечивает прозрачность для бизнес-пользователей и регуляторов.
Фокус главы - баланс между архитектурной структурой и практическими шагами внедрения: от выбора технологических компонентов и форматов хранения до эксплуатации и мониторинга. Примеры и рекомендации опираются на практические случаи, где Spark применялся для обработки миллионов или сотен миллионов событий в сутки, включая ретроспективный анализ, прогнозирование и реактивную обработку. В материалах представлены принципы проектирования, которые позволяют переходить от монолитного к lakehouse-ориентированной архитектуре, сохраняя при этом прозрачность для аналитиков, инженеров и руководителей.
- Обобщение архитектурных паттернов, применимых к разным отраслям, включая lakehouse, Delta Lake и механизмы управления схемами.
- Особенности обработки транзакционных и потоковых данных в рамках аналитического хранилища.
- Практики интеграции Spark с системами хранения данных, системами публикации и подписки на события и BI-инструментами.
- Практические маршруты миграции и принципы эксплуатации в реальном производстве.
- Финансы: обработка транзакций, риск-менеджмент и регуляторная отчетность
- Розничная торговля: персонализация, ценообразование и управление ассортиментом
- Телеком: обработка потоков и реального времени, биллинг и мошенничество
- Промышленность: IIoT, предиктивная аналитика и обслуживание
Финансы: обработка транзакций, риск-менеджмент и регуляторная отчетность
Финансовый сектор генерирует крайне большие объемы структурированных и полуструктурированных данных: транзакционные логи, рынковые данные, метрики по рискам и комплаенсу. В рамках аналитического хранилища Spark применяется как для пакетной обработки исторических данных, так и для онлайн-аналитики в режиме near real-time. Архитектурно это часто реализуется через единый lakehouse-пайплайн: ingest через брокеры сообщений, промежуточные слои в Хранилище данных, обработку в Spark и запись результатов в управляемый репозиторий (Delta Lake) с поддержкой ACID и Time Travel.
Ключевые аспекты реализации:
- Ингестинг и интеграция источников: банковские транзакции, сделки на рынке, логи приложений и внешние данные (например, рейтинги контрагентов). Для стабильной загрузки применяются повторяемые паттерны: иш, кэширование схем, проверка целостности и повторная обработка без дубликатов.
- Архитектура lakehouse: сохранение исходных данных и агрегатов в Delta Lake или Apache Hudi; поддержка схемы Evolution и временных версий данных; управление качеством данных через Data Quality Rules и автоматическую коррекцию ошибок загрузки.
- Риски и комплаенс: построение конвейеров, которые позволяют прослеживаемость операций, детекцию аномалий и поддержание точных аудиторских журналов. Реализация прав доступа на уровне столбцов и данных через интеграцию với IAM/AD и политики masking-я.
- Производительность и масштабируемость: оптимизация планов выполнения через экранирование больших джойнов, использование кластеров Kubernetes или YARN, настройка Shuffle и Broadcast для крупных агрегаций, кэширование Hot Data в памяти для повторных запросов.
- Регуляторная отчетность: подготовка сложных агрегатов за периоды, обеспечение консистентности между пакетной обработкой и стриминговыми конвейерами, автоматизация выгрузки в регуляторные хранилища.
Пример концептуального конвейера:
# упрощенный пример Streaming-to-Batch конвейера
## источник: Kafka (платформа транзакций)
df = spark.readStream.format("kafka").option("subscribe","payments").load()

## преобразование и валидация
processed = df.selectExpr("CAST(value AS STRING) as json").select(from_json(col("json"), schema).alias("d")).select("d.*")

## запись в Delta Lake как streaming-запись
query = processed.writeStream.format("delta").option("path","/data/fin/streaming").option("checkpointLocation","/checkpoints/fin").start()

## последующая пакетная агрегация для регуляторной отчетности
agg = spark.read.format("delta").load("/data/fin/streaming").groupBy("account_id").agg(sum("amount").alias("total_amount"))
agg.write.mode("overwrite").format("parquet").save("/data/fin/reports/monthly")
Опыт показывает, что такой подход обеспечивает прозрачную историю изменений, упрощает регуляторную отчетность и позволяет бизнесу быстро реагировать на изменения рыночных условий. В то же время важными являются процессы управления изменениями схемы, тестирования конвейеров и мониторинга качества данных, особенно при интеграции данных из множества систем: банковских, риск-менеджмента и комплаенса.
Особенности реализации:
- Использование Delta Lakeили Apache Hudiдля обеспечения ACID-совместимости, контроля версий и поддержки временных срезов данных.
- Встраивание политики доступа на уровне данных и столбцов, а также маскирование для чувствительных данных.
- Оркестрация процессов через Airflow или аналог, с чёткими SLA и мониторингом задержек (latency) и throughput.
- Инструменты тестирования данных: наборы для регрессионного тестирования изменений схем и конвейеров, тестирование на качество и валидность транзакций.
Безусловно, реальная реализация в финансовой среде требует сотрудничества между бизнес-аналитиками, инженерами данных и службами комплаенса для выработки единого подхода к данным, их хранению и доступу к ним.
Розничная торговля: персонализация, управление каталогами и ценообразование
Ритейл обладает высокой динамикой изменений продукта, цен и клиентских предпочтений. Spark применяется для интеграции разрозненных источников данных: клики на сайте, данные POS, каталоги, промо-акции, данные лояльности и внешние источники. В рамках аналитического хранилища это приводит к созданию единого lakehouse-представления, позволяющего строить персонализированные сценарии, оперативную оптимизацию цен и управление ассортиментом.
Ключевые принципы реализации:
- Унификация источников данных: онлайн/оффлайн клики, транзакции, витринные данные каталога и цепочек поставок. Важно обеспечить согласование версий продукта и атрибутов, чтобы аналитика не зависела от текущих изменений в источниках.
- Каталог и SCD: для товарной номенклатуры применяются подходы Slowly Changing Dimensions (тип 2 и иногда тип 1) для сохранения исторической контекстности изменений цены, описания и состава товара.
- Персонализация и сегментация: Spark MLlib и интеграции с внешними системами ML позволяют строить рекомендательные модели, рейтинг акций, прогноз спроса. В рамках архитектуры возможно использование MLFlow для экспериментов и моделирования в production.
- Категоризация и ценообразование: использование прогнозов спроса по различным сегментам клиентов, цена-эластичность и динамическое ценообразование, с записью резульатов в аналитическое хранилище и обновление витрин.
Практическая реализация:
- Архитектура: ingestion через конвейеры данных (Kafka/NiFi), Lakehouse с Delta Lake, пакетная и стриминговая обработка Spark, данные в BI-слой через подключение к Data Warehouse.
- Интеграция с каталогами: синхронизация всех изменений каталога и цен, чтобы аналитика и витрины обновлялись без задержек.
- Мониторинг качества данных: автоматические проверки полноты, соответствия типов и единообразия категорий.
Пример упрощенного пайплайна:
# объединение кликов и каталога для формирования активной витрины
clicks = spark.read.parquet("s3://retail/clicks/")
catalog = spark.read.parquet("s3://retail/catalog/")

joined = clicks.join(catalog, clicks.product_id == catalog.id, "left")

joined.writeMode("overwrite").parquet("s3://retail/warehouse/retail_view/")
Преимущества такого подхода очевидны: единая база знаний о товарах и поведении клиентов, быстрая адаптация витрин под акции и сезонность, улучшение точности рекомендаций и повышение конверсии. Важным аспектом остаются операции по синхронизации данного слоя с источниками и обеспечение консистентности в рамках бизнес-процессов и промо-кампаний.
Особенности реализации:
- Интеграция с ML-пайплайнами и хранение признаков в Feature Store, для ускорения онлайн-предсказаний.
- Управление данными в реальном времени для персонализации и ценообразования с минимальной задержкой.
- Мониторинг деградаций моделей и периодическая переобучаемость на новых данных.
- Этап миграции в lakehouse-формат: перенос исторических данных и подготовка к новым источникам и форматам.
Телеком: обработка потоков и реального времени, биллинг и мошенничество
Телекоммуникационные сети генерируют огромные объемы телеметрии, журналов событий и CDR. В рамках аналитического хранилища Spark применяется для обработки потоковых данных в реальном времени и пакетной аналитики на исторических данных. Основная задача - обеспечить точный биллинг, своевременную сигнализацию по мошенничеству и эффективную эксплуатацию сети.
Ключевые практики:
- Потоковая обработка и реальный час: Spark Structured Streaming позволяет обрабатывать события по мере их поступления, интегрируясь с Kafka и другими источниками. Важна корректная агрегация по временным окнам и поддержка задержек в потоке.
- Архитектура lakehouse: Delta Lake предоставляет транзакционную согласованность, временные срезы и устойчивое хранение результатов анализа, что критично для финансовых и юридических аспектов биллинга.
- Мошенничество и риск: построение детекторов аномалий и кластеризации в режиме онлайн, с возможностью переноса вычислений в офлайн-слой для сложных моделей.
- Интеграции и безопасность: строгие политики доступа, аутентификация и шлюзование для внешних систем, а также шифрование данных на уровне хранения и транслита.
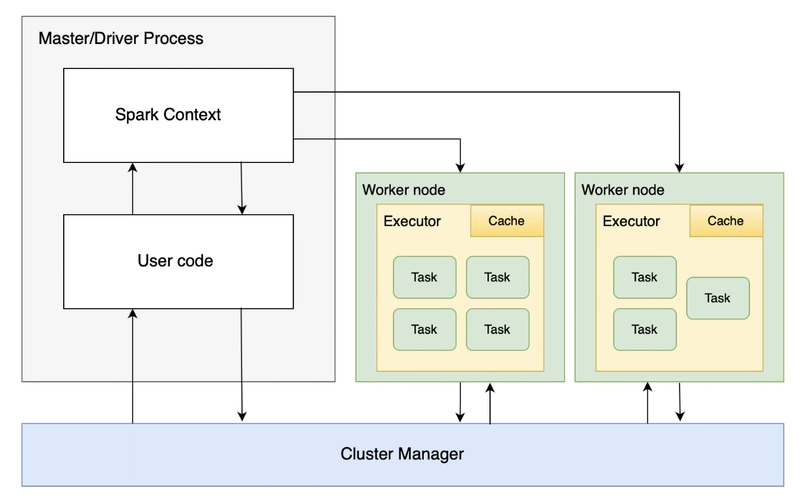
Оптимизация производительности и эксплуатации:
- Настройка источников и конвейеров: оптимизация пропускной способности через конфигурацию источников, буферизацию и управление параллелизмом.
- Управление данными: периодическая очистка старых данных, архивирование и дедупликация событий.
- Инструменты мониторинга: трассировка задержек, SLA по задержке обработки, алерты по задержкам и пропускам.
Пример кода (упрощенный; иллюстративный):
df = spark.readStream.format("kafka").option("subscribe","telecom_events").load()
## простейшие преобразования и агрегации
agg = df.groupBy(window(col("timestamp"), "5 minutes"), col("region")).count()
agg.writeStream.format("delta").option("path","/data/telecom/real_time").option("checkpointLocation","/checkpoints/telecom").start()
Особенности реализации:
- Выбор архитектуры для обработки больших потоков: использование кластеров Kubernetes или распределённых фреймворков обработки под нагрузкой.
- Совместное использование глобальных и локальных источников данных: реализация концепций сбора сигнала и идентификации мошенничества в реальном времени.
- Управление качеством и соответствие требованиям регуляторов: построение аудита и прозрачности обработки, независимый мониторинг.
Промышленность: IIoT, предиктивная аналитика и обслуживание
Промышленный сектор характеризуется данными с датчиков, MES-данными, логами оборудования и ERP-системами. Spark применяется для обработки потоков с датчиков, агрегации временных рядов, объединения с историческими данными и построения предиктивной аналитики для обслуживания оборудования, контроля качества и оптимизации производственных процессов.
Ключевые элементы реализации:
- Интеграция источников: датчики (SCADA/IIoT), MES, ERP, логи оборудования. Архитектура должна справляться с различной скоростью поступления и сжатием данных.
- Архитектура lakehouse: Delta Lake для обеспечения ACID-свойств при объединении онлайн-данных с историческими, поддержка временных версий и Evolution схем.
- Временные ряды и моделирование: интеграция Spark MLlib для извлечения признаков, обучения моделям предиктивного обслуживания и оценки риска отказов, с возможностью переноса в онлайн-режим через модели на базе MLFlow.
- На стороне периферийного оборудования: возможность обработки ближе к источнику данных (edge), а затем синхронизация в облаке или дата-центре для долговременного анализа.
- Операционная устойчивость: мониторинг задержек, обработка ошибок, резервное копирование, автоматическое извлечение коррекций.
Практическое применение:
- Предиктивное обслуживание: использование исторических данных об отказах и текущих сенсорных признаках для прогноза вероятности отказа и планирования работ по замене узлов.
- Оптимизация производственных процессов: анализ потерь, качества, коэффициентов полезного использования оборудования (OEE) и времени простоя.
- Контроль качества: объединение производственных данных с логами качества и настройка автоматических триггеров на отклонения.
Пример куска кода (упрощенный):
df = spark.readStream.format("kafka").option("subscribe","iiot_sensors").load()
sensor = df.selectExpr("CAST(value AS STRING) as json").select(from_json(col("json"), schema).alias("d")).select("d.*")
features = sensor.groupBy("machine_id", window(col("timestamp"), "1 hour")).agg(avg("vibration"), avg("temperature"), max("rpm"))
features.writeStream.format("delta").option("path","/data/industrial/stream").option("checkpointLocation","/checkpoints/industrial").start()
В промышленных проектах критическими являются вопросы задержек, доступности, целостности данных и устойчивости к сбоям. Внедрение Spark в таких условиях требует тесного взаимодействия с инженерами по эксплуатации оборудования и специалистами по данным, чтобы обеспечить корректную интерпретацию сигналов и своевременное обновление моделей обслуживания.
Key takeaways
- Spark позволяет объединить пакетную и потоковую обработку в едином lakehouse-слое, что упрощает управление данными и повышает скорость получения инсайтов.
- Delta Lake и Apache Hudi обеспечивают ACID-совместимость, версионирование и схему Evolution, что критично для регуляторной отчетности и длительного хранения.
- Архитектура должна поддерживать строгие требования к безопасности, управлению доступом, политиками masking и аудитом.
- Интеграции с Kafka/NiFi и систем оркестрации (Airflow, и т. п.) позволяют строить предиктивно-аналитические конвейеры с надёжной эксплуатацией.
- В отраслевых кейсах важно сочетать пакетную обработку с реальным временем, чтобы обеспечить своевременный доступ к данным и устойчивые бизнес-процессы.
- Внедрение требует выстраивания методологий качества данных, тестирования конвейеров и контроля изменений схемы.
- Примеры использования в разных отраслях демонстрируют как концепции lakehouse и структурированного подхода к данным приводят к конкретным бизнес-выгода: точности регуляторной отчетности в финансах, персонализации в рознице, снижению задержек обработки в телеком и повышению эффективности производства в промышленности.
FAQ
- Какие преимущества приносит использование Spark в аналитических хранилищах по сравнению с чисто пакетной обработкой?
Spark обеспечивает гибридную обработку пакетных и потоковых данных в рамках одного конвейера, поддерживает широкий спектр источников и форматов, ускоряет агрегации и аналитические вычисления за счет оптимизаций выполнения и хранения в lakehouse. Это позволяет бизнесу быстрее получать инсайты, поддерживать актуальность данных и уменьшать задержку между событием и принятием решения, что особенно критично в финансовых и телеком-операциях.
- Что такое lakehouse и почему он важен для кейсов внедрения Spark?
Lakehouse - это архитектура, сочетающая преимущества data lake (гибкость и масштаб) с ACID-слоем и структурированным доступом к данным, как в data warehouse. Для кейсов Spark в финансах, рознице, телеке и промышленности lakehouse обеспечивает единое хранилище, где можно безопасно хранить и версионировать данные, выполнять сложные аналитические запросы и строить предиктивные и онлайн-модели без сложной миграции между слоями.
- Какие форматы и инструменты хранения данных чаще всего применяются совместно с Spark в этих кейсах?
Наиболее распространены Delta Lake и Apache Hudi как решения для обеспечения ACID и версионирования. Они интегрируются с Spark и поддерживают эффективные операции на больших объемах. В зависимости от инфраструктуры могут применяться Parquet/ORC как форматы столбцов для пакетной обработки и быстрого доступа к данным. В реальном времени часто используется Delta Lake в сочетании с streaming-пайплайнами через Spark Structured Streaming.
- Какие вызовы безопасности и соответствия нужно учитывать при внедрении Spark в отраслевых кейсах?
Необходимо обеспечить granular access control на уровне столбцов и строк, masking чувствительных данных, аудит доступа и операций, шифрование данных в покое и в транзите, а также управление ключами. В дополнение требуются процессы управления изменениями схем, тестирование конвейеров, мониторинг качества данных и регулярное обновление политик безопасности в рамках регуляторных требований.
- Каковы подходы к миграции от существующих монолитных пайплайнов к lakehouse-архитектуре?
Миграция обычно проводится поэтапно: (1) инвентаризация источников данных и текущих зависимостей, (2) создание целевых моделей данных в lakehouse с поддержкой версий и схем, (3) миграция инпут-пайплайнов без критичных изменений бизнес-логики, (4) внедрение orchestration и мониторинга, (5) параллельная работа старых и новых пайплайнов с постепенным отключением устаревших источников. Важно обеспечить совместимость бизнес-логики и сохранение SLA на время миграции.
- Какие архитектурные принципы помогают избежать проблем с данными при работе с несколькими источниками?
Необходимо выстроить единый каталог метаданных, строгие политики качества данных, единый сериализатор и схемы, совместимые версии данных и устойчивые конвейеры. Использование фабрик пайплайнов, контроля версий схем и проверки согласованности между пакетной и потоковой частями обеспечивает предсказуемость аналитики и предотвращает расхождения между источниками.
- Какую роль играет интеграция с ML-облаками и инструментами в рамках указанных кейсов?
ML-инструменты позволяют строить персонализацию, предиктивные модели обслуживания и прогнозы спроса, что особенно важно для розницы, промышленности и телеком. Интеграция с MLFlow или аналогичными системами обеспечивает отслеживаемость экспериментов, повторяемость моделей и перенос моделей в продакшн. Feature Store упрощает доступ к признакам и ускоряет онлайн-предсказания.
- Какие паттерны планирования ресурсов и оптимизации Spark особенно важны в промышленных кейсах?
Ключевыми являются управление параллелизмом, настройка Shuffle-процессов, использование Broadcast-join для небольших таблиц, кэширование часто используемых данных и эффективное планирование задач через broadcast и cach. Важно также учитывать мониторинг кластера и автоматическое масштабирование под нагрузку.
- В чем заключаются лучшие практики совместной работы бизнес- и технических команд при внедрении Spark?
Необходимо обеспечить совместное планирование архитектуры, четко определить требования к данным и SLA, устанавливать совместные Metamodel и схемы, регулярно проводить ревью данных, внедрять тестирование конвейеров и мониторинг, а также обеспечить прозрачность для бизнес-пользователей через понятные дашборды и отчеты.
- Как оценивать экономическую эффективность внедрения Spark в аналитические хранилища?
Экономическую эффективность оценивают через стоимость владения и эксплуатации кластера, задержки в конвейерах, время до инсайтов, уменьшение времени на регуляторную отчетность и рост конверсий/эффективности бизнеса. В рамках пилотов рекомендуется проводить TCO-анализ и сравнение между монолитной архитектурой и lakehouse-подходом, включая затраты на хранение, вычисления и инфраструктуру.


