

Архитектура Hadoop-экосистемы: HDFS, YARN, MapReduce
Hadoop-экосистема представляет собой комплекс решений для хранения и обработки больших данных, где распределённое хранение данных в HDFS взаимодействует с распределённой вычислительной моделью на базе YARN и парадигмой MapReduce. В реальных индустриальных проектах архитектура дополняется рядом компонентов для управления данными, безопасностью и оркестрацией задач. Глава посвящена практическим кейсам и сценариям применения Hadoop в банковском секторе, телекоммуникациях, ритейле и производственной аналитике, с акцентом на архитектуру, интеграции и типовые паттерны реализации.
Современная практика демонстрирует, что успех внедрения Hadoop в крупных организаций во многом определяется умением сочетать строгое хранение и предсказуемую обработку данных с необходимостью оперативного реагирования на бизнес-задачи. В этих условиях архитектура строится вокруг надёжности и масштабируемости HDFS, гибкости и управляемости YARN и эффективной реализации вычислений через MapReduce. В рамках главы будут рассмотрены типовые паттерны потоков данных, требования к безопасности и соответствию регуляторным нормам, а также конкретные сценарии, которые иллюстрируют как архитектурные принципы переходят в реальные решения.
Краткое содержание главы
- Обзор архитектурной модели Hadoop: HDFS как долговременное хранение, YARN как ядро оркестрации, MapReduce как базовая модель вычислений.
- Инженерные паттерны для банковского сектора: требования к безопасности, консолидация транзакционных и клиринговых данных, оффлайн-аналитика рисков.
- Архитектурные решения для телекоммуникаций: пакетная обработка больших объёмов данных и интеграция с потоками событий через инфраструктуру Hadoop.
- Аналитика в ритейле и производственной сфере: сегментация клиентов, цепочка поставок, IoT-данные и долгосрочное хранение.
- Практические аспекты внедрения: интеграции, управление данными, мониторинг и безопасность.
- Рекомендации по проектированию и эксплуатационной культуре для устойчивой работы Hadoop-платформы.
Общий контекст архитектуры Hadoop
HDFS (Hadoop Distributed File System) реализует распределённое хранение больших файлов на кластерах, обеспечивая высокую доступность и отказоустойчивость за счёт зеркалирования блоков данных на DataNode-узлах. Основные принципы: раздельное хранение данных и метаданных, устойчивость к сбоям отдельных узлов и возможность масштабирования как по объёму данных, так и по числу узлов. В исполнении банковских, телеком и розничных проектов важно учесть не только размер файлов, но и характер запросов: периодические пакетные загрузки, регулярные обновления и возможность быстрого извлечения определённых фрагментов данных для аналитики.
HDFS обеспечивает на уровне инфраструктуры следующие ключевые свойства:
- Распределённое хранение и параллельная обработка данных за счёт количества DataNodes и сетевого уровня передачи.
- Репликация блоков (по умолчанию фактор 3) как базовый механизм отказоустойчивости и балансировки нагрузки.
- Возможность логистически организовать данные по папкам и сегментам, поддерживающим управление доступом и миграцию между уровнями хранения.
- Поддержка расширения и эволюции через федерацию и альтернативные форматы хранения (например, эволюционная кодировка Erasure Coding в современных версиях HDFS).
YARN (Yet Another Resource Negotiator) обеспечивает управление ресурсами кластера и выполнение приложений. Архитектура YARN разделяет задачи планирования ресурсов и выполнение приложений на три ключевых компонента: ResourceManager, NodeManager и ApplicationMaster. Это позволяет эффективно управлять многопользовательскими и многосервисными средами, где разные фреймворки (MapReduce, Hive, Pig и т. д.) могут совместно использовать вычислительную инфраструктуру.
- ResourceManager осуществляет планирование ресурсов между приложениями, учитывая требования по памяти, CPU и качеству обслуживания.
- NodeManager управляет локальными ресурсами на каждом узле и контролирует исполняемые контейнеры приложений.
- ApplicationMaster отвечает за жизненный цикл конкретного приложения, распределение задач и мониторинг статуса.
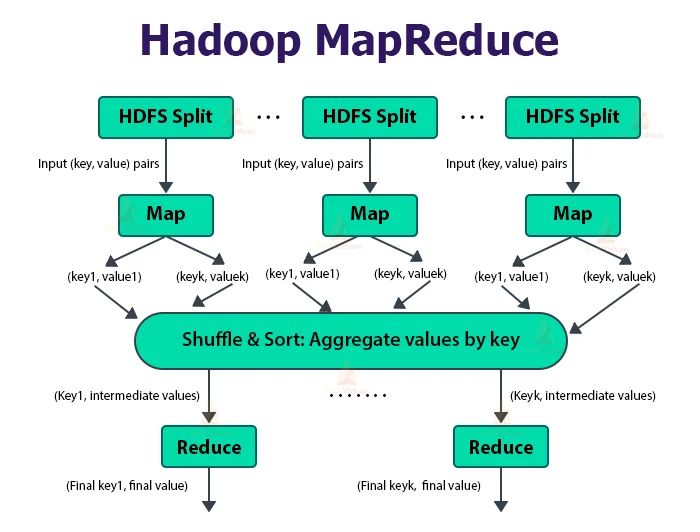
MapReduce выступает парадигмой вычислений в рамках Hadoop, особенно в MRv2 (YARN). В MR выполняются две основные фазы: Map и Reduce, соединённые этапом Shuffle and Sort. Эта модель естественным образом подходит для пакетной обработки больших наборов данных и для сценариев трансформации данных, где результаты одной стадии становятся входом для следующей. Однако для банковских, телеком и ритейловых сценариев нередко требуется интеграция MapReduce с альтернативами и расширенными оркестраторами, такими как Oozie для рабочих процессов, Hive для SQL-аналитики и Sqoop/Flume для переноса данных.
- В контексте проектирования следует учитывать компромиссы между латентностью пакетной обработки и предиктивной аналитикой в реальном времени. MR отлично подходит для оффлайн-аналитики и сложных ETL-процессов, но для задач nearly real-time следует сочетать MapReduce с потоковыми компонентами экосистемы или переходить к более современным фреймворкам в рамках экосистемы Hadoop.
- Важной характеристикой является совместное использование нескольких форматов хранения и индексов, чтобы обеспечить ускорение аналитики и согласованность данных между слоями хранения и обработки.
Интеграционные паттерны и операционные практики
Готовность к практической эксплуатации требует ясной картины интеграций между HDFS, YARN и MapReduce и сопутствующими инструментами. В реальных проектах архитектура дополняется:
- Охраной данных: Kerberos, ACL, политики доступа через Ranger/Knox или эквивалентные механизмы в рамках корпоративной инфраструктуры.
- Инструментами загрузки и миграции: Sqoop для переноса данных из реляционных СУБД, Flume или Flink для потоковой загрузки, NiFi для переработки и маршрутизации событий.
- Оракульной и аналитической слоями: Hive/Impala/Spark SQL для SQL-подобной аналитики поверх HDFS; HBase или Cain для быстрых запросов на выдержанных данных.
- Оркестрацией рабочих процессов: Oozie или современные альтернативы для планирования и мониторинга сложных пайплайнов.
## Пример команды для запуска MapReduce задачи (упрощённо)
hadoop jar /opt/hadoop/hadoop-examples.jar pi 16
Кейсы практики в ключевых индустриальных сегментах
Банковский сектор: безопасность, консолидация данных и аналитика риска
Банковские организации сталкиваются с требованиями к защите данных, соблюдению регулятивных норм, аудиту и точности данных. Архитектура Hadoop в банковской среде должна обеспечить долговременное хранение исторических данных, возможность быстрого анализа и сложных моделирующих циклов, а также строгий контроль доступа и шифрование.
-
Архитектурные принципы. HDFS выступает как единый слой долговременного хранения транзакционных журналов, клиентских данных, клиринговых операций и логов. Репликация блоков обеспечивает отказоустойчивость, а роль NameNode+DataNodes - центральный источник описания структуры данных и их размещения. В банковской среде часто применяют повышенные требования к безопасности: Kerberos-аутентификация, шифрование данных в покое и в передаче, управление доступом на уровне файлов и директорий, а также аудит операций над данными.
-
Роль YARN и MapReduce. YARN обеспечивает изоляцию рабочих процессов (batch-аналитика, бэкап-задачи, риск-анализ) за счёт контейнеров и планирования ресурсов между различными приложениями. MapReduce выполняет пакетные расчёты по историческим данным: оценка кредитного риска, моделирование убытков, комплаенс-анализ и ретроспективное тестирование гипотез. В реальном проекте MapReduce часто используется в связке с Hive для SQL-аналитики и Oozie для оркестрации сложных пайплайнов.
-
Интеграционные сценарии. Ингестирование данных из ERP, core-banking систем и клиринговых платформ может осуществляться через Sqoop и Flume, обеспечивая устойчивость к сбоям и минимальный шанс потери данных. Для регламентируемых данных применяются политики архивирования и сегментирования по времени хранения, делегированное хранение в HDFS и использование разделов классами. В качестве иллюстративной практики можно рассмотреть процесс пакетной загрузки транзакционных архивов, агрегацию и построение рисковых метрик в рамках одной рабочей задачи MR через Oozie.
-
Безопасность и соответствие. В проекте применяются Kerberos-идентификация и безопасное взаимодействие между сервисами, правила доступа в HDFS через ACL, а также внедряются политики по защите персональных данных. В архитектуре можно реализовать разграничение ролей и tenant-изоляцию задач через YARN-типы очередей и ограничение ресурсов.
-
Пример структурирования пайплайна:
- Источник данных: банковские транзакции, логи, клиринговые файлы.
- Хранение: ориентированное на хронологию размещение файлов в HDFS (папки по дате).
- ETL/обогащение: преобразование, нормализация и синхронизация с бизнес-слоями Hive.
- Аналитика: риск-модели и оффлайн-обучение моделей в MR/Spark SQL.
- Контроль доступа и аудит: журналирование действий и мониторинг доступа к данным.
-
Пример кода конфигурации безопасности, минимально иллюстрирующий подход (фрагмент, не полный конфигурационный набор):
  ## Пример настройки Kerberos в рамках Hadoop окружения
  kinit user@EXAMPLE.COM
  hdfs dfs -ls /
Телекоммуникации: обработка потоковых данных и аналитика в реальном времени
Телекоммуникационные операторы генерируют огромный поток событий - детализационные записи звонков (CDR), логи оборудования, сигналы мониторинга сетей. Архитектура Hadoop в таких условиях должна поддерживать как историческую оффлайн-аналитику, так и своевременное извлечение информации для монетарной и операционной эффективности.
-
Архитектурные принципы. Хранение и обработка больших массивов событий в HDFS обеспечивает массив аналитических задач: клиентская сегментация, моделирование churn, анализ сетевых аномалий и оптимизация маршрутизации. YARN обеспечивает многопользовательскую эксплуатацию кластера и эффективное использование ресурсов при запуске разнородных задач (ETL-пайплайны, ML-ворки, регрессионный анализ). MR остаётся надёжной базовой моделью для пакетной обработки и агрегации событий.
-
Потоковая обработка и интеграции. В реальном телеком-проекте основой можно считать пакетную обработку с регулярной агрегацией и денормализацией событий, поступающих через потоковые конвейеры (Flume, Kafka-like слои) в HDFS. Такой подход позволяет строить отчетность и предиктивную аналитику на основе больших архивов и исторических трендов, в то же время поддерживая режим near real-time через периодические батчи.
-
Применение MR и SQL-слоя. Работа с CDR-данными, агрегации по сессиям, использование Hive/Impala для SQL-нагруженной аналитики - типичный сценарий. В крупных проектах может применяться сочетание MR с более современными фреймворками, чтобы улучшить латентность и читаемость запросов, но MR остаётся устойчивым базовым слоем для многих регламентированных задач.
-
Архитектура синхронизации и хранения. Стратегия оптимизации включает раздельное хранение «сырых» и «обработанных» данных, управление версиями схем и схемной эволюцией, безопасное хранение конфиденциальной информации и контроль доступа.
-
Примеры сценариев:
- Анализ загрузки сети и вызовов: вычисление пиковых периодов времени, определение аномалий в трафике.
- Распределённая агрегация по регионам и сегментациям клиентов, построение клиентских профилей.
-
Пример команды для пакетной обработки, иллюстрирующий подход:
  ## Запуск MR-задачи по обработке CDR-данных
  hadoop jar /opt/hadoop/hadoop-examples.jar wordcount \
    /cdr/raw /cdr/output
Ритейл: аналитика клиентов, цепочки поставок и сегментация
В ритейле Hadoop часто служит основой для развертывания «data lake» и дальнейшей аналитики - от оперативной до стратегической. Ключевые задачи включают обработку журналов кликов, транзакционных данных, складских остатков и данных лояльности. Архитектура должна обеспечивать консолидацию данных из разных источников, качество данных, режимы загрузки и возможности долгосрочного хранения.
-
Архитектурные принципы. HDFS применяется как единый репозиторий для больших массивов событий и транзакций. Хранение в формате, поддерживающем эффективную аналитическую обработку (например, Parquet/ORC в связке с Hive) ускоряет SQL-запросы и аналитические пайплайны. YARN обеспечивает изоляцию и эффективное разделение ресурсов между пакетной обработкой и периодическими задачами обновления данных.
-
Эволюционные паттерны обработки. В ритейле характерна необходимая частота обновлений данных: ежедневные репорты, недельные дайджесты и периодическая прогонка моделей рекомендаций. MR-процессы выполняют ETL, агрегации и расчёт метрик ( HR/правила), в то время как SQL-слой через Hive обеспечивает доступ бизнес-пользователям к данным без необходимости писать MapReduce-код.
-
Интеграции и качество данных. В цепочке загрузок используются Sqoop для партийных загрузок из систем ERP, а Flume/Fluent-драйверы - для неструктурированных журналов и потоков кликов. Важным аспектом является реализация политики владения данными, включая метаданные, версионирование и отслеживание происхождения данных (data lineage).
-
Пример паттерна безопасной доставки. Архитектура предусматривает staged-зоны: «сырая», «очищенная» и «модельная» зоны, где данные проходят очистку, нормализацию и индексацию перед загрузкой в аналитическиеBh Hive-таблицы.
-
Пример кода загрузки данных в HDFS и последующей агрегации с MR:
  ## ingest: загрузка данных через Sqoop
  sqoop import --connect jdbc:mysql://db/ratecard \
    --table rates --target-dir /retail/raw/rates \
    --username user --password pass

  ## пакетная агрегация через MR
  hadoop jar /opt/hadoop/hadoop-examples.jar wordcount \
    /retail/raw/rates /retail/output/rates_count
Производственная аналитика: IoT-данные, качество и долгосрочное хранение
Производственные предприятия генерируют огромный поток датчиков, регистров и мероприятий на конвейерах. Архитектура Hadoop выступает как основной слой хранения для исторических данных и среда для пакетной аналитики, регрессионного анализа, предиктивного обслуживания и анализа качества.
-
Архитектурные принципы. HDFS здесь используется как «хранитель» исторических временных рядов и журналов событий с высоким уровнем нагрузки. В сочетании с Hive и Pig можно строить сложные ETL-пайплайны: нормализация, агрегации, нормализация временных рядов, корреляции между признаками. YARN обеспечивает эффективное управление ресурсами при выполнении длинных вычислений, циклов обучения моделей и периодического архивирования данных.
-
Аналитика и ML-процессы. Производственные данные часто требуют сложной агрегации, идентификации аномалий и трендов по многим сенсорам. MR может обрабатывать массивы данных в пакетном режиме, а затем результаты передавать в модели, обучаемые в рамках того же кластера или отдельного вычислительного контура. В рамках экосистемы возможно использование Hive/Impala для SQL-аналитики и интеграцию с инструментами для моделирования (например, Spark MLlib, если проект расширяется за пределы MR).
-
Архитектура и управление данными. Управление данными требует строгого контроля качества, версии схем и жизненного цикла. Для индустриальных данных критично обеспечить долговременное хранение и возможность восстановления после сбоев, а также обеспечение безопасности данные в соответствии с внутренними регламентами.
-
Пример паттерна памяти и хранения. В производственных целях часто строят слои хранения по времени жизни: «сырые» датасеты на уровне HDFS, «очищенные» данные в виде столбцатых форматов, готовые к анализу таблицы Hive.
-
Безопасность и соответствие. Включает аутентификацию, шифрование данных и аудит доступа к данным, особенно если рассматриваются производственные данные, которые относятся к критически важной инфраструктуре.
Инфраструктура и практики внедрения
- Безопасность и контроль доступа. Kerberos-аутентификация, настройка ACL в HDFS, а также применение политики доступа через Apache Ranger или Knox. Эти подходы дают возможность разделять роли и минимизировать риск несанкционированного доступа к конфиденциальной информации.
- Управление данными и качество. Метаданные и каталогизация (data catalog) становятся необходимыми для понимания происхождения данных, их версии и соответствия требованиям регуляторов.
- Мониторинг и эксплуатация. В крупных кластерах важны централизованные панели мониторинга, журналирование и алертинг по состоянию NameNode, DataNode, ResourceManager и задачам MapReduce. Оптимизация конфигураций выполняется на основе того, как данные проходят через этапы загрузки, обработки и экспорта в аналитические слои.
- Пример архитектурной дифференциации. В крупных банках и телекомах внедряют отдельные «ниши» кластера по целям: обработка транзакционных логов, аналитика риска, обработка событий клиентов, архивное хранение. Это облегчает управление производительностью, а также разрешает регуляторные требования к хранению и аудиту.
Key takeaways
- Hadoop-архитектура разделяет хранение и вычисления: HDFS обеспечивает масштабируемое долговременное хранение, YARN - управляет ресурсами и изоляцией, MapReduce - пакетная модель вычислений.
- Архитектура должна учитывать требования отрасли: безопасность, контроль доступа, соответствие регулятивным нормам и возможность интеграции с аналитическими слоями.
- Банковский сектор требует строгого управления безопасностью и аудита, нацеленного на хранение и обработку транзакционных данных и рисков.
- Телекоммуникации требуют интеграционных паттернов для обработки больших объёмов событий и последующей аналитики, включая работу с потоками и пакетами данных.
- Ритейл и производственная аналитика требуют подходов к консолидации разнородных источников, управлению качеством данных и эксплуатации долгосрочного хранения.
- Эффективная интеграция между HDFS, YARN и MapReduce достигается через грамотную оркестрацию задач, использование дополнительных инструментов (Sqoop, Flume, Hive, Oozie) и реализацию политики безопасности.
- Важна культура эксплуатации: планирование ресурсов, мониторинг, управление изменениями и гарантии качества данных.
- В реальных проектах MR часто применяется как базовый слой пакетной обработки, а для задач near real-time и интерактивной аналитики - гибридная архитектура с дополнительными движками и инструментами.
- Учет данных в рамках бизнес-процессов и обеспечение повторяемости пайплайнов является критическим фактором успеха сложных аналитических проектов.
FAQ
- Каковы основные различия между HDFS, YARN и MapReduce в контексте архитектуры кластера?
- HDFS обеспечивает хранение данных в распределённой среде с высокой отказоустойчивостью за счёт репликации и распределённой архитектуры. YARN отвечает за планирование ресурсов и исполнение задач, обеспечивая изоляцию и безопасность между различными приложениями. MapReduce - парадигма вычислений, реализующая обработку данных в пакетном режиме: Map и Reduce стадии, транспортировку промежуточных результатов (shuffle) и агрегацию. В связке они образуют базовую архитектуру: хранение, orchestration и computation, где каждая часть играет свою роль в масштабируемости и надёжности.
- Какие практические эффекты обеспечивает использование HDFS в банковской среде?
- HDFS обеспечивает долговременное хранение исторических и регламентируемых данных, ускорение пакетной аналитики и возможность восстановления после сбоев. Репликация и изоляция данных позволяют безопасно выполнять регулятивные задачи и аудит. Интеграция с Hive и MapReduce упрощает оффлайн-аналитику и моделирование рисков.
- Как решить вопрос баланса между пакетной обработкой и требованиями к латентности в телекоммуникациях?
- Пакетная обработка через MR обеспечивает глубокие и повторяемые вычисления на больших данных. Для задач ближе ктайму можно применять потоковые конвейеры (через Flume/Kafka и интеграцию с кластерами), а MR остается основой для периодических перерасчётов и долговременной аналитики. Архитектурное разделение пайплайнов по слоям хранения и обработке помогает снизить латентность, сохраняя надежность и воспроизводимость.
- Какие паттерны применяют в розничной аналитике для эффективной обработки больших объёмов кликовых данных?
- Частичный пакетный подход: загружать данные в HDFS, хранить в оптимизированных форматах (Parquet/ORC), выполнять ETL и агрегации через MR и Hive. Поддержка данных разных источников (сетевые клики, транзакции, лояльность) достигается через единый data lake и консолидацию с управлением метаданными. Этот подход обеспечивает единый источник правды и ускоряет аналитические запросы.
- Какие принципы безопасности следует внедрять в Hadoop-платформе?
- Реализация Kerberos-аутентификации на уровне сервисов и пользователей, строгие политики доступа на уровне файлов и директорий (ACL), использование Ranger/Knox для централизованного управления политиками и аудитом. В банковской и телеком-отрасли данные требуют дополнительной защиты, журналирования и возможности быстрого восстановления после инцидентов.
- Каковы архитектурные альтернативы MapReduce в рамках Hadoop-экосистемы и когда их целесообразно использовать?
- В рамках экосистемы Hadoop существуют альтернативы для интерактивной и стриминговой аналитики, такие как Hive/Impala и Spark SQL. MR остается надёжной базой для сложных пакетных задач и ETL-процессов, когда необходима явная логика шага за шагом и детальный контроль над стадиями обработки. Переход к более современным движкам может улучшить латентность и эргономику разработки, особенно в сценариях, где требуется интерактивная аналитика.
- Какие ключевые аспекты архитектуры помогают обеспечивать масштабируемость при росте объёмов данных?
- Горизонтальное масштабирование за счёт добавления узлов DataNodes и увеличения вычислительных мощностей через YARN, эффективное управление данными (раздельные зоны хранения, дедупликация и чистка), а также использование форматов столбцовых файлов (Parquet/ORC) для ускорения чтения и снижения затрат на хранение. Важна архитектура данных: продуманное разделение по источникам, времени и предназначению обработки, что облегчает обслуживание кластера и уменьшает риск сбоев.
- В чем преимущество использования SQL‑слоя поверх Hadoop‑данных?
- SQL‑слой (Hive/Impala) предоставляет бизнес‑пользователям удобный интерфейс для запросов и анализа, снижая порог входа и ускоряя принятие решений. Он позволяет использовать знакомые SQL-запросы для больших данных и облегчают миграцию существующих аналитических процессов из реляционных баз данных в Hadoop‑контекст. Это дополняет MR и при необходимости ускоряет повторяемые аналитические задачи.
- Как организовать миграцию legacy‑данных в Hadoop‑платформу без потери согласованности?
- Начать можно с поэтапной миграции: сначала перенести исторические архивы и вспомогательные данные, затем построить слой метаданных и каталог данных. В рамках миграции применяются процедуры валидации качества данных, версионирование схем и аудит изменений. Важна выдержка в плане планирования: версии файлов, контроль версий и тестирование пайплайнов на небольших участках данных до полной миграции.
- Какие показатели эффективности применяются для оценки Hadoop‑кластера в индустриальной среде?
- Производительность обработки (скрипты MR, время выполнения, количество обработанных записей в единицу времени), латентность пайплайна (время от поступления данных до готового вывода), использование ресурсов (CPU, память, диск), доступность кластера (uptime, количество сбоев), устойчивость к сбоям и время восстановления (RTO/RPO), а также соответствие требованиям безопасности и аудита.
Глава представляет собой целостное обоснование архитектурных решений и конкретных кейсов применения Hadoop‑экосистемы в разных индустриальных секторах. В качестве практических ориентиров вы можете применять приведённые принципы к своей реальной инфраструктуре, адаптируя конфигурации под требования регулятора, характер данных и бизнес‑потребности.


