

Архитектура Hadoop-экосистемы: HDFS, YARN, MapReduce
Hadoop-экосистема стала одной из первых масштабируемых платформ для работы с большими данными, заложив фундамент современных data lake и распределённых вычислений. Несмотря на появление новых технологий, её архитектурные принципы — масштабируемость, отказоустойчивость и распределённая обработка — по-прежнему лежат в основе корпоративных data-платформ.
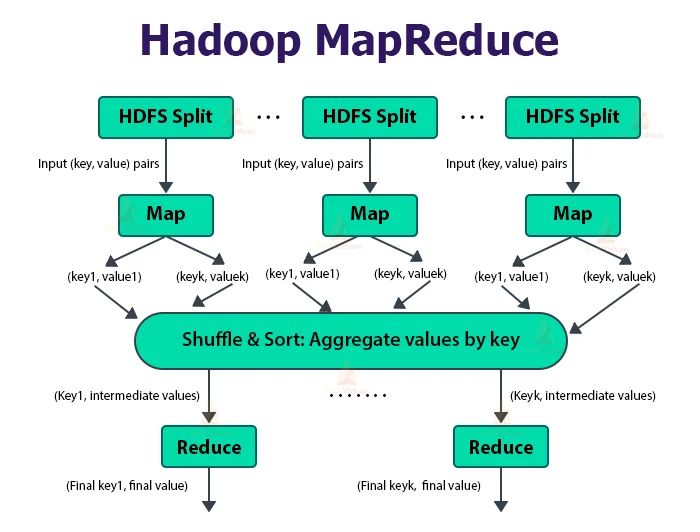
В этом разделе рассматриваются ключевые компоненты Hadoop: распределённое хранилище HDFS, система управления ресурсами YARN и модель вычислений MapReduce. Особое внимание уделяется архитектуре хранения данных, управлению метаданными, планированию ресурсов и выполнению задач, а также интеграции с инструментами обработки и загрузки данных.
Дополнительно раскрываются вопросы безопасности, управления доступом, мониторинга и эксплуатации кластеров, а также практические сценарии применения Hadoop в корпоративной среде. Такой подход позволяет понять роль Hadoop в современной архитектуре данных и его место в гибридных и облачных решениях.
- Введение: роль Hadoop-экосистемы в корпоративной архитектуре данных
- Стратегическая рамка: цели data-платформ на Hadoop
- Архитектурные принципы больших данных: модульность, масштабируемость, отказоустойчивость
- История и текущее положение Hadoop: от HDFS к YARN и экосистеме
- Терминология Hadoop: HDFS, YARN, MapReduce, блоки, репликация
- Архитектура HDFS: хранилище, Namenode/DataNode, блоки и репликация
- Безопасность HDFS: Kerberos, ACL, делегируемые токены
- Метаданные и управление схемой: Hive Metastore, data catalog, схемы
- Протоколы доступа к HDFS и API: WebHDFS, HttpFS, FileSystem API
- Архитектура YARN: ResourceManager, NodeManager, ApplicationMaster, контейнеры
- Планирование ресурсов в YARN: Capacity и Fair Scheduler
- Модель выполнения MapReduce: этапы, Shuffle, сортировка, редьюсеры
- Оптимизация MapReduce: паттерны, настройка параметров, производительность
- Архитектурные паттерны интеграции данных: ETL-пайплайны, data pipelines
- Инструменты загрузки и переноса данных: Sqoop, Flume, Kafka, NiFi
- Обработчики данных в Hadoop-экосистеме: Hive, Pig, Impala, Spark на Hadoop
- Хранилища данных, форматы и компрессия: Parquet, ORC, Avro, SequenceFile
- Архитектура управления данными и качество данных: lineage, метаданные, governance
- Метаданные и управление данными на масштабе: каталоги, эволюция схем, совместимость
- Безопасность, аудит и соответствие: Ranger, Knox, аудит действий
- Развертывание и инфраструктура: on-prem vs облако, гибридные решения
- Операционная модель и мониторинг: Ambari/Cloudera Manager, Prometheus, логирование
- Жизненный цикл кластера: развёртывание, обновления, миграции, совместимость
- Надёжность и аварийное восстановление: High Availability NameNode, JournalNode, DR стратегии
- Архитектура Hadoop-экосистемы: HDFS, YARN, MapReduce
- Риски, ограничения и типовые ошибки реализации Hadoop-проектов
- Развитие, масштабирование и зрелость Hadoop-архитектур: дорожные карты
- Архитектура для data-lake и облачных интеграций: облачный Hadoop, cloud-native подходы
- Будущее Hadoop: роль в гибридных архитектурах и связь с Spark и современными движками
- ADR и принятие архитектурных решений: принципы документирования решений


