

Модель выполнения MapReduce: этапы, Shuffle, сортировка, редьюсеры
В рамках Hadoop-экосистемы MapReduce представляет собой модель параллельной обработки больших данных, где задача разбивается на карты (Map), затем промежуточные данные транспортируются к редьюсерам (Shuffle и Sort) и финально агрегируются. Эта модель позволяет строить предикативно линейные конвейеры обработки, минимизируя сетевые затраты за счет локального сохранения и упорядочения промежуточных данных на уровне узлов. Современные реализации MRv2, работающие под управлением YARN, отделяют управление ресурсами от самой логики обработки, что обеспечивает гибкость и масштабируемость в больших кластерах.
Далее приведено системное представление, начиная с концепций и архитектурных принципов, затем - детальная реконструкция исполнения на каждом этапе, с акцентом на механизмы передачи данных, управление памятью, сортировку и устойчивость к сбоям. В заключение обсуждаются практические аспекты оптимизации и интеграции в рамках Hadoop-модуля YARN.
- Архитектура MapReduce: поток данных, роли мапперов и редьюсеров, взаимодействие с HDFS и YARN.
- Этап Map и локальная агрегация: обработка входных записей, формирование промежуточных пар и политики spill.
- Shuffle и сортировка: копирование промежуточных данных, слияние потоков и группировка по ключу.
- Этап Reduce: агрегация значений по ключу, запись финального вывода и свойства детерминированности.
- Оптимизация и устойчивость: настройка памяти и буферов, компрессия shuffle, выбор партиционера и обработка отказов.
Архитектура и поток данных MapReduce
MapReduce опирается на три основных слоя: данные хранятся в HDFS, управление ресурсами и координацию осуществляет YARN, а вычислительную логику реализуют Map и Reduce задачи. Входные данные разбиваются на InputSplit в соответствии с InputFormat, что позволяет параллельно обрабатывать большие файлы и коллекции мелких файлов. Каждый InputSplit конвертируется в набор записей через RecordReader, после чего запись за записью подается в функцию Map.
Производимые на этапе Map пары ключ-значение проходят через механизм партии (Partitioner). По умолчанию применяется хеширование по ключу, что определяет, на каком редьюсере окажутся конкретные пары. Число редьюсеров обычно устанавливается как параметр задачи и соответствует желаемому уровню параллелизма, а также объему данных, который можно эффективно агрегировать на стороне редьюсеров.
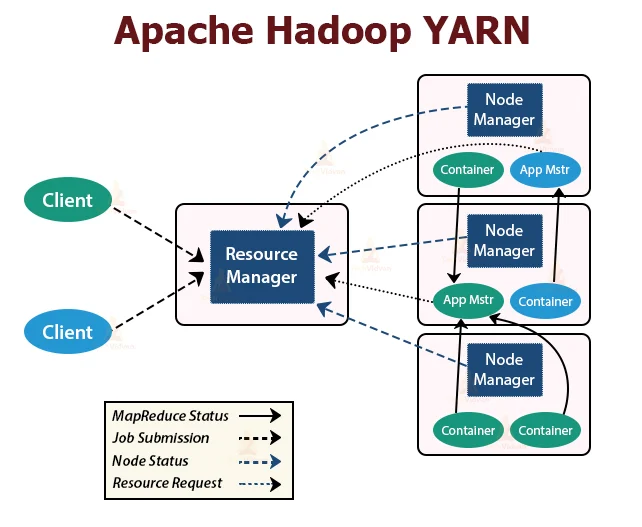
В контуре MRv2, под управлением YARN, задачи Map и Reduce запускаются как контейнеры внутри ApplicationMaster. Это обеспечивает независимость вычислений от конкретных узлов и позволяет динамически перераспределять ресурсы. Контейнеры работают с локальными файловыми системами узлов, где Map-выход до полноты задачи сохраняется локально на диске и далее подлежит перераспределению во время Shuffle.
Ключевые принципы, которые лежат в основе архитектуры: локализация данных (data locality), принцип «вычисляй ближе к данным» и детерминированность результата, обеспечиваемая единообразной семантикой ключей и группировкой значений. Эффективная реализация требует согласования между процессами чтения входа, ожиданий по памяти, стратегии компрессии и алгоритмов сортировки, чтобы минимизировать сетевой трафик и задержки.
Этап Map: обработка и локальная агрегация
Этап Map выполняется на каждом узле-клиенте и отвечает за первичную трансформацию входных данных. Map-задача читает раздел входных данных через RecordReader и на каждом вызове map(K, V) порождает промежуточные пары. Эти пары не обязательно упорядочены внутри самого Map-выхода; порядок важен только в рамках отдельных spill-блоков.
-
Время жизни Map-слоя ограничено рамками одного Map-задачи. Он строит буфер промежуточных пар в памяти до достижения порога, после чего выполняется запись spill-файла на диск. Каждый spill может содержать блоки, отсортированные по ключу, что упрощает последующую слияние на стадии Shuffle. При этом между spills могут существовать несвязанные блоки, и именно механизм слияния (merge) в Reduce обеспечивает глобальную группировку по ключу.
-
Компоненты Map-цепи включают InputFormat, RecordReader, Mapper, Partitioner и механизм вывода MapOutput. В реализации MRv2 существует возможность использовать Combiner - локальное, частичное объединение значений для одного и того же ключа до отправки на редьюсер. Combiner может существенно снизить объем данных, передаваемых через Shuffle, но не должен менять логику редьюсера: применяется только тогда, когда операция над значениями является д monotone и детерминирована.
-
С точки зрения алгоритмов передачи данных, MapOutput writing обычно включает: сортировку внутри spill-блока по ключу, сериализацию пар в эффективный бинарный формат и, по желанию, компрессию. Это минимизирует диск и сетевые расходы в дальнейшем. Важным является выбор кодека сериализации (например, Writable и WritableComparable в нативной реализации Hadoop) и возможность включения компрессии для промежуточной стадии.
-
Важный нюанс - распределение нагрузки между редьюсерами. По умолчанию партиционирование основано на хешировании ключа, поэтому равномерность распределения является критичной для избегания шока, когда один редьюсер получает значительную долю данных. В случаях неравномерности применяются пользовательские Partitioners, которые учитывают распределение данных или специфические характеристики ключей.
-
Роль памяти. Размер MapOutputBuffer критически влияет на скорость spill и общую задержку. Небольшой буфер приводит к частым spills и большему числу spill-файлов, в то время как слишком большой буфер может привести к нехватке памяти и задержкам в других задачах на том же узле. Оптимальное значение определяется характером данных, размером входа и скоростью сети.
-
Вопросы совместимости и детерминированности. Map-выход сохраняется на локальный диск, что обеспечивает устойчивость к сбоям. Однако сбоидиверсии в формате сериализации или конфигурации могут привести к несовпадению значений, если ключи реализованы неправильно. Поэтому при проектировании пользовательской логики важно обеспечить строгое соответствие типов ключей и значения, поддерживаемого последовательным механизмом.
Shuffle и сортировка: перемещение и упорядочение промежуточных данных
Shuffle представляет собой фазу обмена данными между Map и Reduce и включает копирование промежуточных данных, их сбор, сортировку и группировку по ключам. В MRv2 Shuffle выполняется параллельно для каждого редьюсера, что позволяет скрыть сетевые задержки и повысить общий уровень пропускной способности.
-
Копирование промежуточных данных. Редьюсеры отправляют запросы к Map-узлам и получают данные, соответствующие своему partition-номеру. Промежуточные файлы (spill-файлы Map) считываются и консолидируются в память редьюсера. В MR реализованы механизмы конвейерной передачи, которые позволяют перекрывать чтение и обработку потоков, тем самым сокращая задержки.
-
Сжатие и формат. При необходимости промежуточные данные могут быть сжаты на уровне MapOutput, что уменьшает сетевой трафик и скорость передачи. На стороне редьюсера может применяться распаковка и дезкипирование. Сжатие особенно эффективно в кластерах с ограниченной пропускной способностью сети.
-
Сортировка и групировка. Промежуточные пары должны быть упорядочены по ключу для эффективной агрегации и соответствия логике редьюсера. В большинстве реализаций MapReduce сортировка задачи-редьюсер выполняется через слияние нескольких потоков, которые уже отсортированы внутри spill-блоков. Это обеспечивает эффективную схему "external sort" при работе с большими данными, которые не помещаются в память редьюсера.
-
Порядок исполнения и параллелизм. Shuffle может осуществляться параллельно несколькими потоками копирования, что позволяет частично перекрыть IO-системы между Map и Reduce. Граф исполнения MRv2 строится так, чтобы редуктор начинал обработку той части данных, которая была полностью получена и отсортирована, пока другие данные еще копируются. Это снижает общий latency и увеличивает throughput.
-
Проблемы сетевых фронтов и задержек. В тяжелых условиях могут возникать задержки из-за перегрузки сети, неравномерности данных и дисков. Эффективное управление пропускной способностью сети, параллелизмом копирования и выбором размера буфера Shuffle существенно влияет на итоговую производительность.
-
Поддержка вторичной сортировки. Для некоторых сценариев требуется вторичный способ сортировки (secondary sort), где данные упорядочены не только по ключу, но и по второму полю. Это достигается за счет использования сложных типов ключей (например, оберток над исходными ключами) и специфической группировки (GroupingComparator). Реализация требует аккуратной настройки сериализации и корректной реализации сравнения ключей и группировки.
-
Комбинации и оптимизации. Combiner, применяемый на карте, может существенно снизить размер передаваемых данных, если функция редьюсирования поддерживает перерасчет и повторное использование частичной агрегации. Однако combiner должен быть детерминированным и совместимым с редьюсерами, чтобы итоговый результат не изменялся.
Этап Reduce: агрегация и запись результатов
Reduce-фаза осуществляет агрегацию значений по каждому ключу и формирование финального вывода. Каждый вызов reduce(key, Iterable
-
Группировка по ключу. По завершении Shuffle данные подаются редьюсеру в виде упорядоченных по ключу потоков значений. В стандартной реализации группировка достигается на уровне группы ключей, обеспечивая для каждого ключа полный набор значений. Эта организация позволяет реализовать агрегации без повторного прохода по данным.
-
Роль секции Reducer. В логике Reducer определяется функция агрегации: суммирование, объединение, вычисление статистик и прочие операции над множеством значений. Reducer не обязан обрабатывать весь набор значений сразу; он может реализовать оконные или потоковые стратегии обработки, если необходимо поддерживать стримовую обработку.
-
Combiner и вопросы детерминированности. Combiner может быть применен перед передачей данных на редьюсер, но для корректности он должен соответствовать логике reducer: результат применения combiners не должен зависеть от порядка обработки ключей и значений. В случаях, когда агрегации требуют порядка или сложной логики, применение combiner обходит целесообразность.
-
Вывод и формат. Промежуточные данные после Reduce записываются в выходной формат (OutputFormat). В большинстве сценариев выходное хранилище - HDFS, однако MRv2 поддерживает и другие файловые системы. Важна согласованность схемы записи и корректная обработка ошибок: сбой процесса редьюсера может потребовать повторного запуска этого задания.
-
Мониторинг и контроль. В MRv2 механизмы журналирования, Counters и метрики позволяют отслеживать количество обработанных ключей, размер выходных файлов, длительности стадий и дискпропорции. Эти данные служат основой для последующей оптимизации и диагностики.
Оптимизация, надёжность и интеграция с YARN
Глубокая оптимизация модели MapReduce связана с управлением памятью, сетевой нагрузкой и устойчивостью к сбоям. В MRv2 контроль над ресурсами осуществляется через YARN, что обеспечивает гибкость в распределении CPU, памяти и времени выполнения между задачами Map и Reduce.
-
Настройки памяти и JVM. Основные параметры включают mapreduce.map.memory.mb, mapreduce.reduce.memory.mb, а также соответствующие параметры JVM-опций (mapreduce.map.java.opts, mapreduce.reduce.java.opts). Правильный баланс между памяти и нагрузкой на другие процессы критичен: чрезмерно большой MapOutputBuffer может лишить систему памяти, а слишком маленький буфер приведет к частым spills и задержкам.
-
Компрессия и serialization. Включение компрессии для Shuffle (mapreduce.map.output.compress и связанные кодеки) сокращает сетевой трафик, особенно в кластерах с высокой задержкой сети. Выбор сериализации (например, Writable/WritableComparable) влияет на производительность сериализации и дешифрования, а также на совместимость между Map и Reduce.
-
Партиционирование и сортировка. При неравномерном распределении ключей важна кастомизация Partitioners. В сочетании с пользовательскими Comparator-ами можно реализовать вторичную сортировку и гибкое группирование ключей.
-
Компрессия вывода. Выбор компрессии вывода reduce (mapreduce.output.fileoutputformat.compress) снижает нагрузку на диск и сеть, но увеличивает вычислительную стоимость декомпрессии при чтении финального вывода.
-
Производительность и буферы. Путь к снижению задержек лежит в оптимизации размера Shuffle-б buffers (mapreduce.tasktracker.shuffle.max.buffer.size или аналогичных параметров), численного порога параллельных копий и уровня параллелизма. Кроме того, задача может быть настроена на активное использование более эффективных сетевых профилей и RPC-секций.
-
Надежность и отказоустойчивость. MRv2 в рамках YARN поддерживает повторный запуск задач (перезапуск Map или Reduce при сбоях) и speculative execution для задач, которые отстают от графика. Это обеспечивает устойчивость к перегреву узлов и временным задержкам, но требует разумной настройки порогов и мониторинга, чтобы не создавать лишних задач и не перегружать сеть.
-
Интеграции и экосистема. В MRv2 архитектура синхронизирована с YARN и HDFS, что облегчает интеграцию с системами метаданных и мониторинга. В контексте практических кейсов часто применяется сочетание MRv2 с другими инструментами Hadoop-экосистемы и дополнительными слоями обработки (например, аффинитивное кэширование, OLAP-слои и т. п.). В рамках российского и открытого ПО рекомендуется опираться на стандартные реализации MRv2 в Apache Hadoop и closely-supported дистрибутивы, чтобы сохранить совместимость и поддержку.
-
Паттерны архитектуры. Модель MapReduce хорошо сочетается с пакетной обработкой больших данных, когда время выполнения может быть рассчитано заранее и задачи можно распараллелить. Для задач с требованиями интерактивной задержки чаще применяют альтернативные системы (например, Tez или Spark); однако MapReduce остаётся надёжной и предсказуемой основой для больших пакетных конвейеров, где важна детерминированность и масштабируемость.
Примеры архитектурных паттернов и сценариев внедрения
-
Паттерн «Mappers-преобладают» для обработки больших файлов логов: данные читаются по разделам, затем агрегация выполняется на Reduce. В таком сценарии компрессия и эффективные партиции помогают минимизировать сетевые издержки, а Combiner обеспечивает раннюю агрегацию на карте.
-
Паттерн «Secondary Sort» применяется, когда требуется ранжировать значения внутри ключа. Это достигается за счет обёрток ключей и изменения Comparator-логики на группе. Реализация требует осторожного проектирования и тестирования, но обеспечивает предсказуемую последовательность обработки.
-
Паттерн «Параллельное чтение и запись» - через настройку параллельных копий Shuffle и конвейерной передачи, что позволяет скрывать задержки сети и использовать пропускную способность кластера.
-
Паттерн «Компрессия Shuffle» в условиях ограниченной сети - акцент на включение mapreduce.map.output.compress и выбор подходящего кодека. Это существенно уменьшает сетевой трафик, но требует дополнительных вычислений на дешифрацию и потенциальных компрессий.
Key takeaways
- MapReduce разделяет вычисления на Map, Shuffle/Sort и Reduce, организуя эффективный поток данных между локальными узлами и узлами-редьюсерами.
- Промежуточные данные пишутся на диск и являются частично отсортированными внутри spills, что требует механизма внешней сортировки на стадии Reduce.
- Партиционирование по ключу определяет баланс нагрузки между редьюсерами; выбор Partitioners критичен для производительности.
- Shuffle-копирование может быть сжатым и параллельным, что влияет на сетевые задержки и пропускную способность.
- Конфигурации памяти, компрессии и JVM-настроек существенно влияют на производительность; баланс между памятью и дисковыми операциями требует эмпирической калибровки.
- YARN как слой оркестрации обеспечивает гибкость распределения ресурсов и устойчивость к сбоям, позволяя масштабировать MapReduce-конвейеры в крупных кластерах.
- В современных рабочих сценариях MapReduce часто сочетается с другими технологиями для интерактивного анализа, однако надёжность и предсказуемость MRv2 сохраняют его актуальность для пакетной обработки больших данных.
FAQ
Вопрос: Что такое Shuffle в MapReduce и зачем он нужен?
Shuffle - это фазa обмена данных между Map и Reduce, которая копирует промежуточные пары из Map-резульатов на узлы редьюсеров, затем сортирует и группирует их по ключу. Эта фаза минимизирует сетевые задержки за счет параллельной передачи и локального сохранения данных, обеспечивая корректную агрегацию значений, связанных с одним ключом.
Вопрос: Как выбирается число редьюсеров?
Число редьюсеров определяется конфигурацией задачи и целями по параллелизму. Оно зависит от объёма промежуточных данных, пропускной способности сети и желаемого времени выполнения. В MRv2 это решение может быть адаптивно скорректировано в зависимости от нагрузки по кластерам, но чаще задаётся явно параметрами mapreduce.job.reduces или аналогами в рамках конфигурации.
Вопрос: Что считается ключевым для эффективности Combiner?
Combiner может снизить объем данных, передаваемых через Shuffle, если операция над значениями детерминирована и не зависит от порядка обработки значений. Эффективность Combiner возрастает, когда значения частично агрегируются локально на Map-узле без изменения итоговой семантики редьюсера.
Вопрос: Какие параметры памяти и буферов критичны для производительности?
Важны mapreduce.map.memory.mb, mapreduce.reduce.memory.mb и соответствующие JVM-опции (mapreduce.map.java.opts, mapreduce.reduce.java.opts). Также значимы параметры для буферов и сортировки: mapreduce.task.io.sort.mb, mapreduce.task.io.sort.factor. Их баланс определяет частоту spills и скорость Shuffle.
Вопрос: Как MRv2 взаимодействует с YARN?
MRv2 запускается в рамках YARN как набор контейнеров, где ApplicationMaster координирует Map и Reduce задачи, распределяет ресурсы и отвечает за мониторинг выполнения. Это обеспечивает гибкость масштабирования, устойчивость к сбоям и возможность эффективного использования ресурсов кластера.
Вопрос: Какие паттерны наиболее эффективны для больших наборов данных?
Эффективны паттерны с равномерным партиционированием и использованием Combiner там, где возможно локальное агрегирование, а также выбором подходящих кодеков компрессии shuffle. В сценариях, где требуется вторичная сортировка, применяются специальные Comparator и GroupingComparator, что требует дополнительной задумчивости в дизайне ключей.
Вопрос: Какие типичные проблемы встречаются при реализации MapReduce конвейера?
Частые проблемы включают неравномерное распределение ключей, приводящее к перегрузке отдельных редьюсеров; задержки в Shuffle из-за перегрузки сети; избыток spills из-за неадекватного размера MapOutputBuffer; и сложности с настройкой памяти в условиях изменяемой нагрузки. Эффективная диагностика требует мониторинга Counters, журналов задач и сетевых метрик.
Вопрос: Можно ли заменить MapReduce на более современные альтернативы?
В рамках пакетной обработки MapReduce остаётся надежной и детерминированной моделью. Однако для интерактивной или микро-пакетной аналитики часто применяют альтернативы (например, Tez, Spark). В рамках архитектуры Hadoop MRv2 остаётся фундаментальным усложняющим элементом, который обеспечивает надёжные конвейеры пакетной обработки и совместимость с HDFS и YARN.
Вопрос: Какие открытые стандарты и интерфейсы используются в MapReduce?
В MRv2 реализована единая модель исполнения, часто ориентированная на Writable/WritableComparable для сериализации и сравнения ключей и значений. Протоколы RPC используются для коммуникаций между ApplicationMaster, NodeManager и задачами. Эти интерфейсы обеспечивают совместимость между различными дистрибутивами и версиями Hadoop.
Вопрос: Как обеспечить детерминированность результатов при использовании Combiner и Partitioners?
Детерминированность достигается за счет следования строгой семантике коробочных типов ключей и значений, а также корректной реализации GroupingComparator. Combiner должен выполнять над значениями ту же операцию, что и Reducer, и не зависеть от порядка обработки данных. Это критично для поддержания согласованности результатов в большом масштабе.


