

Оптимизация MapReduce: паттерны, настройка параметров, производительность
Оптимизация MapReduce является ключевым элементом цифровой трансформации в больших данных. Правильное сочетание архитектурных паттернов, настройки параметров и мониторинга позволяет достигать высокой пропускной способности и предсказуемой задержки обработки при разумном потреблении ресурсов кластера. Эта глава рассматривает паттерны оптимизации на уровне MapReduce, детально разбирает параметры конфигурации, их влияние на задачи и поведение системы, а также приводит практические подходы к диагностике и интеграции в Hadoop-экосистему.
Оптимизация не сводится к "ускорению одной задачи". Она требует системного подхода: учитывать данные и их распределение, характеристики workload, характеристики кластера и требования бизнеса. В рамках MapReduce особенно важно управлять процессом shuffle, эффективной сериализацией и форматами данных, балансировкой нагрузки между картами и редьюсерами, а также грамотно размещать задачи на узлах с учётом локальности данных.
-
В этом разделе выделены архитектурные паттерны и практики настройки, которые показывают, как проектировать и разворачивать MapReduce- Jobs так, чтобы они выдерживали пиковые нагрузки, обрабатывали рост объема данных и минимизировали задержку на разных стадиях обработки.
-
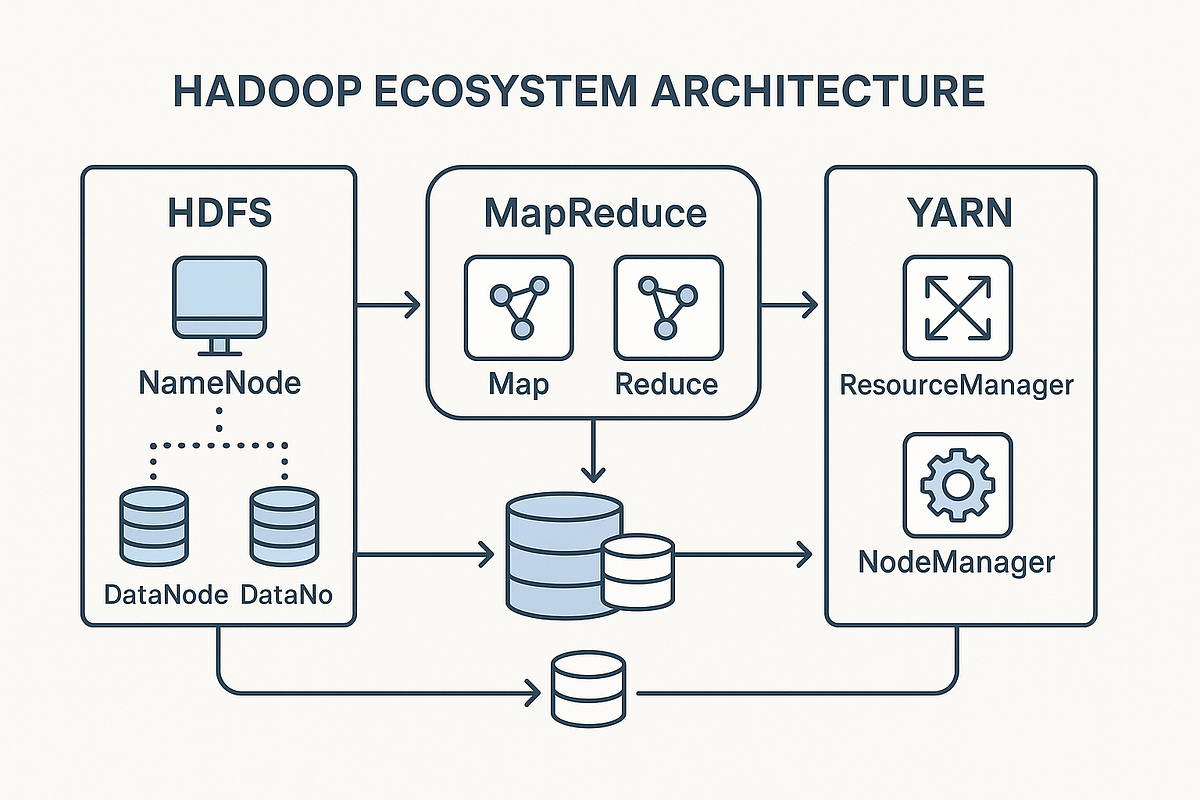
Рассматриваются концепции, которые применимы как в классическом MapReduce/YARN, так и в более современных интеграциях в Hadoop-экосистеме: HDFS для хранения, YARN как менеджер ресурсов, механизмы сериализации и передачи данных между этапами обработки.
-
В конце главы приведены практические примеры и рекомендации по мониторингу, чтобы оперативно выявлять узкие места и управлять настройками без остановки рабочих процессов.
-
Особое внимание уделено практикам, которые можно внедрить в рамках существующих инфраструктур: минимизация перерасхода памяти, грамотное использование комбайнеров и в mapper-коде, а также выбор подходящих форматов данных и схем сериализации.
Краткое содержание главы
- Архитектурные паттерны оптимизации MapReduce: как выстроить работу мап-процессов, редьюсеров и shuffle-соединений.
- Настройка параметров и их влияние на производительность: ресурсы, память, JVM, компрессия и поток обработки.
- Алгоритмы и протоколы: сериализация данных, паттерны сортировки и разделения; баланс между скоростью и потреблением памяти.
- Мониторинг, диагностика и производительность: метрики, инструменты, методики выявления узких мест.
- Интеграции и практические сценарии внедрения: сценарии под ETL, агрегацию, обработку больших объемов данных в рамках Hadoop-эко-системы.
Архитектурные паттерны оптимизации MapReduce
Уровень архитектурных паттернов требует системного взгляда на цепочку обработки данных: от исходного формата источников до результата, который потребует загрузку в целевую систему. В контексте MapReduce основная задача - снизить накладные расходы shuffle, балансировать нагрузку между Map и Reduce, минимизировать время ожидания из-за блокировок и ожидания локальности данных.
-
Паттерн data locality и расписания задач. Распределение задач с учётом размещения данных (водная линия: дата-центр, узел кластера) позволяет снизить сетевые передачи и увеличить пропускную способность. В YARN это достигается за счёт политики планирования и корректного распределения ресурсов между очередями (capacity, fair scheduler).
-
Паттерн параллельной агрегации. Разделение данных на независимые параллельные подзадачи, которые затем объединяются на редьюсере. Такой подход особенно эффективен, когда данные хорошо делимы и нагрузка равномерна, что уменьшает задержку из-за редких больших ключей (skew).
-
Паттерн компрессии на этапе shuffle. Сжатие shuffle-данных на уровне передачи между узлами помогает уменьшить сетевой трафик и задержку доступа к данным. Выбор форматов и алгоритмов компрессии (например, Snappy, Zlib) зависит от баланса между скоростью распаковки и эффективностью сжатия.
-
Паттерн «в mapper» и «во внешнем кабинетe» (in-mapper combining vs. combiner). Встраивание локального агрегирования в mapper может привести к значительной экономии сетевых расходов и повышения скорости партирования на входе редьюсера, особенно при большом объёме промежуточных данных.
-
Паттерн кастомных Partitioner и сортировки. Правильный partitioner распределяет ключи по редьюсерским задачам так, чтобы минимизировать межредьюсеры и уменьшить количество конфликтов при группировке ключей. В некоторых сценариях целесообразна secondary sort, когда порядок по ключу важен для последовательной обработки или упрощения логики редьюсера.
-
Паттерн спецификации форматов данных. Выбор формата и типа данных влияет на производительность. Hadoop Writable-типов в чистом MapReduce обеспечивает эффективную сериализацию, но современные форматы вроде Avro или Parquet дают преимущества в компрессии и совместимости с аналитикой вне MapReduce.
-
Паттерн оптимизации памяти и GC на задачах. Эффективная настройка памяти JVM и поведения сборщика мусора - фундаментальная часть архитектурной оптимизации. Проблемы переполнения памяти на мап-заданиях приводят к частым spill и перерасходу времени на GC, что сказывается на задержке.
В практическом плане данные паттерны призваны снизить сетевой трафик, снизить задержку шухляды и сбалансировать усилия между мапами и редьюсерами. Часть паттернов применима и в рамках альтернативных фреймворков, но их применение в MapReduce обеспечивает совместную совместимость с существующей Hadoop-инфраструктурой.
Встраиваемые примеры паттернов
- Встроенное комбинирование в mapper (in-mapper combining) снижает количество записей в промежуточных данных и уменьшает трафик shuffle.
- Использование кастомного Partitioner для балансировки нагрузки между редьюсерами на основе диапазонов ключей или хеширования.
- Применение secondary sort там, где разные подгруппы требуют предсказуемого порядка для корректной агрегации.
  mapreduce.map.memory.mb
  2048


  mapreduce.reduce.memory.mb
  4096


  mapreduce.map.java.opts
  -Xmx1800m


  mapreduce.reduce.java.opts
  -Xmx3500m


  yarn.nodemanager.resource.memory-mb
  24576


  yarn.scheduler.maximum-allocation-memory-mb
  4096
Настройка параметров и влияние на производительность
Эффективность MapReduce напрямую зависит от грамотной настройки ресурсов и параметров, которые управляют нагрузкой, памятью и сетевой передачей. Важно отличать базовую настройку от конкретного workload-driven тюнинга и учитывать особенности версий Hadoop и используемой экосистемы.
-
Ресурсы кластера и планирование. Управление ресурсами в YARN требует баланса между доступной памятью на ноде, лимитами по CPU и количеством контейнеров. Установка разумного максимума по памяти на контейнеры (map и reduce задачи) предотвращает перегрузку узлов и снижает риск частого обращения к диску. В типичных кластерах среднего размера разумный диапазон составляет от 1,5-4 ГБ на карту и от 2-8 ГБ на редьюсер, но точные значения зависят от workload.
-
Память и JVM. Правильная настройка mapreduce.map.memory.mb, mapreduce.reduce.memory.mb и соответствующих JVM-параметров критически важна. Недоразмеренная память приводит к частым spills и повыситщее потребление времени на GC. Избыточная память увеличивает время старта и потребление ресурсов без пропорционального выигрыша.
-
Параллелизм и количество задач. Оптимальное число map и reduce задач не всегда соответствует числу ядер в кластере. Чрезмерный параллелизм вызывает OOM-падение, перегружает сеть shuffle и усложняет планирование. Рекомендация: начинать с числа задач, близкого к количеству узлов, затем адаптивно настраивать на основе анализа метрик.
-
Шаблоны компрессии и сериализации. Выбор формата данных и компрессии влияет на пропускную способность и мегабайты на секундах. Snappy обеспечивает быстрый распаковку и умеренную компрессию, тогда как Zstandard (когда доступен) может принести лучшие компрессионные показатели. Применение компрессии на этапе shuffle снижает сетевой трафик, но требует дополнительных затрат на распаковку в редьюсерах.
-
Влияние параметров shuffle и sort. Параметры типа mapreduce.task.io.sort.factor, mapreduce.job.reduce.slowstart.completedmaps или mapreduce.reduce.shuffle.input.buffer.percent влияют на распределение работы между тасками и задержки в начале редьюсеров. Правильная настройка помогает снизить таргетированное время ожидания и общий latency.
-
Мониторинг как драйвер изменений. Без системного мониторинга невозможно точно определить, какие параметры требуют коррекции. Метрики по времени выполнения карт, задержке shuffle, количеству spills и использованию памяти дают конкретику для повторных запусков с изменениями.
mapreduce.map.memory.mb 2048 mapreduce.map.java.opts -Xmx1536m mapreduce.reduce.memory.mb 4096 mapreduce.reduce.java.opts -Xmx3584m mapreduce.reduce.shuffle.parallelcopies 4 mapreduce.job.reduce.slowstart.completedmaps 0.7 yarn.nodemanager.resource.memory-mb 24576 yarn.scheduler.maximum-allocation-memory-mb 6144 -
Мемориальная и временная эффективность. Взаимосвязь между объемом локальных данных и временем выполнения заметна: увеличение буферов для shuffle может снизить число spills, но увеличивает использование памяти. В некоторых сценариях разумно уменьшить объем памяти под shuffle на редьюсерах, чтобы ускорить GC и снизить задержку старта, особенно когда данные не слишком велики или есть ограниченная сеть.
-
Выбор форматов и сериализации. В чистом MapReduce чаще применяются Writable-типовые данные для низкоуровневой производительности. Однако для сценариев интеграции с внешними системами и аналитикой эффективна поддержка Avro- или Parquet-форматов, особенно в связке с Hive или Spark, где перенос данных между слоями требует хорошей компрессии и совместимости.
-
Примеры сценариев нагрузки. ETL-процессы с крупной агрегацией и сортировкой часто выигрывают от паттерна «map-side aggregation» и рациональной настройки shuffle, что снижает сетевые расходы и среднее время ожидания на редьюсеры. Для сценариев с большой дисперсной выборкой и сильной неоднородностью данных требуется продуманная балансировка между мапами и редьюсерами, чтобы нивелировать skew и переработку узких ключей.
Алгоритмы, протоколы и паттерны реализации
MapReduce опирается на определённые алгоритмы и протоколы, которые обеспечивают эффективную обработку и обмен данными между стадиями. В техническом плане ключевыми аспектами являются выбор сериализации, параметризованные паттерны сортировки и группировки, а также эффективная организация передачи данных через shuffle.
-
Сериализация и форматы данных. Hadoop Writable обеспечивает эффективное представление примитивов и составных типов в Java, минимизируя накладные расходы на сериализацию/десериализацию. Однако для совместимости и аналитических сценариев часто применяются форматы Avro или Parquet, которые поддерживают эволюцию схем и эффективную компрессию. Выбор зависит от того, требуется ли совместимость с внешними системами, и от возможностей потребителей данных на этапе анализа.
-
Комбайнеры vs in-mapper объединение. Комбайнеры выполняются после стадии map и дают возможность уменьшить промежуточный объем данных, которые передаются между мапами и редьюсерами. В некоторых случаях встраивание объединения непосредственно в mapper (in-mapper combining) может существенно повысить производительность, но требует аккуратности в реализации (не забывать об управлении состоянием и побочных эффектах).
-
Паттерны сортировки и группировки. Secondary sort используется, когда порядок значений внутри групп по ключу критичен для логики редьюсера. В таких случаях следует применять соответствующие компараторы группировки и ключей. Однако применение secondary sort может увеличить сложность и стоимость выполнения, поэтому должно быть обосновано бизнес-логикой.
-
Partitioner и балансировка нагрузки. СпециализированныйPartitioner может минимизировать переработку и балансировать нагрузку между редьюсерами. В ряде сценариев полезно использовать диапазонный разделитель (range partitioning) или хеширование с учётом cardinality ключей. Важно также учитывать потенциальный побочный эффект: если один редьюсер получает слишком много ключей, он становится узким местом, даже если общее количество редьюсеров велико.
-
Роль протоколов взаимодействия. В MapReduce коммуникации между узлами осуществляются через RPC и передачу данных по сети в shuffle phase. Эффективная работа протоколов обеспечивает минимальные задержки и минимизацию повторных передач в случае сбоев. В контексте YARN это сопровождается контролем ресурсов, мониторингом состояния контейнеров и обработкой отказов без потери целостности данных.
  mapreduce.job.output.key.comparator.class
  org.apache.hadoop.mapreduce.lib.partition.KeyFieldBasedComparator


  mapreduce.partition.file-output-format.separator
  ,
Мониторинг, диагностика и производительность
Эффективная оптимизация невозможна без системного мониторинга и диагностики. В рамках MapReduce критически важно отслеживать не только время выполнения задач, но и поведение сети, использование памяти, количество spills на этапе sort/shuffle, и коэффициент повторной попытки переработки задач.
-
Метрики и индикаторы. Ключевые показатели включают среднее время выполнения map и reduce задач, долю времени, затрачиваемого на shuffle, вероятность ошибок обработки данных, коэффициент spill, скорость передачи данных через сеть и показатель использования памяти на узле. Эти метрики позволяют быстро выявлять узкие места, связанные с конфигурацией памяти, степенью параллелизма и балансом нагрузки.
-
Инструменты мониторинга. В Hadoop-экосистеме важна комплексная картина: веб-интерфейсы YARN ResourceManager и ApplicationMaster, журналы задач, а также внешние системы мониторинга (Prometheus, Grafana, Ganglia). Метрики2 в Hadoop и JMX-метрики предоставляют данные о загрузке CPU, памяти, сетевых потоках и состоянии контейнеров. Интеграция таких инструментов позволяет строить дашборды для анализа трендов и быстрого реагирования.
-
Диагностика узких мест. При анализе следует обратить внимание на задержки на этапах map, shuffle и reduce, распределение задач по узлам, а также на skew в ключах. Применение практик profiling для JVM (например, сбор статистики GC и анализ объема памяти) помогает определить, вызывает ли проблема слишком ранний или частый GC, или же перерасход памяти на конкретных узлах.
-
Практические подходы к мониторингу. Регулярная калибровка порогов уведомлений на основе бизнес-целей и SLA. Внедрение стандартных процедур: сбор метрик, алерты на нестандартное потребление ресурсов, анализ логов, репликация конфигураций в окружениях тестирования и продакшна. Важно поддерживать версию конфигураций и процесс их управления, чтобы изменения можно было повторно воспроизвести.
Примеры конфигураций мониторинга и диагностики
## Пример настройки логирования и рантайм-метрик
export HADOOP_LOG_DIR=/var/log/hadoop
export HADOOP_ROOT_LOGGER=INFO,stdout

## Пример интеграции с Prometheus-экспортером
## Включение metrics2 в Hadoop и настройка экспорта
Интеграции и практические сценарии внедрения
Опыт интеграции MapReduce в реальных проектах подсказывает, что паттерны оптимизации работают лучше в рамках четко выстроенных процессов обработки данных и процессов эксплуатации кластера.
-
Интеграция в Hadoop-эко-систему. MapReduce естественно интегрируется с HDFS для хранения промежуточных и итоговых данных, с YARN для управления ресурсами и с инструментами оркестрации, такими как Oozie или Apache Airflow, для построения конвейеров обработки данных. Опыт показывает, что баланс между обработкой на уровне MapReduce и более современными формами обработки (например, Spark) достигается через четко определенные задачи и требования к latency.
-
Практические сценарии внедрения. В рамках ETL-pipeline мощность MapReduce может быть направлена на крупномасштабную агрегацию, фильтрацию и сортировку. В ситуациях с большими массивами регистров и событийной ленты MapReduce хорошо подходит для пакетной обработки, когда критично обеспечить воспроизводимость и прозрачность алгоритмов обработки. Для сценариев, где требуется интерактивность, чаще рассматриваются альтернативные фреймворки, но MapReduce продолжает быть базовым компонентом в рамках больших корпоративных промышленных сред.
-
Практика по конфигурациям под нагрузку. Для постоянной нагрузки с переменным пиком можно применить гибкое управление параметрами через очереди YARN и автоматическую адаптацию размера контейнеров. В случаях с сильной данные- skew полезны раздельные задачи для обработки по диапазонам ключей и корректировка partitioner’а. В то же время, при обработке больших объемов данных с высокой степенью линейной транзакции, целесообразна стратегия компрессии на shuffle и оптимизация памяти для жарких точек кластера.
Key takeaways
- Оптимизация MapReduce требует системного подхода к паттернам мап- и редьюсер-обработки, shuffle и балансировке нагрузки.
- Настройка параметров памяти, ресурсов и JVM-контроля имеет прямое влияние на время выполнения, пропускную способность и стабильность.
- Выбор сериализации и форматов данных (Writable, Avro, Parquet) влияет на компрессию, совместимость и скорость обработки.
- Паттерны типа in-mapper combining, кеширование данных, корректный Partitioning и secondary sort - эффективные инструменты для снижения сетевого трафика и задержек.
- Мониторинг метрик и реализация диагностических процедур - залог предсказуемости производительности и своевременности реакции на узкие места.
- Интеграции в Hadoop-эко-систему требуют ясной структуры конвейеров данных, продуманной архитектуры хранения и согласованности оперативных процедур.
- Важно сочетать архитектурные паттерны с практиками управления ресурсами в рамках YARN и согласованием с бизнес-целями.
FAQ
- Какие главные архитектурные паттерны следует использовать для оптимизации MapReduce?
- Основные паттерны включают data locality для эффективной локальности данных, встраиваемые паттерны агрегации в mapper (in-mapper combining), оптимизацию shuffle через выбор подходящих параметров и компрессии, а также балансировку нагрузки между мапами и редьюсерами с использованием кастомного Partitioner и возможности Secondary Sort в случаях, когда порядок ключей критичен. Эти паттерны позволяют снизить сетевые передачи, уменьшить задержку и повысить общую пропускную способность конвейера обработки данных.
- Какие параметры наиболее критичны для производительности MapReduce в YARN?
- Важнейшими параметрами являются memory и CPU для map и reduce контейнеров (mapreduce.map.memory.mb, mapreduce.reduce.memory.mb, mapreduce.map.java.opts, mapreduce.reduce.java.opts), параметры shuffle (mapreduce.reduce.shuffle.parallelcopies, mapreduce.job.reduce.slowstart.completedmaps), ресурсы нод (yarn.nodemanager.resource.memory-mb), и лимиты очередей (yarn.scheduler.maximum-allocation-memory-mb). Эти настройки определяют, сколько параллельных задач может запуститься, как они взаимодействуют и как быстро данные перемещаются между этапами.
- Когда стоит использовать in-mapper combining?
- В случаях, когда промежуточные данные между мапами имеют большой объем и сетевой трафик становится узким местом, встраивание локального агрегирования в mapper может существено снизить количество передаваемых записей. Однако это требует аккуратной реализации, чтобы избежать побочных эффектов и поддерживать корректность вычислений.
- Как выбрать формат сериализации и формат хранения промежуточных данных?
- Выбор зависит от целей: Writable эффективно в рамках чистого MapReduce и обеспечивает компактную сериализацию, Avro выгоден для совместимости и эволюции схем, Parquet - для аналитических сценариев и плотной компрессии. В интеграции с внешними системами (Hive, Spark) Parquet и Avro часто предоставляют лучшие возможности совместной работы и эффективной компрессии.
- Что такое паттерн secondary sort и когда его использовать?
- Secondary sort позволяет сортировать значения внутри групп по ключу до передачи в редьюсер, что упрощает логику редьюсера и может снизить сложность последующих операций. Применение следует обдумать: если порядок значений внутри группы критичен для корректной агрегации или дальнейшей обработки, иначе стоимость реализации может не окупаться.
- Какие шаги для эффективного мониторинга MapReduce?
- Внедрите сбор метрик по времени map/reduce, задержке shuffle, количеству spills и использованию памяти. Используйте YARN-UI, ApplicationMaster логи, а также внешние системы мониторинга (Prometheus, Grafana) для создания дашбордов. Регулярно анализируйте тренды и устанавливайте алерты на превышение порогов по задержкам и ресурсам.
- Как интегрировать MapReduce в существующую Hadoop-экосистему?
- Интеграция требует согласования конвейеров обработки, форматов данных и механизмов оркестрации. MapReduce хорошо работает с HDFS в качестве хранилища, YARN как менеджером ресурсов и, при необходимости, с инструментами оркестрации. В условиях гибридной инфраструктуры полезно держать MapReduce как базовую основу для пакетной обработки и предусмотреть переход к более современным фреймворкам там, где требуется интерактивность и более низкие latency.
- Какие сценарии лучше подходят для MapReduce, а какие склонны к другим фреймворкам?
- MapReduce хорошо подходит для пакетной обработки, больших объемов данных и предсказуемых SLA, где важно повторяемое и воспроизводимое выполнение. В сценариях, требующих интерактивности или низкой задержки, альтернативы вроде Spark могут быть предпочтительнее. Однако MapReduce остается устойчивой базой в инфраструктурах, где требуются строгие гарантии и совместимость с существующими конвейерами.
- Как минимизировать skew и переработку в MapReduce?
- Стратегии включают выбор подходящего partitionerа, применение сквозной балансировки ключей, использование диапазонного разделения и, при необходимости, вторичной сортировки. Также полезно предобработать данные на этапе ETL, чтобы смягчить неравномерность распределения значений по ключам и снизить вероятность перегрузки отдельных редьюсеров.
- Какие практики следует соблюдать для поддержания производительности на продакшн-кластерах?
- Важно поддерживать единообразие конфигураций, документировать изменения и внедрять устойчивые процессы тестирования. Регулярно проводить профилирование задач, внедрять мониторинг и алерты, управлять ресурсами через очереди YARN и следовать принципам минимизации времени spills и GC. Также необходимо поддерживать документацию по паттернам оптимизации внутри команды и учиться на опыте реальных проектов через ретроспективы и постмортемы.
Глава рассчитана на профессиональных практиков: инженеров по данным, системных архитекторов и лидов команд, ответственных за операционную устойчивость и производительность больших Hadoop-подобных конвейеров. Ее цель - превратить теоретические принципы оптимизации в конкретные практики, применимые к реальным системам, сохранив баланс между архитектурной целостностью и эксплуатационной гибкостью.


