

Архитектура HDFS: хранилище, Namenode/DataNode, блоки и репликация
Hadoop Distributed File System (HDFS) строится на концепции разделения ролей между управляющим узлом, отвечающим за метаданные, и узлами хранения, на которых физически размещаются данные. Эта глава рассматривает архитектуру HDFS с позиции именно данных: как хранятся блоки, как достигается репликация, каким образом Namenode и DataNodes координируют свои действия, и какие механизмы обеспечения целостности и доступности лежат в основе надежной работы распределенной файловой системы. В контексте экосистемы Hadoop HDFS выступает как фундаментальный слой, на котором строятся MapReduce и YARN, и с ним необходимо тесно согласовывать параметры конфигурации, мониторинга и обслуживания.
HDFS проектировался с акцентом на работающие в больших кластерах сценарии: большие файлы, высокую пропускную способность чтения и записи, устойчивость к сбоям отдельных узлов и простоту масштабирования. В основе лежат концепции хранения данных в виде блоков фиксированного размера, дублирование блоков на разных DataNodes и централизованная система метаданных, которую поддерживает NameNode. Взаимодействие между компонентами строится на специализированных протоколах: DataNodes периодически сообщают NameNode о своем состоянии (heartbeat и block reports), NameNode принимает решения о размещении копий, повторной репликации и исправлении нарушений целостности. В современных кластерах полезно рассмотреть дополнительно вопросы высокой доступности NameNode через механизмы журналирования и отказоустойчивости с использованием Quorum Journal Manager (QJM) и ZooKeeper Failover Control (ZKFC).
Ключевые концепции, которые будут разобраны далее, применимы независимо от масштаба кластера и типа хранения данных: от выбора размера блока и фактора репликации до принципов консистентности, планирования размещения реплик и поведения при сбоях узлов. В конце главы приведены практические ориентиры по настройке параметров, типичным паттернам эксплуатации и типовым сценариям интеграции с MapReduce и YARN.
- Архитектура распределенного хранилища данных: роль Namenode и DataNodes, управление namespace и данными.
- Блоки, репликация и целостность: как хранится файл, как обеспечивается доступность и восстановление.
- Протоколы взаимодействия Namenode/DataNodes: heartbeat, block reports, планирование репликаций и устранение нарушений.
- Высокая доступность и устойчивость: HA NameNode, QJM, ZKFC, механизмы аварийного переключения и восстановления.
- Конфигурация и эксплуатационные практики: параметры, связанные с производительностью, балансировкой нагрузки и мониторингом.
Краткое содержание главы
- Архитектура HDFS: разделение ролей хранения и метаданных, принципы namespace и хранения.
- Механизмы блока и репликации: размер блока, фактор репликации, алгоритмы выбора узлов и восстановления.
- Взаимодействие NameNode и DataNodes: протоколы и сигналы состояния, журналирование изменений.
- Надежность и высока доступность: HA NameNode, журналирование, Failover, безопасность.
- Эксплуатация и интеграция: настройка производительности, совместимость с MapReduce и YARN.
Основные элементы архитектуры HDFS
HDFS реализует концепцию разделения вопроса хранения и управления данными. На уровне namespace существует NameNode, который хранит структуру файловой системы, права доступа и размещение блоков. На уровне данных работают DataNodes, которые реально держат блоки файлов на локальных дисках. Каждый файл разбивается на блоки фиксированного размера, чаще всего 128 мегабайт по умолчанию, и каждый блок реплицируется на нескольких DataNodes в разных топологиях сети для обеспечения устойчивости к сбоям аппаратного обеспечения и сетевых сбоев. Система поддерживает целостность данных через контрольные суммы CRC для каждого блока, что позволяет обнаруживать повреждения и автоматически восстанавливать их за счет копий.
Назначение и взаимодействие NameNode и DataNodes строится вокруг последовательности надежных сигналов и обновлений. DataNodes посылают NameNode heartbeat через заданные интервалы, информируют о наличии своих блоков через сообщения block reports и тем самым поддерживают актуальный вид распределения данных. NameNode, в свою очередь, управляет статусом клейма файловой системы, обрабатывает запросы клиентов на создание и удаление файлов, чтение и запись, а также реагирует на события изменения размера файлов: добавление блоков, удаление блоков, изменение разрешений. Такой подход позволяет единообразно представлять файловую систему, независимо от того, сколько DataNodes физически хранит данные.
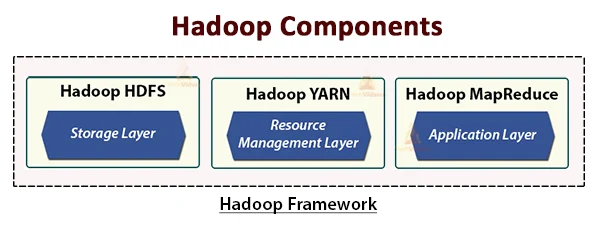
В контексте MapReduce и YARN HDFS выступает как устойчивый источник данных: MapReduce считывает входные данные из HDFS, записывает выходные данные обратно в HDFS, а YARN предоставляет ресурсы для выполнения задач с доступом к тем же данным через единый API. В современных кластерах дополнительно рассматривают вопрос высокой доступности NameNode и доступности блочно-управляемого пространства через репликацию метаданных, журналирование изменений и координацию на уровне консенсуса. В результате архитектура HDFS обеспечивает не только долговременность данных, но и эффективное управление ими в условиях постоянно растущего объема информации.
Блоки и репликация: принципы хранения и обеспечения доступности
Каждый файл в HDFS представляется как поток блоков, каждый блок имеет фиксированный размер и хранится на одном DataNode. Репликация - это механизм дублирования блоков на разных DataNodes. Фактор репликации по умолчанию равен 3, что обеспечивает устойчивость к сбоям до двух узлов в рамках классической конфигурации. Репликация реализуется таким образом, чтобы копии блока располагались на разных узлах и в разных топологиях сети, минимизируя риск одновременного выхода из строя всей копии; кроме того, размещение реплик учитывает географическую и сетевую близость к вычислительным узлам, которым требуется доступ к данным.
Ключевые механизмы и принципы включают:
- размер блока: выбор размера блока влияет на количество реплик и нагрузку на NameNode. Увеличение размера блока может снизить метаданные, но повлияет на параллелизм чтения и запись, в то время как уменьшение блока увеличивает число реплик и требования к сетевым ресурсам.
- репликация и контроль целостности: CRC по каждому блоку и контроль целостности при чтении и записи. DataNodes рассчитывают CRC при записи блока, NameNode хранит метаданные о блоках и их репликах, а при получении данных клиентом может проверяться корректность.
- постановка и перераспределение реплик: когда блок недостает копий (under-replicated) или становится переполненным (over-replicated), NameNode инициирует операцию репликации или удаления копий через DataNodes. Это автоматизированный процесс, который поддерживает требуемый уровень доступности.
- отказоустойчивость: в случае сбоя DataNode соответствующие блоки продолжают существовать на других копиях, а NameNode переподбирает местоположение блока для чтения или повторной записи.
Практическая важность здесь состоит в настройке параметров, которые соответствуют требованиям к задержке записи, пропускной способности сети и целостности данных. Фактор репликации напрямую влияет на потребление дискового пространства класса кластера; при больших кластерах разумно оценивать допустимый компромисс между надежностью и экономией ресурсов. Размер блока следует выбирать с учетом характера рабочих нагрузок: для задач, работающих с очень большими файлами, блоки большого размера могут снизить фрагментацию и нагрузку на координатор репликаций, но потребуют большего времени на восстановление отдельной копии в случае повреждения.
Метаданные и хранение информации о файловой системе: Namenode и DataNodes
Namenode выполняет роль центрального каталога, в котором хранится namespace, включая структуру директорий, разрешения и местоположение блоков каждого файла. Внутренне Namenode хранит два важных файла: fsimage и editlog. fsimage представляет собой снимок текущего состояния namespace, тогда как editlog регистрирует все последовательные операции изменения. При старте NameNode считывает fsimage и последовательно проигрывает записи editlog, восстанавливая актуальное состояние файловой системы. Это позволяет обеспечить атомарность операций и устойчивость к сбоям.
DataNodes хранят фактические блоки файлов на локальных дисках. Каждый блок имеет уникальный идентификатор и хранится с локальными метаданными (местоположение на диске, размер, состояние). DataNodes регулярно отправляют block reports NameNode, который служит индикатором «что реально находится на полках» и служит основой для верификации целостности. При этом DataNodes могут выполнять операции очистки, удаления и переразмещения блоков в рамках политик кластера, которые регулируются NameNode и администратором.
Управление пространством имен в NameNode критично для производительности и масштабируемости. В старших версиях Hadoop внедрено решение для масштабирования через Federation, когда множество NameNode-уровней обслуживает параллельно разные части namespace. Однако для базовой архитектуры в рамках одной файловой системы чаще применяется единый NameNode. В контексте высокой доступности NameNode работает параллельно в виде активного и резервного экземпляра. Резервный NameNode дублирует метаданные через механизм журналирования изменений и использует механизм журналирования, чтобы быть готовым к быстрому переключению активного узла при сбое активной части.
Переход к HA требует дополнительных компонентов: Journaling Nodes (JournalNode), упорядочение журналов через Quorum Journal Manager (QJM) и механизм автоматического переключения через ZooKeeper Failover Controller (ZKFC). Эти механизмы позволяют Namenode-ы оставаться согласованными и гарантировать непрерывный доступ к namespace, даже если активный NameNode выходит из строя. Важной особенностью является то, что репликация метаданных и данных разделена: данные остаются в DataNodes, а метаданные - в Namenode. Это облегчает масштабирование хранения данных и улучшает гибкость управления.
Протоколы взаимодействия: как Namenode и DataNodes координируют работу
Коммуникации между NameNode и DataNodes строятся на нескольких низкоуровневых сигналах и событиях:
- heartbeat: периодические сигнализации от DataNodes к NameNode об их доступности и статусе. Heartbeat помогает NameNode определить, какие DataNodes живы и какие нуждаются в обслуживании.
- block reports: DataNodes отправляют список своих блоков NameNode. Это позволяет NameNode поддерживать актуальный реестр размещения блоков и выполнять балансировку, репликацию и проверку целостности.
- addBlock и completeOperation: операции записи файлов приводят к размещению новых блоков и последующему уведомлению NameNode об их завершении.
- репликации и оптимизация: NameNode инициирует процессы копирования блоков между DataNodes для сохранения требуемого уровня репликации, а DataNodes выполняют фактическое копирование по указанию NameNode.
Эти механизмы обеспечивают синхронность архитектуры: NameNode хранит «каркас» файловой системы, а DataNodes реализуют физическое хранение данных. Важной задачей является своевременное и корректное обновление статуса блоков, чтобы предотвратить рассинхронизацию между метаданными и фактическим содержимым данных. В этом контексте целостность блоков обеспечивается через контрольные суммы и периодическую проверку, что особенно критично для больших кластеров с высоким объемом операций записи и чтения.
Надежность, отказоустойчивость и высока доступность
Высокая доступность NameNode достигается за счет реализации активной и резервной копий NameNode. При использовании QJM и ZKFC при обнаружении сбоя активного NameNode его задачи перенимает standby-узел, а процессы журналирования и консолидации метаданных продолжают работать без потери данных. В HA-конфигурациях NameNode постоянно синхронизирует свои реплики метаданных, что позволяет минимизировать время простоя. В случае падения DataNode или затруднений в сети система перенаправляет запросы к текущим репликам и, при необходимости, инициирует перераспределение блоков на другие DataNodes.
Помимо HA, существуют дополнительные практики для повышения устойчивости:
- репликация подписей и журналирования: использование QJM обеспечивает последовательную запись изменений в журнал, доступны несколько независимых JournalNode-узлов, которые формируют консенсус.
- балансировка и перераспределение данных: механизмы, встроенные в NameNode, позволяют перераспределить блоки между DataNodes для оптимизации нагрузки и устранения «горячих точек».
- целостность и проверки: контрольные суммы и детектирование повреждений, а также повторная синхронизация недостающих реплик, позволяют поддерживать корректность данных в условиях аппаратных сбоев.
- безопасность и контроль доступа: Kerberos-основанная аутентификация и разграничение прав доступа, защитные механизмы на уровне файловой системы.
Эксплуатационные преимущества такой архитектуры включают предсказуемую задержку доступа к данным и устойчивость к сбоям, что особенно критично в рамках аналитических рабочих нагрузок MapReduce и приложений, которые опираются на своевременный доступ к большому объему входных данных.
Практические аспекты конфигурации и интеграции
Настройка HDFS требует осознанного выбора параметров, влияющих на производительность и устойчивость к сбоям. Ключевые параметры включают:
- dfs.blocksize: размер блока. В зависимости от рабочих нагрузок и характера данных следует выбирать баланс между количеством блоков и эффективностью чтения.
- dfs.replication: фактор репликации по умолчанию. Рекомендуется выбирать исходя из требований по доступности и затрат на хранение.
- dfs.namenode.handler.count и аналогичные параметры: максимальное число потоков, обрабатывающих запросы к NameNode.
- dfs.namenode.heartbeat.recheck-interval и другие временные параметры, влияющие на частоту heartbeat и реакцию на задержки.
- настройки HA: использование QJM, JournalNode, ZKFC. В конфигурациях HA необходимо прописать параметры failover и адреса сервисов координации.
Интеграция с MapReduce и YARN реализуется за счет того, что они используют единый файловый интерфейс HDFS для чтения и записи данных. В MapReduce заданиям требуется быстрый доступ к входным данным, что диктует важность локальности данных и минимизации сетевых перемещений. YARN использует те же API доступа к файловой системе для сохранения результатов и промежуточных данных, поэтому согласование настроек заслуги между хранилищем и вычислительным слоем становится критическим аспектом. При проектировании кластера целесообразно заранее определить уровни доступности для NameNode, требования к задержкам и пропускной способности сети, а также стратегию распределения файлов крупных наборов данных. В современных реалиях можно дополнительно рассмотреть интеграцию с новыми технологиями хранения, например HDFS-EC для сценариев с исключительным требованием к устойчивости и экономии пространства, однако это требует другой архитектурной модели и дополнительных настройок.
Key takeaways
- HDFS разделяет функции хранения данных и управления метаданными: DataNodes хранят блоки, NameNode хранит namespace и размещение блоков.
- Блоки фиксированного размера и репликация создают устойчивость к сбоям и обеспечивают параллелизм чтения.
- Протоколы heartbeat и block reports обеспечивают синхронизацию между NameNode и DataNodes, а контроль целостности данных поддерживает надежность.
- В современных кластерах HA NameNode достигается через QJM и ZKFC, что обеспечивает минимальное время простоя при сбоях.
- Производительность и надежность зависят от грамотной настройки blocksize, replication factor и параметров управления журналированием и failover.
- Глубина интеграции с MapReduce и YARN требует согласованности параметров доступа к HDFS и учета локальности данных.
- При необходимости можно использовать расширения HDFS, например Federation для масштабирования namespace, и HDFS-EC для альтернативной стратегии хранения данных.
FAQ
- Что такое fsimage и editlog в Namenode, и зачем они нужны?
- fsimage - это снимок текущего состояния namespace HDFS, фиксированное «карт-бланш» файловой системы на конкретный момент времени. Editlog - это последовательность операций изменения, которые применяются к fsimage. При старте NameNode читает fsimage и последовательно воспроизводит записи editlog, восстанавливая актуальное состояние. Эта архитектура обеспечивает устойчивость к сбоям: данные блоков хранятся на DataNodes, метаданные - в Namenode, и при сбое можно восстановить состояние через журнал изменений.
- Как работает путь записи файлов в HDFS?
- При записи файла клиент выбирает цепочку DataNodes, образующую репликаторский конвейер. Первый DataNode в цепочке принимает данные, затем передает их следующим DataNodes, формируя цепочку репликации. После завершения записи первый DataNode подтверждает Namenode, что новый блок создан и размещен. NameNode обновляет свою базу и информирует DataNodes о размещении реплик. Этот механизм обеспечивает параллельную запись и распределенное хранилище по всем узлам.
- Почему размер блока и фактор репликации важны для производительности?
- Размер блока влияет на количество взаимодействий между клиентом и NameNode и на распределение нагрузки по DataNodes. Более крупные блоки уменьшают число блоков и связанные метаданные, но могут повысить время восстановления при повреждении одной из крупных копий. Фактор репликации определяет устойчивость к сбоям: чем выше фактор, тем выше надёжность, но выше затраты дискового пространства и сетевой трафик. Оптимальные значения зависят от доступной сети, характера рабочих нагрузок и требований к SLA.
- Какие сигналы используются для мониторинга состояния кластера?
- DataNodes посылают heartbeats NameNode через заданные интервалы времени и регулярно отправляют block reports с информацией о наличии блоков. NameNode, в свою очередь, обрабатывает запросы клиентов на создание файлов, чтение и изменение прав доступа, а также осуществляет управление размещением реплик и восстановлением целостности. В HA конфигурациях дополнительно используются JournalNode и ZKFC для координации переключений между активной и резервной копией NameNode.
- Что такое Quorum Journal Manager (QJM) и зачем он нужен?
- QJM - это механизм журналирования изменений в NameNode, который записывает их в набор JournalNode-узлов. Это обеспечивает консистентную и отказоустойчивую запись изменений файловой системы в распределенной среде. В сочетании с ZKFC он позволяет автоматически переключать активный NameNode без потери данных и минимизировать время простоя.
- Как можно повысить доступность HDFS без значимых изменений в приложениях?
- Реализация HA NameNode с использованием QJM и ZKFC позволяет свести к минимуму простои, так как standby NameNode поддерживает актуальное состояние через журналирование изменений. Кроме того, Federation (мелкие, независимые namespace) может снизить нагрузку на одну точку отказа и улучшить масштабируемость. В рамках эксплуатации следует следить за мониторингом DataNodes, состоянием сети и производительностью узлов, чтобы быстро реагировать на изменения.
- Какие проверки целостности применяются к блокам?
- HDFS применяет контрольные суммы CRC для каждого блока и проверяет их при чтении. DataNodes выполняют локальные проверки и повторно читают данные при обнаружении повреждений, используя доступные реплики. Это обеспечивает целостность данных и защиту от аппаратных сбоев, а также позволяет обнаруживать и исправлять повреждения на раннем этапе.
- Как организация управляет политикой размещения реплик?
- Размещение реплик учитывает топологию кластера (racks, узлы, дата-центр) и стремится распределить копии по разным узлам и топологиям. Это снижает риск одновременного выхода из строя всех копий блока. Настройки Topology Script и конкретные параметры размещения позволяют адаптировать политику под физическую инфраструктуру.
- Какие типичные ограничения и риски связаны с одной NameNode?
- Один NameNode в единой файловой системе является узким местом для производительности и точкой отказа. Поэтому современные кластеры применяют HA и, при необходимости, Federation. Также важно учитывать производительность NameNode и пропускную способность сетевого канала, поскольку все операции изменения файлов и размещение блоков зависят от быстродействия NameNode.
- Какие сценарии синхронизации с MapReduce и YARN особенно критичны?
- MapReduce читает входные данные из HDFS и пишет выходные данные обратно в HDFS, поэтому задержки на доступ к данным напрямую влияют на время выполнения задач. YARN требует стабильного доступа к файловой системе для хранения промежуточных данных и журналов задач. Наличие множества DataNodes и эффективное управление репликацией позволяют обеспечить локальное чтение и балансировку нагрузки по кластерам, что критично для времени выполнения задач и устойчивости к сбоям.


